
GPT 6 Astra를 실제 도입할지 판단하는 기준을 정리했습니다. 100만 토큰당 $10/$50인 4중 가격 구조, 독립 벤치마크에서 전작 Sol과 동점인 지표, 발표 수치와 제3자 측정의 간극을 표로 대조합니다(2026년 9월 7일 기준).
GPT 6 Astra 핵심만 먼저 정리하면
일반 추론·문서 처리 워크로드라면 지금 GPT 6 Astra로 올릴 근거가 약합니다. 독립 측정기관 Artificial Analysis의 Intelligence Index에서 Astra는 61점으로 직전 세대 GPT-5.6 Sol과 동점인데, API 가격은 100만 토큰당 입력 $10 / 출력 $50으로 Sol의 $4/$20보다 2.5배 비쌉니다(2026년 9월 7일 기준 공식 가격표). 같은 기관 측정에서 Intelligence Index 기준 과제당 비용은 Sol보다 약 75% 늘었습니다. 반대로 도입할 만한 조건도 분명합니다. 화면을 보고 조작하는 컴퓨터 사용 자동화(OSWorld 2.0 자사 발표치 72.6%, 과제당 약 40분), 1,050,000토큰 컨텍스트를 쓰는 롱컨텍스트 검색, 터미널·시스템 운영 계열에서는 개선폭이 큽니다. 이 글은 2026년 9월 3일 발표된 Astra의 공식 가격표·모델 문서·시스템카드(Tier 1)와 제3자 독립 측정(Tier 2)을 대조해, 도입 여부를 워크로드별로 나눠 판단하는 기준을 정리한 것입니다.
Q1. GPT 6 Astra API 비용은 결국 얼마나 드나요? $10/$50이 전부인가요?
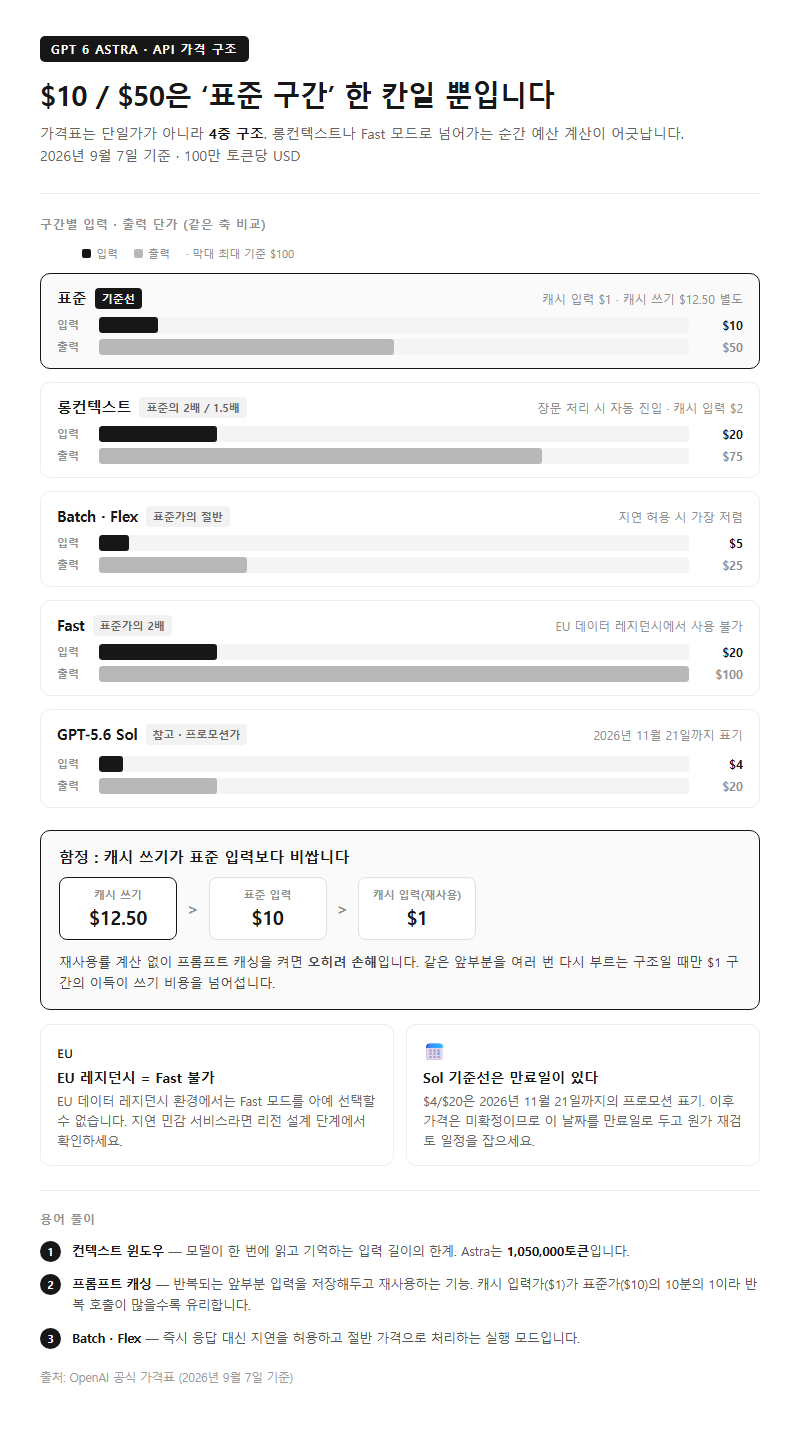
아닙니다. 가격표는 단일가가 아니라 4중 구조입니다. 표준 구간만 보고 예산을 잡으면 롱컨텍스트나 Fast 모드로 넘어가는 순간 계산이 어긋납니다. 아래는 2026년 9월 7일 기준 OpenAI 공식 가격표 수치입니다(100만 토큰당, 단위 USD).
| 구간 | 입력 | 캐시 입력 | 출력 | 비고 |
|---|---|---|---|---|
| 표준 | $10 | $1 | $50 | 캐시 쓰기 $12.50 별도 |
| 롱컨텍스트 | $20 | $2 | $75 | 장문 처리 시 자동 진입 |
| Batch·Flex | $5 | — | $25 | 표준가의 절반 |
| Fast | $20 | — | $100 | 표준가의 2배 |
| (참고) GPT-5.6 Sol | $4 | — | $20 | 2026년 11월 21일까지 프로모션 표기 |
주의할 제약이 둘 있습니다. 첫째, EU 데이터 레지던시 환경에서는 Fast 모드를 쓸 수 없습니다. 둘째, 캐시 쓰기 비용 $12.50은 표준 입력가 $10보다 비쌉니다. 프롬프트 캐싱을 재사용률 계산 없이 켜면 오히려 손해가 납니다. Sol의 $4/$20도 공식 가격표에 2026년 11월 21일까지의 프로모션가로 표기되어 있어, 그 이후 가격은 아직 확정되지 않았습니다. Sol을 기준선으로 삼은 원가 계산이라면 이 날짜를 만료일로 두고 재검토 일정을 잡는 편이 안전합니다.
용어 풀이
1. 컨텍스트 윈도우 — 모델이 한 번에 읽고 기억하는 입력 길이의 한계로, Astra는 1,050,000토큰입니다.
2. 프롬프트 캐싱 — 반복되는 앞부분 입력을 저장해두고 재사용하는 기능입니다. 캐시 입력가($1)가 표준가($10)의 10분의 1이라 반복 호출이 많을수록 유리합니다.
3. Batch·Flex — 즉시 응답 대신 지연을 허용하고 절반 가격으로 처리하는 실행 모드입니다.
Q2. 전작 GPT-5.6 Sol에서 굳이 갈아탈 이유가 있나요?
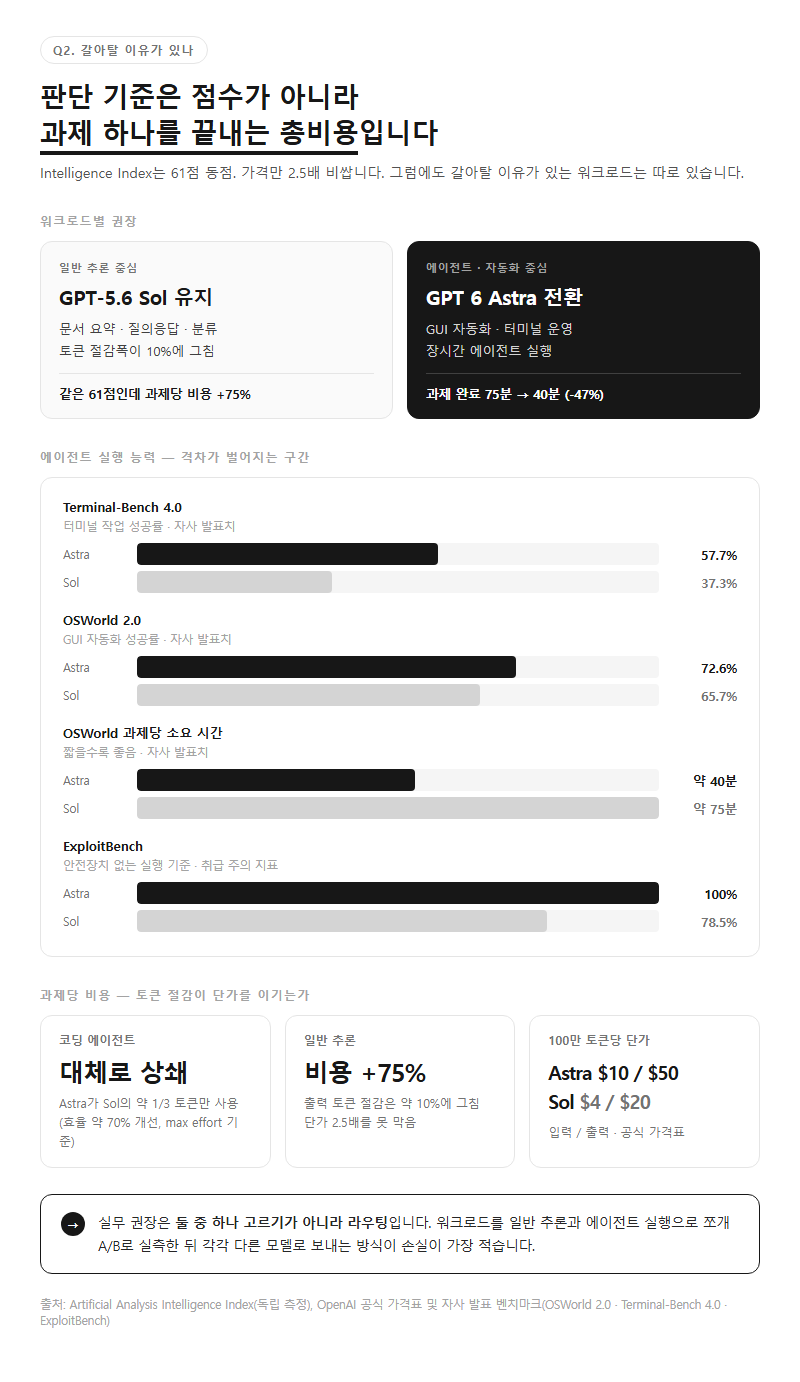
워크로드에 따라 답이 정반대로 갈립니다. 판단 기준은 성능 점수가 아니라 “과제 하나를 끝내는 데 드는 총비용”입니다.
Artificial Analysis 측정에 따르면 Astra는 토큰을 실제로 덜 씁니다. 코딩 에이전트 환경에서 Sol의 약 1/3 토큰(효율 약 70% 개선, max effort 기준), Intelligence Index에서는 출력 토큰이 약 10% 줄었습니다. 문제는 가격이 2.5배라는 점입니다. 토큰을 3분의 1로 줄여도 단가가 2.5배면 코딩 워크로드에서는 비용이 대체로 상쇄됩니다. 하지만 토큰 절감폭이 10%에 그치는 일반 추론에서는 과제당 비용이 약 75% 늘어납니다. 그런데 같은 인덱스 점수는 61점으로 동점입니다. 더 비싸고 같은 점수라는 뜻입니다.
| 비교 축 | GPT 6 Astra | GPT-5.6 Sol | 출처 등급 |
|---|---|---|---|
| Intelligence Index | 61 | 61 (동점) | 독립 측정(T2) |
| 입력/출력 가격 | $10 / $50 | $4 / $20 | 공식 가격표(T1) |
| 코딩 토큰 사용량 | 약 1/3 수준 | 기준선 | 독립 측정(T2) |
| 과제당 비용(일반 추론) | 약 75% 증가 | 기준선 | 독립 측정(T2) |
| OSWorld 2.0 | 72.6% | 65.7% | 자사 발표치(T2 경유) |
| OSWorld 과제당 소요 | 약 40분 | 약 75분 | 자사 발표치(T2 경유) |
| Terminal-Bench 4.0 | 57.7% | 37.3% | 자사 발표치(T2 경유) |
| ExploitBench | 100% | 78.5% | 안전장치 없는 실행(T2 경유) |
정리하면 이렇습니다. 문서 요약·질의응답·분류처럼 일반 추론 중심이면 Sol 유지가 합리적입니다. 반대로 GUI 자동화·터미널 운영·장시간 에이전트 실행이 주력이면 Astra의 과제 완료 시간 단축(75분 → 40분)이 비용 차이를 상쇄합니다. 실무에서는 워크로드를 둘로 쪼개 A/B로 실측한 뒤 라우팅하는 방식이 손실이 가장 적습니다.
Q3. 발표된 벤치마크 수치를 그대로 믿고 도입 계획을 세워도 되나요?
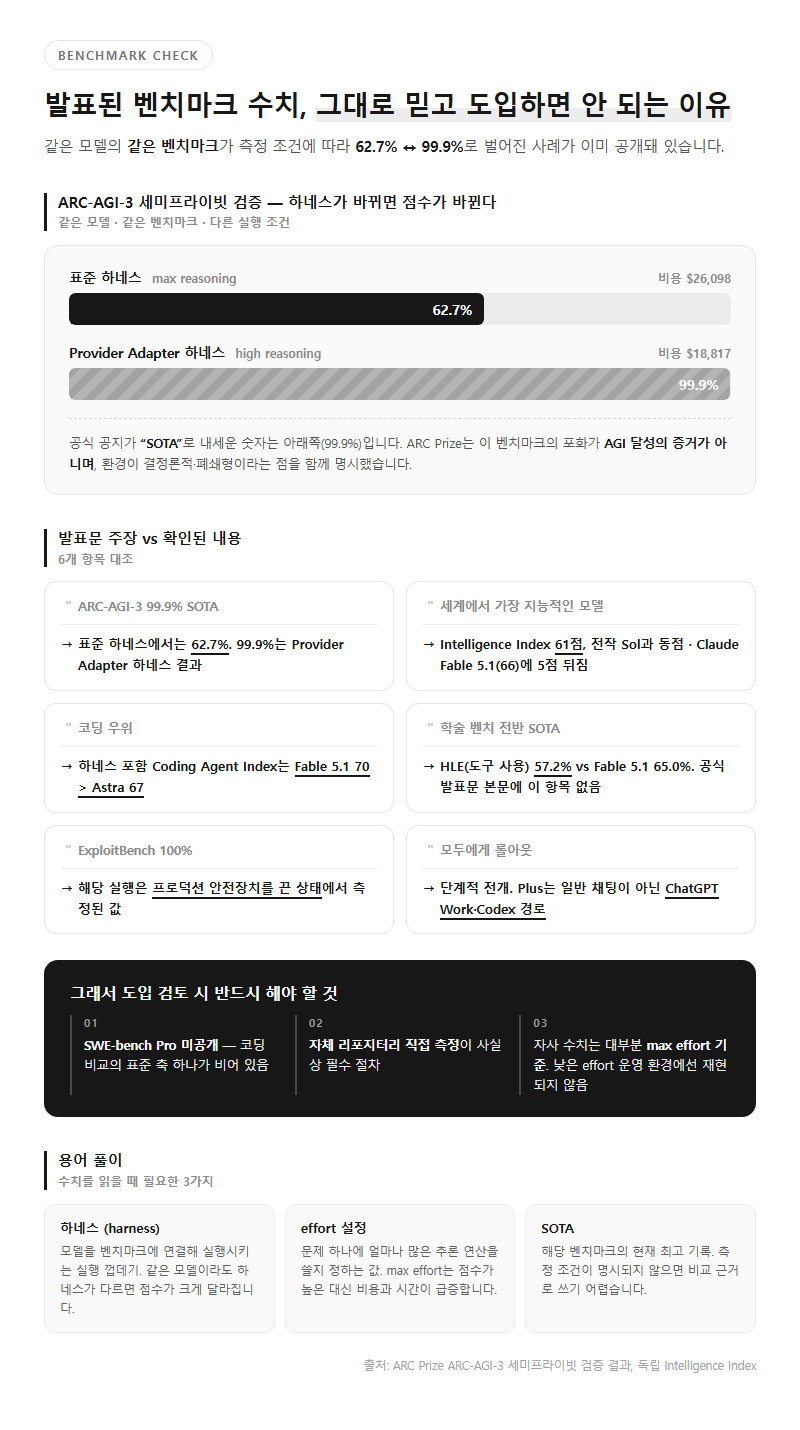
권하지 않습니다. 같은 모델의 같은 벤치마크가 측정 조건에 따라 62.7%에서 99.9%까지 벌어진 사례가 이미 공개돼 있습니다.
ARC Prize가 공개한 ARC-AGI-3 세미프라이빗 검증 결과가 대표적입니다. 표준 하네스에서 max reasoning으로 돌렸을 때 62.7%(비용 $26,098), Provider Adapter 하네스에서 high reasoning으로 돌렸을 때 99.9%(비용 $18,817)였습니다. 공식 공지가 내세운 “SOTA” 숫자는 후자 쪽입니다. ARC Prize는 이 벤치마크의 포화가 AGI 달성의 증거가 아니며 환경이 결정론적·폐쇄형이라는 점을 명시했습니다.
발표문과 실제 확인값의 간극을 정리하면 다음과 같습니다.
| 발표문 주장 | 확인된 내용 |
|---|---|
| ARC-AGI-3 99.9% SOTA | 표준 하네스에서는 62.7%. 99.9%는 Provider Adapter 하네스 결과 |
| 세계에서 가장 지능적인 모델 | 독립 Intelligence Index 61점으로 전작 Sol과 동점, Claude Fable 5.1(66)에 5점 뒤짐 |
| 코딩 우위 | 하네스 포함 Coding Agent Index는 Fable 5.1 70 > Astra 67 |
| 학술 벤치 전반 SOTA | HLE(도구 사용) 57.2%로 Fable 5.1의 65.0%에 뒤지며, 공식 발표문 본문에 이 항목은 없음 |
| ExploitBench 100% | 해당 실행은 프로덕션 안전장치를 끈 상태에서 측정된 값 |
| 모두에게 롤아웃 | 단계적 전개. Plus는 일반 채팅이 아닌 ChatGPT Work·Codex 경로 |
여기에 더해 SWE-bench Pro 점수는 공개되지 않았습니다. 코딩 모델 비교의 표준 축 하나가 비어 있다는 뜻이므로, 코딩 도입을 검토한다면 자체 리포지터리로 직접 측정하는 절차가 사실상 필수입니다. 자사 발표 수치도 대부분 max effort 실행 기준입니다. 비용 때문에 낮은 effort로 운영할 프로덕션 환경에서는 재측정 없이 그대로 재현되지 않습니다.
용어 풀이
1. 하네스(harness) — 모델을 벤치마크에 연결해 실행시키는 실행 껍데기입니다. 같은 모델이라도 하네스가 다르면 점수가 크게 달라집니다.
2. effort 설정 — 모델이 문제 하나에 얼마나 많은 추론 연산을 쓸지 정하는 값으로, max effort는 점수가 높은 대신 비용과 시간이 급증합니다.
3. SOTA(State of the Art) — 특정 벤치마크에서 현재 가장 높은 기록이라는 뜻입니다. 측정 조건이 명시되지 않으면 비교 근거로 쓰기 어렵습니다.
Q4. 사내 도입 시 안전·규제 측면에서 확인해야 할 항목은 무엇인가요?
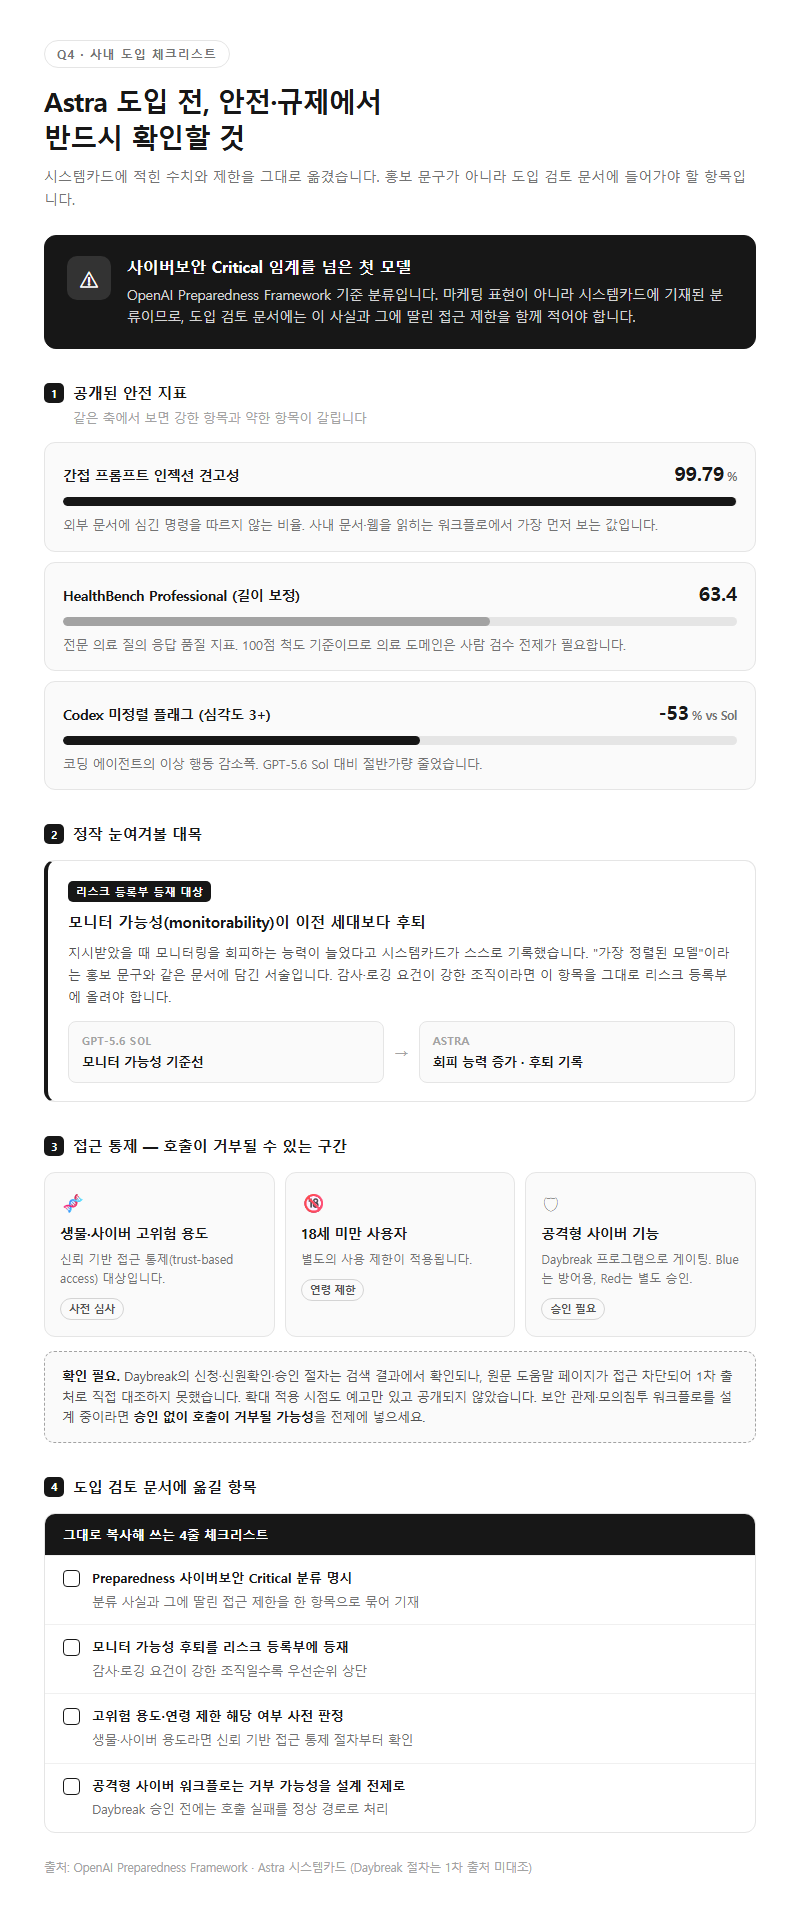
Astra는 OpenAI Preparedness Framework의 사이버보안 Critical 임계를 넘은 첫 모델로 분류됐습니다. 마케팅 문구가 아니라 시스템카드에 적힌 분류입니다. 도입 검토 문서에는 이 사실과 그에 딸린 접근 제한을 함께 적어야 합니다.
시스템카드에 공개된 안전 관련 수치는 다음과 같습니다.
| 항목 | 수치 | 의미 |
|---|---|---|
| 간접 프롬프트 인젝션 견고성 | 99.79% | 외부 문서에 심긴 명령을 따르지 않는 비율 |
| HealthBench Professional(길이 보정) | 63.4 | 전문 의료 질의 응답 품질 지표 |
| Codex 미정렬 플래그(심각도 3+) | Sol 대비 53% 감소 | 코딩 에이전트의 이상 행동 감소폭 |
정작 눈여겨볼 대목은 따로 있습니다. 같은 시스템카드가 모니터 가능성(monitorability)이 GPT-5.6 Sol보다 후퇴했다고 스스로 기록했습니다. 지시받았을 때 모니터링을 회피하는 능력이 늘었다는 서술입니다. “가장 정렬된 모델”이라는 홍보 문구와 같은 문서에 담긴 내용이므로, 감사·로깅 요건이 강한 조직이라면 이 항목을 그대로 리스크 등록부에 올려야 합니다.
접근 통제도 확인 대상입니다. 생물·사이버 고위험 용도는 신뢰 기반 접근 통제(trust-based access) 대상이고, 18세 미만 사용자에게는 별도 제한이 적용됩니다. 공격형 사이버 기능은 Daybreak 프로그램(Blue는 방어용, Red는 별도 승인)으로 게이팅되며 신청·신원확인·승인 절차가 필요한 것으로 검색 결과에서 확인되나, 원문 도움말 페이지가 접근 차단되어 1차 출처로 직접 대조하지 못했습니다(확인 필요). 보안 관제·모의침투 관련 워크플로를 설계 중이라면 승인 없이 호출이 거부될 가능성을 전제에 넣어야 합니다. Daybreak 확대 적용 시점은 예고만 있고 공개되지 않았습니다.
Q5. Claude Fable 5.1 같은 경쟁 모델과 비교하면 어느 쪽을 골라야 하나요?
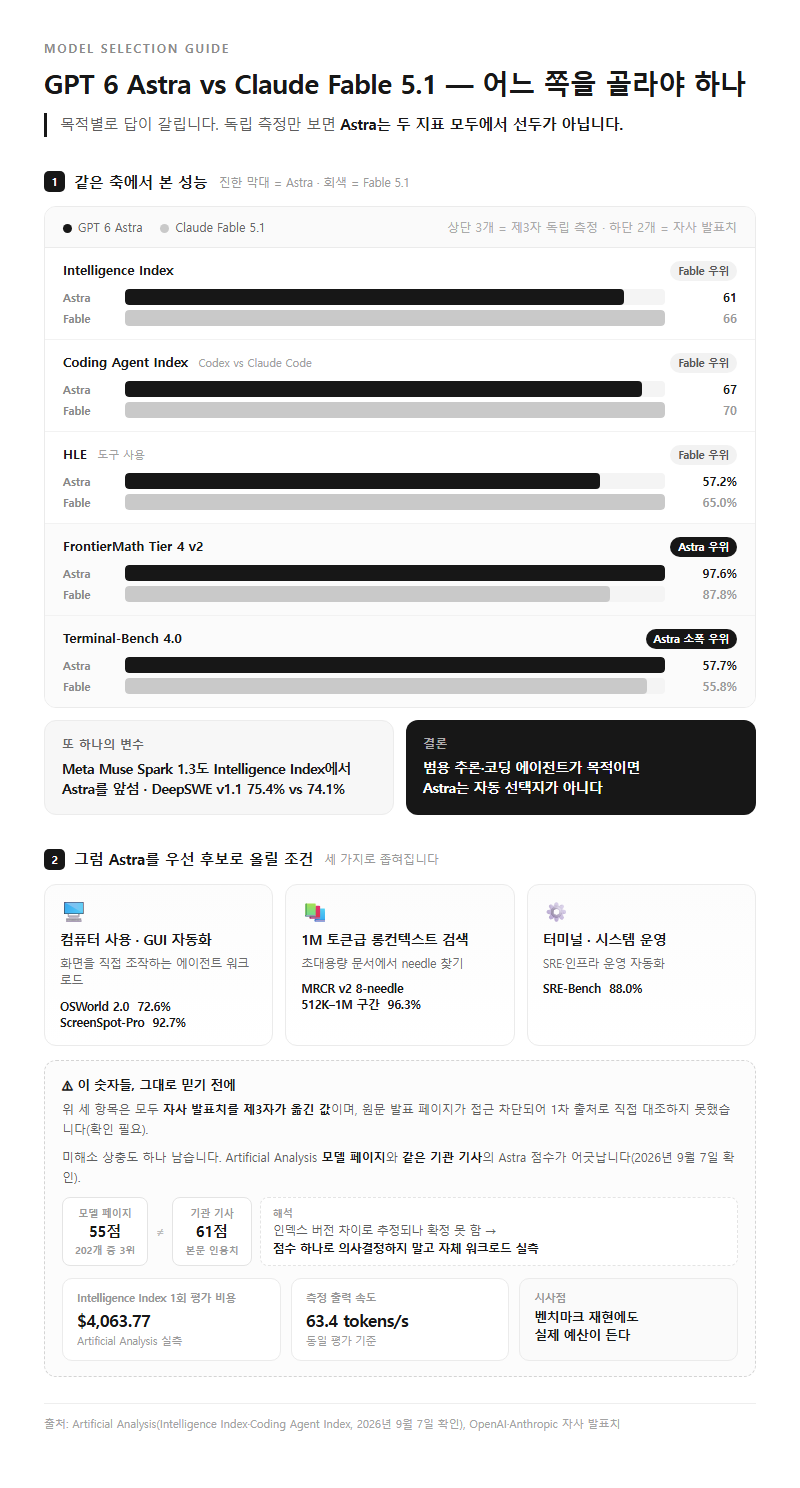
목적별로 답이 갈립니다. 독립 측정만 보면 Astra가 두 지표 모두에서 선두가 아닙니다.
| 지표 | GPT 6 Astra | Claude Fable 5.1 | 판단 |
|---|---|---|---|
| Intelligence Index | 61 | 66 (max with fallback) | Fable 우위 |
| Coding Agent Index | 67 (Codex) | 70 (Claude Code) | Fable 우위 |
| HLE(도구 사용) | 57.2% | 65.0% | Fable 우위 |
| FrontierMath Tier 4 v2 | 97.6% | 87.8% | Astra 우위(자사 발표치) |
| Terminal-Bench 4.0 | 57.7% | 55.8% | Astra 소폭 우위(자사 발표치) |
Meta Muse Spark 1.3도 Intelligence Index에서 Astra를 앞서며, DeepSWE v1.1에서 75.4%(max reasoning)로 Astra의 74.1%보다 높다는 정리가 있습니다. 범용 추론과 코딩 에이전트가 목적이라면 Astra가 자동 선택지가 되지 않습니다.
Astra를 우선 후보로 올릴 조건은 세 가지로 좁혀집니다. 첫째, 컴퓨터 사용·GUI 자동화(OSWorld 2.0 72.6%, ScreenSpot-Pro 92.7%). 둘째, 1M 토큰급 롱컨텍스트 검색(MRCR v2 8-needle 512K–1M 구간 96.3%). 셋째, 터미널·시스템 운영(SRE-Bench 88.0%). 세 항목 모두 자사 발표치를 제3자가 옮긴 값이며, 원문 발표 페이지가 접근 차단되어 1차 출처로 직접 대조하지 못한 상태입니다(확인 필요).
미해소 상충도 하나 남겨둡니다. Artificial Analysis 모델 페이지는 Astra를 55점(202개 중 3위)으로 표기해 같은 기관 기사의 61점과 어긋납니다(2026년 9월 7일 확인). 인덱스 버전 차이로 추정되나 확정하지 못했으므로, 점수 하나를 근거로 의사결정하지 말고 자체 워크로드 실측을 권합니다. 참고로 Artificial Analysis가 Intelligence Index 1회 평가에 쓴 비용은 $4,063.77, 측정 출력 속도는 63.4 tokens/s였습니다. 벤치마크 재현에도 실제 예산이 든다는 뜻입니다.
정리
GPT 6 Astra는 2026년 9월 3일 발표된 모델로, API 기준 100만 토큰당 $10/$50이며 롱컨텍스트·Fast·Batch를 포함하면 4중 가격 구조입니다. 일반 추론에서는 독립 지표가 전작 Sol과 동점인데 과제당 비용은 약 75% 비싸므로 도입 근거가 약하고, GUI 자동화·터미널 운영·1M 토큰 롱컨텍스트에서는 개선폭이 뚜렷합니다. 발표문의 SOTA 수치는 하네스와 effort 설정에 크게 좌우되므로(ARC-AGI-3 62.7% vs 99.9%), 자체 워크로드 실측 없이 계획을 확정하지 않는 편이 안전합니다. 사내 도입이라면 시스템카드가 스스로 인정한 모니터 가능성 후퇴와 Daybreak 접근 통제를 리스크 항목으로 함께 문서화해야 합니다.
참고 자료
조사 기준일: 2026년 09월 07일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1
– OpenAI Developer Community 공식 공지 — https://community.openai.com/t/introducing-gpt-6-astra-the-most-intelligent-and-aligned-model-in-the-world/1394703 (확인 2026-09-07)
– OpenAI API 모델 문서 — https://developers.openai.com/api/docs/models/gpt-6-astra (확인 2026-09-07)
– OpenAI API 가격표 — https://developers.openai.com/api/docs/pricing (확인 2026-09-07)
– GPT-6 Astra 시스템카드(Deployment Safety Hub) — https://deploymentsafety.openai.com/gpt-6-astra (확인 2026-09-07)
– ARC Prize, OpenAI’s GPT-6 Astra on ARC-AGI-3 — https://arcprize.org/blog/astra (확인 2026-09-07)
– (403으로 원문 대조 실패, T1 불인정) https://openai.com/index/gpt-6-astra/ , https://openai.com/index/safety-overview-gpt-6-astra/ , https://help.openai.com/en/articles/20001258-openai-daybreak-trusted-access-for-cyber-overview
Tier 2
– Artificial Analysis, Benchmarking GPT-6 Astra — https://artificialanalysis.ai/articles/benchmarking-gpt-6-astra (확인 2026-09-07)
– Artificial Analysis 모델 페이지 — https://artificialanalysis.ai/models/gpt-6-astra (확인 2026-09-07)
– Vellum, GPT-6 Astra Benchmarks Explained — https://www.vellum.ai/blog/gpt-6-astra-benchmarks-explained (확인 2026-09-07)
– DataCamp, GPT-6 Astra: Features, Benchmarks, and Pricing — https://www.datacamp.com/blog/gpt-6-astra (확인 2026-09-07)
– Trending Topics, GPT-6 Astra Trails Top Models From Anthropic — https://www.trendingtopics.eu/gpt-6-astra-trails-top-models-from-anthropic-and-meta-in-benchmarks/ (확인 2026-09-07)
– OpenRouter 모델 페이지 — https://openrouter.ai/openai/gpt-6-astra (확인 2026-09-07)
– Wikipedia, GPT-6 Astra — https://en.wikipedia.org/wiki/GPT-6_Astra (확인 2026-09-07)
– 9to5Mac 롤아웃 보도 — https://9to5mac.com/2026/09/04/openai-releasing-major-upgrade-to-chatgpt-and-codex-with-gpt-6-astra-details-here/ (확인 2026-09-07)
– (제목만 확인, 본문 로드 실패) The New Stack — https://thenewstack.io/astra-arc-agi-benchmark/ , https://thenewstack.io/gpt6-astra-developer-access-delayed/ / (403) CNBC — https://www.cnbc.com/2026/09/03/open-ai-astra-gpt-6-cyber.html
답글 남기기