
문명6로 AI 에이전트 장기 수행을 재는 CivBench를 논문·저장소·데이터셋 원문과 대조했습니다. 23런이라는 표본 한계, RAG@10 48.2~65.8%, 1런 $31~229 비용까지 판단 기준을 정리합니다.
CivBench, 무엇을 기준으로 비교해야 할까
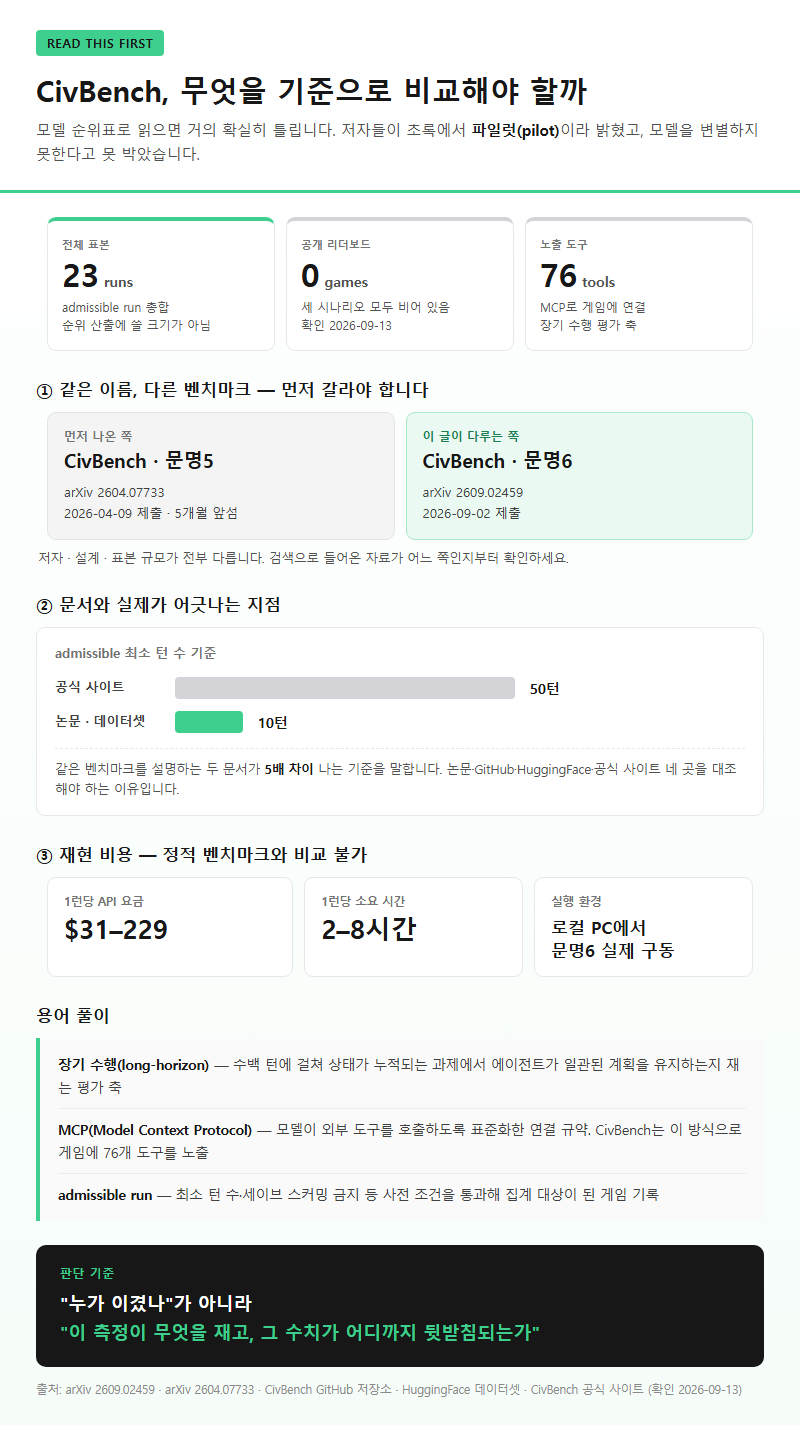
지금 시점에서 CivBench 결과를 모델 순위표로 읽으면 거의 확실히 틀립니다. 저자들이 초록에서 이 연구를 파일럿(pilot)이라 부르며 모델을 변별하지 못한다고 못 박았고, 전체 표본도 23개 admissible run뿐입니다(arXiv 2609.02459, 2026-09-02 제출). 이 글은 문명6 기반 CivBench를 논문 본문·GitHub 저장소·HuggingFace 데이터셋·공식 사이트 네 곳의 원문과 대조해, 이 벤치마크를 어떤 기준으로 읽고 무엇과 비교해야 하는지 정리했습니다. 게임 공략이나 문명6 플레이 팁은 다루지 않습니다.
비교가 필요한 이유는 세 가지입니다. 첫째, 같은 이름의 벤치마크가 두 개 있습니다. 문명5를 쓰는 CivBench(arXiv 2604.07733, 2026-04-09 제출)가 5개월 앞서 나왔는데, 이번 문명6판과 저자·설계·표본 규모가 전부 다릅니다. 검색으로 유입된 자료가 어느 쪽인지부터 갈라야 합니다. 둘째, 문서와 실제가 어긋나는 지점이 여럿입니다. 공식 사이트는 admissible 기준을 최소 50턴으로 적어두었지만 논문·데이터셋의 기준은 최소 10턴이고, 공개 리더보드는 세 시나리오 모두 “0 games played” 상태입니다(확인 2026-09-13). 셋째, 재현 비용이 정적 벤치마크와 비교 불가한 수준입니다. 1런당 API 요금 약 $31~229, 소요 2~8시간이며 로컬 PC에서 문명6를 실제로 구동해야 합니다.
정리하면 판단 기준은 “누가 이겼나”가 아니라 “이 측정이 무엇을 재고, 그 수치가 어디까지 뒷받침되는가”여야 합니다.
용어 풀이
1. 장기 수행(long-horizon) — 수백 턴에 걸쳐 상태가 누적되는 과제에서 에이전트가 일관된 계획을 유지하는지 재는 평가 축입니다.
2. MCP(Model Context Protocol) — 모델이 외부 도구를 호출하도록 표준화한 연결 규약입니다. CivBench는 이 방식으로 게임에 76개 도구를 노출합니다.
3. admissible run — 사전에 정한 조건(최소 턴 수, 세이브 스커밍 금지 등)을 통과해 집계 대상이 된 게임 기록입니다.
비교 기준 정리
CivBench 계열 자료를 볼 때 짚어야 할 항목을 단위·주의점과 함께 정리했습니다. 이 표의 값은 모두 논문 본문 또는 공식 배포처에서 확인했고, 매체 보도로만 확인된 값은 뒤에서 따로 구분했습니다.
| 항목 | 값·단위 | 주의점 |
|---|---|---|
| 환경 구성 | MCP 서버 + 76개 도구 | 도구 수가 많다고 호출이 늘지는 않음 |
| 에피소드 길이 | 300턴 이상 / 수천 회 도구 호출 | 컨텍스트 누적으로 후반 비용이 급증 |
| 표본 | 23 admissible run, 4개 모델 계열 | 모델 간 비교 통계로는 부족 |
| PMR | 비인프라 호출의 0.96~2.13% | 자발적 상태 점검 비율 |
| 승리 진행도 조회 | 전체 호출의 0.05~0.29% / 게임당 3.7~10.0회 | 지시가 있어도 거의 안 봄 |
| 조회 간격 | 지시 20턴 vs 실측 30~75턴 | 지시 이탈이 핵심 관찰 |
| RAG@10 | 48.2~65.8% | 부트스트랩 신뢰구간이 서로 겹침 |
| 라벨링 검증 | 50건 표본, 92.0% 일치 | Claude Haiku 4.5가 고정 루브릭으로 수행 |
| 1런 비용 | $31~229, 2~8시간 (기준일 2026-09-13) | 로컬 PC 점유 시간은 별도 |
두 지표의 의미를 구분해야 합니다. PMR은 “묻지 않아도 보는가”를 재고, RAG@10은 “적어둔 계획을 실제로 실행하는가”를 잽니다. 후자는 10턴이라는 판정 창 안에 자기 커밋먼트가 실행됐는지를 보는 것이라, 낮다고 해서 모델이 계획을 잊었다는 뜻은 아닙니다. 일본 IT 매체 Postation도 2026-09-08 기사에서 이 점을 짚으며, RAG@10은 망각이 아니라 실행 타이밍을 재는 지표라고 정리했습니다.
주의할 값도 있습니다. 모델별 RAG@10 개별 수치는 논문 본문 텍스트나 표에 없고 Figure 4 그림에만 있습니다. 그래서 매체 귀속이 엇갈립니다 — Let’s Data Science 기사는 Claude Opus 4.6 48.2%, GPT-5.4 63.2%, Gemini 3.1 Pro 65.8%로 적었으나, 초록이 제시한 범위 상단 65.8%와 GPT 값의 관계는 원문에서 확인되지 않았습니다. 모델별 귀속은 확인 필요 항목으로 남겨둡니다.
용어 풀이
1. PMR(Proactive Monitoring Rate) — 에이전트가 시키지 않아도 게임 상태를 스스로 조회한 비율입니다.
2. RAG@10 — 에이전트가 스스로 밝힌 단기 계획이 이후 10턴 안에 실제 행동으로 이어진 비율입니다.
3. 세이브 스커밍(save scumming) — 불리한 결과가 나오면 저장 지점으로 되돌려 다시 시도하는 행위로, 집계에서 배제 사유가 됩니다.
옵션·유형별 비교
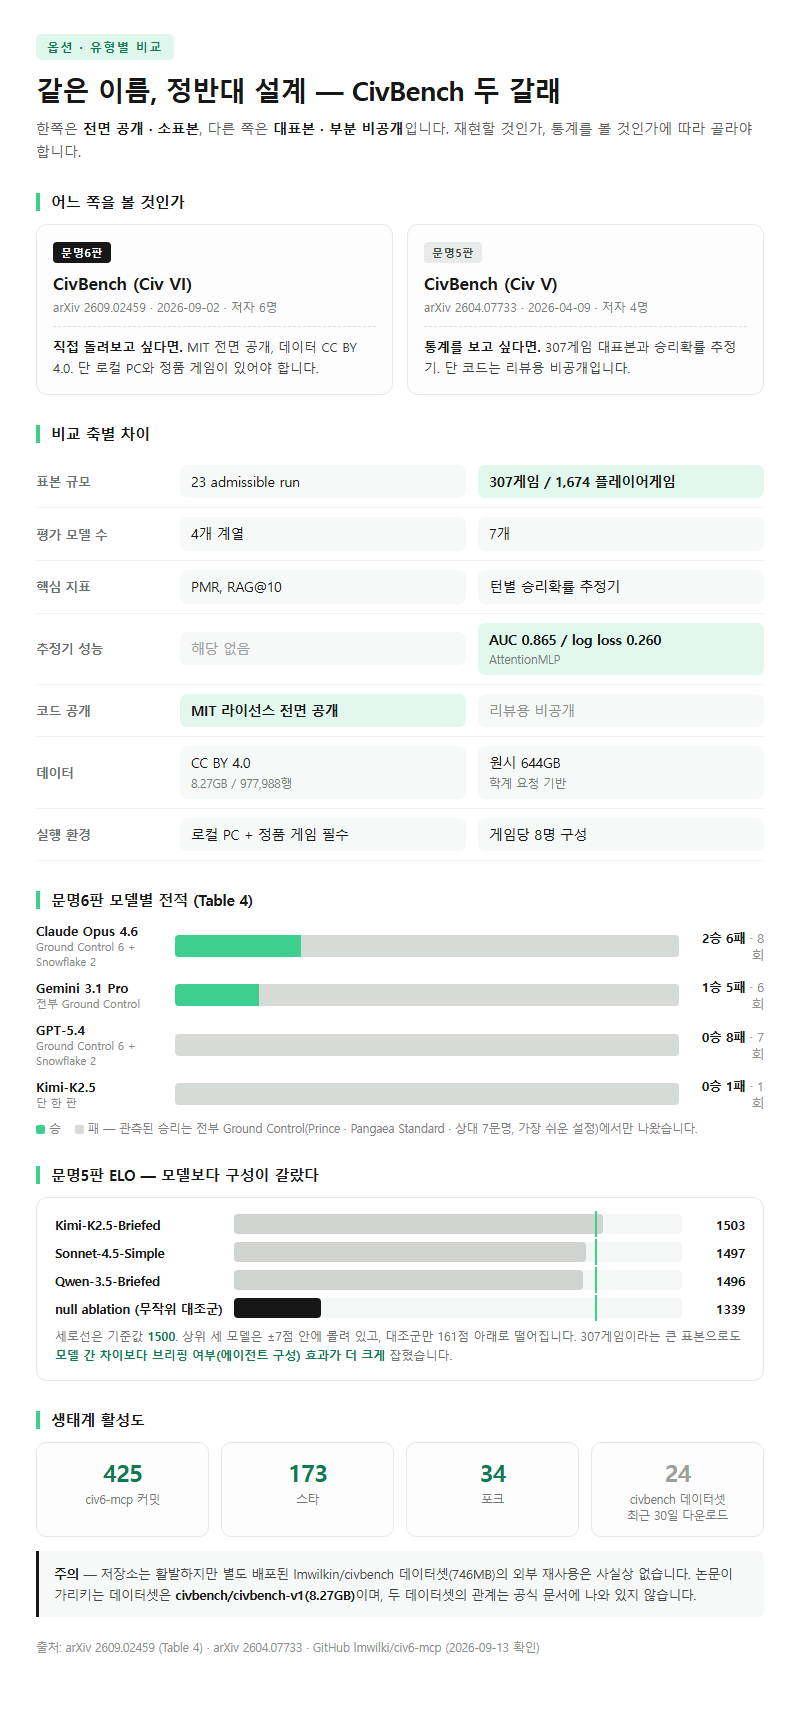
같은 이름을 쓰는 두 벤치마크는 설계 철학이 정반대입니다. 한쪽은 전면 공개·소표본, 다른 쪽은 대표본·부분 비공개입니다.
| 비교 축 | CivBench (문명6) | CivBench (문명5) |
|---|---|---|
| arXiv ID / 제출일 | 2609.02459 / 2026-09-02 | 2604.07733 / 2026-04-09 |
| 저자 수 | 6명 | 4명 |
| 표본 | 23 admissible run | 307게임 / 1,674 플레이어게임 |
| 평가 모델 수 | 4개 계열 | 7개 |
| 핵심 지표 | PMR, RAG@10 | 턴별 승리확률 추정기 |
| 추정기 성능 | 해당 없음 | AttentionMLP AUC 0.865 / log loss 0.260 |
| 코드 공개 | MIT 라이선스 전면 공개 | 리뷰용 비공개 |
| 데이터 | CC BY 4.0, 8.27GB / 977,988행 | 원시 644GB, 학계 요청 기반 |
| 실행 환경 | 로컬 PC + 정품 게임 필수 | 게임당 8명 구성 |
문명6판의 모델별 전적은 Claude Opus 4.6 2승 6패, Gemini 3.1 Pro 1승 5패, GPT-5.4 0승 8패, Kimi-K2.5 0승 1패입니다(Table 4). 다만 런 분포가 균등하지 않습니다 — Claude 8회(Ground Control 6 + Snowflake 2), GPT-5.4 7회(6+2), Gemini 6회(전부 Ground Control), Kimi 1회로, Kimi는 단 한 판입니다. 관측된 승리는 전부 Ground Control 시나리오에서만 나왔습니다. 난이도 Prince·Pangaea Standard·상대 7문명인 가장 쉬운 설정입니다.
문명5판의 ELO는 오히려 모델 변별의 어려움을 보여줍니다. Sonnet-4.5-Simple 1497, Kimi-K2.5-Briefed 1503, Qwen-3.5-Briefed 1496으로 기준값 1500 근방에 몰려 있고, 무작위 대조군에 해당하는 null ablation만 1339로 떨어집니다. 307게임이라는 훨씬 큰 표본으로도 모델 간 차이보다 에이전트 구성(브리핑 여부) 효과가 더 크게 잡힌 셈입니다.
생태계 활성도도 갈립니다. 문명6판 저장소 lmwilki/civ6-mcp는 확인 시점 커밋 425개, 스타 173, 포크 34입니다(2026-09-13). 반면 별도 배포된 lmwilkin/civbench 데이터셋(746MB)의 최근 30일 다운로드는 24회로, 외부 재사용은 사실상 없습니다. 참고로 논문이 가리키는 데이터셋은 civbench/civbench-v1(8.27GB)이며, 두 데이터셋의 관계는 공식 문서에 나와 있지 않습니다.
상황별 추천
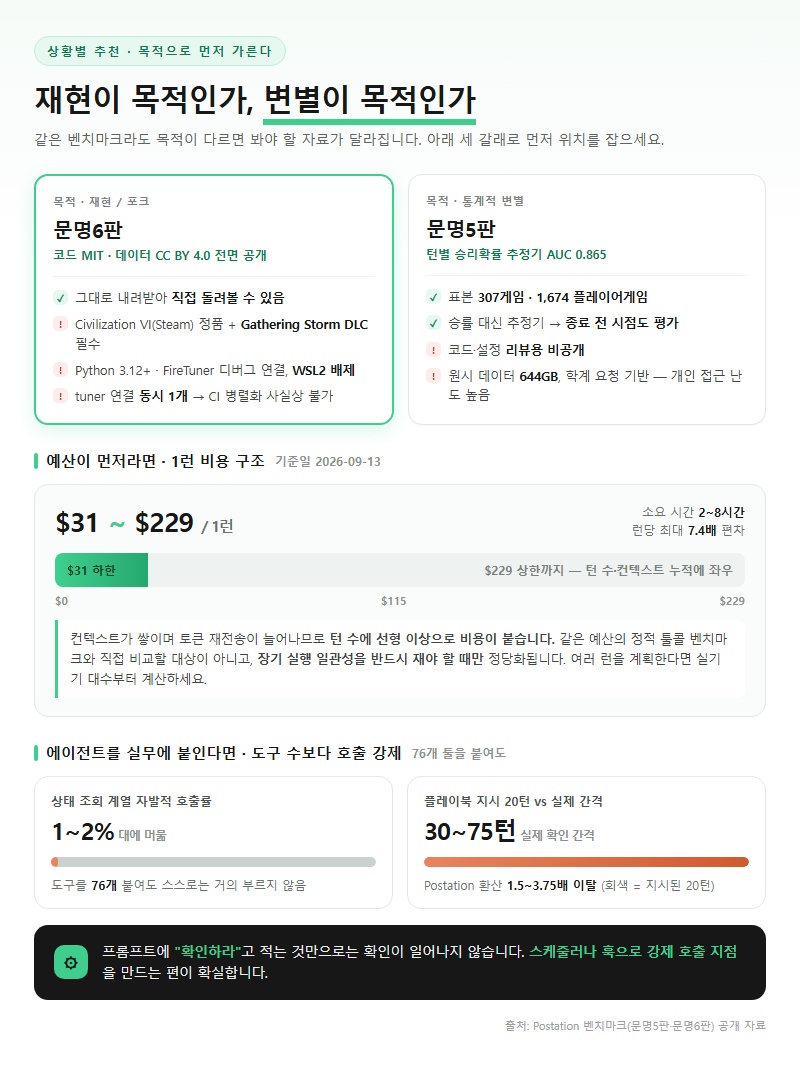
목적에 따라 봐야 할 자료가 달라집니다. 아래는 조건별 판단입니다.
재현·포크가 목적이라면 문명6판입니다. 코드가 MIT, 데이터가 CC BY 4.0으로 전면 공개돼 있어 그대로 돌려볼 수 있습니다. 다만 진입 조건이 뻑뻑합니다 — Civilization VI(Steam) 정품과 Gathering Storm DLC, Python 3.12+, FireTuner 디버그 인터페이스 연결이 필요하고, tuner 연결은 동시에 1개만 허용됩니다. WSL2도 배제됩니다. 이 조건이면 CI 병렬화가 사실상 불가능하므로, 여러 런을 돌릴 계획이라면 실기기 대수부터 계산해야 합니다.
통계적 변별이 목적이라면 문명5판입니다. 307게임·1,674 플레이어게임 표본에 승률 대신 턴별 승리확률 추정기(AUC 0.865)를 써서, 게임이 끝나기 전 시점에도 진행도를 평가하도록 설계했습니다. 대신 코드·설정이 리뷰용 비공개이고 원시 데이터 644GB는 학계 요청 기반이라, 개인이 바로 손대기는 어렵습니다.
예산 판단이 필요하다면 비용 구조를 먼저 봅니다. 1런에 $31~229, 2~8시간(기준일 2026-09-13)이며 컨텍스트 누적으로 토큰 재전송이 늘어나는 구조라 턴 수에 선형 이상으로 비용이 붙습니다. 같은 예산으로 돌릴 수 있는 정적 툴콜 벤치마크와 직접 비교할 대상이 아니고, 장기 실행 일관성을 반드시 재야 할 때만 정당화됩니다.
에이전트를 실무에 붙이려는 개발자라면 도구 수보다 호출 강제 설계를 봐야 합니다. 76개를 붙여도 상태 조회 계열의 자발적 호출은 1~2%대에 머물렀고, 20턴마다 확인하라는 플레이북 지시에도 실제 간격은 30~75턴이었습니다. Postation은 이를 1.5~3.75배 이탈로 환산했습니다. 프롬프트에 “확인하라”고 적는 것만으로는 확인이 일어나지 않으니, 스케줄러나 훅으로 강제 호출 지점을 만드는 편이 확실합니다.
자주 하는 실수
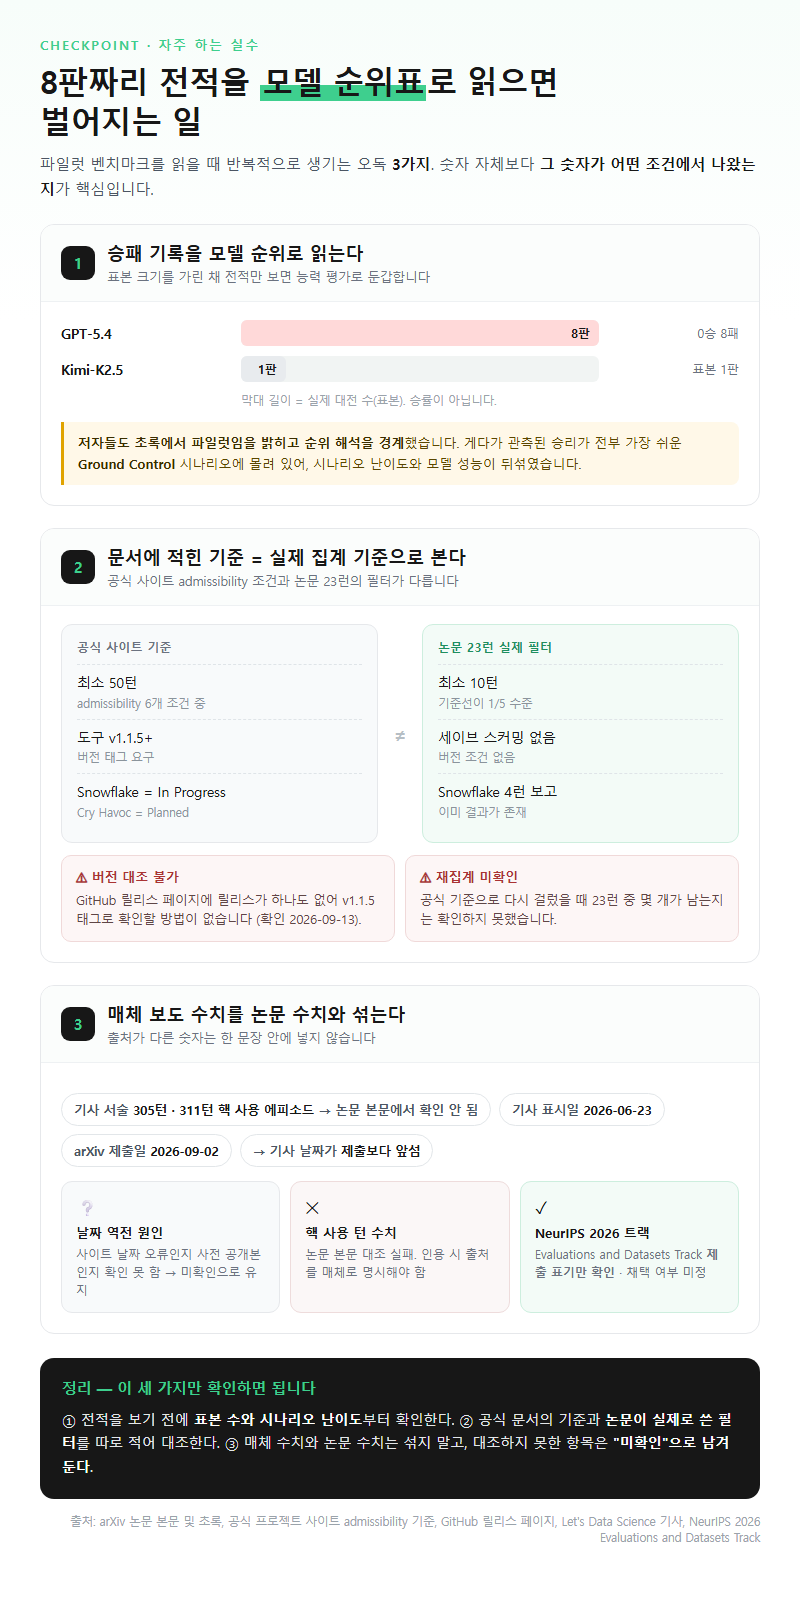
첫째, 승패 기록을 모델 순위로 읽는 것입니다. GPT-5.4의 0승 8패는 강렬해 보이지만 표본이 8판이고, Kimi-K2.5는 단 1판입니다. 저자들이 초록에서 파일럿임을 밝히고 순위 해석을 경계했다는 점을 건너뛰면, 8판짜리 전적이 모델 능력 평가로 둔갑합니다. 게다가 관측된 승리가 전부 가장 쉬운 Ground Control 시나리오에 몰려 있어, 시나리오 난이도와 모델 성능이 뒤섞였습니다.
둘째, 문서에 적힌 기준과 실제 집계 기준을 같은 것으로 보는 것입니다. 공식 사이트는 admissibility 6개 조건에 “최소 50턴”과 “v1.1.5+ 도구 버전”을 넣었지만, 논문의 23런은 최소 10턴·세이브 스커밍 없음 기준으로 걸렀습니다. 게다가 GitHub 릴리스 페이지에는 릴리스가 하나도 없어 v1.1.5라는 버전 태그로 대조할 방법이 없습니다(확인 2026-09-13). 공식 기준으로 다시 걸렀을 때 23런 중 몇 개가 남는지는 확인하지 못했습니다. 시나리오 상태도 어긋납니다 — 사이트는 Snowflake를 In Progress, Cry Havoc을 Planned로 표기하는데 논문은 이미 Snowflake 4런을 보고했습니다.
셋째, 매체 보도 수치를 논문 수치와 섞는 것입니다. Let’s Data Science 기사가 서술한 305턴·311턴 핵 사용 에피소드는 논문 본문에서 확인되지 않았습니다. 같은 기사의 표시 날짜가 2026-06-23으로 arXiv 제출일(2026-09-02)보다 앞서는 점도 정리되지 않았습니다. 사이트 날짜 오류인지 사전 공개본을 다룬 것인지 확인하지 못했으므로, 이 대목은 미확인으로 두는 편이 안전합니다. 또한 NeurIPS 2026 Evaluations and Datasets Track은 제출 표기만 확인됐을 뿐 채택 여부는 미정입니다.
정리
CivBench 문명6판은 모델을 줄 세우는 도구가 아니라, 에이전트가 장기 과제에서 자기 계획을 얼마나 실행하고 상태를 얼마나 점검하는지를 처음으로 수백 턴 규모에서 계측한 파일럿입니다. 23런·4개 모델 계열이라는 표본은 순위 해석을 지탱하지 못하며, 저자들도 같은 취지로 선을 그었습니다. 재현·포크가 목적이면 MIT + CC BY 4.0으로 전부 열려 있는 문명6판을, 통계적 변별이 목적이면 307게임 표본의 문명5판(arXiv 2604.07733)을 보는 편이 맞습니다. 실무에 옮길 교훈 한 줄은 이것입니다 — 도구를 76개 붙여도 호출을 강제하지 않으면 에이전트는 1~2%만 스스로 확인한다.
참고 자료
조사 기준일: 2026년 09월 13일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1
– arXiv abs 2609.02459 — https://arxiv.org/abs/2609.02459 (확인 2026-09-13)
– arXiv HTML 전문 2609.02459v1 — https://arxiv.org/html/2609.02459v1 (확인 2026-09-13)
– arXiv abs 2604.07733 — https://arxiv.org/abs/2604.07733 (확인 2026-09-13)
– arXiv HTML 전문 2604.07733v1 — https://arxiv.org/html/2604.07733v1 (확인 2026-09-13)
– GitHub lmwilki/civ6-mcp — https://github.com/lmwilki/civ6-mcp (확인 2026-09-13)
– GitHub 릴리스 페이지 — https://github.com/lmwilki/civ6-mcp/releases (확인 2026-09-13)
– 공식 CivBench 페이지 — https://civ6-mcp.lwilko.com/civbench (확인 2026-09-13)
– HuggingFace civbench/civbench-v1 — https://huggingface.co/datasets/civbench/civbench-v1 (확인 2026-09-13)
Tier 2
– Let’s Data Science, “AI Agent Triggers Nuclear Strike in Civilization VI” — https://letsdatascience.com/news/ai-agent-triggers-nuclear-strike-in-civilization-vi-f7f1a843 (확인 2026-09-13)
– Postation(일본 IT 매체) CivBench 해설 기사, 2026-09-08 — https://www.postation.jp/news/civbench-long-horizon-agent-benchmark-civilization-vi-pmr-rag10-2026 (확인 2026-09-13)
– papers.cool 집계 페이지 — https://papers.cool/arxiv/2609.02459 (확인 2026-09-13)
– HuggingFace lmwilkin/civbench — https://huggingface.co/datasets/lmwilkin/civbench (확인 2026-09-13)
답글 남기기