
Gemini 3.8 Flash와 Cyber 버전의 실제 차이를 가격·벤치마크·접근 조건으로 정리했습니다. Cyber는 API가 없고 Fairwind 심사를 통과한 기관만 쓸 수 있으며, 일반판은 단가 동결에도 태스크 비용이 약 40% 올랐습니다. (2026년 9월 15일 기준)
Gemini 3.8 Flash 개요
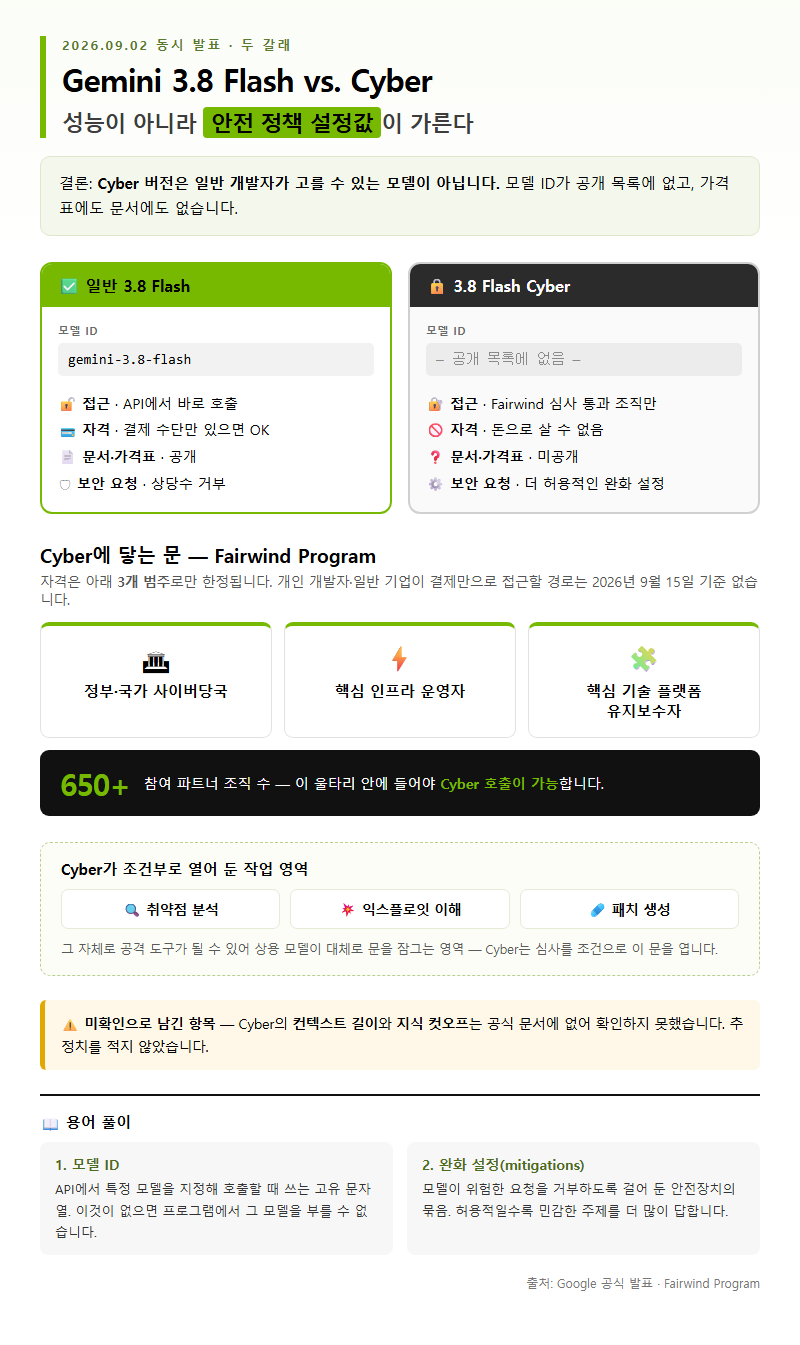
결론부터 말하면, Gemini 3.8 Flash Cyber 버전은 일반 개발자가 고를 수 있는 모델이 아닙니다. 두 모델은 2026년 9월 2일 같은 날 발표됐습니다. 그런데 일반 3.8 Flash는 gemini-3.8-flash라는 모델 ID로 API에서 바로 호출되는 반면, Cyber 변종은 공개 모델 목록에 모델 ID조차 없습니다. 가격표에도, 문서에도 없습니다. 이 글은 두 버전의 차이를 접근 조건·성능 지표·비용 구조 세 축으로 정리했고, Cyber의 컨텍스트 길이나 지식 컷오프처럼 공식 문서에 없는 항목은 미확인으로 남겨 두었습니다.
두 모델을 가르는 것은 성능이 아니라 안전 정책의 설정값입니다. Google 공식 발표에 따르면 Cyber는 일반 3.8 Flash보다 사이버보안 영역에서 더 허용적인 완화 설정으로 출하됩니다. 쉽게 말해 일반판이 거부하는 종류의 보안 관련 요청을 Cyber는 처리합니다. 취약점 분석·익스플로잇 이해·패치 생성 같은 작업은 그 자체가 공격 도구로 전용될 수 있어 상용 모델이 대체로 문을 걸어 잠그는 영역인데, Cyber는 그 문을 조건부로 열어 둔 모델입니다.
그래서 접근 통제가 붙습니다. Cyber는 Fairwind Program이라는 심사를 통과한 조직만 쓸 수 있고, 자격은 정부·국가 사이버당국, 핵심 인프라 운영자, 핵심 기술 플랫폼 유지보수자 3개 범주로 한정됩니다. 참여 파트너는 650곳 이상입니다. 개인 개발자나 일반 기업이 결제 수단만으로 접근할 방법은 2026년 9월 15일 기준 없습니다.
용어 풀이
1. 모델 ID — API에서 특정 모델을 지정해 호출할 때 쓰는 고유 문자열로, 이것이 없으면 프로그램에서 그 모델을 부를 수 없습니다.
2. 완화 설정(mitigations) — 모델이 위험한 요청을 거부하도록 걸어 둔 안전장치의 묶음으로, 허용적일수록 민감한 주제를 더 많이 답합니다.
1. 일반판과 Cyber판, 공개된 정보의 비대칭
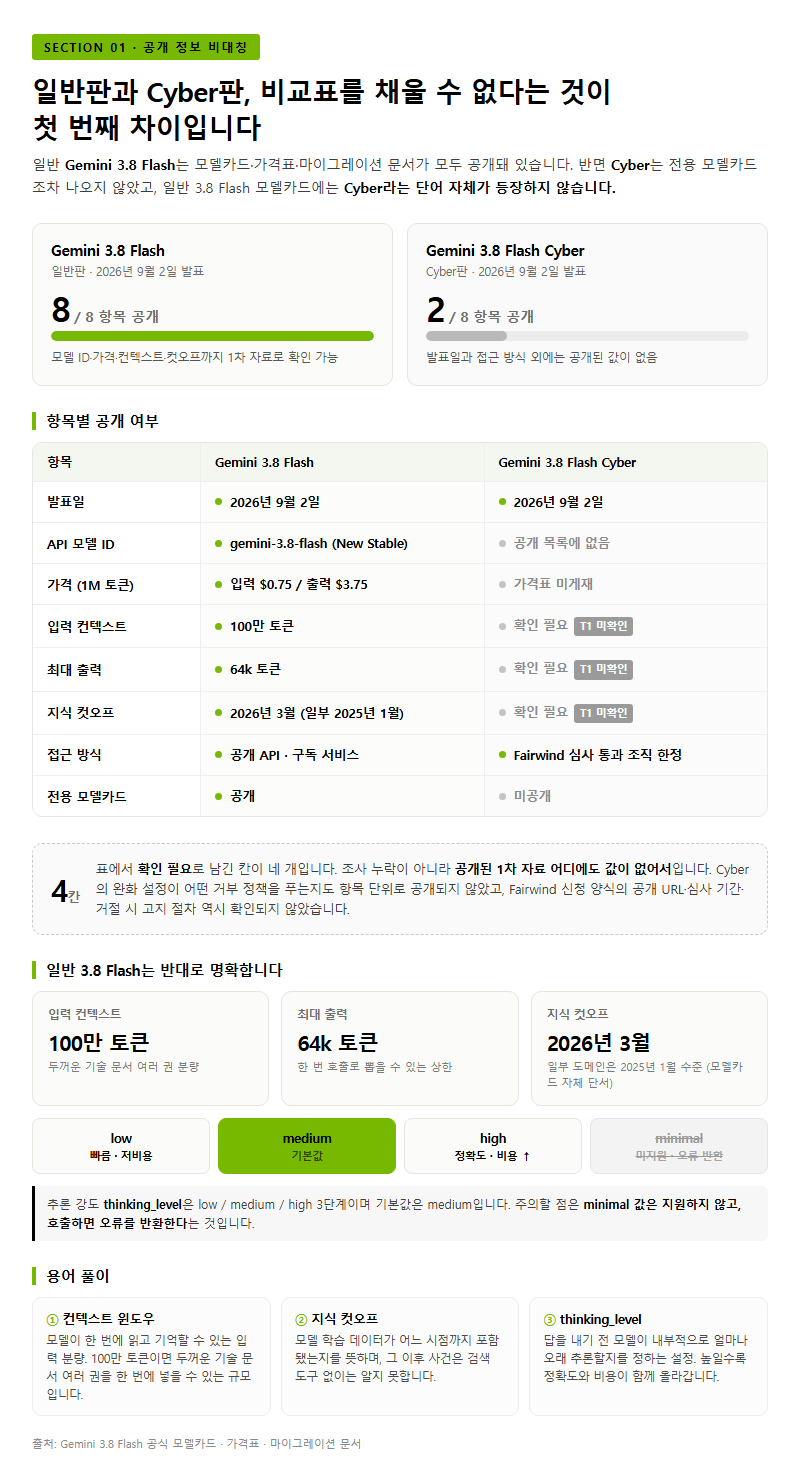
두 버전을 비교하려 해도 비교표를 채울 수 없다는 점이 첫 번째 차이입니다. 일반 3.8 Flash는 모델카드·가격표·마이그레이션 문서가 모두 공개돼 있지만, Cyber는 전용 모델카드조차 나오지 않았습니다. 일반 3.8 Flash 모델카드에는 Cyber라는 단어 자체가 등장하지 않습니다.
| 항목 | Gemini 3.8 Flash | Gemini 3.8 Flash Cyber |
|---|---|---|
| 발표일 | 2026년 9월 2일 | 2026년 9월 2일 |
| API 모델 ID | gemini-3.8-flash (New Stable) |
공개 목록에 없음 |
| 가격 | 입력 $0.75 / 출력 $3.75 (1M 토큰) | 가격표 미게재 |
| 입력 컨텍스트 | 100만 토큰 | 확인 필요 (T1 미확인) |
| 최대 출력 | 64k 토큰 | 확인 필요 (T1 미확인) |
| 지식 컷오프 | 2026년 3월 (일부 도메인은 2025년 1월) | 확인 필요 (T1 미확인) |
| 접근 방식 | 공개 API·구독 서비스 | Fairwind 심사 통과 조직 한정 |
| 전용 모델카드 | 공개 | 미공개 |
표에서 확인 필요로 남긴 칸이 네 개입니다. 조사 누락이 아니라 공개된 1차 자료 어디에도 값이 없어서입니다. Cyber의 완화 설정이 구체적으로 어떤 거부 정책을 푸는지도 항목 단위로 공개되지 않았습니다. Fairwind 신청 양식의 공개 URL·심사 기간·거절 시 고지 절차 역시 확인되지 않았습니다.
일반 3.8 Flash의 사양은 반대로 명확합니다. 입력 100만 토큰, 출력 최대 64k 토큰이고, 지식 컷오프는 2026년 3월입니다. 다만 모델카드가 일부 도메인은 2025년 1월 수준에 머문다는 단서를 스스로 달아 두었습니다. 추론 강도는 thinking_level로 low/medium/high 3단계이며 기본값은 medium입니다. 주의할 점은 minimal 값은 지원하지 않고 호출하면 오류를 반환한다는 것입니다.
용어 풀이
1. 컨텍스트 윈도우 — 모델이 한 번에 읽고 기억할 수 있는 입력 분량으로, 100만 토큰이면 두꺼운 기술 문서 여러 권을 한 번에 넣을 수 있는 규모입니다.
2. 지식 컷오프 — 모델 학습 데이터가 어느 시점까지 포함됐는지를 뜻하며, 그 이후 사건은 검색 도구 없이는 알지 못합니다.
3. thinking_level — 답을 내기 전 모델이 내부적으로 얼마나 오래 추론할지를 정하는 설정으로, 높일수록 정확도와 비용이 함께 올라갑니다.
2. Cyber 성능 수치는 어디까지 믿을 수 있나
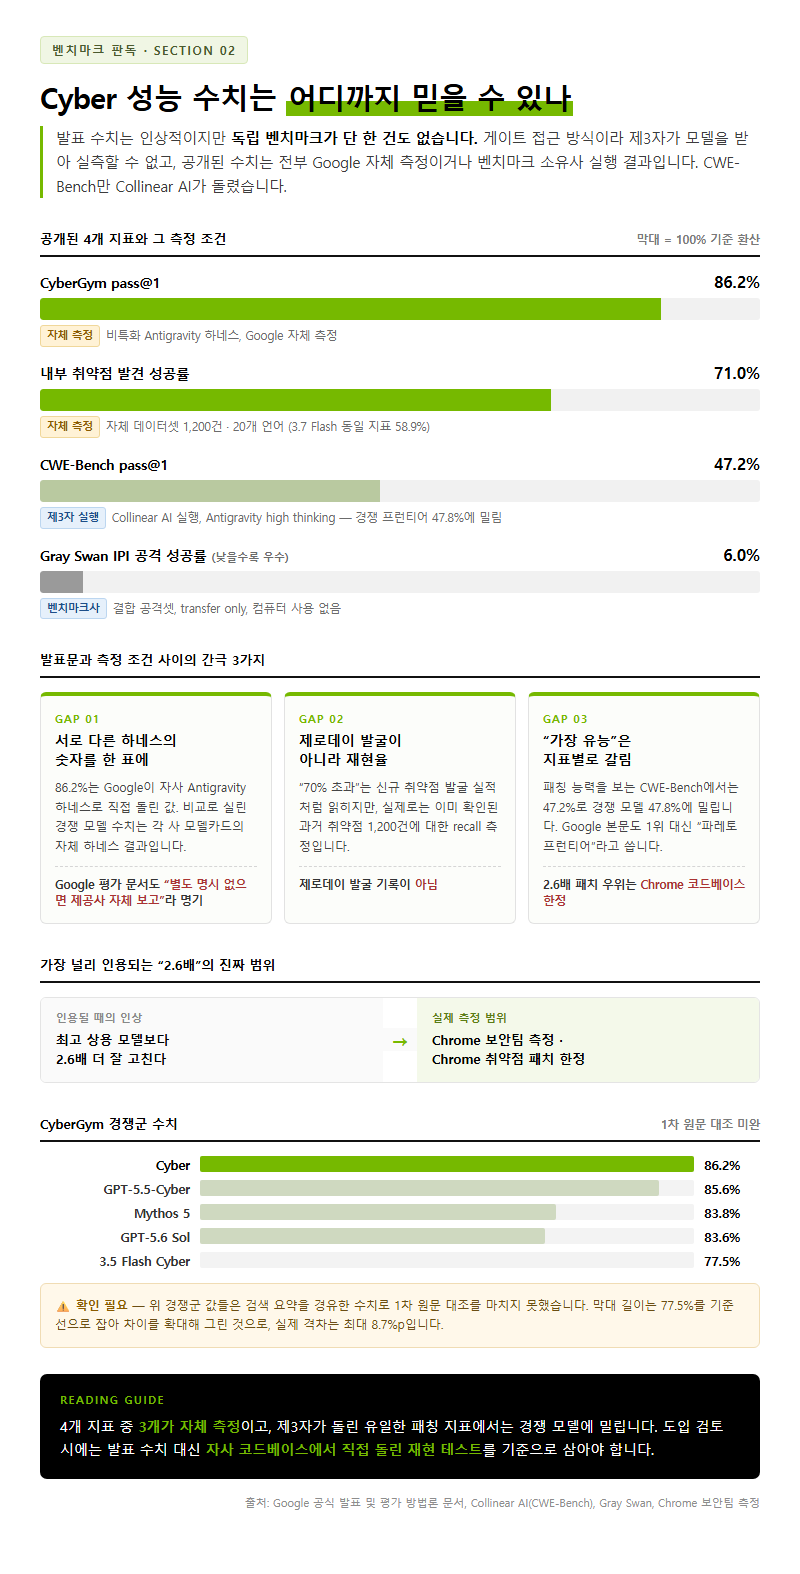
Cyber의 발표 수치는 인상적이지만, 독립 벤치마크가 단 한 건도 없습니다. 게이트 접근 방식이라 제3자가 모델을 받아 실측할 수 없고, 현재 공개된 Cyber 수치는 전부 Google 자체 측정이거나 벤치마크 소유사가 실행한 결과입니다. CWE-Bench만 Collinear AI가 실행했습니다.
| 지표 | Cyber 점수 | 측정 조건 |
|---|---|---|
| CyberGym pass@1 | 86.2% | 비특화 Antigravity 하네스, Google 자체 측정 |
| CWE-Bench pass@1 | 47.2% | Collinear AI 실행, Antigravity high thinking |
| Gray Swan IPI 공격 성공률 | 6.0% (낮을수록 우수) | 결합 공격셋, transfer only, 컴퓨터 사용 없음 |
| 내부 취약점 발견 성공률 | 70% 초과 (71.0%) | 자체 데이터셋 1,200건·20개 언어 |
여기서 발표문과 실제 측정 조건 사이의 간극을 짚어야 합니다. 첫째, CyberGym 86.2%는 Google이 자사 Antigravity 하네스로 직접 돌린 결과이고, 비교 대상으로 제시된 경쟁 모델 수치는 각 사 모델카드에 실린 자체 하네스 결과를 그대로 가져온 것입니다. 서로 다른 실행 환경의 숫자를 한 표에 놓은 비교입니다. Google 평가 방법론 문서도 별도 명시가 없으면 제공사 자체 보고 수치라고 명기합니다.
둘째, 취약점 발견 성공률 70% 초과라는 문구는 신규 취약점을 발굴한 실적처럼 읽히지만, 실제로는 이미 확인된 과거 취약점 1,200건에 대한 재현율(recall) 측정입니다. 제로데이 발굴 기록이 아닙니다. 참고로 3.7 Flash의 동일 내부 지표는 58.9%로 보고됐습니다.
셋째, 가장 유능한 사이버보안 모델이라는 서열 주장은 지표별로 갈립니다. 패칭 능력을 보는 CWE-Bench에서는 Cyber가 47.2%로 경쟁 프런티어 모델 47.8%에 밀립니다. Google 본문도 1위라고 쓰지 않고 파레토 프런티어라는 표현을 씁니다. 가장 널리 인용된 수치는 Chrome 보안팀 측정으로, Cyber가 훨씬 큰 최고 상용 모델들보다 Chrome 취약점에 대해 올바른 패치를 2.6배 더 많이 생성했다는 것입니다. 이 역시 Chrome이라는 특정 코드베이스에 한정된 측정입니다.
CyberGym 경쟁군 수치로는 GPT-5.5-Cyber 85.6%, Mythos 5 83.8%, GPT-5.6 Sol 83.6%, 3.5 Flash Cyber 77.5%가 거론되지만, 이 값들은 검색 요약 경유라 1차 원문 대조를 마치지 못했습니다(확인 필요).
3. 일반 3.8 Flash의 성능과 숨은 비용 구조
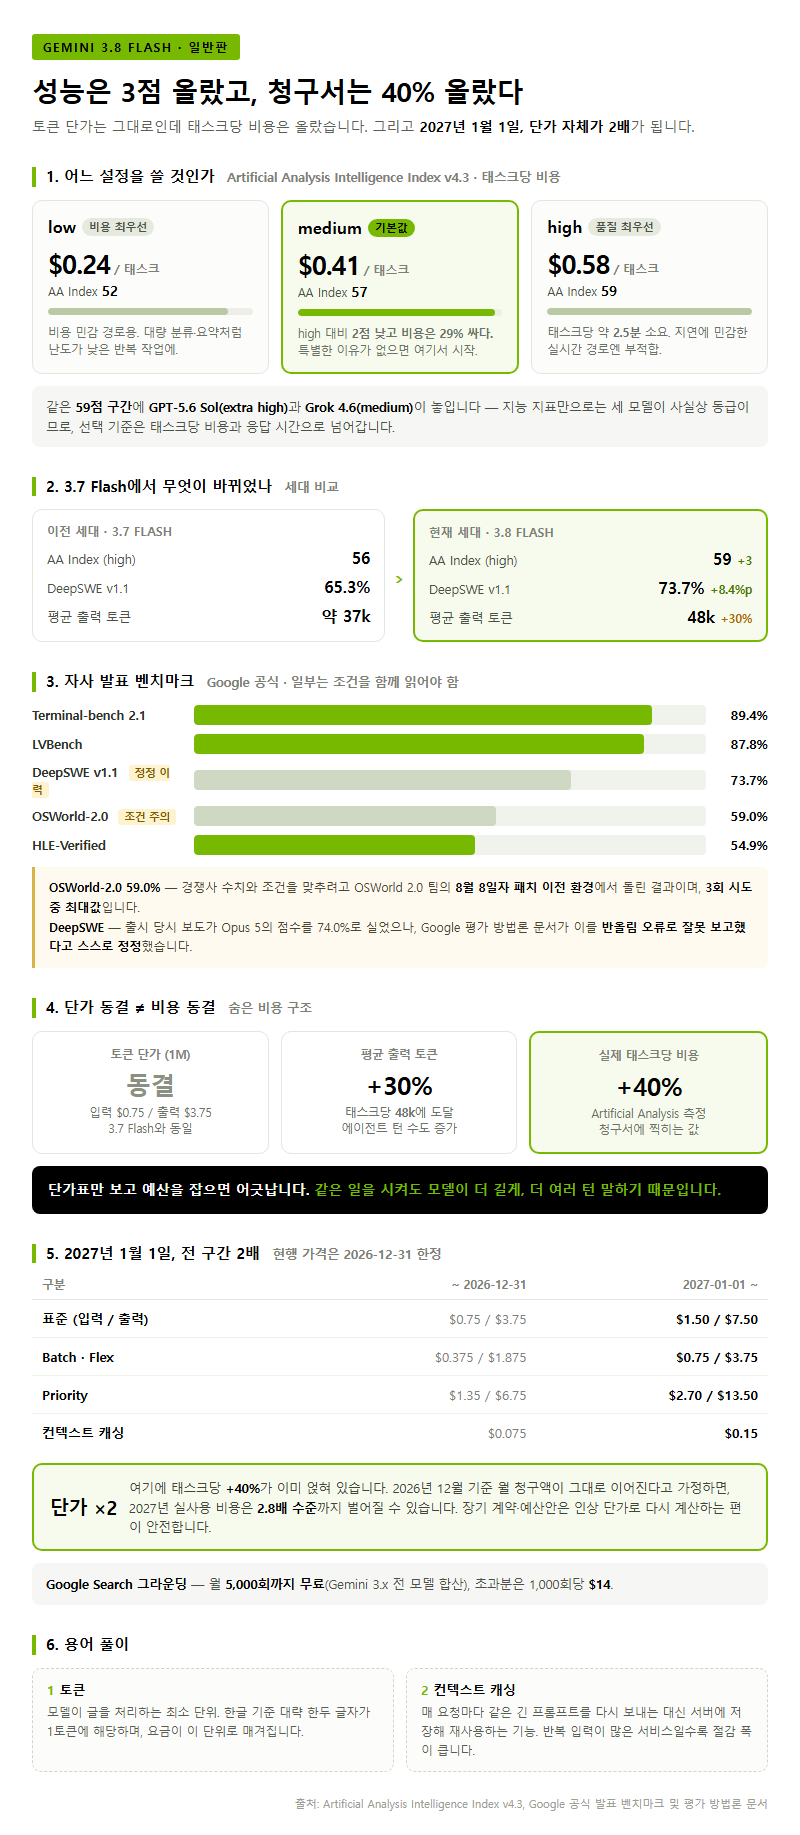
일반판으로 넘어오면 독립 측정이 있습니다. Artificial Analysis 측정 기준 Intelligence Index v4.3에서 high 설정 59점, medium 57점, low 52점입니다. 3.7 Flash의 high가 56점이었으니 3점 상승입니다. 같은 59점 구간에 GPT-5.6 Sol(extra high)과 Grok 4.6(medium)이 놓입니다.
| 설정 | AA Index | 태스크당 비용 | 비고 |
|---|---|---|---|
| high | 59 | $0.58 | 태스크당 약 2.5분 소요 |
| medium | 57 | $0.41 | 기본값 |
| low | 52 | $0.24 | 비용 민감 경로용 |
Google 자사 발표 벤치마크는 DeepSWE v1.1 73.7%, Terminal-bench 2.1 89.4%, LVBench 87.8%, OSWorld-2.0 59.0%, HLE-Verified 54.9%입니다. 이 중 두 가지는 조건을 함께 읽어야 합니다. OSWorld-2.0 59.0%는 경쟁사 수치와 조건을 맞추려고 OSWorld 2.0 팀의 8월 8일자 패치 이전 환경에서 돌린 결과이며, 3회 시도 중 최대값입니다. 그리고 출시 당시 보도가 Opus 5의 DeepSWE 점수를 74.0%로 실었는데, Google 평가 방법론 문서가 이를 반올림 오류로 잘못 보고했다고 스스로 정정했습니다. 참고로 3.7 Flash의 DeepSWE v1.1은 65.3%였습니다.
비용 구조가 이 글에서 가장 실무적인 부분입니다. 토큰 단가는 입력 $0.75 / 출력 $3.75(1M 토큰)로 3.7 Flash와 같습니다. 그런데 Artificial Analysis 측정으로는 태스크당 실제 비용이 약 40% 올랐습니다. 원인은 태스크당 평균 출력 토큰이 30% 증가해 48k에 달하고 에이전트 턴 수가 늘어난 데 있습니다. 단가 동결이 곧 비용 동결은 아닙니다.
여기에 2027년 1월 1일부터 단가 자체가 2배가 됩니다. 현행 가격은 2026년 12월 31일까지 한정입니다.
| 구분 | 2026-12-31까지 | 2027-01-01부터 |
|---|---|---|
| 표준 (입력/출력) | $0.75 / $3.75 | $1.50 / $7.50 |
| Batch·Flex | $0.375 / $1.875 | 2배 인상 |
| Priority | $1.35 / $6.75 | 2배 인상 |
| 컨텍스트 캐싱 | $0.075 | 2배 인상 |
Google Search 그라운딩은 월 5,000회까지 무료이며(Gemini 3.x 전 모델 합산), 초과분은 1,000회당 $14입니다.
용어 풀이
1. 토큰 — 모델이 글을 처리하는 최소 단위로, 한글 기준 대략 한두 글자가 1토큰에 해당하며 요금이 이 단위로 매겨집니다.
2. 컨텍스트 캐싱 — 매 요청마다 같은 긴 프롬프트를 다시 보내는 대신 서버에 저장해 재사용하는 기능으로, 반복 입력이 많은 서비스의 비용을 크게 낮춥니다.
3. 하네스(harness) — 모델에 도구·환경·재시도 규칙을 붙여 벤치마크를 실행하는 실행 틀로, 같은 모델이라도 하네스가 다르면 점수가 달라집니다.
4. 경쟁 구도와 실제 선택 기준
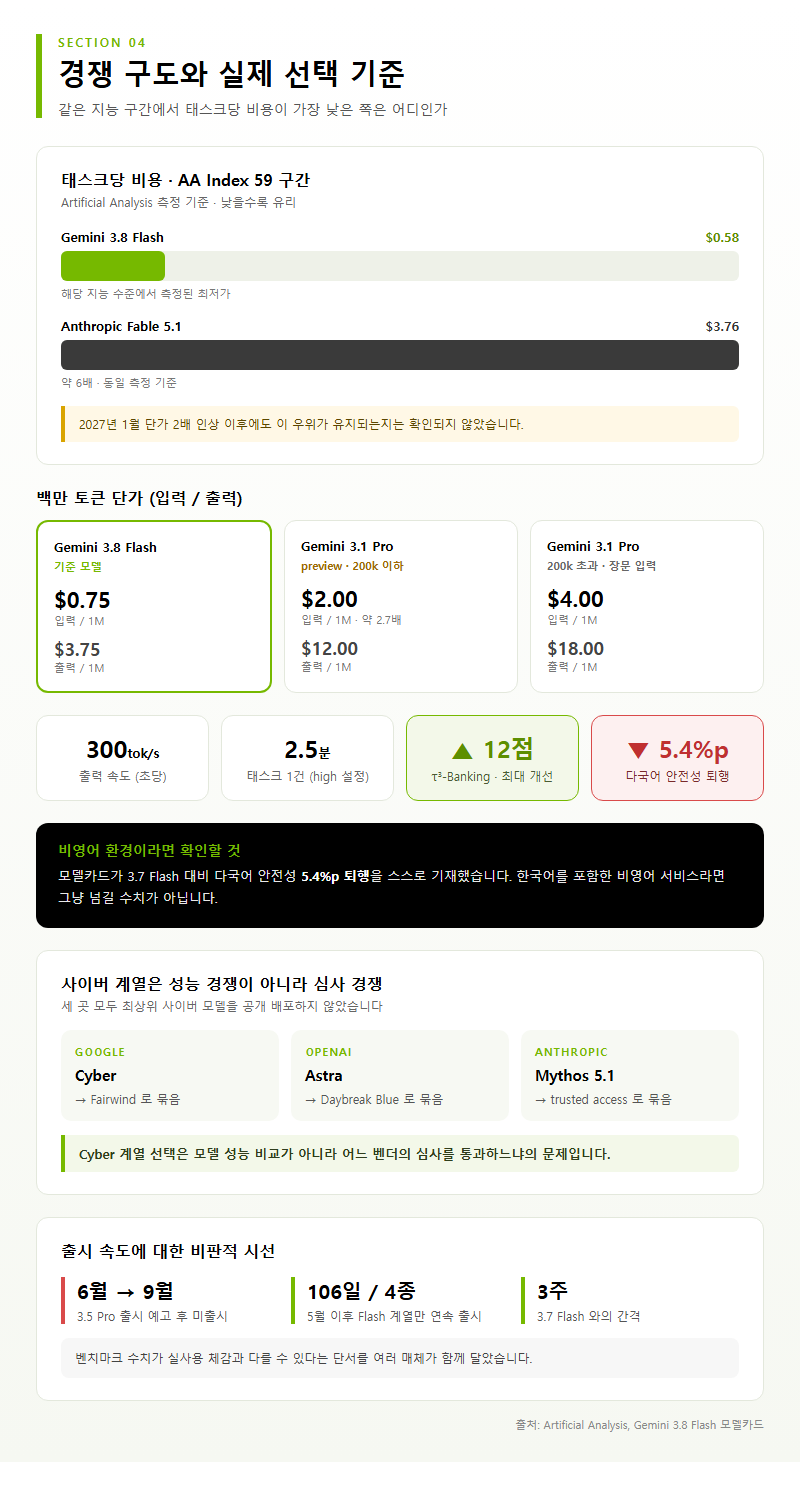
가격 대비 지능만 보면 3.8 Flash의 위치는 유리합니다. AA Index 59점 구간에서 태스크당 $0.58은 해당 지능 수준에서 측정된 최저가라는 것이 Artificial Analysis의 평가입니다. Anthropic Fable 5.1은 같은 측정에서 태스크당 $3.76으로 약 6배입니다. 다만 2027년 1월 단가 2배 인상 이후에도 이 우위가 유지되는지는 확인되지 않았습니다.
| 비교 대상 | 가격 | 위치 |
|---|---|---|
| Gemini 3.8 Flash | $0.75 / $3.75 | AA Index 59, 태스크당 $0.58 |
| Gemini 3.1 Pro (preview) | $2.00 / $12.00 (200k 이하) | 입력 기준 약 2.7배 비쌈, preview 상태 |
| Gemini 3.1 Pro (200k 초과) | $4.00 / $18.00 | 장문 입력 구간 |
| Anthropic Fable 5.1 | — | 태스크당 $3.76 (약 6배) |
출력 속도는 초당 약 300토큰이고 high 설정 기준 태스크 하나에 2.5분이 걸립니다. 벤치마크 중 개선폭이 가장 컸던 항목은 τ³-Banking으로 12점 상승했습니다. 반대 방향의 수치도 있습니다. 모델카드는 3.7 Flash 대비 다국어 안전성이 5.4%p 퇴행했다고 스스로 기재했습니다. 한국어를 포함한 비영어 환경에서 서비스한다면 그냥 넘길 수치가 아닙니다.
사이버 영역의 경쟁 구도는 성능 경쟁이 아니라 심사 경쟁에 가깝습니다. Google은 Cyber를 Fairwind로, OpenAI는 Astra를 Daybreak Blue로, Anthropic은 Mythos 5.1을 trusted access로 각각 묶었습니다. 세 곳 모두 최상위 사이버 모델을 공개 배포하지 않았습니다. 결국 Cyber 계열 선택은 모델 성능 비교가 아니라 어느 벤더의 심사를 통과하느냐의 문제입니다.
출시 속도에 대한 비판적 시선도 함께 기록해 둘 만합니다. Google은 3.5 Pro를 6월에 내놓겠다고 했으나 9월까지 나오지 않았고, 5월 이후 106일 동안 Flash 계열만 4종이 출시됐습니다. 3.7 Flash와의 간격은 3주였습니다. 벤치마크 수치가 실사용 체감과 다를 수 있다는 단서도 여러 매체가 달았습니다.
5. 독자 유형별 판단 정리와 자주 묻는 질문
일반 이용자라면, Cyber는 신청 대상 자체가 아니라는 점만 알아 두면 충분합니다. 반대로 일반 3.8 Flash는 이미 손에 있을 가능성이 높습니다. Google AI Pro·Ultra 구독자는 Gemini 앱과 Google Sheets, 검색 AI 모드에서 9월 2일부터 적용받고 있습니다. 무료 등급은 적용 대상으로 언급되지 않았습니다.
API를 직접 쓰는 개발자라면 마이그레이션에서 깨지는 지점이 명확합니다. thinking_level의 minimal은 오류를 반환하고, 프리필된 model turn은 제거해야 하며, ·top_p·top_k는 thinking_level enum으로 대체돼 더 이상 쓰지 않습니다. 비용이 걱정된다면 민감하지 않은 경로를 low(태스크당 $0.24)로 내리는 구성이 현실적입니다. 취약점 스캔 파이프라인을 설계한다면 일반 3.8 Flash와 외부 도구 조합을 기준선으로 잡고, Cyber는 조직이 심사를 통과한 뒤에 검토할 항목으로 미루는 편이 낫습니다.
Q. Cyber 버전을 개인이 신청할 수 있습니까?
A. 불가능합니다. Fairwind 자격은 정부·국가 사이버당국, 핵심 인프라 운영자, 핵심 기술 플랫폼 유지보수자 3개 범주이며, 참여사는 사내 보안·침해대응·모의침투 팀으로 접근을 한정하고 MFA 등 보호조치를 적용해야 합니다.
Q. Cyber가 일반판보다 무조건 성능이 좋습니까?
A. 사이버보안 특정 과업에서 유리하도록 조정된 모델이며, 범용 성능이 더 낫다는 근거는 공개되지 않았습니다. 패칭 지표인 CWE-Bench에서는 47.2%로 경쟁 모델 47.8%에 밀립니다.
Q. 지금 API 비용을 확정해도 됩니까?
A. 2026년 12월 31일까지의 가격만 확정입니다. 2027년 1월 1일부터 전 요금제가 2배로 오르므로 연간 예산은 두 구간으로 나눠 잡아야 합니다.
Q. 3.8 Flash와 3.1 Pro 중 무엇을 고릅니까?
A. 2026년 9월 15일 기준 3.1 Pro는 preview 상태이고 입력 단가가 약 2.7배 높습니다. 안정 버전이 필요하면 3.8 Flash가 기본 선택지입니다.
정리
Gemini 3.8 Flash와 Cyber 버전의 차이는 성능 등급이 아니라 접근 권한과 안전 정책의 차이입니다. Cyber는 모델 ID·가격·컨텍스트 사양이 모두 미공개이고 Fairwind 심사를 통과한 기관만 쓰므로, 일반 개발자의 아키텍처 선택지에 들어가지 않습니다. 일반 3.8 Flash는 AA Index 59점에 태스크당 $0.58로 동급 최저가입니다. 다만 단가가 동결됐음에도 출력 토큰 30% 증가로 실비용이 약 40% 올랐다는 점이 중요합니다. 2027년 1월 1일 단가 2배 인상과 다국어 안전성 5.4%p 퇴행, 두 가지는 도입 전에 예산과 테스트 계획에 반영해야 할 항목입니다.
참고 자료
조사 기준일: 2026년 09월 15일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (전부 WebFetch로 원문 대조, 확인일 2026-09-15)
– Google 공식 발표: https://blog.google/innovation-and-ai/models-and-research/gemini-models/3-8-flash-and-3-8-flash-cyber/
– Fairwind Program 발표: https://blog.google/innovation-and-ai/technology/safety-security/fairwind-program/
– DeepMind 모델카드 (3.8 Flash): https://deepmind.google/models/model-cards/gemini-3-8-flash/
– DeepMind Cyber 제품 페이지: https://deepmind.google/models/gemini/cyber/
– 평가 방법론 PDF (3.8 Flash): https://storage.googleapis.com/deepmind-media/gemini/gemini_3-8_flash_model_evaluation.pdf
– 평가 방법론 PDF (3.8 Flash Cyber): https://storage.googleapis.com/deepmind-media/gemini/gemini_3-8_flash_cyber_model_evaluation.pdf
– Gemini API 모델 목록: https://ai.google.dev/gemini-api/docs/models
– Gemini API “What’s new in 3.8 Flash”: https://ai.google.dev/gemini-api/docs/latest-model
– Gemini API 가격표: https://ai.google.dev/gemini-api/docs/pricing
Tier 2 (확인일 2026-09-15)
– Artificial Analysis 분석글: https://artificialanalysis.ai/articles/gemini-3-8-flash
– The Register: https://www.theregister.com/ai-and-ml/2026/09/02/with-gemini-38-flash-google-reminds-everyone-its-still-in-the-race/5294049
– Fortune: https://fortune.com/2026/09/03/google-shipped-four-gemini-flash-models-in-106-days-but-its-flagship-frontier-model-is-still-nowhere-to-be-seen/
– The Hacker News: https://thehackernews.com/2026/09/google-anthropic-and-openai-unveil.html
– the-decoder: https://the-decoder.com/gemini-3-8-flash-is-googles-third-budget-model-in-six-weeks-while-frontier-models-remain-mia/
– 9to5Google: https://9to5google.com/2026/09/02/gemini-3-8-flash-launch/
– Vellum(Google 공표표 재인용, 독자 측정 아님): https://www.vellum.ai/blog/gemini-3-8-flash-benchmarks-explained
– https://artificialanalysis.ai/models/releases/gemini-3-8-flash — WebFetch가 Index 41점·TTFT 13.00s를 반환했으나 AA 자체 분석글(59점)과 충돌. 오독으로 판단해 본문에서 배제 [Hermes §11.4 교차검증 적용]
– https://docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-3-8-flash — 네비게이션만 반환, 본문 미확보
답글 남기기