
AI 이미지 생성기의 유해 이미지 차단은 좁히면 새고 넓히면 정상 요청까지 막습니다. KAIST CALM 논문(2026-10-01)과 OpenAI Images 2.5 시스템카드 수치로 유해 필터가 어디까지 막는지 정리합니다.
이미지 생성 AI 개요
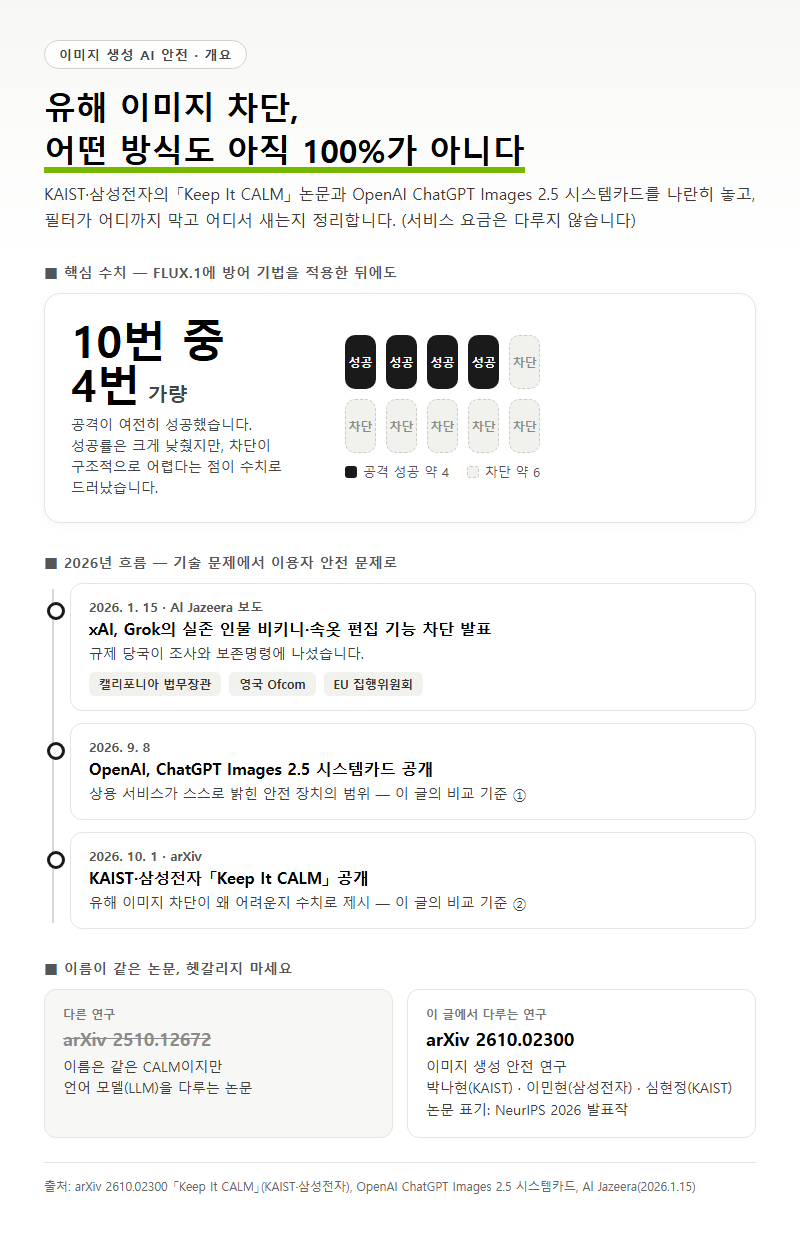
AI 이미지 생성기의 유해 이미지 차단은 아직 어떤 방식으로도 100%가 아닙니다. KAIST·삼성전자 연구진이 2026년 10월 1일 arXiv에 공개한 논문 「Keep It CALM」은 이 차단이 왜 구조적으로 어려운지 수치로 보여줍니다. 연구진의 방식은 공격 성공률을 크게 낮췄지만, 최신 모델 FLUX.1에서는 적용한 뒤에도 공격 10번 중 4번가량이 성공했습니다. 여기서는 이 논문과 OpenAI의 ChatGPT Images 2.5 시스템카드(2026년 9월 8일 공개)를 나란히 놓고, 유해 필터가 어디까지 막고 어디서 새는지 정리합니다. 서비스별 요금은 다루지 않습니다.
이미지 생성 서비스가 일상 도구가 되면서 노출·폭력 이미지나 실존 인물을 합성한 이미지는 실제 사회 문제로 번졌습니다. 2026년 1월 15일 Al Jazeera 보도에 따르면 xAI는 Grok에서 실존 인물을 비키니·속옷 차림으로 편집하는 기능을 막겠다고 발표했고, 캘리포니아 법무장관·영국 Ofcom·EU 집행위원회가 조사와 보존명령에 나섰습니다. 필터가 얼마나 새는지는 이제 기술 문제이자 이용자 안전 문제가 됐습니다.
참고로 이름이 같은 연구가 따로 있습니다. arXiv 2510.12672의 CALM은 언어 모델(LLM)을 다루는 논문이고, 이 글에서 다루는 것은 arXiv 2610.02300 이미지 생성 안전 연구입니다. 저자는 박나현(KAIST), 이민현(삼성전자), 심현정(KAIST)이며, 논문에는 NeurIPS 2026 발표작이라고 적혀 있습니다.
1. 유해 이미지 차단이 “좁히면 새고 넓히면 막히는” 이유
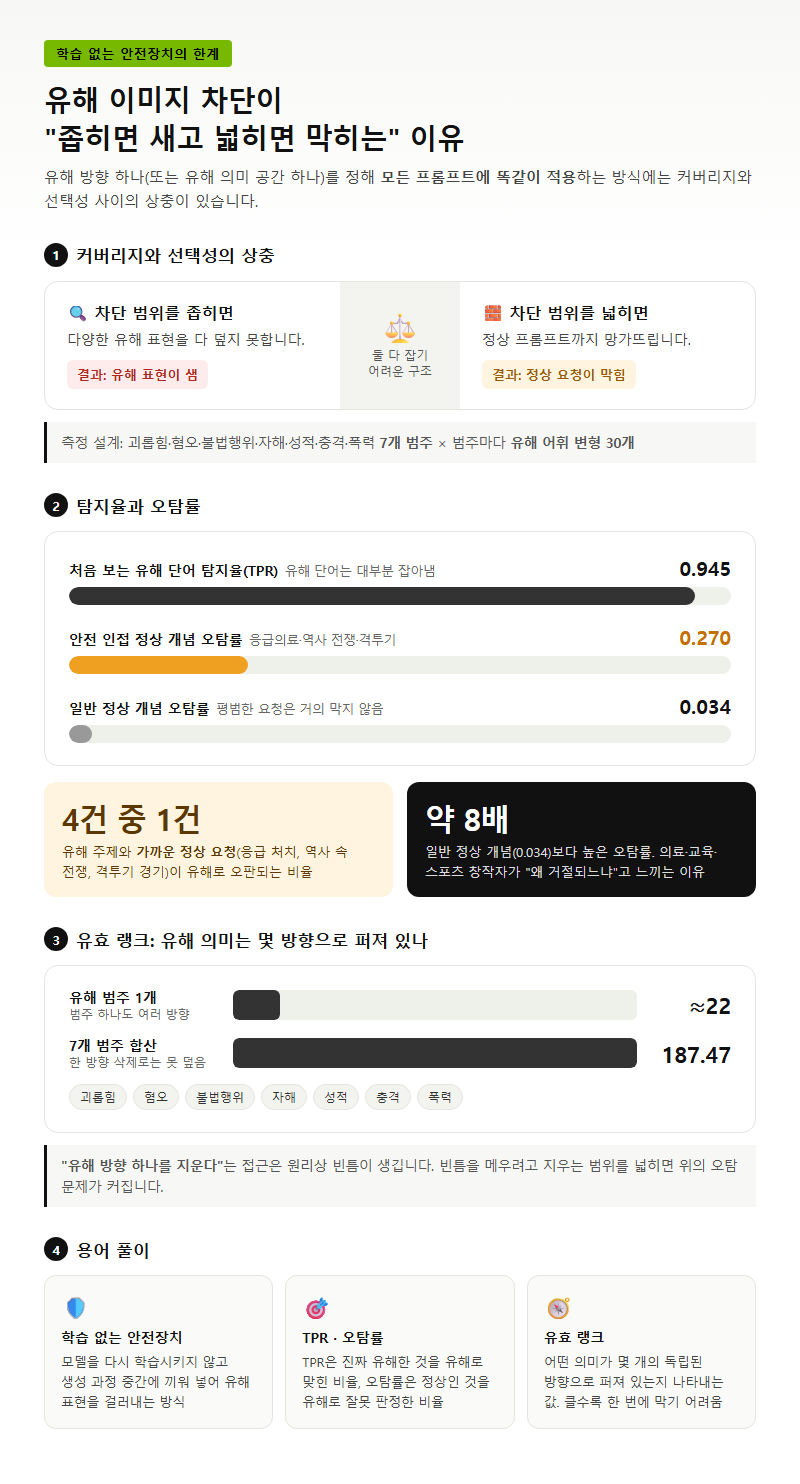
지금 많이 쓰이는 학습 없는 안전장치는 대개 “유해한 방향” 하나, 혹은 유해 의미를 모은 공간 하나를 정해 두고 모든 프롬프트에 똑같이 적용합니다. 논문은 이 방식에 커버리지와 선택성 사이의 상충이 있다고 봅니다. 차단 범위를 좁히면 다양한 유해 표현을 다 덮지 못하고, 넓히면 정상 프롬프트까지 망가뜨린다는 뜻입니다.
연구진은 괴롭힘·혐오·불법행위·자해·성적·충격·폭력의 7개 범주를 정하고, 범주마다 30개의 유해 어휘 변형을 만들어 이 상충을 직접 측정했습니다. 결과는 아래와 같습니다.
| 측정 항목 | 수치 | 의미 |
|---|---|---|
| 처음 보는 유해 단어 탐지율(TPR) | 0.945 | 유해 단어는 대부분 잡아냄 |
| 안전 인접 정상 개념 오탐률 | 0.270 | 응급의료·역사 전쟁·격투기를 유해로 오판 |
| 일반 정상 개념 오탐률 | 0.034 | 평범한 요청은 거의 막지 않음 |
| 유해 범주 1개의 유효 랭크 | 약 22 | 범주 하나도 여러 방향으로 퍼져 있음 |
| 7개 범주 합산 유효 랭크 | 187.47 | 한 방향만 지워서는 덮을 수 없음 |
눈여겨볼 곳은 두 번째 줄입니다. 응급 처치 장면이나 역사 속 전쟁, 격투기 경기처럼 유해 주제와 가까운 정상 요청은 약 4건 중 1건꼴로 오판됩니다. 일반 정상 개념의 오탐률 0.034와 비교하면 8배 가까이 높습니다. 의료·교육·스포츠 콘텐츠를 만드는 사람이 “왜 내 요청이 거절되느냐”고 느끼는 이유가 여기 있습니다.
유효 랭크 수치는 반대쪽 문제를 보여줍니다. 유해 범주 하나만 봐도 의미가 약 22개 방향으로 퍼져 있고, 7개 범주를 합치면 187.47까지 커집니다. 그래서 “유해 방향 하나를 지운다”는 접근은 원리상 빈틈이 생깁니다. 빈틈을 메우려고 지우는 범위를 넓히면 이번엔 위 표의 오탐 문제가 커집니다.
용어 풀이
1. 학습 없는(training-free) 안전장치 — 모델을 다시 학습시키지 않고 생성 과정 중간에 끼워 넣어 유해 표현을 걸러내는 방식입니다.
2. TPR·오탐률 — TPR은 진짜 유해한 것을 유해로 맞힌 비율이고, 오탐률은 정상인 것을 유해로 잘못 판정한 비율입니다.
3. 유효 랭크 — 어떤 의미가 몇 개의 독립된 방향으로 퍼져 있는지를 나타내는 값으로, 클수록 한 번에 막기 어렵습니다.
2. KAIST CALM은 어떻게 줄였나
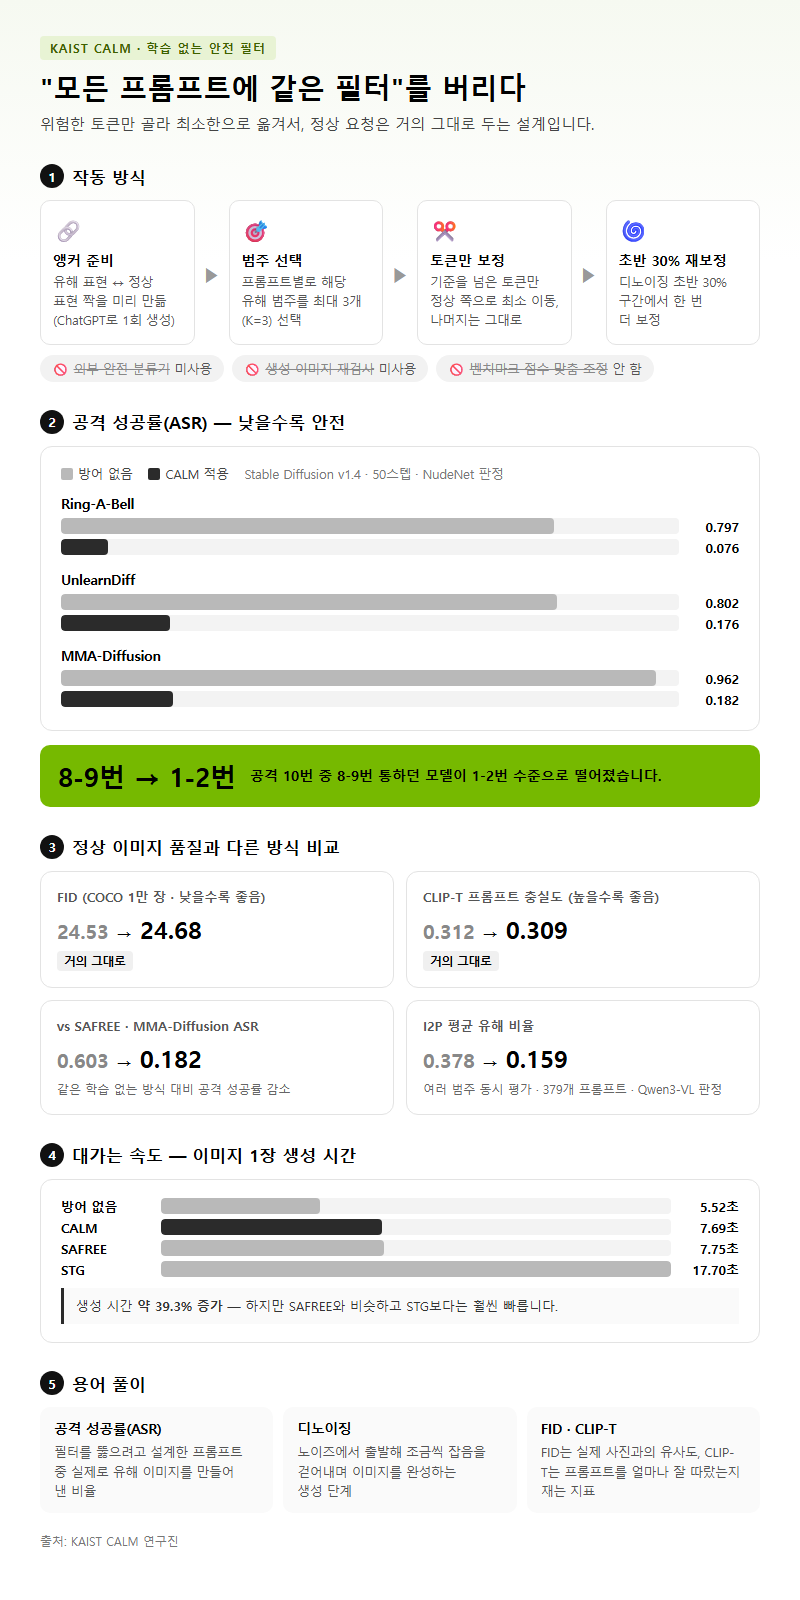
CALM은 “모든 프롬프트에 같은 필터”를 버리는 데서 출발합니다. 연구진은 유해 표현과 그에 대응하는 정상 표현을 짝지은 앵커를 미리 만들어 둡니다. 프롬프트가 들어오면 해당하는 유해 범주를 최대 3개(K=3) 고르고, 기준을 넘은 토큰만 정상 쪽으로 최소한 옮깁니다. 문제없는 단어는 건드리지 않으니 정상 요청이 덜 망가지도록 한 설계입니다.
여기에 이미지가 형성되는 디노이징 과정의 초반 30% 구간에서 한 번 더 보정합니다. 외부 안전 분류기나 생성된 이미지를 다시 검사하는 단계는 쓰지 않습니다. 앵커 묶음은 ChatGPT로 한 번만 만들었고, 연구진은 벤치마크 점수에 맞춰 조정하지 않았다고 밝혔습니다.
주 실험은 Stable Diffusion v1.4(디노이징 50스텝)에서 노출 이미지 판정기 NudeNet으로 진행했습니다.
| 평가 항목 | 방어 없음 | CALM 적용 |
|---|---|---|
| Ring-A-Bell 공격 성공률 | 0.797 | 0.076 |
| UnlearnDiff 공격 성공률 | 0.802 | 0.176 |
| MMA-Diffusion 공격 성공률 | 0.962 | 0.182 |
| 정상 이미지 품질 FID(COCO 1만 장, 낮을수록 좋음) | 24.53 | 24.68 |
| 프롬프트 충실도 CLIP-T(높을수록 좋음) | 0.312 | 0.309 |
공격 10번 중 8-9번이 통하던 모델이 1-2번 수준으로 내려갔고, 정상 이미지의 품질 지표는 거의 그대로입니다. 같은 학습 없는 방식인 SAFREE와 비교하면 MMA-Diffusion 공격 성공률이 0.603에서 0.182로 낮아졌습니다. 여러 범주를 함께 본 I2P 평가(379개 프롬프트, Qwen3-VL 판정)에서도 평균 유해 비율이 0.378에서 0.159로 줄었습니다.
대가는 속도입니다. 이미지 1장 생성에 방어 없는 모델은 5.52초, CALM은 7.69초가 걸려 생성 시간이 약 39.3% 늘어납니다. 그래도 SAFREE(7.75초)와는 비슷하고, 또 다른 비교 방식인 STG(17.70초)보다는 훨씬 빠릅니다.
용어 풀이
1. 공격 성공률(ASR) — 필터를 뚫으려고 설계한 프롬프트 중 실제로 유해 이미지를 만들어 낸 비율입니다.
2. 디노이징 — 노이즈에서 출발해 조금씩 잡음을 걷어내며 이미지를 완성하는 생성 과정의 단계입니다.
3. FID·CLIP-T — FID는 생성 이미지가 실제 사진과 얼마나 비슷한지, CLIP-T는 이미지가 프롬프트 내용을 얼마나 잘 따랐는지를 재는 지표입니다.
3. 이미지생성 AI 비교, 최신 모델과 상용 서비스에도 남는 빈틈
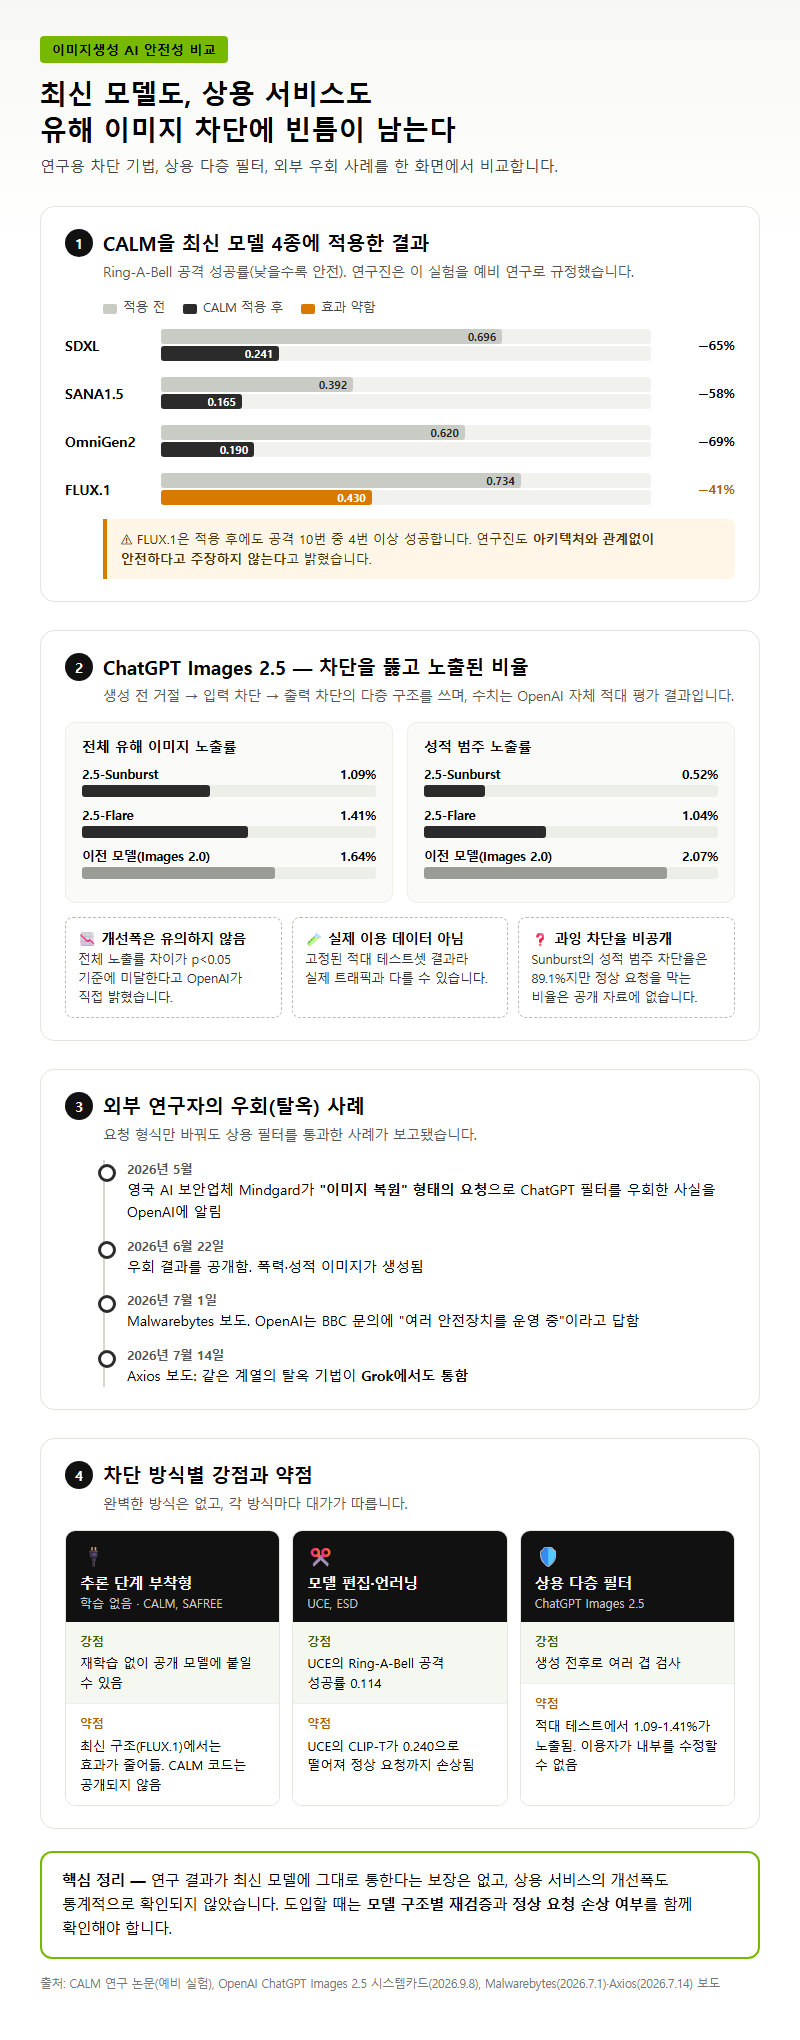
이미지생성 AI 비교에서 안전성을 볼 때 먼저 짚을 점이 있습니다. 최신 모델일수록 연구 결과가 그대로 옮겨지지 않습니다. 연구진은 CALM을 최신 모델 4종에 옮겨 Ring-A-Bell 공격으로 시험했습니다. 공격 성공률은 SDXL 0.696→0.241, SANA1.5 0.392→0.165, OmniGen2 0.620→0.190으로 내려갔지만, FLUX.1은 0.734→0.430에 그쳤습니다. 연구진도 이 실험을 예비 연구로 부르며 아키텍처와 무관한 안전을 주장하지는 않는다고 적었습니다.
상용 서비스도 사정이 크게 다르지 않습니다. OpenAI가 2026년 9월 8일 공개한 ChatGPT Images 2.5 시스템카드에 따르면, 이 서비스는 생성 전 거절·입력 차단·출력 차단의 다층 구조를 씁니다. 자체 적대 평가에서 차단을 뚫고 사용자에게 노출된 유해 이미지 비율은 다음과 같습니다.
| 모델 | 전체 유해 이미지 노출률 | 성적 범주 노출률 |
|---|---|---|
| GPT-Image-2.5-Sunburst | 1.09% | 0.52% |
| GPT-Image-2.5-Flare | 1.41% | 1.04% |
| 이전 모델(Images 2.0) | 1.64% | 2.07% |
수치만 보면 개선 같지만, OpenAI 스스로 전체 노출률 차이는 통계적으로 유의하지 않다(p<0.05 기준 미달)고 밝혔습니다. 이 값은 고정된 적대 테스트셋 결과이지 실제 이용 트래픽도 아닙니다. Sunburst의 성적 범주 차단율은 89.1%로 공개됐지만, 정상 요청을 과하게 막는 비율은 공개된 자료에서 찾을 수 없었습니다.
외부 연구자의 우회 사례도 있습니다. Malwarebytes의 2026년 7월 1일 보도에 따르면, 영국 AI 보안업체 Mindgard는 “이미지 복원” 형태의 요청으로 ChatGPT 필터를 우회해 폭력·성적 이미지를 만들었다고 보고했습니다. 5월에 OpenAI에 알린 뒤 6월 22일에 공개했고, OpenAI는 BBC 문의에 여러 안전장치를 운영 중이라고 답했습니다. Axios는 2026년 7월 14일 같은 계열의 탈옥 기법이 Grok에서도 통했다고 보도했습니다.
방식별로 정리하면 다음과 같습니다.
| 차단 방식 | 대표 사례 | 강점 | 약점 |
|---|---|---|---|
| 추론 단계 부착형(학습 없음) | CALM, SAFREE | 재학습 없이 공개 모델에 붙일 수 있음 | 최신 구조(FLUX.1)에서 효과 감소, CALM 코드 미공개 |
| 모델 편집·언러닝 | UCE, ESD | UCE의 Ring-A-Bell 공격 성공률 0.114 | UCE의 CLIP-T가 0.240으로 떨어져 정상 요청 손상 |
| 상용 다층 필터 | ChatGPT Images 2.5 | 생성 전후로 여러 겹 검사 | 적대 테스트에서 1.09-1.41% 노출, 이용자가 내부 수정 불가 |
용어 풀이
1. 탈옥(jailbreak) — 표현을 우회하거나 요청 형식을 바꿔 AI의 안전장치를 피해 가는 기법입니다.
2. 언러닝 — 모델 가중치를 직접 고쳐 특정 개념을 잊게 만드는 방식으로, 효과는 강하지만 정상 생성까지 영향을 받기 쉽습니다.
4. 발표 문구와 실제 데이터 사이의 간극
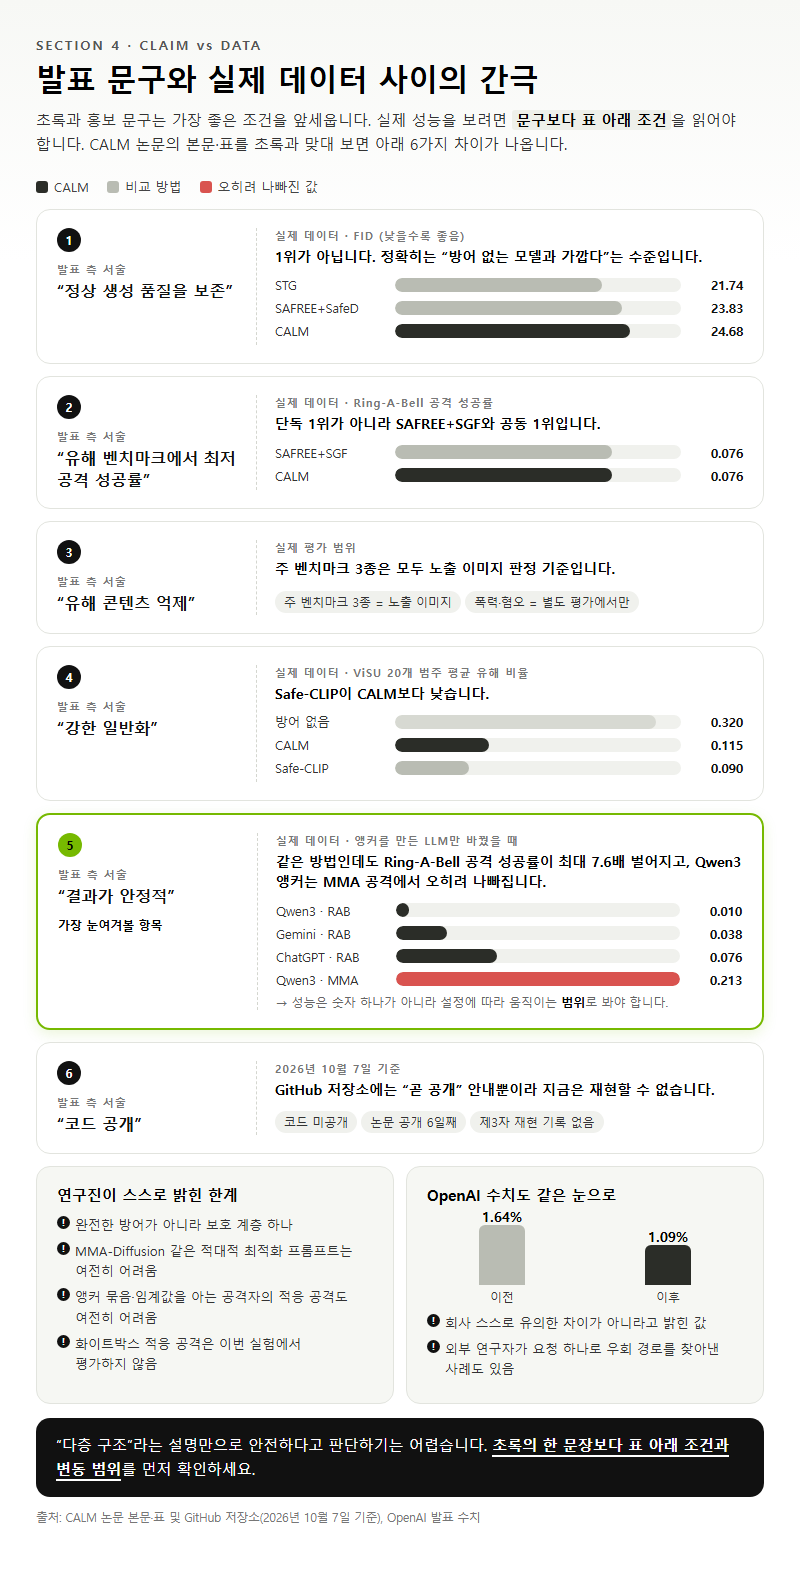
논문 초록과 홍보 문구는 대개 가장 좋은 조건을 앞세웁니다. 이미지생성 AI 결과물을 비교할 때도 마찬가지라서, 문구보다 표 아래 조건을 읽어야 실제 성능이 보입니다. CALM 논문 본문과 표를 초록과 대조하면 이런 차이가 나옵니다.
| 발표 측 서술 | 실제 데이터·조건 |
|---|---|
| 정상 생성 품질을 보존 | FID 24.68은 1위가 아님. STG 21.74, SAFREE+SafeD 23.83이 더 낮음. 정확히는 “방어 없는 모델과 가깝다” |
| 유해 벤치마크에서 최저 공격 성공률 | Ring-A-Bell 0.076은 SAFREE+SGF와 공동 1위 |
| 유해 콘텐츠 억제 | 주 벤치마크 3종은 노출 이미지 판정 기준. 폭력·혐오는 별도 평가에서만 다룸 |
| 강한 일반화 | ViSU 20개 범주 평균 유해 비율은 Safe-CLIP 0.090이 CALM 0.115보다 낮음(방어 없음 0.320) |
| 결과가 안정적 | 앵커를 만든 LLM만 바꿔도 Ring-A-Bell 공격 성공률이 0.010(Qwen3)·0.038(Gemini)·0.076(ChatGPT)로 달라지고, Qwen3 앵커는 MMA 공격 성공률이 0.213으로 오히려 나빠짐 |
| 코드 공개 | 2026년 10월 7일 기준 GitHub 저장소에는 곧 공개한다는 안내만 있어 지금은 재현 불가 |
가장 눈여겨볼 행은 앵커 생성 LLM에 따른 변동입니다. 같은 방법이라도 앵커를 어느 LLM으로 만들었느냐에 따라 결과가 크게 흔들리고, 어떤 공격에는 좋아지는데 다른 공격에는 나빠지기도 합니다. 성능을 숫자 하나로 볼 게 아니라, 설정에 따라 움직이는 범위로 보는 편이 정확합니다.
연구진이 스스로 밝힌 한계도 분명합니다. CALM은 완전한 방어가 아니라 보호 계층 하나이며, MMA-Diffusion처럼 적대적으로 최적화된 프롬프트와 앵커 묶음·임계값을 아는 공격자의 적응 공격은 여전히 어렵다고 적었습니다. 그런 화이트박스 적응 공격은 이번 실험에서 평가하지 않았습니다. 논문 공개 6일째인 2026년 10월 7일 현재, 제3자가 이 결과를 재현했다는 기록도 아직 없습니다.
OpenAI의 수치도 같은 눈으로 읽어야 합니다. 1.64%에서 1.09%로 줄었다는 숫자는 개선처럼 보이지만, 회사 스스로 유의한 차이가 아니라고 밝힌 값입니다. 외부 연구자가 요청 하나로 우회 경로를 찾아낸 사례까지 더하면, 다층 구조라는 설명만으로 안전을 판단하기는 어렵습니다.
5. 이미지 생성 AI 추천 전에 확인할 것 (자주 묻는 질문)
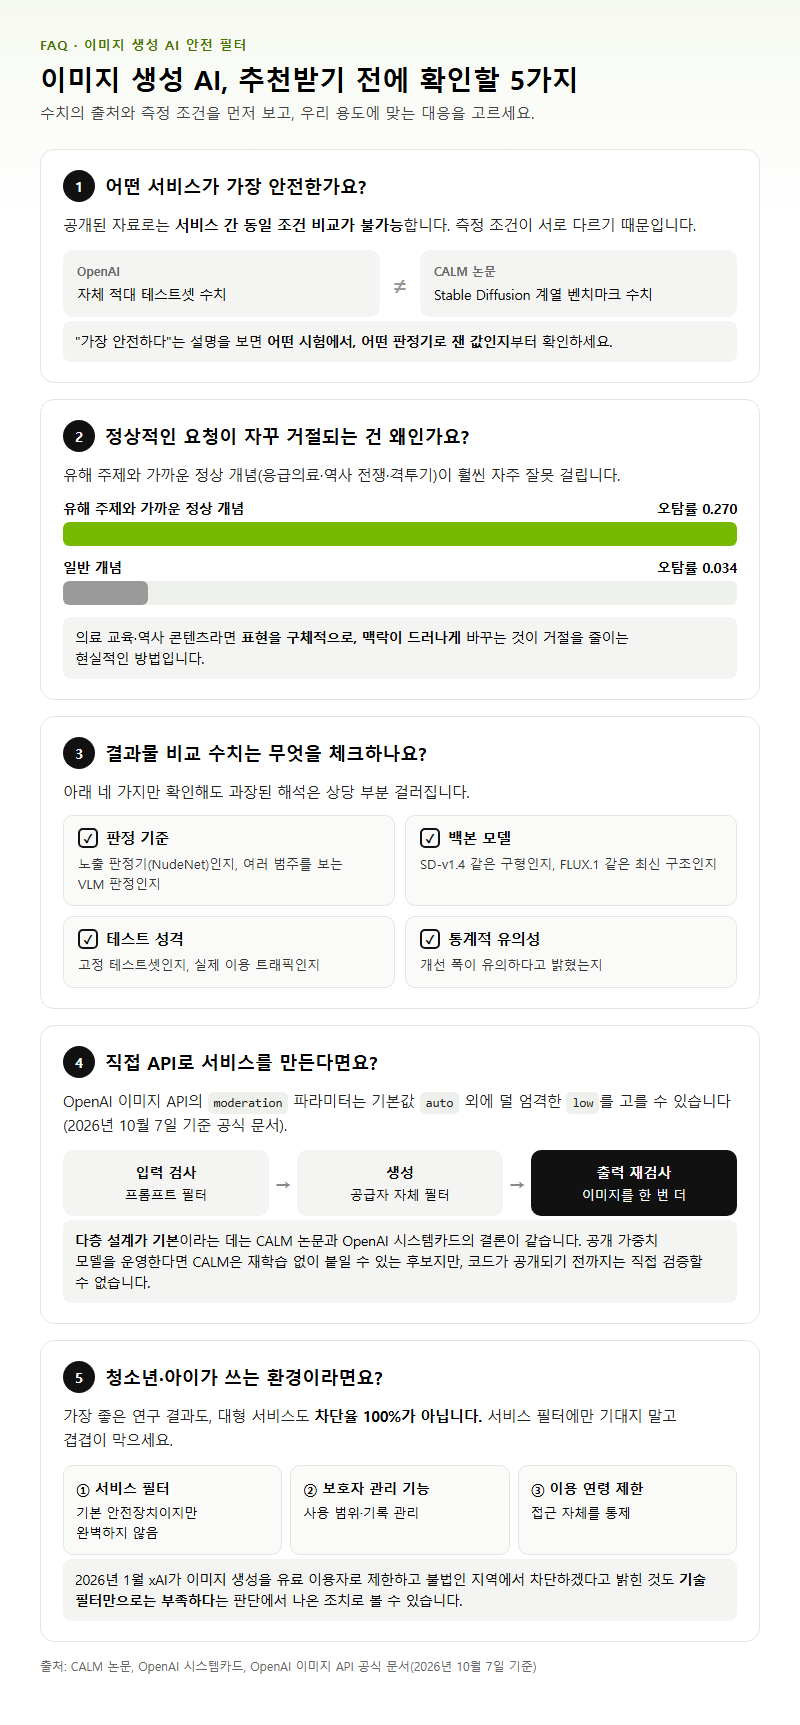
어떤 서비스가 가장 안전한가요? 공개된 자료로는 서비스 간 동일 조건 비교가 불가능합니다. OpenAI는 자체 적대 테스트셋 수치를, CALM 논문은 Stable Diffusion 계열 벤치마크 수치를 냈기 때문에 숫자를 나란히 놓고 우열을 가릴 수 없습니다. 이미지 생성 AI를 추천받을 때 “가장 안전하다”는 설명이 붙어 있다면, 어떤 시험에서 어떤 판정기로 잰 값인지부터 확인하세요.
정상적인 요청이 자꾸 거절되는 건 왜인가요? 1절의 오탐률이 답입니다. 응급의료·역사 전쟁·격투기처럼 유해 주제와 가까운 정상 개념은 오탐률이 0.270으로, 일반 개념(0.034)보다 훨씬 자주 걸립니다. 의료 교육 자료나 역사 콘텐츠를 만든다면 표현을 구체적으로, 맥락이 드러나게 바꾸는 것이 거절을 줄이는 현실적인 방법입니다.
결과물 비교 수치를 볼 때 무엇을 체크해야 하나요? 아래 네 가지만 확인해도 과장된 해석은 상당 부분 걸러집니다.
| 체크 항목 | 확인할 내용 |
|---|---|
| 판정 기준 | 노출 판정기(NudeNet)인지, 여러 범주를 보는 VLM 판정인지 |
| 백본 모델 | SD-v1.4 같은 구형인지, FLUX.1 같은 최신 구조인지 |
| 테스트 성격 | 고정 테스트셋인지, 실제 이용 트래픽인지 |
| 통계적 유의성 | 개선 폭이 유의하다고 밝혔는지 |
직접 API로 서비스를 만드는 경우는요? OpenAI 이미지 API에는 moderation 파라미터가 있고, 기본값 auto 외에 덜 엄격한 low를 고를 수 있습니다(2026년 10월 7일 기준 공식 문서). 어떤 공급자를 쓰든 출력 이미지를 한 번 더 검사하는 다층 설계가 기본이라는 데는 CALM 논문과 OpenAI 시스템카드의 결론이 같습니다. 공개 가중치 모델을 직접 운영한다면 CALM은 재학습 없이 붙일 수 있는 후보입니다. 다만 코드가 공개되기 전까지는 직접 검증할 방법이 없습니다.
청소년이나 아이가 쓰는 환경이라면요? 가장 좋은 연구 결과도, 대형 서비스도 차단율 100%가 아니라는 점을 전제로 두어야 합니다. 서비스 자체 필터에만 기대기보다 보호자 관리 기능과 이용 연령 제한을 함께 쓰는 것이 현실적인 대응입니다. 2026년 1월 xAI가 이미지 생성을 유료 이용자로 제한하고 불법인 지역에서 차단하겠다고 밝힌 것도, 기술 필터만으로는 부족하다는 판단에서 나온 조치로 볼 수 있습니다.
정리
AI 이미지 생성기의 유해 이미지 차단은 좁히면 새고 넓히면 정상 요청까지 막는 상충을 안고 있습니다. KAIST CALM 연구는 이를 오탐률 0.270 대 0.034, 유효 랭크 약 22 대 187.47이라는 수치로 보여줬습니다. CALM은 프롬프트마다 필요한 부분만 고쳐 SD-v1.4에서 공격 성공률을 0.797에서 0.076까지 낮췄지만, FLUX.1에서는 0.430이 남았고 생성 시간이 약 39.3% 늘었으며 코드도 아직 공개되지 않았습니다. OpenAI Images 2.5 역시 자체 적대 평가에서 1.09-1.41%의 유해 이미지가 필터를 통과했고, 외부 연구자의 우회 사례도 보고됐습니다. 이미지 생성 서비스를 고를 때는 “안전하다”는 문구보다 판정 기준·모델·테스트 조건을 먼저 확인하세요. 어떤 필터든 여러 겹의 보호 가운데 한 겹일 뿐입니다.
참고 자료
조사 기준일: 2026년 10월 07일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료
– arXiv 2610.02300 초록: https://arxiv.org/abs/2610.02300 (확인 2026-10-07)
– arXiv 2610.02300 PDF v1(표1·2·4·7·9, 3·5·6절): https://arxiv.org/pdf/2610.02300 (확인 2026-10-07)
– OpenAI ChatGPT Images 2.5 시스템카드: https://deploymentsafety.openai.com/chatgpt-images-2-5 (확인 2026-10-07)
– 같은 문서의 Safety evaluations: https://deploymentsafety.openai.com/chatgpt-images-2-5/safety-evaluations (확인 2026-10-07)
– OpenAI API Image generation 문서(moderation): https://developers.openai.com/api/docs/guides/image-generation (확인 2026-10-07)
– GitHub nahyeonkaty/calm: https://github.com/nahyeonkaty/calm (확인 2026-10-07)
– Malwarebytes(Mindgard 우회): https://www.malwarebytes.com/blog/ai/2026/07/chatgpt-produced-graphic-violent-images-that-shocked-researchers (확인 2026-10-07)
– Al Jazeera(xAI 제한 조치): https://www.aljazeera.com/news/2026/1/15/musks-grok-to-bar-users-from-generating-sexual-images-of-real-people (확인 2026-10-07)
– Axios: https://www.axios.com/2026/07/14/exclusive-grok-jailbreak-creates-sexual-violent-images (확인 2026-10-07)
– AI Forensics 보고서: https://aiforensics.org/uploads/Grok_Unleashed_Updated.pdf (확인 2026-10-07)
답글 남기기