

문샷AI의 Kimi K3.1 Pro는 공개를 보류한 것이 아닙니다. 사이버 데이터를 뺀 뒤 2026년 11월 4일까지 가중치를 공개하겠다고 예고한 상태입니다. 자체 시험 90.5→81.0의 한계와 가격, OpenAI·Anthropic 방식과의 차이를 비교합니다.
이 글에는 네이버 브랜드커넥트 제휴 링크가 포함되어 있습니다. 링크를 통해 구매가 이루어지면 작성자가 일정액의 수수료를 지급받습니다. 제품 선택과 구매는 독자의 판단이며, 이 글은 특정 제품의 효과를 보증하지 않습니다.
Kimi K3.1 Pro 오픈웨이트, 무엇을 기준으로 비교해야 할까
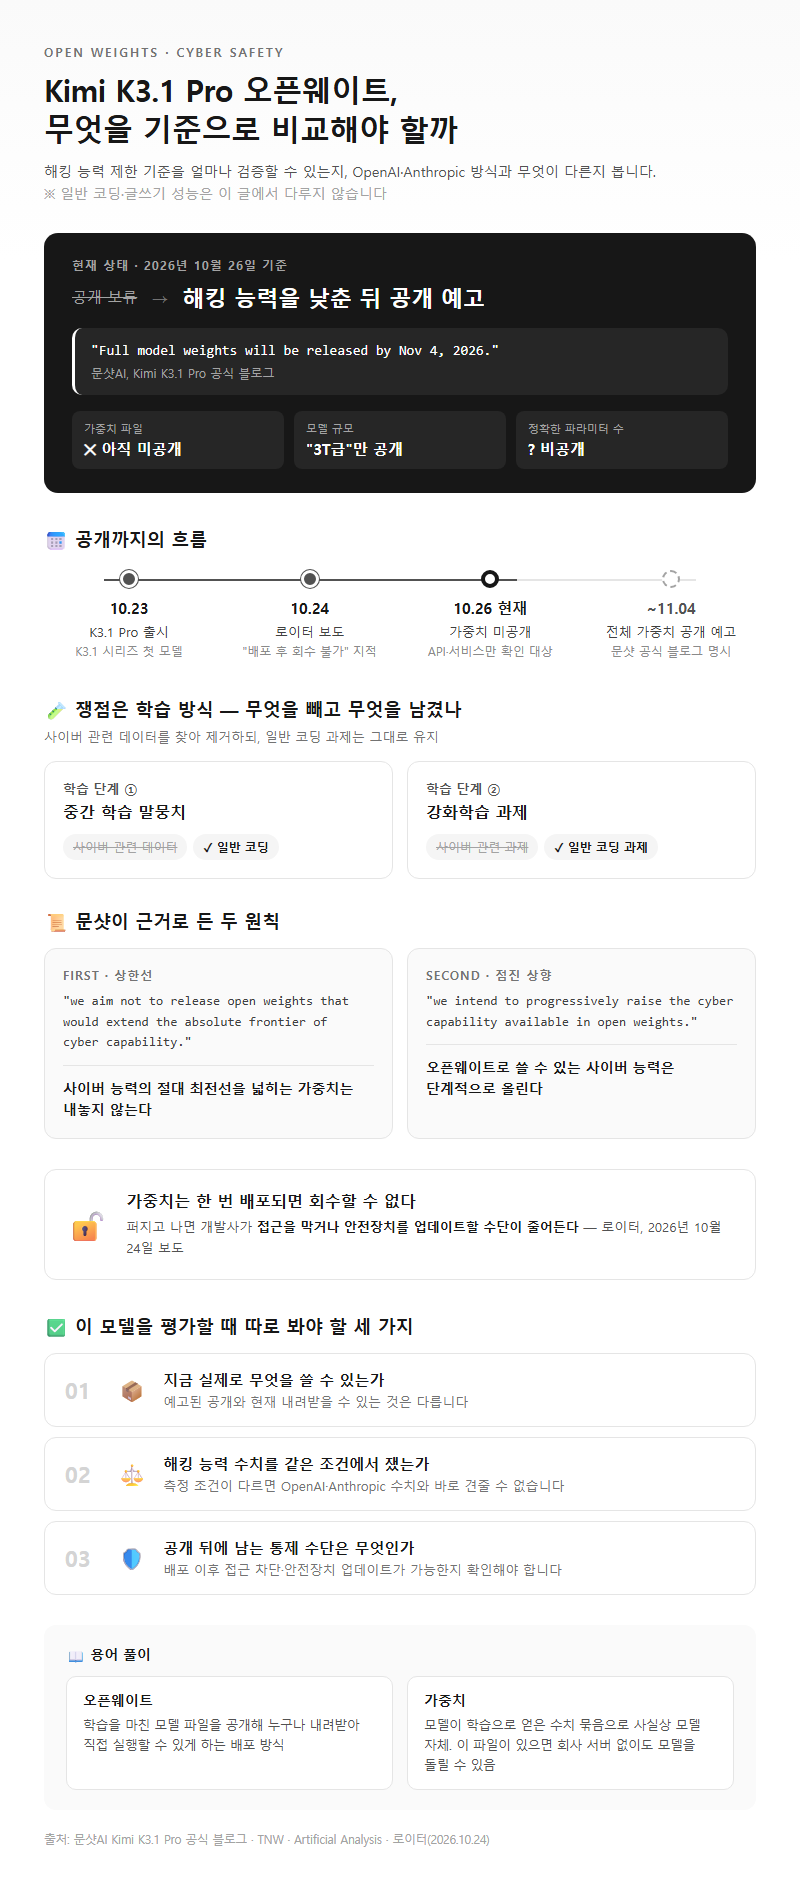
Kimi K3.1 Pro는 오픈웨이트 공개를 보류한 것이 아니라, 해킹 능력을 낮춘 뒤 공개를 예고한 상태입니다. 문샷AI는 Kimi K3.1 Pro 공식 블로그에 “Full model weights will be released by Nov 4, 2026.”라고 적었습니다. 하지만 2026년 10월 26일 현재 가중치 파일은 아직 공개되지 않았습니다. 이 글은 문샷이 내세운 해킹 능력 제한 기준을 얼마나 검증할 수 있는지, OpenAI·Anthropic의 방식과 무엇이 다른지 비교합니다. 일반 코딩이나 글쓰기 성능은 다루지 않습니다.
K3.1 Pro는 K3.1 시리즈의 첫 모델입니다. TNW와 Artificial Analysis 보도에 따르면 출시일은 2026년 10월 23일입니다. 문샷은 규모를 “3T급”이라고만 밝혔고 정확한 파라미터 수는 공개하지 않았습니다. 쟁점은 학습 방식에 있습니다. 문샷은 중간 학습 말뭉치와 강화학습 과제 양쪽에서 사이버 관련 데이터를 찾아 제거하고 일반 코딩 과제는 그대로 뒀다고 설명했습니다. 근거로 든 원칙은 두 가지입니다. 하나는 “First, we aim not to release open weights that would extend the absolute frontier of cyber capability.”이고, 다른 하나는 “Second, we intend to progressively raise the cyber capability available in open weights.”입니다.
이 조치가 주목받는 것은 가중치가 한 번 배포되면 회수할 수 없기 때문입니다. 로이터는 2026년 10월 24일 보도에서 이 점을 짚었습니다. 가중치가 퍼지고 나면 개발사가 접근을 막거나 안전장치를 업데이트할 수단이 줄어든다는 지적입니다. 그래서 이 모델을 평가할 때는 세 가지를 따로 봐야 합니다. 지금 실제로 무엇을 쓸 수 있는지, 해킹 능력 수치를 같은 조건에서 쟀는지, 공개 뒤에 남는 통제 수단이 무엇인지입니다.
용어 풀이
1. 오픈웨이트 — 학습을 마친 모델 파일을 공개해 누구나 내려받아 직접 실행할 수 있게 하는 배포 방식입니다.
2. 가중치 — 모델이 학습으로 얻은 수치 묶음으로, 사실상 모델 자체입니다. 이 파일이 있으면 회사 서버 없이도 모델을 돌릴 수 있습니다.
비교 기준 정리
문샷 발표문을 그대로 읽으면 “해킹 능력을 줄인 오픈웨이트 모델”로 보입니다. 하지만 항목별로 나눠 보면 확인된 것과 회사 주장에 그치는 것이 섞여 있습니다. 이 모델을 판단할 기준과 각 기준의 함정을 아래 표에 정리했습니다.
| 항목 | 확인할 기준 | 단위 | 주의점 |
|---|---|---|---|
| 공개 상태 | 가중치 파일을 실제로 내려받을 수 있는가 | 날짜 | 10월 26일 현재 API·앱에서만 쓸 수 있고, Artificial Analysis도 독점 모델로 분류함 |
| 해킹 능력 | xdev-bench-hard 점수 | pass@3 비율(%) | 문샷의 비공개 자체 시험이라 외부에서 재현할 수 없음 |
| 측정 조건 | 모델별 평가 하니스가 같은가 | 하니스 이름 | K3.1 Pro는 KimiCode, 경쟁 모델은 Claude Code로 평가함 |
| 환각률 | 어떤 시험셋으로 쟀는가 | % | 출시 블로그와 API 문서가 서로 다른 시험셋을 씀 |
| 가격 | 100만 토큰당 입력·출력 단가 | 달러 | 단가와 작업당 총비용은 별개 |
| 종합 성능 | 외부 기관의 지수 | 점수·순위 | 외부 지수는 해킹 능력이 아니라 일반 지능을 측정함 |
| 규제 환경 | 중국 수출통제 기술 목록 개정안 | 날짜 | 의견 수렴이 2026년 11월 15일에 끝나며 아직 확정되지 않음 |
가장 먼저 볼 항목은 측정 조건입니다. 문샷 차트에서 K3.1 Pro는 KimiCode 하니스로, GLM-5.3과 DeepSeek-V4.1-Flash-1017은 Claude Code 하니스로 평가됐습니다. 블로그 각주에 적힌 내용입니다. 하니스가 다르면 같은 모델도 점수가 달라질 수 있어서, 한 차트에 나란히 놓여 있어도 같은 기준의 비교로 보기 어렵습니다.
시험 규모도 따져봐야 합니다. 문샷은 xdev-bench-hard의 문항 수를 공개하지 않았습니다. 그런데 차트의 점수(90.5·85.7·81.0·57.1·33.3)는 모두 21문항 기준 비율과 정확히 맞아떨어집니다. 이를 토대로 계산하면 데이터 제거 전후 차이인 9.5%p는 실제로 2문항 차이일 가능성이 있습니다. 회사가 문항 구성을 밝히지 않은 만큼 이 숫자는 추정입니다. 그래도 작은 시험에서는 몇 문항만 달라져도 퍼센트 차이가 크게 보인다는 점은 기억해 둘 만합니다.
환각률도 숫자 하나로 정리되지 않습니다. 출시 블로그는 Kimi Hallu Bench Hard(도구 사용) 기준 23.4%에서 8.3%로 줄었다고 밝혔습니다. API 문서는 사용자가 오류를 신고한 대화를 비식별화한 별도 시험셋으로 23.35%에서 6.85%로 줄었다고 적었습니다. 두 문서 모두 이 수치가 일상 사용의 오류율은 아니라고 명시했습니다.
용어 풀이
1. 하니스 — 모델에게 과제를 주고 도구 실행·결과 채점을 관리하는 평가용 실행 틀입니다. 무엇을 쓰느냐에 따라 같은 모델의 점수도 달라집니다.
2. pass@3 — 같은 과제를 세 번 시도해 한 번이라도 성공하면 통과로 치는 채점 방식입니다.
옵션·유형별 비교
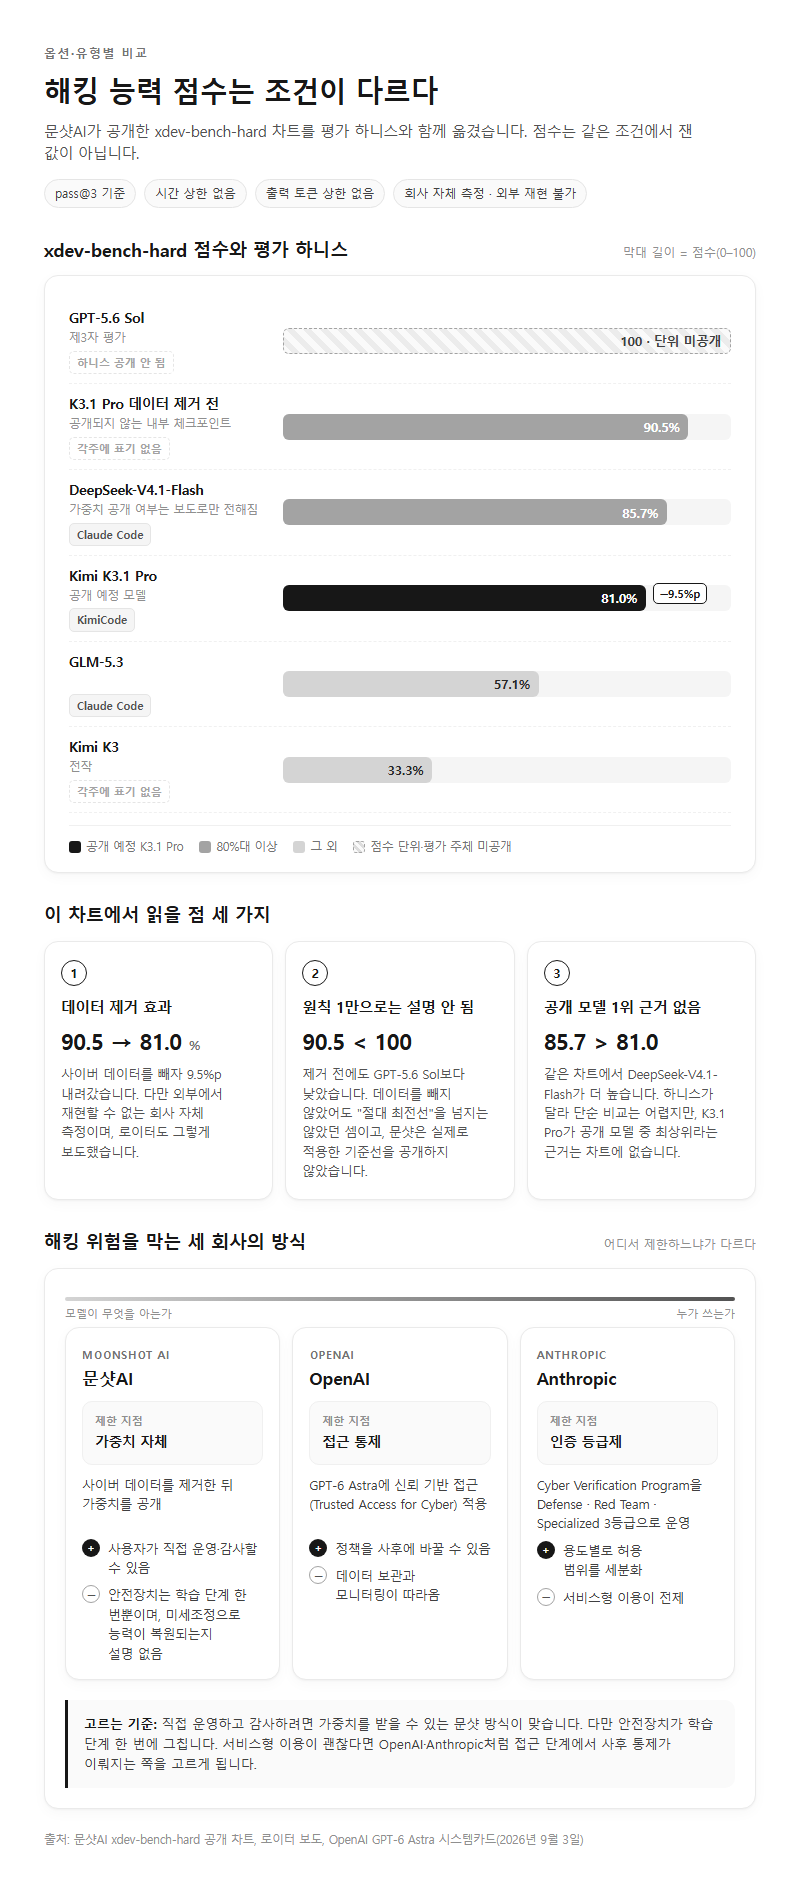
해킹 능력 점수는 조건이 다르다
문샷이 공개한 xdev-bench-hard 차트를 하니스 정보와 함께 옮겼습니다. 이 시험은 pass@3 기준이며 시간과 출력 토큰에 상한을 두지 않았습니다.
| 모델 | 점수 | 평가 하니스 | 비고 |
|---|---|---|---|
| GPT-5.6 Sol | 100 | 공개되지 않음 | 제3자 평가, 점수 단위·평가 주체 미공개 |
| K3.1 Pro 데이터 제거 전 체크포인트 | 90.5% | 각주에 별도 표기 없음 | 공개되지 않는 내부 모델 |
| DeepSeek-V4.1-Flash | 85.7% | Claude Code | 가중치 공개 여부는 보도로만 전해짐 |
| Kimi K3.1 Pro | 81.0% | KimiCode | 공개 예정 모델 |
| GLM-5.3 | 57.1% | Claude Code | — |
| Kimi K3 | 33.3% | 각주에 별도 표기 없음 | 전작 |
이 표에서 읽을 점은 셋입니다. 첫째, 데이터 제거로 점수가 90.5%에서 81.0%로 9.5%p 내려갔습니다. 다만 외부에서 재현할 수 없는 회사 자체 측정이고, 로이터도 그렇게 보도했습니다.
둘째, 원칙 1만으로는 데이터를 깎은 이유가 설명되지 않습니다. 문샷 차트에서도 제거 전 체크포인트(90.5%)가 GPT-5.6 Sol(100)보다 낮습니다. 데이터를 빼지 않았어도 “절대 최전선”을 넘는 상황은 아니었던 셈입니다. 문샷은 K3.1 Pro의 사이버 능력이 공개된 지 3개월 이상 된 최전선 독점 모델보다 뒤처진다고 주장했지만, 실제로 어떤 기준선을 적용했는지는 공개하지 않았습니다.
셋째, 같은 차트에서 DeepSeek-V4.1-Flash(85.7%)가 K3.1 Pro(81.0%)보다 높습니다. 하니스가 달라 단순 비교는 어렵지만, K3.1 Pro가 공개 모델 가운데 해킹 능력 최상위라는 근거는 이 차트에 없습니다.
해킹 위험을 막는 세 회사의 방식
세 회사는 해킹 능력을 어느 지점에서 제한하느냐가 다릅니다. 문샷은 모델이 무엇을 아는지를 깎았고, 다른 두 회사는 누가 쓰는지를 관리합니다.
| 회사 | 제한 지점 | 구체 조치 | 유리한 점 | 한계 |
|---|---|---|---|---|
| 문샷AI | 가중치 자체 | 사이버 데이터를 제거한 뒤 공개 | 사용자가 직접 운영·감사 가능 | 안전장치가 학습 단계 한 번뿐이고, 미세조정으로 능력이 복원되는지 설명이 없음 |
| OpenAI | 접근 통제 | GPT-6 Astra에 신뢰 기반 접근(Trusted Access for Cyber) 적용 | 정책을 사후에 바꿀 수 있음 | 데이터 보관과 모니터링이 따라옴 |
| Anthropic | 인증 등급제 | Cyber Verification Program을 Defense·Red Team·Specialized 3등급으로 운영 | 용도별로 허용 범위를 세분화 | 서비스형 이용이 전제 |
OpenAI는 2026년 9월 3일 게시한 시스템카드에서 “Astra is our first model to reach the Critical level of cybersecurity capability under our Preparedness Framework.”라고 밝혔습니다. 가장 높은 위험 등급을 인정하고 접근을 관리하는 방식입니다.
Anthropic은 2026년 10월 6일 프로그램을 Opus 5.5·Sonnet 5.5·Mythos 5.1로 확대하면서 CyScenarioBench 결과를 공개했습니다. 10개 과제를 5회씩, 등급당 50회 시도한 결과입니다. 인증 없이 접근하면 첫 프롬프트에서 모두 차단됐습니다. Defense 등급은 50회 중 46회 차단됐고, Red Team 등급은 차단 0회에 34회 성공했습니다. 안전장치를 끈 Opus 5.5의 성공률은 67.6%였습니다. 같은 모델이라도 등급에 따라 허용 범위가 이만큼 달라집니다.
키미 AI 가격과 작업당 총비용
Artificial Analysis와 Notebookcheck 집계 기준으로 2026년 10월 현재 K3.1 Pro API 가격은 입력 100만 토큰당 $2, 출력 $10입니다. Implicator 보도에 나온 전작 K3 가격 $3/$15와 비교하면 입력·출력 모두 33.3% 내린 셈입니다. 다만 매체가 집계한 값이라 회사 가격표가 바뀌면 달라질 수 있습니다.
단가가 낮다고 총비용도 낮은 것은 아닙니다. Artificial Analysis는 지수를 측정하면서 출력 토큰 1억 5천만 개를 썼고, 작업당 비용은 $2.11로 집계됐습니다. 출력 속도는 초당 57.5토큰이었습니다. 문샷은 함께 출시한 K3.1 Pro Highspeed가 2~3배 빠르다고 밝혔지만, 회사 측 주장입니다.
API 모델 ID는 kimi-k3.1-pro와 kimi-k3.1-pro-highspeed입니다. API 문서에 따르면 컨텍스트 윈도우는 1M 토큰입니다. max_completion_tokens 기본값은 131,072이며 최대 1,048,576까지 늘릴 수 있습니다. 출력 상한을 크게 잡을수록 작업당 비용도 커질 수 있다는 점을 함께 봐야 합니다.
키미 AI 후기와 외부 평가
외부 기관 평가로는 Artificial Analysis Intelligence Index가 대표적입니다. K3.1 Pro는 55점으로 215개 모델 중 4위를 기록했습니다. Implicator와 Notebookcheck가 인용한 같은 지수에서 Claude Opus 5.5는 58점입니다. 일반 지능 기준으로는 최상위권에 가깝다는 평가입니다.
해킹 능력 제한을 두고는 반응이 더 엇갈립니다. Implicator는 xdev-bench-hard가 공개되지 않아 외부에서 재현할 수 없으므로 외부 적대적 시험이 필요하다는 지적을 전했습니다. Notebookcheck는 Audn AI가 가중치 공개 뒤 안전장치를 걷어내겠다는 계획을 허깅페이스에 올렸다고 보도했습니다. 공개 뒤 미세조정으로 능력이 복원되는지 문샷 블로그가 답하지 않았다는 점은 두 매체 모두 짚었습니다.
용어 풀이
1. 미세조정 — 공개된 모델에 추가 데이터를 넣어 다시 학습시키는 작업입니다. 이 과정에서 제거된 능력이 되살아날 수 있는지가 이번 쟁점의 핵심입니다.
2. 컨텍스트 윈도우 — 모델이 한 번에 읽고 기억할 수 있는 입력 분량으로, 토큰 수로 표시합니다.
상황별 추천
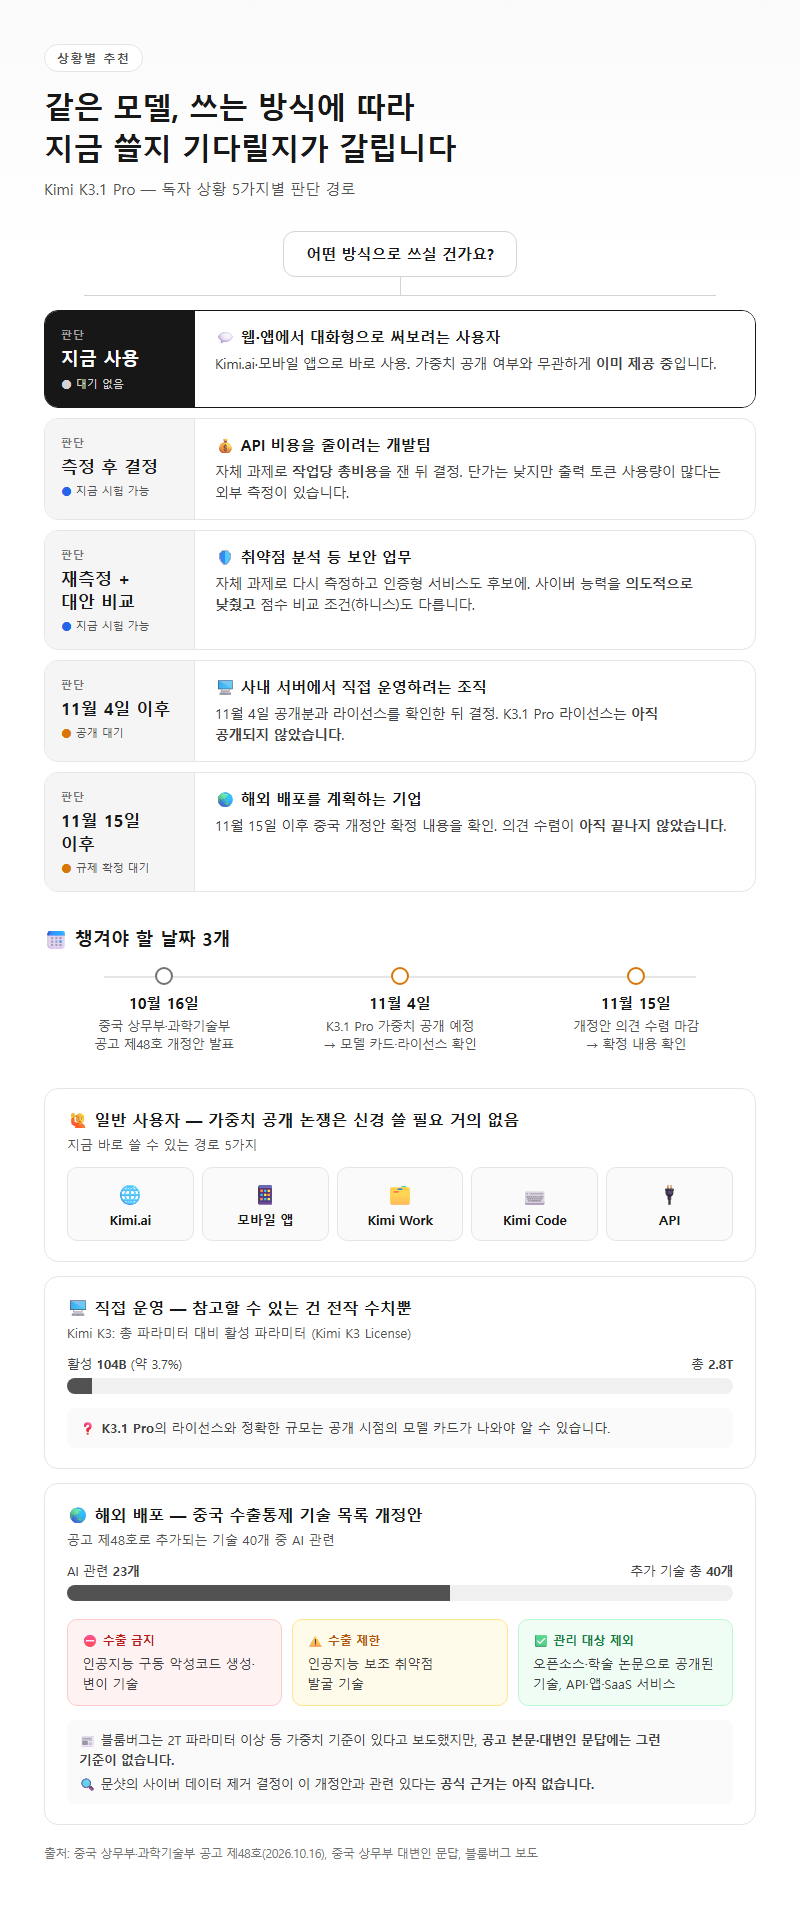
같은 모델이라도 어떻게 쓰느냐에 따라 기다려야 할지 지금 써도 될지가 갈립니다. 독자 상황별 판단은 아래와 같습니다.
| 상황 | 추천 판단 | 근거 |
|---|---|---|
| 웹·앱에서 대화형으로 써보려는 사용자 | 지금 Kimi.ai·모바일 앱으로 사용 | 가중치 공개 여부와 무관하게 이미 제공 중 |
| API 비용을 줄이려는 개발팀 | 자체 과제로 작업당 총비용을 측정한 뒤 결정 | 단가는 낮지만 출력 토큰 사용량이 많다는 외부 측정이 있음 |
| 취약점 분석 등 보안 업무 | 자체 과제로 다시 측정하고, 인증형 서비스도 후보에 넣기 | 사이버 능력을 의도적으로 낮췄고 점수 비교 조건도 다름 |
| 사내 서버에서 직접 운영하려는 조직 | 11월 4일 공개분과 라이선스를 확인한 뒤 결정 | K3.1 Pro 라이선스는 아직 공개되지 않음 |
| 해외 배포를 계획하는 기업 | 11월 15일 이후 중국 개정안 확정 내용 확인 | 의견 수렴이 끝나지 않음 |
일반 사용자라면 가중치 공개 논쟁에 신경 쓸 필요가 거의 없습니다. 지금 쓸 수 있는 경로는 Kimi.ai, 모바일 앱, Kimi Work, Kimi Code, API입니다. 웹과 앱은 11월 4일 공개 여부와 관계없이 이미 쓸 수 있습니다.
보안 업무에 쓰려 한다면 판단이 달라집니다. 문샷은 사이버 관련 데이터를 일부러 뺐고, 경쟁 모델과 점수를 비교할 때도 하니스가 달랐습니다. 업무용으로 고를 거라면 직접 준비한 과제로 다시 재는 것이 가장 확실합니다. 승인된 보안 인력에게 더 넓은 기능을 여는 Anthropic의 인증 등급제 같은 서비스형 대안도 함께 비교할 만합니다.
직접 운영을 원하는 조직은 공개일과 라이선스를 모두 확인해야 합니다. 전작 Kimi K3는 총 2.8T 파라미터 중 104B가 활성화되는 구조이고 Kimi K3 License를 따릅니다. 하지만 K3.1 Pro의 라이선스와 정확한 규모는 공개 시점의 모델 카드가 나와야 알 수 있습니다.
해외 배포를 고려한다면 중국 규제 일정도 챙겨야 합니다. 중국 상무부·과학기술부는 2026년 10월 16일 공고 제48호로 수출통제 기술 목록에 40개 기술을 추가하는 개정안을 냈습니다. 이 가운데 AI 관련이 23개이고, 의견 수렴은 2026년 11월 15일까지입니다. 상무부 대변인 문답에 따르면 인공지능 구동 악성코드 생성·변이 기술은 수출 금지, 인공지능 보조 취약점 발굴 기술은 수출 제한 대상입니다. 반면 오픈소스나 학술 논문으로 이미 공개된 기술, 그리고 API·앱·SaaS로 제공하는 서비스는 관리 대상에서 빠집니다. 블룸버그는 개정안에 2T 파라미터 이상 등의 가중치 기준이 있다고 보도했지만, 상무부 공고 본문과 대변인 문답에는 그런 기준이 나오지 않습니다. 문샷의 데이터 제거 결정이 이 개정안과 관련 있다는 공식 근거도 지금까지는 없습니다.
자주 하는 실수
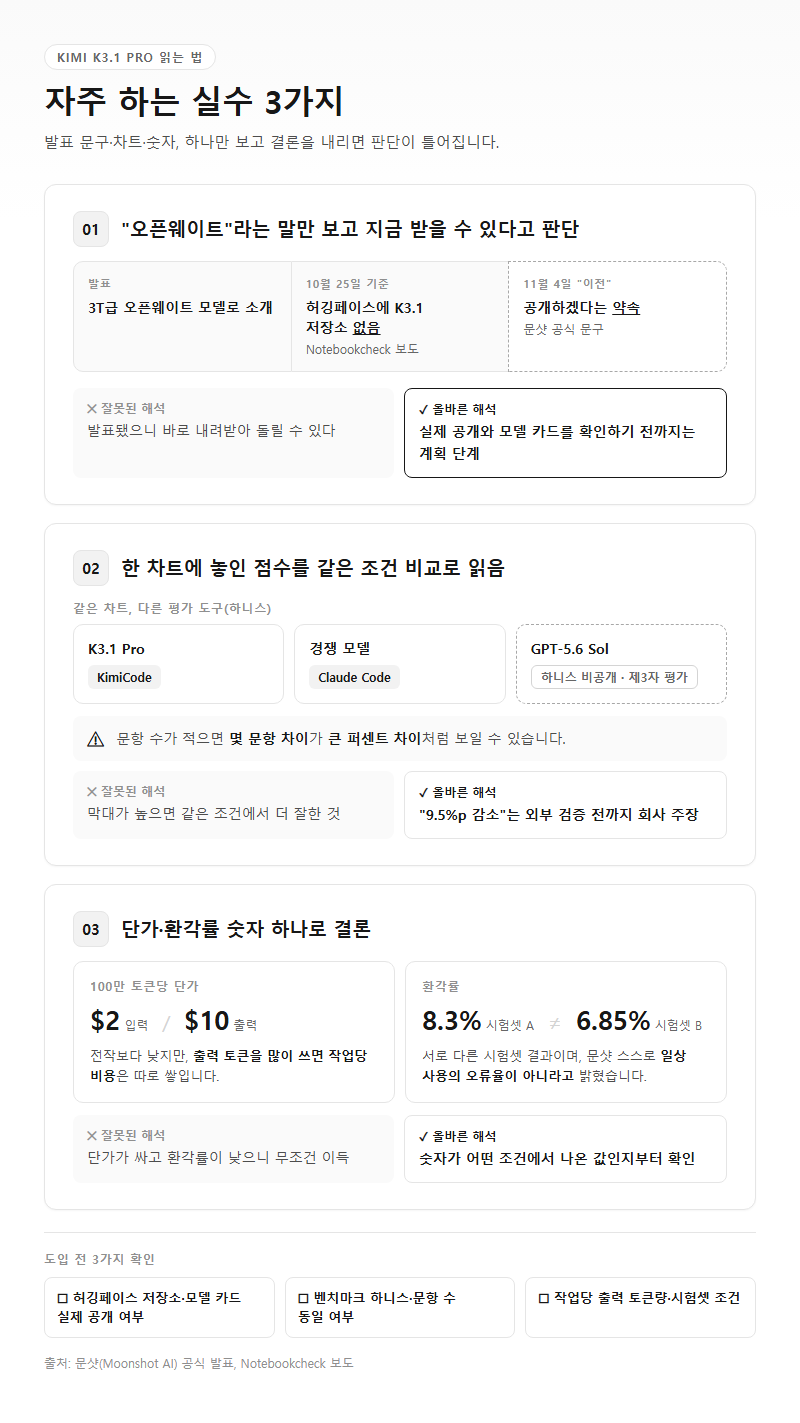
첫째, “오픈웨이트 모델”이라는 발표 문구만 보고 지금 내려받을 수 있다고 판단하는 것입니다. 문샷은 K3.1 Pro를 3T급 오픈웨이트 모델로 소개했지만, 공식 문구는 11월 4일 “이전”에 공개한다는 약속입니다. Notebookcheck는 10월 25일 기준 허깅페이스에 K3.1 저장소가 없었다고 보도했습니다. 실제 공개와 모델 카드를 확인하기 전까지는 계획 단계로 보는 것이 맞습니다.
둘째, 한 차트에 나란히 놓인 점수를 같은 조건의 비교로 읽는 것입니다. K3.1 Pro는 KimiCode, 경쟁 모델은 Claude Code로 평가됐습니다. GPT-5.6 Sol은 하니스가 공개되지 않은 제3자 평가입니다. 문항 수까지 적다면 몇 문항 차이가 큰 퍼센트 차이로 보일 수 있습니다. “9.5%p 감소”는 외부 검증 전까지 회사 주장으로 읽어야 합니다.
셋째, 단가나 환각률 숫자 하나로 결론을 내리는 것입니다. 100만 토큰당 $2/$10이라는 단가는 전작보다 낮지만, 출력 토큰을 많이 쓰면 작업당 비용은 따로 쌓입니다. 환각률 8.3%와 6.85%도 서로 다른 시험셋의 결과이고, 문샷 스스로 일상 사용의 오류율이 아니라고 밝혔습니다. 숫자를 볼 때는 어떤 조건에서 나온 값인지부터 확인하세요.
정리
Kimi K3.1 Pro는 공개를 보류한 모델이 아닙니다. 사이버 데이터를 빼서 해킹 능력을 낮춘 뒤 2026년 11월 4일까지 가중치를 공개하겠다고 예고한 모델입니다. 다만 그 효과를 보여주는 수치(90.5%→81.0%)는 외부에서 재현할 수 없는 자체 시험 결과이고, 경쟁 모델과는 하니스가 달라 같은 조건의 비교도 아닙니다. 문샷은 모델이 아는 것을 깎았고, OpenAI·Anthropic은 쓰는 사람을 관리합니다. 접근 방식부터 다릅니다.
한 줄로 정리하면, 웹·앱 사용자는 지금 써도 됩니다. 보안 업무나 직접 운영이 목적이라면 11월 4일 공개분과 외부 재현 결과를 확인한 뒤 판단하세요.
함께 보면 좋은 제품
- 라이프밀 홀그레인 저당 그래놀라 그릭요거트토핑 귀리 시리얼 140g (11,000원)
- 그릭요거트 토핑을 올린 귀리 그래놀라 시리얼입니다.
위 링크는 제휴 링크이며, 제품 선택은 독자의 판단입니다.
참고 자료
- Kimi 공식 블로그, Kimi K3.1 Pro 발표: https://www.kimi.ai/blog/kimi-k3-1-pro
- Kimi API 문서, K3.1 Pro quickstart: https://platform.kimi.ai/docs/guide/kimi-k3-1-pro-quickstart
- Hugging Face, moonshotai/Kimi-K3: https://huggingface.co/moonshotai/Kimi-K3
- 중국 상무부 공고 2026년 제48호: https://www.mofcom.gov.cn/zwgk/zcfb/art/2026/art_0a31a3c9ac404f7a9b0e917ce3412997.html
- 중국 상무부 대변인 문답: https://www.mofcom.gov.cn/syxwfb/art/2026/art_a4acff07e134447fbe7bbeb486df3ea6.html
- OpenAI, GPT-6 Astra Deployment Safety: https://deploymentsafety.openai.com/gpt-6-astra
- Anthropic, Cyber Verification Program: https://www.anthropic.com/news/cyber-verification-program
- Artificial Analysis, Kimi K3.1 Pro 모델 페이지: https://artificialanalysis.ai/models/kimi-k3-1-pro
- Reuters(Yahoo 게재), 2026년 10월 24일: https://www.yahoo.com/news/articles/moonshot-curbs-hacking-ability-kimi-042516641.html
- The Next Web: https://thenextweb.com/news/moonshot-kimi-k3-1-pro-open-weight-cyber
- Implicator: https://www.implicator.ai/kimi-k3-1-pro-hacking-cut-unpublished-test/
- Notebookcheck: https://www.notebookcheck.net/Kimi-K3-1-Pro-Free-to-try-hacking-skills-deliberately-weakened.1433507.0.html
답글 남기기