
AI 코딩 에이전트가 만든 리팩터링 부채를 2026년 9월 기준 실측 데이터로 정리했습니다. GitClear 6억 건 분석, SWE-Bench ProMax 41.2%, Bun 11일 100만 줄 이식 사례까지 근거 중심으로 짚어봅니다.
AI에이전트 핵심만 먼저 정리하면
AI 코딩 에이전트를 대규모 리팩터링에 투입할지 가르는 기준은 모델 성능이 아니라 병합 전 검증 파이프라인이 있느냐입니다. 2023년부터 2026년까지 코드 변경 6억 2,300만 건을 분석했더니 리팩터링(이동 코드)은 70% 줄었고 블록 중복은 81% 늘었습니다[T2: LeadDev 2026-07-07 보도]. 같은 기간 DORA 2025 설문에서는 개발자 59%가 AI가 코드 품질에 긍정적이라고 답했습니다. 자기 보고와 계측이 정반대를 가리킵니다[T1: blog.google 2025-09-23]. 물론 11일 만에 Zig 535,496줄을 Rust로 옮긴 Bun 사례처럼 성공 기록도 있습니다. 그 팀은 구현자·적대적 리뷰어·수정자를 분리한 검증 구조를 사람이 직접 설계했습니다[T1: bun.com 2026-07-08]. 이 글은 2026년 9월 6일까지 공개된 벤치마크·계측·논문을 대조해, 어떤 조건에서 에이전트 리팩터링이 성립하고 어디서 부채로 되돌아오는지 정리한 개발자 트랙 문서입니다.
Q1. AI가 코드를 빨리 짜주는데 왜 리팩터링 부채가 쌓인다는 건가요?
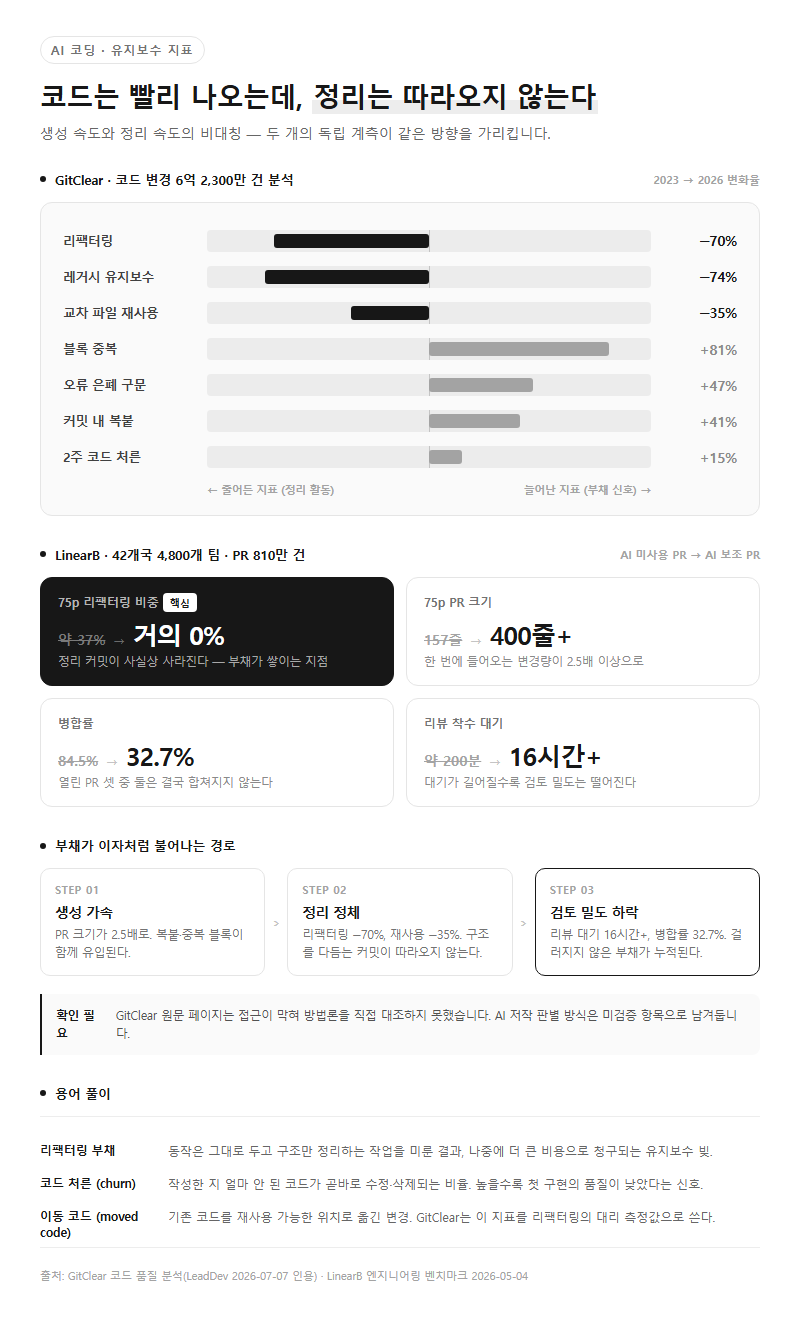
생성 속도와 정리 속도가 비대칭이라서 그렇습니다. GitClear가 2023~2026년 코드 변경 6억 2,300만 건을 분석한 지표는 한 방향을 가리킵니다. 리팩터링 −70%, 블록 중복 +81%, 커밋 내 복붙 +41%, 오류 은폐 구문 +47%, 교차 파일 재사용 −35%, 레거시 유지보수 −74%, 2주 코드 처른 +15%입니다[T2: LeadDev 2026-07-07]. 다만 GitClear 원문 페이지는 접근이 막혀 방법론을 직접 대조하지 못했습니다. AI 저작 판별 방식은 확인 필요 항목으로 남겨둡니다.
PR 단위 계측도 같은 방향입니다. LinearB가 42개국 4,800개 팀의 PR 810만 건을 집계한 2026년 5월 4일자 벤치마크를 보면 이렇습니다.
| 지표 | AI 미사용 PR | AI 보조 PR |
|---|---|---|
| 75퍼센타일 PR 크기 | 157줄 | 400줄 초과 |
| 75퍼센타일 리팩터링 비중 | 약 37% | 거의 0% |
| 병합률 | 84.5% | 32.7% |
| 리뷰 착수 대기 | 약 200분 | 16시간 초과 |
리팩터링 비중이 사실상 0에 수렴한다는 대목이 핵심입니다[T2: LinearB 2026-05-04]. 코드는 더 많이 들어오는데 정리 커밋은 그만큼 따라오지 않습니다. 리뷰 대기 시간까지 늘어나니 검토 밀도도 떨어집니다. 이 구조가 반복되면 부채는 이자처럼 불어납니다.
용어 풀이
1. 리팩터링 부채 — 동작은 그대로 두고 구조만 정리하는 작업을 미룬 결과, 나중에 더 큰 비용으로 청구되는 유지보수 빚입니다.
2. 코드 처른(churn) — 작성한 지 얼마 안 된 코드가 곧바로 수정·삭제되는 비율로, 높을수록 첫 구현의 품질이 낮았다는 신호입니다.
3. 이동 코드(moved code) — 기존 코드를 재사용 가능한 위치로 옮긴 변경으로, GitClear는 이 지표를 리팩터링의 대리 측정값으로 씁니다.
Q2. 벤치마크 점수가 높은 최신 모델을 쓰면 리팩터링도 잘 되는 것 아닌가요?
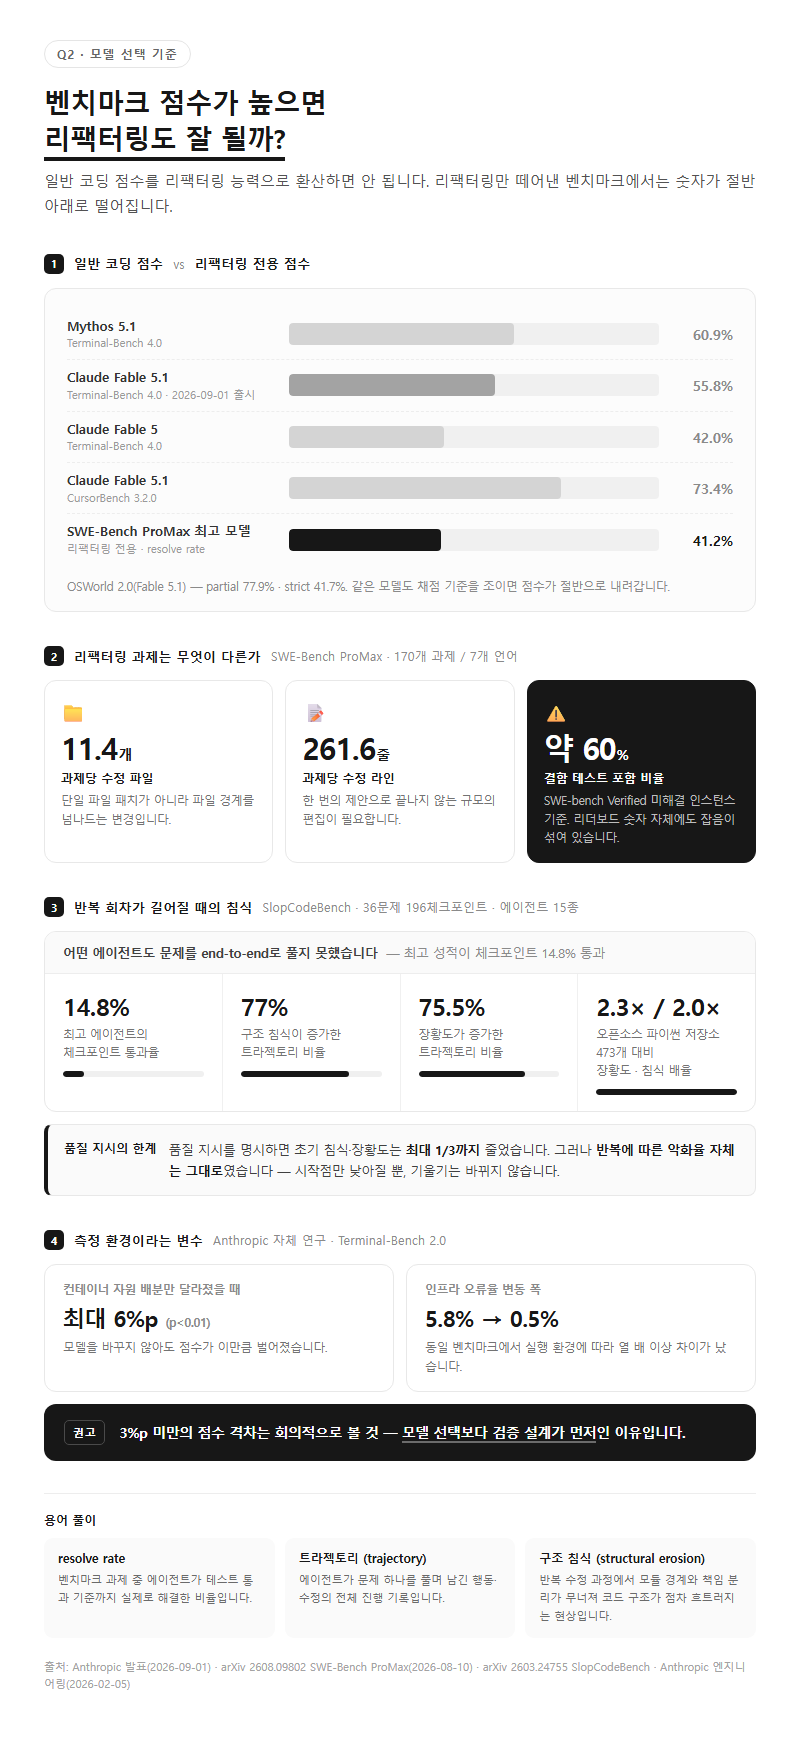
일반 코딩 점수를 리팩터링 능력으로 환산하면 안 됩니다. 2026년 9월 1일 출시된 Claude Fable 5.1은 Terminal-Bench 4.0에서 55.8%를 기록했고(Fable 5는 42.0%, Mythos 5.1은 60.9%), CursorBench 3.2.0은 73.4%, OSWorld 2.0은 partial 77.9%·strict 41.7%입니다[T1: Anthropic 발표 2026-09-01]. 반면 리팩터링만 떼어낸 벤치마크의 숫자는 훨씬 낮습니다.
SWE-Bench ProMax(arXiv 2608.09802, 2026년 8월 10일)는 7개 언어 170개 리팩터링 과제로 짜여 있고, 과제당 평균 11.4개 파일·261.6줄을 고쳐야 합니다. 여기서 최고 모델의 resolve rate는 41.2%에 그쳤습니다. 같은 논문은 SWE-bench Verified의 미해결 인스턴스 중 약 60%가 결함 있는 테스트를 포함한다고 보고했습니다[T1: arXiv 2608.09802]. 기존 리더보드 숫자 자체에도 잡음이 섞여 있다는 뜻입니다.
반복 회차가 길어질 때의 침식은 더 뚜렷합니다. SlopCodeBench(arXiv 2603.24755)는 36개 문제·196개 체크포인트에서 코딩 에이전트 15종을 측정했는데, 어떤 에이전트도 문제를 end-to-end로 풀지 못했고 최고 성적이 체크포인트 14.8% 통과였습니다. 구조 침식은 트라젝토리의 77%, 장황도는 75.5%에서 늘었고, 오픈소스 파이썬 저장소 473개와 비교하면 장황도 2.3배·침식 2.0배였습니다. 품질 지시를 명시하면 초기 침식과 장황도가 최대 1/3까지 줄었지만, 반복에 따른 악화율 자체는 그대로였습니다[T1: arXiv 2603.24755].
여기에 측정 환경 변수까지 겹칩니다. Anthropic 자체 연구는 컨테이너 자원 배분만 달라져도 Terminal-Bench 2.0 점수가 최대 6%p(p<0.01) 벌어졌고, 인프라 오류율은 5.8%에서 0.5%로 바뀌었다고 밝히며 3%p 미만 격차는 회의적으로 보라고 권고했습니다[T1: Anthropic 엔지니어링 2026-02-05]. 모델 선택보다 검증 설계가 먼저인 이유가 여기에 있습니다.
용어 풀이
1. resolve rate — 벤치마크 과제 중 에이전트가 테스트 통과 기준까지 실제로 해결한 비율입니다.
2. 트라젝토리(trajectory) — 에이전트가 문제 하나를 풀며 남긴 행동·수정의 전체 진행 기록입니다.
3. 구조 침식(structural erosion) — 반복 수정 과정에서 모듈 경계와 책임 분리가 무너져 코드 구조가 점차 흐트러지는 현상입니다.
Q3. 11일 만에 100만 줄을 옮겼다는 Bun 사례는 무엇을 증명하나요?
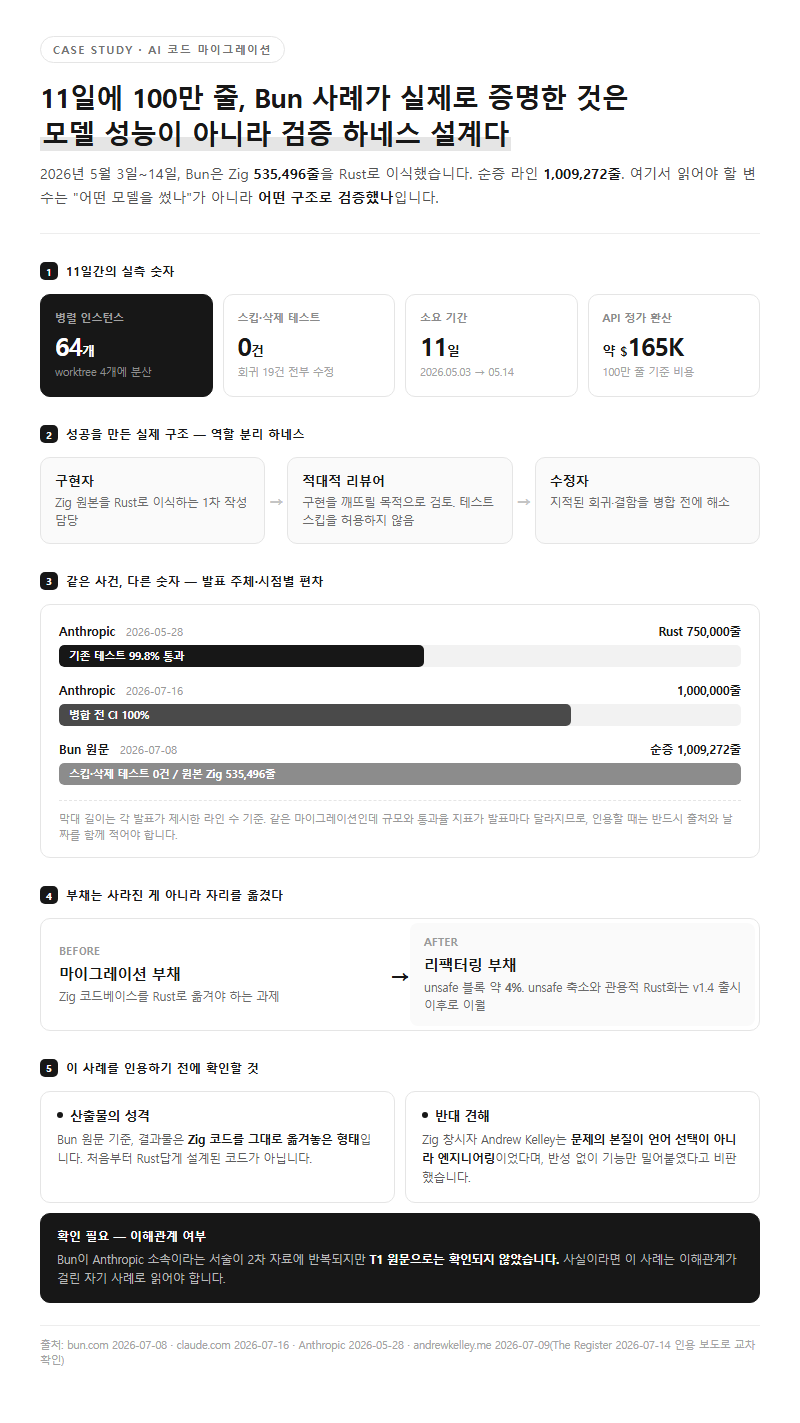
모델의 능력이 아니라 검증 하네스 설계의 효과를 증명합니다. Bun은 2026년 5월 3일부터 5월 14일까지 11일간 Zig 535,496줄을 Rust로 이식했고, 순증 라인은 1,009,272줄입니다. 최대 64개 Claude 인스턴스를 구현자·적대적 리뷰어·수정자로 나눠 worktree 4개에서 병렬로 돌렸으며, 스킵하거나 삭제한 테스트는 0건, 알려진 회귀 19건은 모두 고쳤습니다. 토큰은 입력 59억·출력 6.9억·캐시 입력 읽기 720억이 들어갔고 API 정가로 환산하면 약 $165,000입니다[T1: bun.com 2026-07-08].
같은 사건의 숫자가 발표 주체와 시점마다 달라진다는 점은 짚고 가야 합니다.
| 출처 | 규모 | 테스트 통과율 |
|---|---|---|
| Anthropic 2026-05-28 | Rust 750,000줄 | 기존 테스트 99.8% |
| Anthropic 2026-07-16 | 100만 줄 | 병합 전 CI 100% |
| Bun 원문 2026-07-08 | Zig 535,496줄 → 순증 1,009,272줄 | 스킵·삭제 테스트 0건 |
더 중요한 단서는 결과물의 성격입니다. Bun 원문은 산출물이 Zig 코드를 그대로 옮겨놓은 형태이며, ** 축소와 관용적 Rust화는 v1.4 출시 이후 점진 리팩터링 과제로 이월**했다고 밝혔습니다. Rust 코드 중 unsafe 블록 비중은 약 4%입니다[T1: bun.com 2026-07-08, claude.com 2026-07-16]. 마이그레이션 부채가 사라진 게 아니라 리팩터링 부채로 자리를 옮긴 셈입니다.
Zig 창시자 Andrew Kelley는 이 리라이트를 두고 문제의 본질이 언어 선택이 아니라 엔지니어링이었다고 반박하며, 반성 없이 기능만 밀어붙였다는 취지로 비판했습니다[T2: andrewkelley.me 2026-07-09; The Register 2026-07-14 인용 보도로 교차 확인]. 참고로 Bun이 Anthropic 소속이라는 서술이 2차 자료에 반복되지만 T1 원문으로는 확인하지 못했습니다(확인 필요). 사실이라면 위 사례는 이해관계가 걸린 자기 사례로 읽어야 합니다.
Q4. 개발자가 체감하는 생산성과 실제 측정치는 얼마나 다른가요?
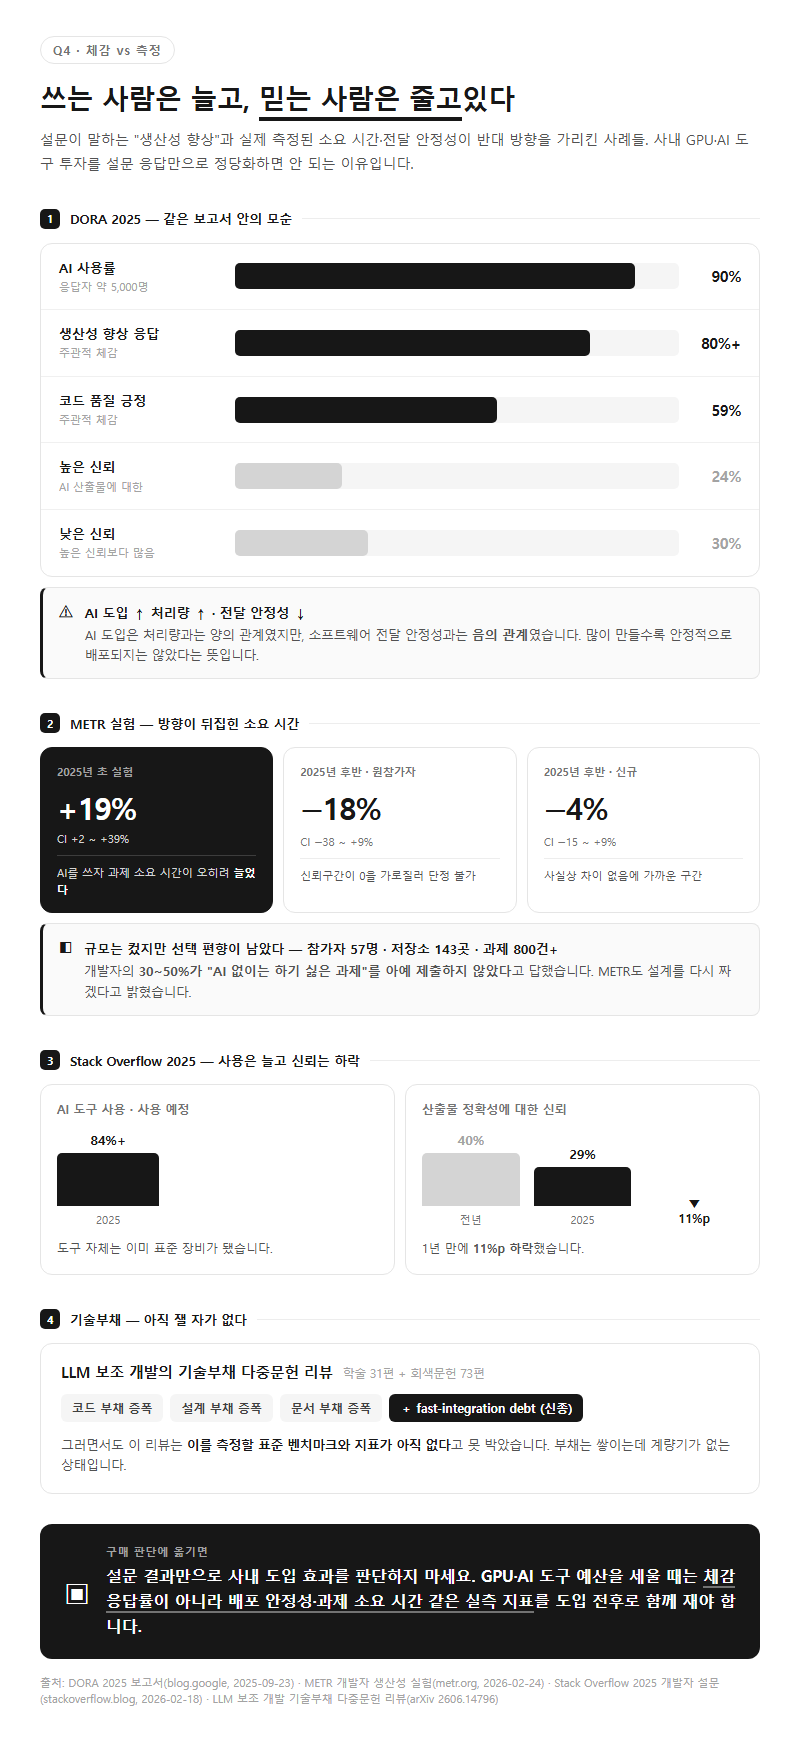
방향이 반대로 나온 사례가 여러 건 있습니다. DORA 2025 보고서(2025년 9월 23일, 응답자 약 5,000명)는 AI 사용률 90%, 생산성 향상 응답 80% 이상, 코드 품질 긍정 59%를 보고하면서도 높은 신뢰 24% 대 낮은 신뢰 30%로 신뢰가 갈린다는 점을 함께 밝혔습니다. 결정적으로 AI 도입은 처리량과 양의 관계지만 소프트웨어 전달 안정성과는 음의 관계였습니다[T1: blog.google 2025-09-23].
METR의 개발자 생산성 실험은 더 직접적입니다. 2025년 초 실험에서 AI를 쓰면 과제 소요 시간이 오히려 19%(신뢰구간 +2~+39%) 늘었습니다. 2025년 후반 재실험에서는 원참가자 −18%(CI −38~+9%), 신규 참가자 −4%(CI −15~+9%)로 방향이 뒤집혔지만 신뢰구간이 0을 가로질러 단정할 수 없습니다. 참가자 57명·저장소 143곳·과제 800건 이상 규모였고, 개발자의 30~50%가 AI 없이는 하기 싫은 과제를 아예 제출하지 않았다고 답해 선택 편향이 커졌습니다. METR도 설계를 다시 짜겠다고 밝혔습니다[T2: metr.org 2026-02-24].
신뢰 지표도 떨어지는 중입니다. Stack Overflow 2025 개발자 설문에서 AI 도구 사용·사용 예정은 84% 이상인데 정확성 신뢰는 29%로 전년 대비 11%p 떨어졌습니다[T2: stackoverflow.blog 2026-02-18]. 쓰는 사람은 늘고 믿는 사람은 주는 구조입니다.
학계 정리도 같은 결입니다. LLM 보조 개발의 기술부채 다중문헌 리뷰(arXiv 2606.14796, 학술 31편 + 회색문헌 73편)는 LLM이 코드·설계·문서 부채를 증폭하고 fast-integration debt 같은 신종 부채를 만든다고 정리하면서, 이를 측정할 표준 벤치마크와 지표가 아직 없다고 못 박았습니다[T1: arXiv 2606.14796]. 설문 결과만으로 사내 도입 효과를 판단하면 안 되는 이유입니다.
Q5. 도입 비용은 어떻게 잡고, 어떤 조건이면 하지 말아야 하나요?
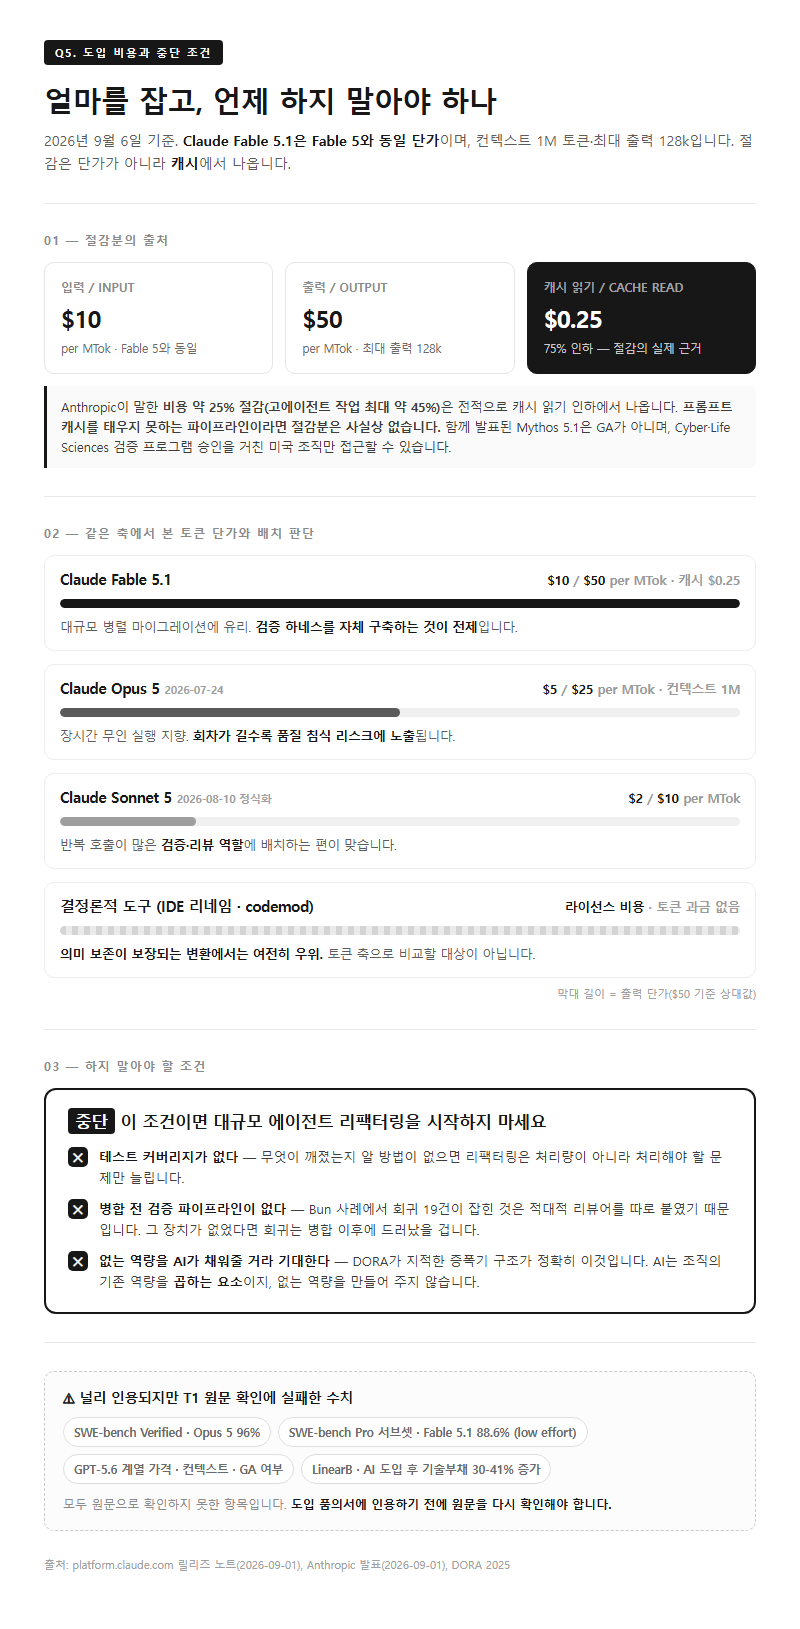
먼저 가격 표기를 정확히 읽어야 합니다. 2026년 9월 6일 기준 Claude Fable 5.1은 입력 $10 / 출력 $50 per MTok로 Fable 5와 같고, 기본 컨텍스트 1M 토큰·최대 출력 128k입니다. Anthropic이 말한 비용 약 25% 절감(고에이전트 작업 최대 약 45%)의 근거는 캐시 읽기 $0.25/MTok, 즉 75% 인하입니다[T1: platform.claude.com 릴리즈 노트 2026-09-01, Anthropic 발표 2026-09-01]. 프롬프트 캐시를 태우지 못하는 파이프라인이라면 절감분은 사실상 없습니다. 함께 발표된 Mythos 5.1은 GA가 아니며 Cyber·Life Sciences 검증 프로그램 승인을 거친 미국 조직만 접근할 수 있습니다.
| 선택지 | 단가(2026-09-06 기준) | 리팩터링 관점의 판단 |
|---|---|---|
| Claude Fable 5.1 | $10 / $50 per MTok, 캐시 읽기 $0.25 | 대규모 병렬 마이그레이션에 유리, 검증 하네스 자체 구축이 전제 |
| Claude Opus 5 (2026-07-24) | $5 / $25 per MTok, 컨텍스트 1M | 장시간 무인 실행 지향, 회차가 길수록 품질 침식 리스크 노출 |
| Claude Sonnet 5 | $2 / $10 per MTok (2026-08-10 정식화) | 반복 호출이 많은 검증·리뷰 역할에 배치 |
| 결정론적 도구(IDE 리네임·codemod) | 라이선스 비용 | 의미 보존이 보장되는 변환에서는 여전히 우위 |
하지 말아야 할 조건은 명확합니다. 테스트 커버리지와 병합 전 검증 파이프라인이 없다면 대규모 에이전트 리팩터링은 처른만 늘립니다. DORA가 지적한 증폭기 구조가 정확히 이것입니다. AI는 조직의 기존 역량을 곱하는 요소이지 없는 역량을 만들어 주지 않습니다[T1: DORA 2025]. Bun 사례에서 회귀 19건이 발견된 것도 적대적 리뷰어를 따로 붙였기 때문이며, 그 장치가 없었다면 회귀는 병합 이후에 드러났을 겁니다.
참고로 널리 인용되는 몇몇 수치는 원문 확인에 실패했습니다. SWE-bench Verified에서 Opus 5가 96%라는 값, Fable 5.1의 SWE-bench Pro 서브셋 88.6%(low effort), GPT-5.6 계열의 가격·컨텍스트·GA 여부, LinearB의 “AI 도입 후 기술부채 30~41% 증가”는 모두 T1 원문으로 확인하지 못한 항목입니다. 도입 품의서에 인용하기 전에 원문을 다시 확인해야 합니다.
정리
AI 코딩 에이전트의 생성 능력은 실증됐습니다. 다만 계측 지표는 리팩터링이 70% 줄고 중복이 81% 늘었다고 말합니다. 리팩터링 전용 벤치마크에서 최고 모델의 resolve rate는 41.2%, 반복 확장 과제에서는 최고 에이전트도 체크포인트 14.8%만 통과했으니 일반 코딩 점수를 리팩터링 능력으로 환산해서는 안 됩니다. Bun이 11일 만에 50만 줄을 옮긴 재현 가능한 요소는 모델이 아니라 구현자·적대적 리뷰어·수정자 분리, worktree 4개 병렬, 병합 전 CI 전량 통과라는 검증 구조였고, 그 팀조차 관용적 Rust화를 다음 과제로 미뤘습니다. 판단 기준은 결국 하나입니다. 검증 파이프라인이 있으면 에이전트 대규모 리팩터링이 성립하고, 없으면 부채만 앞당겨 쌓입니다.
참고 자료
조사 기준일: 2026년 09월 06일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (확인일 2026-09-06)
– Anthropic, Introducing Claude Fable 5.1 and Claude Mythos 5.1 — https://www.anthropic.com/claude-fable-and-mythos-5-1
– Claude Platform 릴리즈 노트(API) — https://platform.claude.com/docs/en/release-notes/api
– Anthropic, Introducing Claude Opus 5 (2026-07-24) — https://www.anthropic.com/news/claude-opus-5
– Anthropic, Quantifying infrastructure noise in agentic coding evals (2026-02-05) — https://www.anthropic.com/engineering/infrastructure-noise
– Claude, Introducing dynamic workflows in Claude Code (2026-05-28) — https://claude.com/blog/introducing-dynamic-workflows-in-claude-code
– Claude, How Anthropic runs large-scale code migrations with Claude Code (2026-07-16) — https://claude.com/blog/ai-code-migration
– Bun, Rewriting Bun in Rust (2026-07-08) — https://bun.com/blog/bun-in-rust
– OpenAI Codex 체인지로그 — https://learn.chatgpt.com/docs/changelog
– Google, How are developers using AI? Inside Google’s 2025 DORA report (2025-09-23) — https://blog.google/innovation-and-ai/technology/developers-tools/dora-report-2025/
– DORA, State of AI-assisted Software Development 2025 — https://dora.dev/dora-report-2025/
– arXiv 2608.09802, SWE-Bench ProMax (2026-08-10) — https://arxiv.org/abs/2608.09802
– arXiv 2603.24755, SlopCodeBench (2026-03-25) — https://arxiv.org/abs/2603.24755
– arXiv 2606.14796, Faster Code, Deeper Debt? (2026-06-11) — https://arxiv.org/abs/2606.14796
Tier 2 (확인일 2026-09-06)
– LeadDev, Code maintainability plummets in the AI coding era (2026-07-07) — https://leaddev.com/ai/code-maintainability-plummets-in-the-ai-coding-era
– LeadDev, How AI generated code accelerates technical debt (2025-02-19) — https://leaddev.com/technical-direction/how-ai-generated-code-accelerates-technical-debt
– LinearB, 8 million pull requests reveal where engineering productivity breaks down (2026-05-04) — https://linearb.io/blog/8-million-prs-engineering-productivity
– METR, We are Changing our Developer Productivity Experiment Design (2026-02-24) — https://metr.org/blog/2026-02-24-uplift-update/
– Stack Overflow, Mind the gap: Closing the AI trust gap for developers (2026-02-18) — https://stackoverflow.blog/2026/02/18/closing-the-developer-ai-trust-gap/
– Andrew Kelley, My Thoughts on the Bun Rust Rewrite (2026-07-09) — https://andrewkelley.me/post/my-thoughts-bun-rust-rewrite.html
– The Register, Zig creator calls Bun’s Claude Rust rewrite ‘unreviewed slop’ (2026-07-14) — https://www.theregister.com/devops/2026/07/14/zig-creator-calls-buns-claude-rust-rewrite-unreviewed-slop/
답글 남기기