
OpenAI Habitat은 임의 SQL을 막고 객체·엣지 API, Cosmos DB, CDC를 조합해 초당 7천만 건 이상을 처리하는 사내 스토리지입니다. PostgreSQL·Meta TAO와 설계를 비교하고 Rust 전환 수치를 어디까지 믿을 수 있는지 정리했습니다.
OpenAI Habitat, 무엇을 기준으로 비교해야 할까
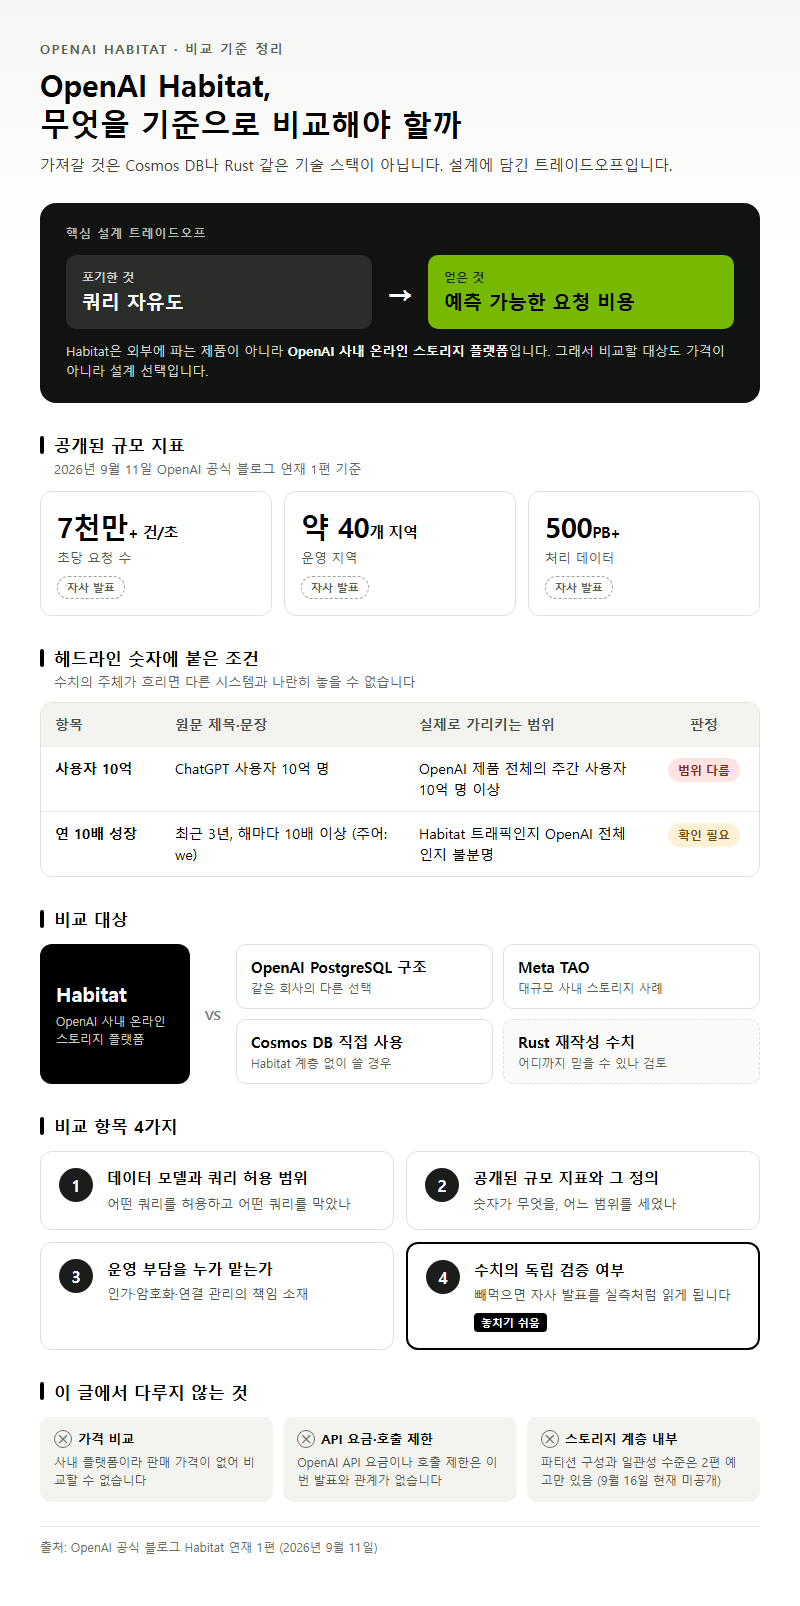
OpenAI Habitat의 스토리지 구조는 쿼리 자유도를 포기하고 요청 비용을 예측 가능하게 만든 설계입니다. 그러니 가져갈 것은 Cosmos DB나 Rust 같은 기술 스택이 아니라 이 트레이드오프입니다. 2026년 9월 11일 OpenAI 공식 블로그에 올라온 연재 1편을 보면, Habitat은 초당 7천만 건 이상의 요청, 약 40개 지역, 500PB 이상의 데이터를 처리합니다. 이 글에서는 OpenAI Habitat 아키텍처를 OpenAI의 PostgreSQL 구조, Meta TAO, Cosmos DB 직접 사용과 비교하고, Rust 재작성 수치를 어디까지 믿을 수 있는지 따져봅니다. 스토리지 계층 내부(파티션 구성, 일관성 수준)는 2편에서 다룬다는 예고만 나왔습니다. 2026년 9월 16일 현재 2편이 올라오지 않아 이 글에서는 빼두었습니다.
비교하기 전에 헤드라인 숫자에 붙은 조건부터 봐야 합니다. 원문 제목은 ChatGPT 사용자 10억 명이지만, 본문에 적힌 수치는 OpenAI 제품 전체의 주간 사용자 10억 명 이상입니다. 성장률도 마찬가지입니다. 최근 3년 동안 해마다 10배 이상 성장했다는 문장의 주어가 we라서, Habitat 트래픽 이야기인지 OpenAI 전체 이야기인지 원문만으로는 알 수 없습니다(확인 필요). 수치의 주체가 흐리면 다른 시스템과 나란히 놓을 수 없습니다.
Habitat은 외부에 파는 제품이 아니라 OpenAI 사내 온라인 스토리지 플랫폼이라는 점도 짚어둡니다. 그래서 가격 비교는 불가능하고, OpenAI API 요금이나 호출 제한도 이번 발표와 관계가 없습니다. 이 글에서 비교하는 항목은 네 가지입니다. ① 데이터 모델과 쿼리 허용 범위 ② 공개된 규모 지표와 그 정의 ③ 인가·암호화·연결 관리 같은 운영 부담을 누가 맡는지 ④ 수치가 독립적으로 검증됐는지. 넷째 항목을 빼먹으면 자사 발표를 실측처럼 읽게 됩니다.
비교 기준 정리
아래 표에 대규모 온라인 스토리지를 비교할 때 확인할 항목과 단위, 그리고 Habitat 발표에서 각 항목이 공개된 현황을 정리했습니다. 수치는 2026년 9월 11일 OpenAI 블로그와 2026년 1월 22일 PostgreSQL 글을 기준으로 했습니다.
| 비교 항목 | 기준·단위 | Habitat 공개 현황 | 주의점 |
|---|---|---|---|
| 처리량 | 초당 요청 수(rps) | 현재 7천만 건 이상 / Python 시절 최대 2천만 건 이상 | 두 값은 측정 시점과 구현 언어가 달라 같은 조건의 비교가 아님 |
| 사용자 규모 | 주간 사용자 수 | 10억 명 이상 | ChatGPT 단독이 아니라 OpenAI 제품 전체 기준 |
| 데이터량 | 서빙 데이터(PB) | 500PB 이상 | Cosmos DB 계정·파티션 구성은 1편에 없음 |
| 쿼리 자유도 | 허용하는 쿼리 형태 | 객체·엣지 기반 NoSQL API | 임의 SQL, 대규모 스캔, 조인을 허용하지 않음 |
| 지연 | p50·p99(ms) | 공개 안 됨 | 참고로 PostgreSQL 글은 p99 두 자릿수 초반 ms를 공개 |
| 가용성 | 퍼센트(%) | 공개 안 됨 | PostgreSQL 글은 99.999%를 공개 |
| 자원 효율 | CPU·메모리 배수 | Rust가 Python 대비 6배·15배 | 측정 조건 비공개, 제3자 재측정 없음 |
| 운영 지역 | 지역 수 | 약 40곳 | 지역 목록은 미공개 |
표에서 먼저 눈에 띄는 건 지연과 가용성 수치가 비어 있다는 점입니다. 2026년 9월 15일 HackerNoon 분석 글도 이 부분을 짚었습니다. 꼬리 지연 문제를 핵심 서사로 삼으면서 정작 지연 수치는 하나도 내놓지 않았다는 지적입니다. OpenAI는 앞선 PostgreSQL 글에서 p99와 가용성을 모두 밝혔으니, 두 글을 나란히 놓으면 Habitat 쪽의 공개 범위가 더 좁습니다.
처리량도 조심해서 읽어야 합니다. 7천만 건은 Rust 서비스가 대부분을 처리하는 현재의 전체 트래픽이고, 2천만 건은 Python 서비스가 기록한 최대치입니다. 둘을 나눠 Rust가 3.5배 더 처리한다고 계산하면 오독입니다. .NET Ramblings 발췌문에는 초당 2,200만 건으로 적혀 있지만 공식 원문에는 이 숫자가 없습니다.
용어 풀이
1. p99 지연 — 요청 100건 중 가장 느린 1건을 뺀 나머지가 모두 들어오는 응답 시간으로, 사용자가 체감하는 최악의 느림에 가깝습니다.
2. 꼬리 지연(tail latency) — 평균은 빠른데 일부 요청만 유난히 느려지는 현상으로, 요청이 여러 번 이어지는 서비스에서 전체 체감 속도를 끌어내립니다.
옵션·유형별 비교
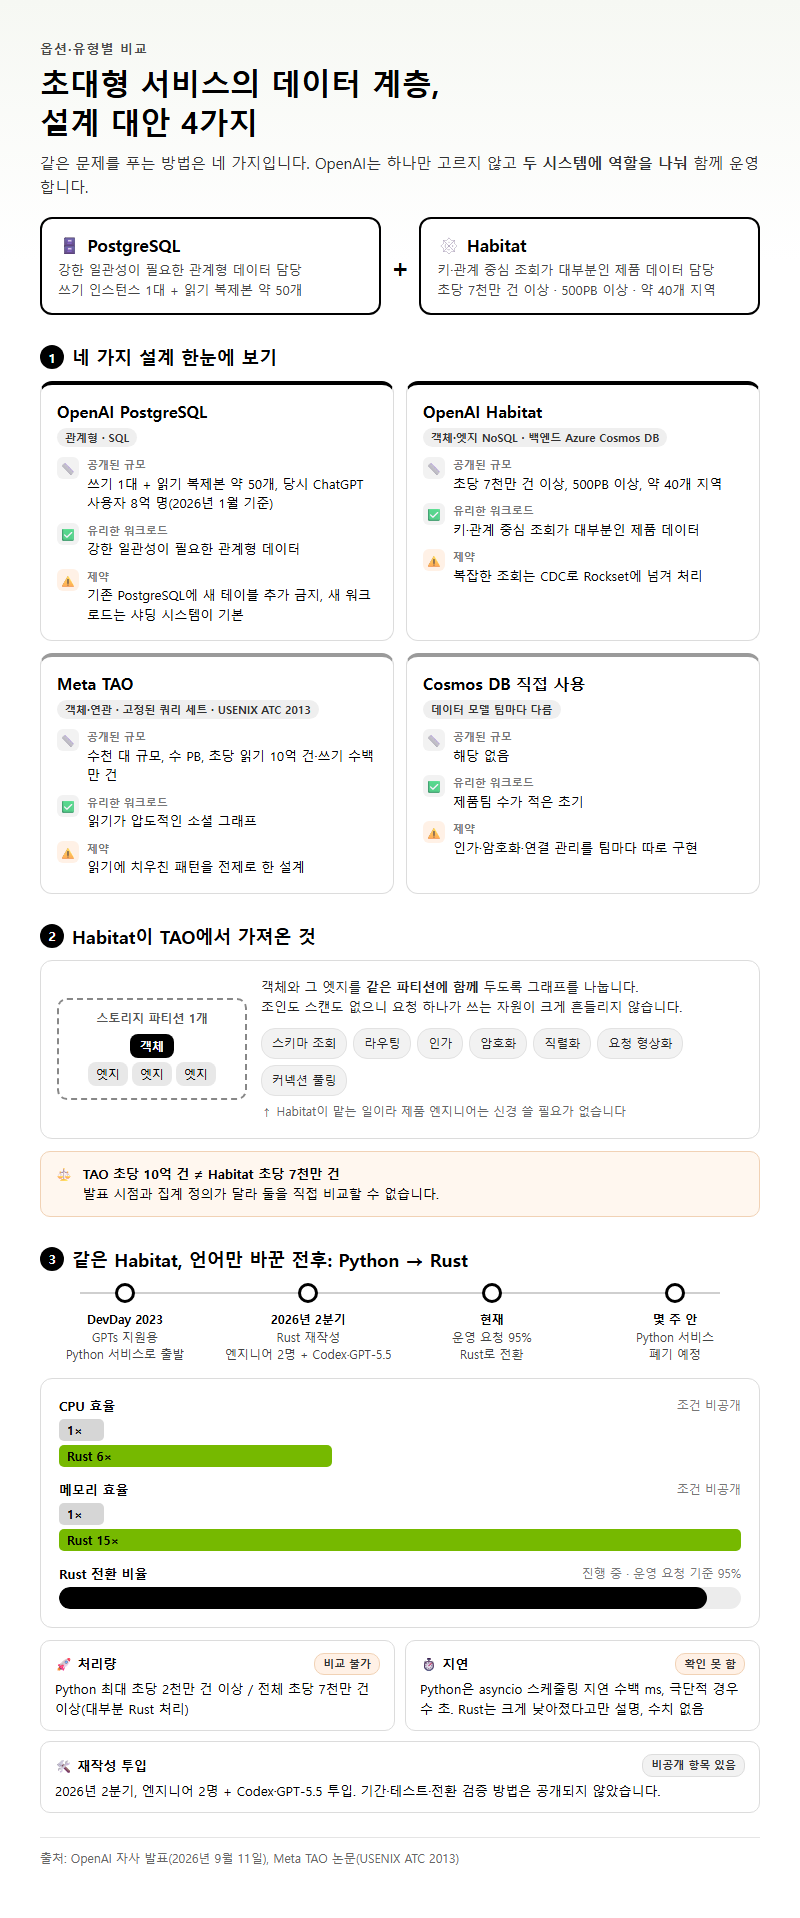
같은 문제, 즉 초대형 소비자 서비스의 온라인 데이터 계층을 푸는 설계 대안은 크게 네 가지입니다. OpenAI는 이 중 하나만 쓰지 않고 PostgreSQL과 Habitat에 역할을 나눠 함께 운영합니다.
| 설계 | 데이터 모델·쿼리 | 공개된 규모 | 유리한 워크로드 | 제약 |
|---|---|---|---|---|
| OpenAI PostgreSQL | 관계형, SQL | 쓰기 인스턴스 1대 + 읽기 복제본 약 50개, 당시 ChatGPT 사용자 8억 명(2026년 1월 기준) | 강한 일관성이 필요한 관계형 데이터 | 기존 PostgreSQL에 새 테이블 추가 금지, 새 워크로드는 샤딩 시스템이 기본 |
| OpenAI Habitat | 객체·엣지 NoSQL, 백엔드 Azure Cosmos DB | 초당 7천만 건 이상, 500PB 이상, 약 40개 지역 | 키·관계 중심 조회가 대부분인 제품 데이터 | 복잡한 조회는 CDC로 Rockset에 넘겨 처리 |
| Meta TAO(USENIX ATC 2013) | 객체·연관, 고정된 쿼리 세트 | 수천 대 규모, 수 PB, 초당 읽기 10억 건·쓰기 수백만 건 | 읽기가 압도적인 소셜 그래프 | 읽기에 치우친 패턴을 전제로 한 설계 |
| Cosmos DB 직접 사용 | 팀마다 다름 | 해당 없음 | 제품팀 수가 적은 초기 | 인가·암호화·연결 관리를 팀마다 따로 구현 |
Habitat은 Meta TAO에서 영감을 받았다고 밝혔고, 그래서 객체와 그 엣지를 같은 스토리지 파티션에 함께 두도록 그래프를 나눕니다. 조인도 스캔도 없으니 요청 하나가 쓰는 자원이 크게 흔들리지 않습니다. 스키마 조회, 라우팅, 인가, 암호화, 직렬화, 요청 형상화, 커넥션 풀링은 Habitat이 맡습니다. 제품 엔지니어는 이 일에 신경 쓸 필요가 없습니다. 다만 TAO의 초당 10억 건과 Habitat의 초당 7천만 건은 발표 시점과 집계 정의가 달라 직접 비교가 성립하지 않습니다.
다음은 같은 Habitat 안에서 구현 언어만 바꾼 전후 비교입니다. 수치는 모두 2026년 9월 11일 OpenAI 자사 발표입니다.
| 항목 | Python 서비스 | Rust 서비스 | 판정 |
|---|---|---|---|
| 처리량 | 최대 초당 2천만 건 이상 | 전체 초당 7천만 건 이상(대부분 Rust 처리) | 비교 불가 |
| CPU 효율 | 기준 | 6배 | 조건 비공개 |
| 메모리 효율 | 기준 | 15배 | 조건 비공개 |
| 지연 | asyncio 스케줄링 지연 수백 ms, 극단적 경우 수 초 | 크게 낮아졌다고만 설명, 수치 없음 | 확인 못 함 |
| 전환 비율 | — | 운영 요청의 95% | 진행 중(Python은 몇 주 안에 폐기 예정) |
| 재작성 투입 | — | 2026년 2분기, 엔지니어 2명 + Codex·GPT-5.5 | 기간·테스트·전환 검증 방법 비공개 |
Habitat의 출발점은 DevDay 2023에서 GPTs를 지원하려고 만든 Python 라이브러리였습니다. 2025년 중반, 클라이언트 라이브러리 방식이 한계에 부딪히면서 독립 서비스로 떨어져 나왔고 Rust 재작성은 그다음 단계입니다. 6배·15배를 제3자가 다시 측정한 자료는 2026년 9월 16일 현재 없습니다. Habitat은 외부에 공개된 시스템이 아니라서 재현할 방법도 없습니다.
용어 풀이
1. 객체·엣지 모델 — 데이터를 노드(사용자, 대화 등)와 그 사이의 관계선으로 저장하는 방식으로, 조회 패턴을 미리 고정하기 쉽습니다.
2. CDC(변경 데이터 캡처) — 원본 저장소에서 바뀐 내용만 뽑아 다른 시스템에 거의 실시간으로 보내는 기법입니다.
3. 파티션 — 분산 데이터베이스가 데이터를 나눠 담는 단위로, 함께 조회되는 데이터가 같은 파티션에 있을수록 빠릅니다.
상황별 추천
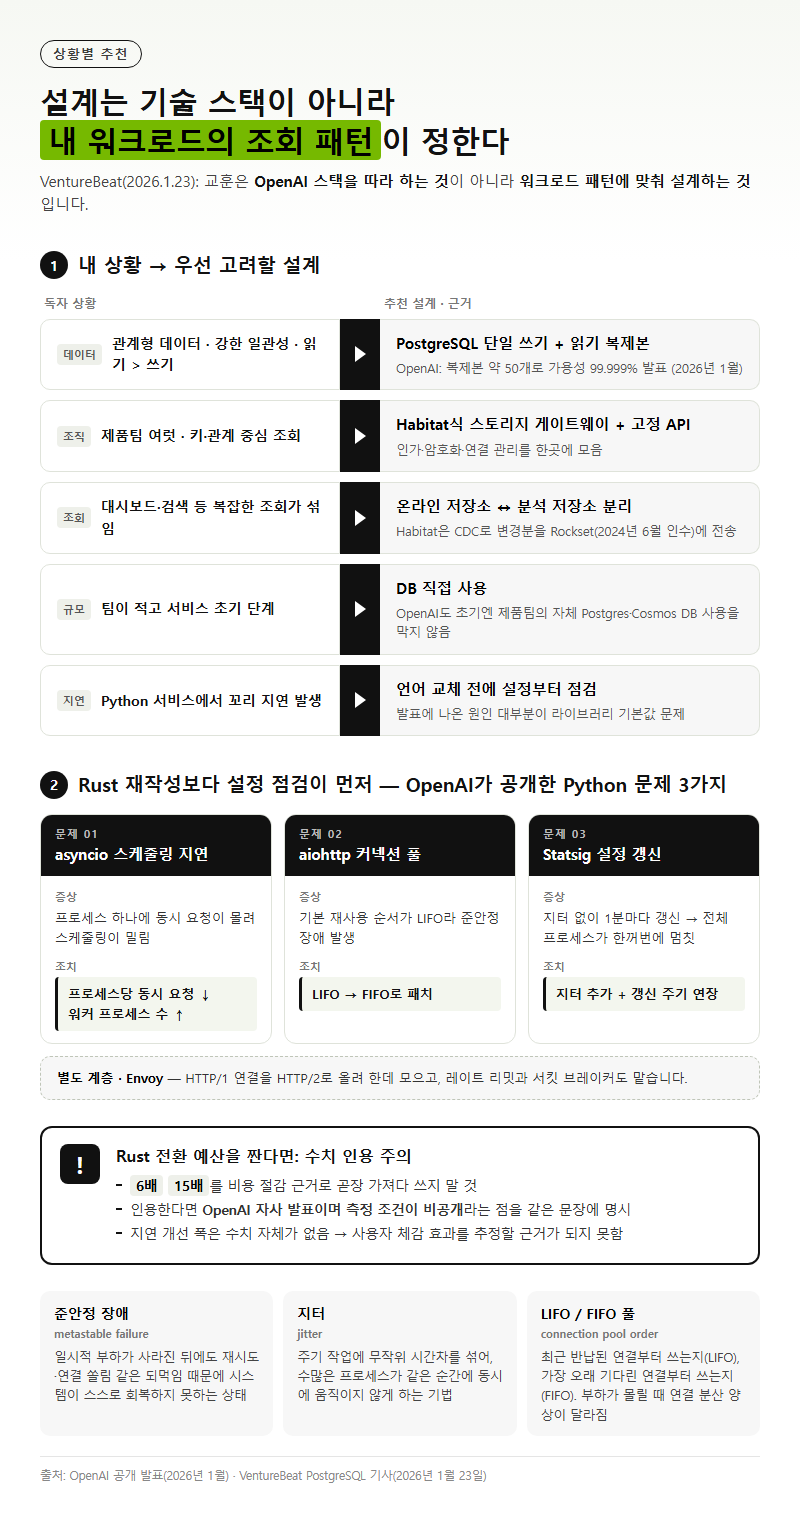
어떤 설계가 맞는지는 기술 스택이 아니라 내 워크로드의 조회 패턴이 정합니다. VentureBeat도 2026년 1월 23일 PostgreSQL 기사에서, OpenAI 스택을 따라 하는 것이 아니라 워크로드 패턴에 맞춰 설계를 정하는 것이 교훈이라고 평가했습니다. 이 관점으로 상황을 나눠보면 다음과 같습니다.
| 독자 상황 | 우선 고려할 설계 | 근거 |
|---|---|---|
| 관계형 데이터, 강한 일관성 필요, 쓰기보다 읽기가 많음 | PostgreSQL 단일 쓰기 + 읽기 복제본 | OpenAI도 복제본 약 50개로 99.999% 가용성을 발표(2026년 1월) |
| 제품팀이 여럿이고 조회가 키·관계 중심 | Habitat식 스토리지 게이트웨이 + 고정 API | 인가·암호화·연결 관리를 한곳에 모음 |
| 대시보드·검색 같은 복잡한 조회가 섞임 | 온라인 저장소와 분석 저장소 분리 | Habitat은 CDC로 변경분을 Rockset(2024년 6월 인수)에 보냄 |
| 팀이 적고 서비스 초기 단계 | DB 직접 사용 | OpenAI도 초기에 제품팀의 자체 Postgres·Cosmos DB 사용을 막지 않음 |
| Python 서비스에서 꼬리 지연 발생 | 언어 교체 전에 설정 점검 | 발표에 나온 원인 대부분이 라이브러리 기본값 문제 |
규모가 크지 않은 서비스라면 Rust 재작성보다 설정 점검이 먼저입니다. OpenAI가 공개한 Python 운영 문제는 세 가지였습니다. 첫째는 asyncio 스케줄링 지연으로, 프로세스당 동시 요청을 줄이고 워커 프로세스 수를 늘려 대응했습니다. 둘째로 aiohttp 커넥션 풀의 기본 재사용 순서가 LIFO라 준안정 장애가 생겼는데, FIFO로 패치해 해결했습니다. 셋째, Statsig 설정이 지터 없이 1분마다 갱신되면서 전체 프로세스가 한꺼번에 멈칫했고, 지터를 넣고 갱신 주기를 늘려 풀었습니다. 이와 별도로 Envoy가 HTTP/1 연결을 HTTP/2로 올려 한데 모으고, 레이트 리밋과 서킷 브레이커도 맡습니다.
Rust 전환 예산을 짜는 중이라면 6배·15배를 비용 절감 근거로 곧장 가져다 쓰면 안 됩니다. 인용하더라도 OpenAI 자사 발표이며 측정 조건이 비공개라는 점을 같은 문장에 밝혀야 합니다. 지연 개선 폭은 아예 수치가 없어서 사용자 체감 효과를 추정할 근거로 삼을 수 없습니다.
용어 풀이
1. 준안정 장애(metastable failure) — 일시적 부하가 사라진 뒤에도 재시도·연결 쏠림 같은 되먹임 때문에 시스템이 스스로 회복하지 못하는 상태입니다.
2. 지터(jitter) — 주기 작업에 무작위 시간차를 섞어 수많은 프로세스가 같은 순간에 동시에 움직이지 않게 하는 기법입니다.
3. LIFO/FIFO 커넥션 풀 — 가장 최근 반납된 연결부터 쓰는지(LIFO), 가장 오래 기다린 연결부터 쓰는지(FIFO)의 차이로, 부하가 몰릴 때 연결 분산 양상이 달라집니다.
자주 하는 실수
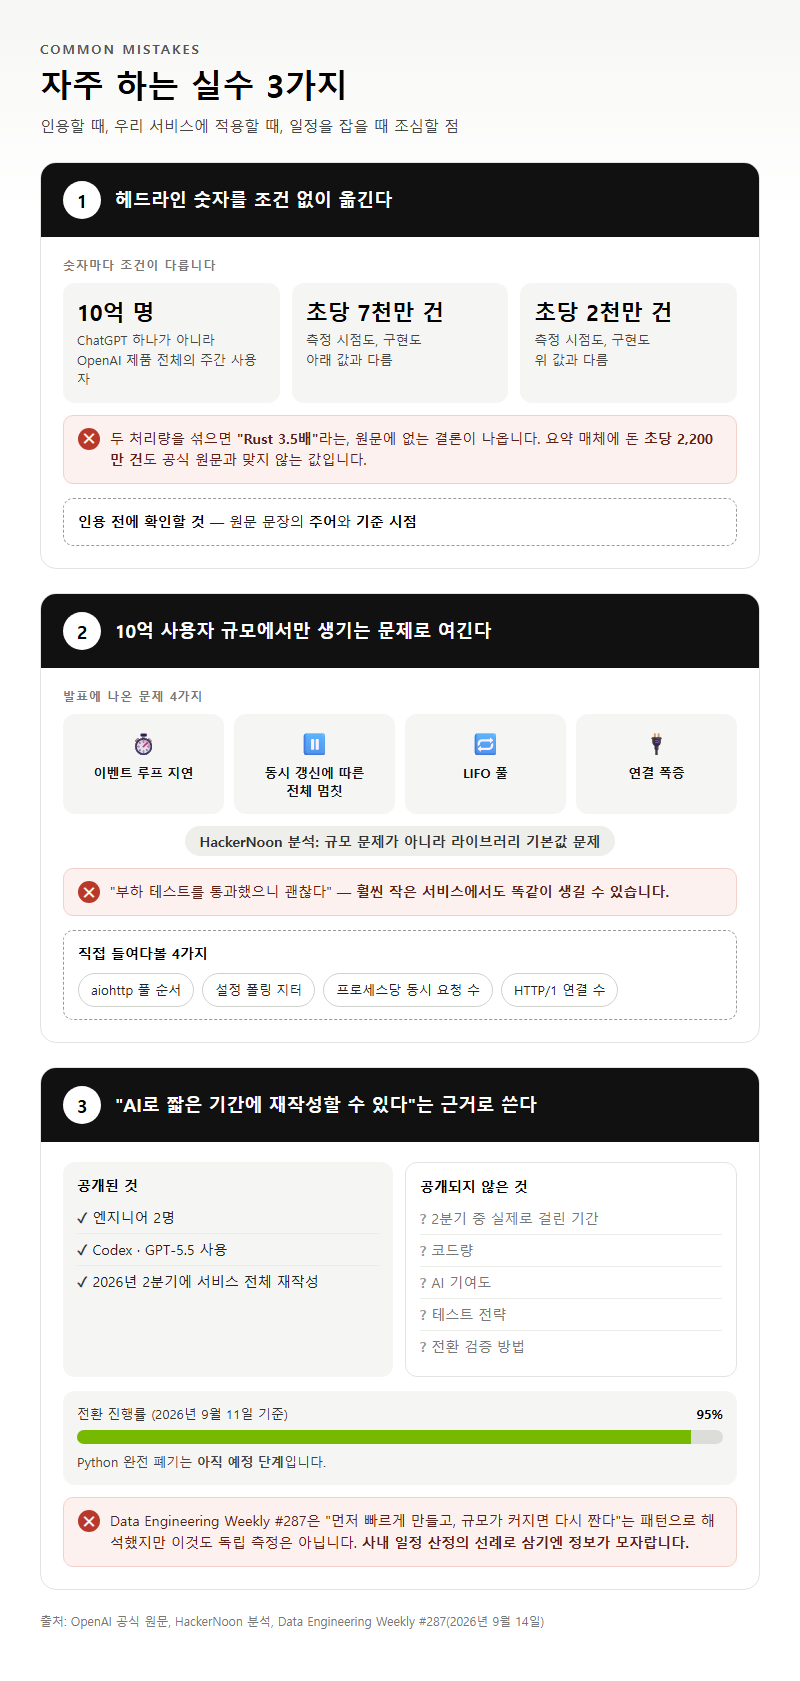
첫째, 헤드라인 숫자를 조건 없이 옮기는 실수입니다. 10억 명은 ChatGPT 하나가 아니라 OpenAI 제품 전체의 주간 사용자입니다. 초당 7천만 건과 2천만 건은 측정 시점도 구현도 다릅니다. 이 둘을 섞으면 Rust 3.5배라는, 원문에 없는 결론이 나옵니다. 요약 매체에 돈 초당 2,200만 건이라는 수치도 공식 원문과 맞지 않는 값입니다. 인용하기 전에 원문 문장의 주어와 기준 시점부터 확인하세요.
둘째, 발표에 나온 문제를 10억 사용자 규모에서만 생기는 일로 여기는 실수입니다. HackerNoon 분석은 이벤트 루프 지연, 동시 갱신에 따른 전체 멈칫, LIFO 풀, 연결 폭증 네 가지를 규모 문제가 아니라 라이브러리 기본값 문제로 봤고, 그래서 훨씬 작은 서비스에서도 똑같이 생길 수 있다고 했습니다. 부하 테스트를 통과했다고 안심하기보다 aiohttp 풀 순서, 설정 폴링 지터, 프로세스당 동시 요청 수, HTTP/1 연결 수를 직접 들여다보는 편이 현실적입니다.
셋째, AI로 짧은 기간에 재작성할 수 있다는 근거로 이 사례를 쓰는 실수입니다. 엔지니어 2명이 Codex와 GPT-5.5로 2026년 2분기에 서비스 전체를 다시 짰다는 대목은 인상적입니다. 하지만 2분기 중 실제로 걸린 기간, 코드량, AI 기여도, 테스트 전략, 전환 검증 방법은 하나도 공개되지 않았습니다. Data Engineering Weekly #287(2026년 9월 14일)은 이를 먼저 빠르게 만들고 규모가 커지면 다시 짜는 패턴으로 해석했는데, 이 역시 독립 측정은 아닙니다. 게다가 2026년 9월 11일 기준 전환율은 95%이고 Python 완전 폐기는 아직 예정 단계입니다. 사내 일정 산정의 선례로 삼기에는 정보가 모자랍니다.
정리
OpenAI Habitat은 임의 SQL·스캔·조인을 막은 객체·엣지 API를 Cosmos DB 위에 올리고, 복잡한 조회는 CDC로 떼어낸 구조입니다. 이렇게 해서 요청 비용이 일정한 온라인 계층을 만들었습니다. 관계형 일관성이 필요한 데이터는 여전히 PostgreSQL이 맡으므로 둘은 대체 관계가 아니라 역할 분담입니다. Rust 전환의 6배·15배와 지연 개선은 측정 조건이 공개되지 않았고, 스토리지 계층 설명은 2편을 기다려야 합니다. 한 줄로 정리하면, 조회 패턴이 고정돼 있고 팀이 여럿이면 Habitat식 게이트웨이를, 그렇지 않으면 PostgreSQL과 설정 점검부터 고르면 됩니다.
참고 자료
조사 기준일: 2026년 09월 16일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (모두 2026-09-16 확인)
– OpenAI, Rapidly scaling online storage to serve over 1 billion ChatGPT users (2026-09-11): https://openai.com/index/scaling-storage-one-billion-users-part-one/ (r.jina.ai 리더로 원문 수신)
– OpenAI RSS (게시일 확인): https://openai.com/news/rss.xml
– OpenAI, Scaling PostgreSQL to power 800 million ChatGPT users (2026-01-22): https://openai.com/index/scaling-postgresql/
– OpenAI 채용공고 Software Engineer, Habitat (Online Data), Seattle: https://openai.com/careers/software-engineer-habitat-(online-data-seattle/
– OpenAI, OpenAI Acquires Rockset: https://openai.com/index/openai-acquires-rockset/
– USENIX ATC ’13, TAO: Facebook’s Distributed Data Store for the Social Graph: https://www.usenix.org/conference/atc13/technical-sessions/presentation/bronson
– (원문 미대조, 403) OpenAIDevs X 게시물: https://x.com/OpenAIDevs/status/2098502006935814272
Tier 2 (모두 2026-09-16 확인)
– HackerNoon, Your Load Test Won’t Find These Four Gaps (2026-09-15): https://hackernoon.com/your-load-test-wont-find-these-four-gaps-learnings-from-openais-habitat
– Data Engineering Weekly #287 (2026-09-14): https://www.dataengineeringweekly.com/p/data-engineering-weekly-287
– .NET Ramblings (2026-09-11, 22M 표기 오류 확인용): https://www.dotnetramblings.com/post/11_09_2026/11_09_2026_4/
– VentureBeat (2026-01-23): https://venturebeat.com/data/how-openai-is-scaling-the-postgresql-database-to-800-million-users
– InfoQ (2026-02-12): https://www.infoq.com/news/2026/02/openai-runs-chatgpt-postgres/
답글 남기기