
Gemini 3.8 Live와 Extended Thinking의 실시간 대화 구조 차이를 도구 호출, 턴 종료 신호, 가격, 지연 시간, 독립 벤치마크로 비교합니다. 3.1 Flash Live에서 옮길 때 오류가 나는 설정도 함께 정리했습니다.
Gemini 3.8 Live 핵심만 먼저 정리하면
실시간 음성 에이전트라면 기본은 Gemini 3.8 Live 기본형입니다. 여러 단계를 거치는 도구 작업이 서비스의 중심일 때만 Gemini 3.8 Live Extended Thinking을 고르면 됩니다. 독립 평가 기관 Artificial Analysis(AA)가 측정한 에이전트 과제 점수는 Extended Thinking(High)이 68.6%로, 기본형 30.1%보다 38.5%p 높았습니다. 대신 대화 흐름, Arena Elo, 과제 성공률은 세 항목 모두 기본형이 앞섰습니다.
두 모델은 2026년 9월 15일에 함께 발표됐고 표시 가격도 같습니다. 그런데 도구 실행을 기다리는 방식과 작업 완료를 알리는 신호가 달라서 클라이언트 코드는 모델별로 따로 설계해야 합니다. 이 글에서는 공식 문서에 적힌 구조 차이, AA 측정 성능, 비용과 지연, 3.1 Flash Live에서 넘어올 때 바뀌는 점, 경쟁 모델과의 구조 비교를 차례로 다룹니다. 제공 국가나 Workspace 요금제 조건처럼 공식 확인이 끝나지 않은 항목은 따로 표시했습니다.
Q1. Gemini 3.8 Live와 Extended Thinking은 실시간 대화 처리 방식이 어떻게 다른가요?
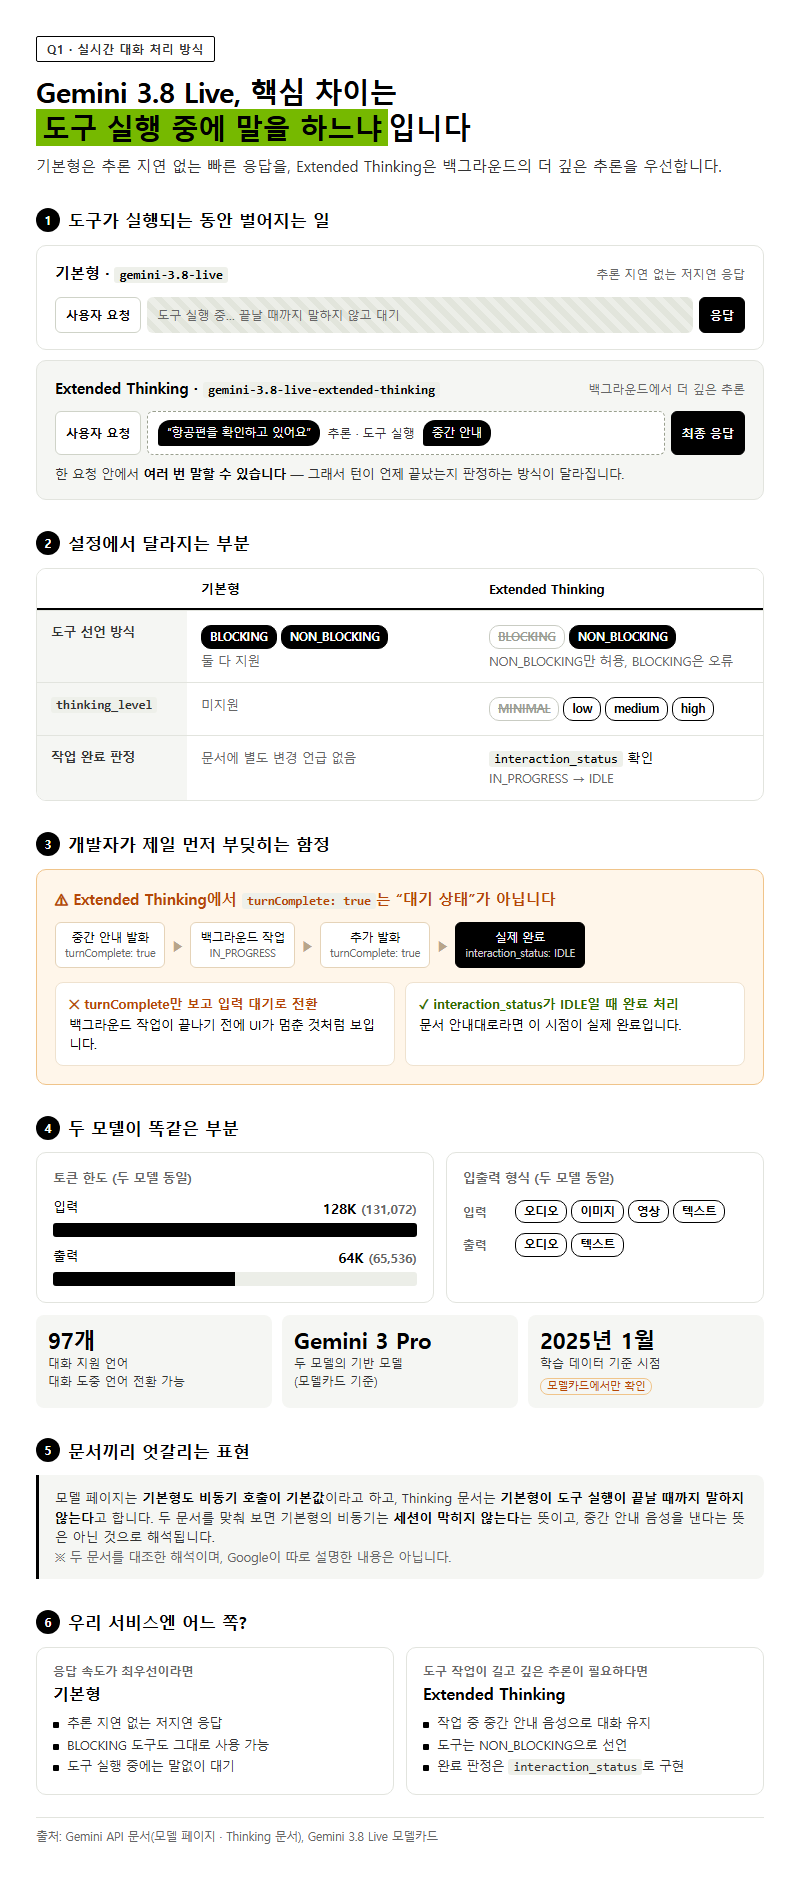
가장 큰 차이는 도구를 실행하는 동안 모델이 말을 하느냐입니다. Gemini API 문서에 따르면 기본형은 추론 지연 없는 빠른 응답에 맞춰 설계됐습니다. Extended Thinking은 추론과 도구 실행을 백그라운드에서 돌리고, 그사이 “항공편을 확인하고 있다”는 식의 중간 안내 음성을 내보냅니다.
| 구분 | Gemini 3.8 Live (기본형) | Gemini 3.8 Live Extended Thinking |
|---|---|---|
| API 모델 ID | gemini-3.8-live |
gemini-3.8-live-extended-thinking |
| 설계 우선순위 | 추론 지연 없는 저지연 응답 | 백그라운드에서 더 깊은 추론 |
| 도구 선언 방식 | BLOCKING, NON_BLOCKING 모두 지원 | NON_BLOCKING만 허용, BLOCKING은 오류 |
| 도구 실행 중 발화 | 실행이 끝날 때까지 말하지 않고 대기 | 중간 안내 음성을 내며 작업 진행 |
| 한 요청 안에서 발화 | 문서에 별도 변경 언급 없음 | 여러 번 말할 수 있음 |
turnComplete: true의 의미 |
문서에 별도 변경 언급 없음 | 대기 상태를 뜻하지 않음 |
| 작업 완료 판정 | 문서에 별도 변경 언급 없음 | interaction_status(IN_PROGRESS/IDLE) 확인 |
thinking_level |
미지원 | low, medium, high (MINIMAL 미지원) |
| 입력 / 출력 한도 | 128K(131,072) / 64K(65,536) 토큰 | 기본형과 동일 |
| 입력 / 출력 형식 | 오디오·이미지·영상·텍스트 / 오디오·텍스트 | 기본형과 동일 |
개발자가 제일 먼저 부딪히는 건 턴 종료 판정입니다. Extended Thinking은 한 요청 안에서 여러 번 말합니다. 그래서 turnComplete: true를 받자마자 사용자 입력 대기로 넘어가면 백그라운드 작업이 끝나기 전에 UI가 멈춘 것처럼 보입니다. 문서 안내대로라면 interaction_status가 IDLE로 바뀐 시점이 실제 완료입니다.
공식 문서끼리 표현이 엇갈리는 곳도 있습니다. 모델 페이지에는 기본형도 비동기 호출이 기본값이라고 돼 있는데, Thinking 문서에는 기본형이 도구 실행이 끝날 때까지 말하지 않는다고 돼 있습니다. 두 문서를 대조하면 기본형의 비동기는 세션이 막히지 않는다는 뜻으로 해석됩니다. 중간 안내 음성까지 낸다는 뜻은 아닙니다. 어디까지나 두 문서를 맞춰 본 해석이며, Google이 따로 설명한 내용은 아닙니다.
모델카드에는 두 모델이 Gemini 3 Pro 기반이고 학습 데이터 기준 시점이 2025년 1월이라고 적혀 있습니다. 이 기준 시점은 모델카드에서만 확인했을 뿐, 다른 문서로 교차 확인하지는 못했습니다. 대화 지원 언어는 97개이고 대화 도중에 언어를 바꿀 수 있다고 안내돼 있습니다.
Q2. 음성 AI 벤치마크 1위라는데, 두 모델 중 실제로 대화를 더 잘하는 쪽은 어디인가요?
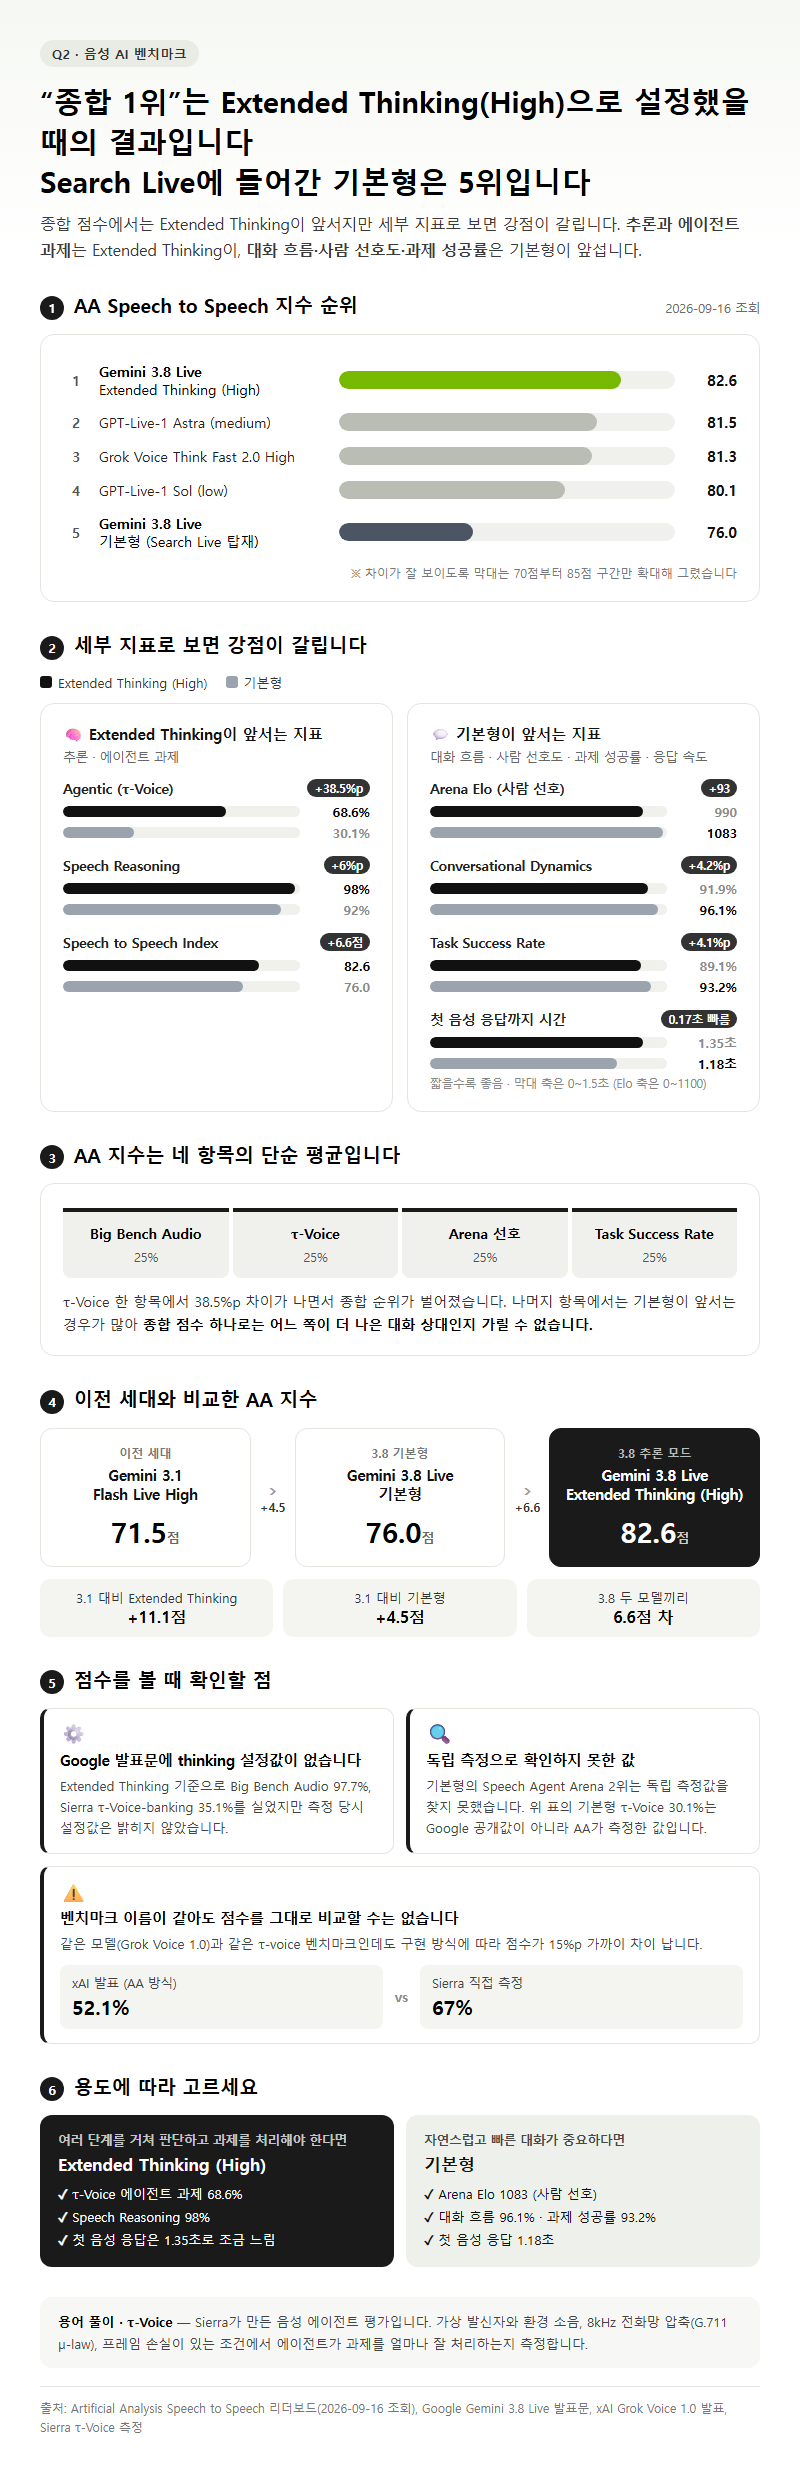
1위는 Extended Thinking을 High로 설정했을 때에 한정된 결과입니다. Search Live에 들어간 기본형은 같은 지수에서 5위입니다. 2026년 9월 16일에 조회한 AA Speech to Speech 리더보드 순위는 Extended Thinking(High) 82.6, GPT-Live-1 Astra(medium) 81.5, Grok Voice Think Fast 2.0 High 81.3, GPT-Live-1 Sol(low) 80.1, Gemini 3.8 Live 기본형 76.0 순입니다.
| AA 세부 지표 (2026-09-16 조회) | Extended Thinking (High) | 기본형 |
|---|---|---|
| Speech to Speech Index | 82.6 | 76.0 |
| Speech Reasoning | 98% | 92% |
| Conversational Dynamics | 91.9% | 96.1% |
| Agentic (τ-Voice) | 68.6% | 30.1% |
| Arena Elo | 990 | 1083 |
| Task Success Rate | 89.1% | 93.2% |
| 첫 음성 응답까지 시간 | 1.35초 | 1.18초 |
강점은 뚜렷하게 갈립니다. Extended Thinking은 추론과 에이전트 과제에서, 기본형은 대화 흐름과 사람 선호도, 과제 성공률에서 앞섭니다. AA 지수는 Big Bench Audio, τ-Voice, Arena 선호, Task Success Rate 네 항목을 같은 비중으로 평균한 값입니다. 종합 점수 하나로는 어느 쪽이 더 나은 대화 상대인지 가릴 수 없습니다.
이전 세대인 Gemini 3.1 Flash Live High는 AA 지수 71.5로, Extended Thinking보다 11.1점, 기본형보다 4.5점 낮습니다. 3.8의 두 모델끼리는 6.6점 차이입니다.
Google 발표문에는 Extended Thinking 기준 Big Bench Audio 97.7%, Sierra τ-Voice-banking 35.1%가 실려 있고, 기본형은 Speech Agent Arena 2위로 소개됐습니다. 다만 발표문에 측정 당시 thinking 설정값이 빠져 있고, Speech Agent Arena 순위는 독립 측정 값을 찾지 못했습니다. 위 표의 기본형 τ-Voice 30.1%도 Google이 공개한 값이 아니라 AA 측정값입니다.
벤치마크 이름이 같다고 점수를 곧바로 나란히 놓을 수도 없습니다. xAI는 Grok Voice 1.0의 τ-voice 점수를 AA 방식으로 52.1%라고 발표했지만, Sierra가 직접 측정한 값은 67%였습니다. 이름은 같아도 구현 방식이 달라 비교가 성립하지 않는 사례입니다.
용어 풀이
1. τ-Voice — Sierra가 만든 음성 에이전트 평가로, 시뮬레이션 발신자, 환경 소음, 8kHz 전화망 압축(G.711 µ-law), 프레임 손실 조건에서 278개 업무 과제를 채점합니다.
2. pass@1 — 과제마다 한 번만 시도해서 성공한 비율로 채점하는 방식이며, τ-voice에서 텍스트 모델의 상한은 약 85%입니다.
3. Arena Elo — 사용자가 두 응답 중 더 나은 쪽을 고른 선호 비교 결과를 레이팅 점수로 환산한 값입니다.
Q3. 두 모델 가격이 같은데, 실제 운영 비용과 응답 지연은 얼마나 차이 나나요?
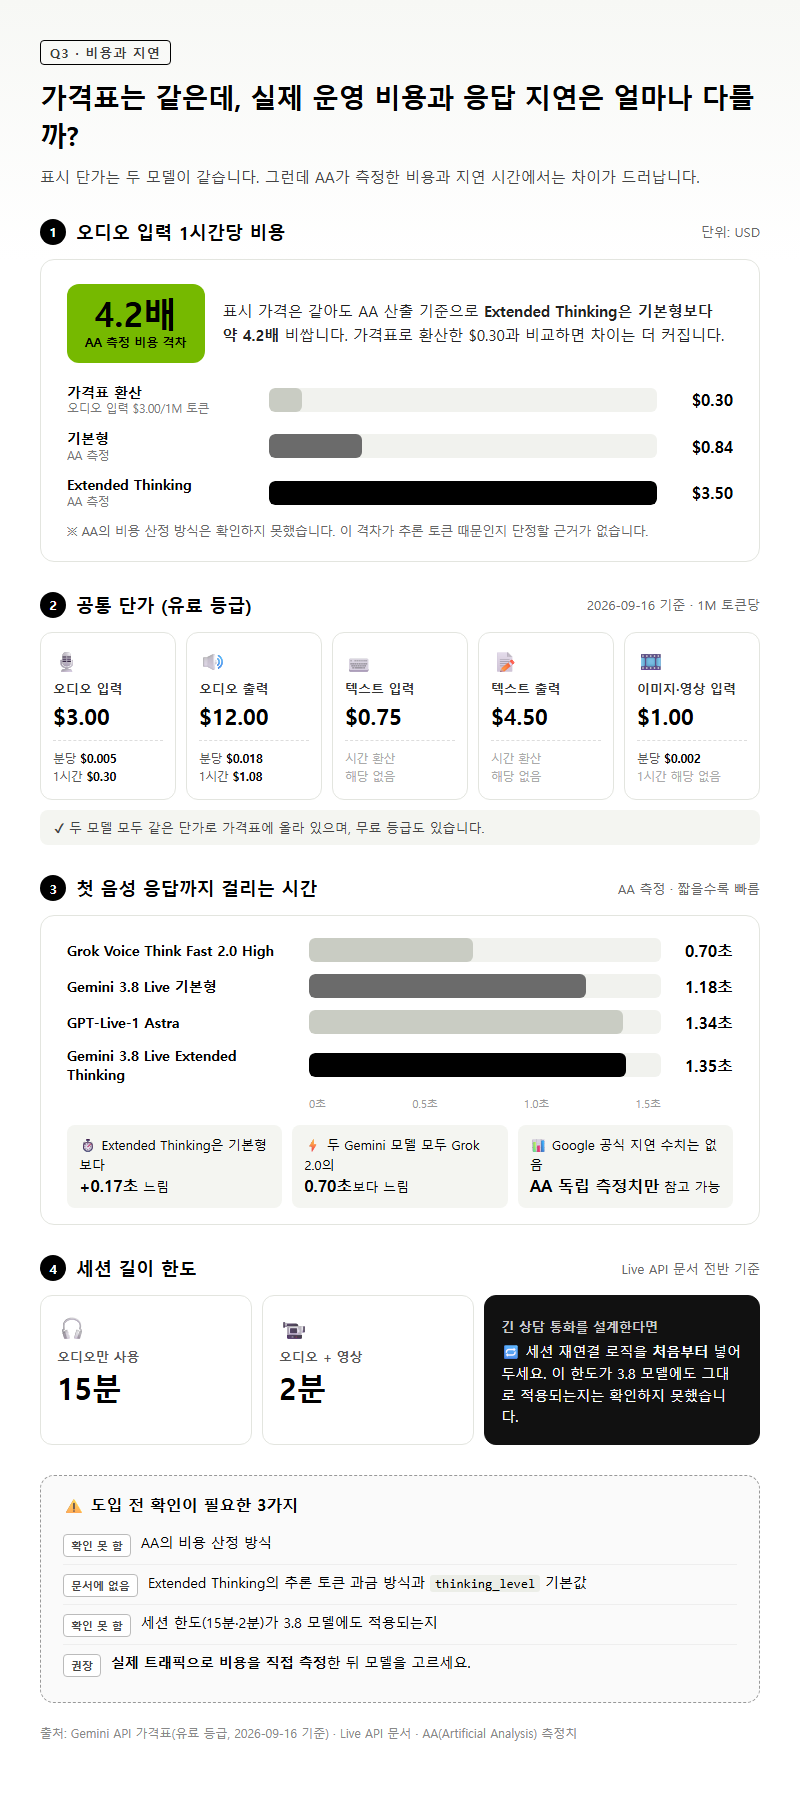
표시 가격은 같아도 AA가 측정한 입력 1시간당 비용은 약 4.2배 차이가 납니다. 2026년 9월 16일 기준 Gemini API 유료 등급 가격표에 두 모델은 같은 단가로 올라 있고, 무료 등급도 있습니다.
| 항목 (유료 등급, 2026-09-16 기준) | 1M 토큰당 | 분당 환산 | 1시간 환산 |
|---|---|---|---|
| 오디오 입력 | $3.00 | $0.005 | $0.30 |
| 오디오 출력 | $12.00 | $0.018 | $1.08 |
| 텍스트 입력 | $0.75 | 해당 없음 | 해당 없음 |
| 텍스트 출력 | $4.50 | 해당 없음 | 해당 없음 |
| 이미지·영상 입력 | $1.00 | $0.002 | 해당 없음 |
AA가 산출한 입력 오디오 1시간당 비용은 기본형 $0.84, Extended Thinking $3.50입니다. 표시 가격으로 환산한 오디오 입력 1시간 $0.30과 비교해도 격차가 큽니다. 문제는 AA의 비용 산정 방식을 확인하지 못했다는 점입니다. Extended Thinking의 추론 토큰 과금 방식과 thinking_level 기본값도 공식 문서에 나와 있지 않아 둘 다 확인이 필요합니다. 이 격차가 추론 토큰에서 오는지 단정할 근거가 없으니, 도입 전에 실제 트래픽으로 비용을 측정해 보는 것이 좋습니다.
| 첫 음성 응답까지 시간 (AA 측정) | 값 |
|---|---|
| Gemini 3.8 Live 기본형 | 1.18초 |
| GPT-Live-1 Astra | 1.34초 |
| Gemini 3.8 Live Extended Thinking | 1.35초 |
| Grok Voice Think Fast 2.0 High | 0.70초 |
지연 시간은 Extended Thinking이 기본형보다 0.17초 깁니다. Google이 공식 지연 수치를 내놓지 않아, 지금 참고할 수 있는 값은 AA의 독립 측정치뿐입니다. 응답 속도만 따지면 두 Gemini 모델 모두 Grok 2.0의 0.70초보다 느립니다.
세션 길이 한도도 봐야 합니다. Live API 문서 전반에는 오디오만 쓰면 15분, 오디오와 영상을 함께 쓰면 2분으로 적혀 있습니다. 그런데 이 값이 3.8 모델에도 그대로 적용되는지는 확인하지 못했습니다. 긴 상담 통화를 설계한다면 세션 재연결 로직을 처음부터 넣어두는 편이 낫습니다.
Q4. Gemini 3.1 Flash Live에서 3.8 Live로 옮기면 코드에서 무엇이 깨지나요?
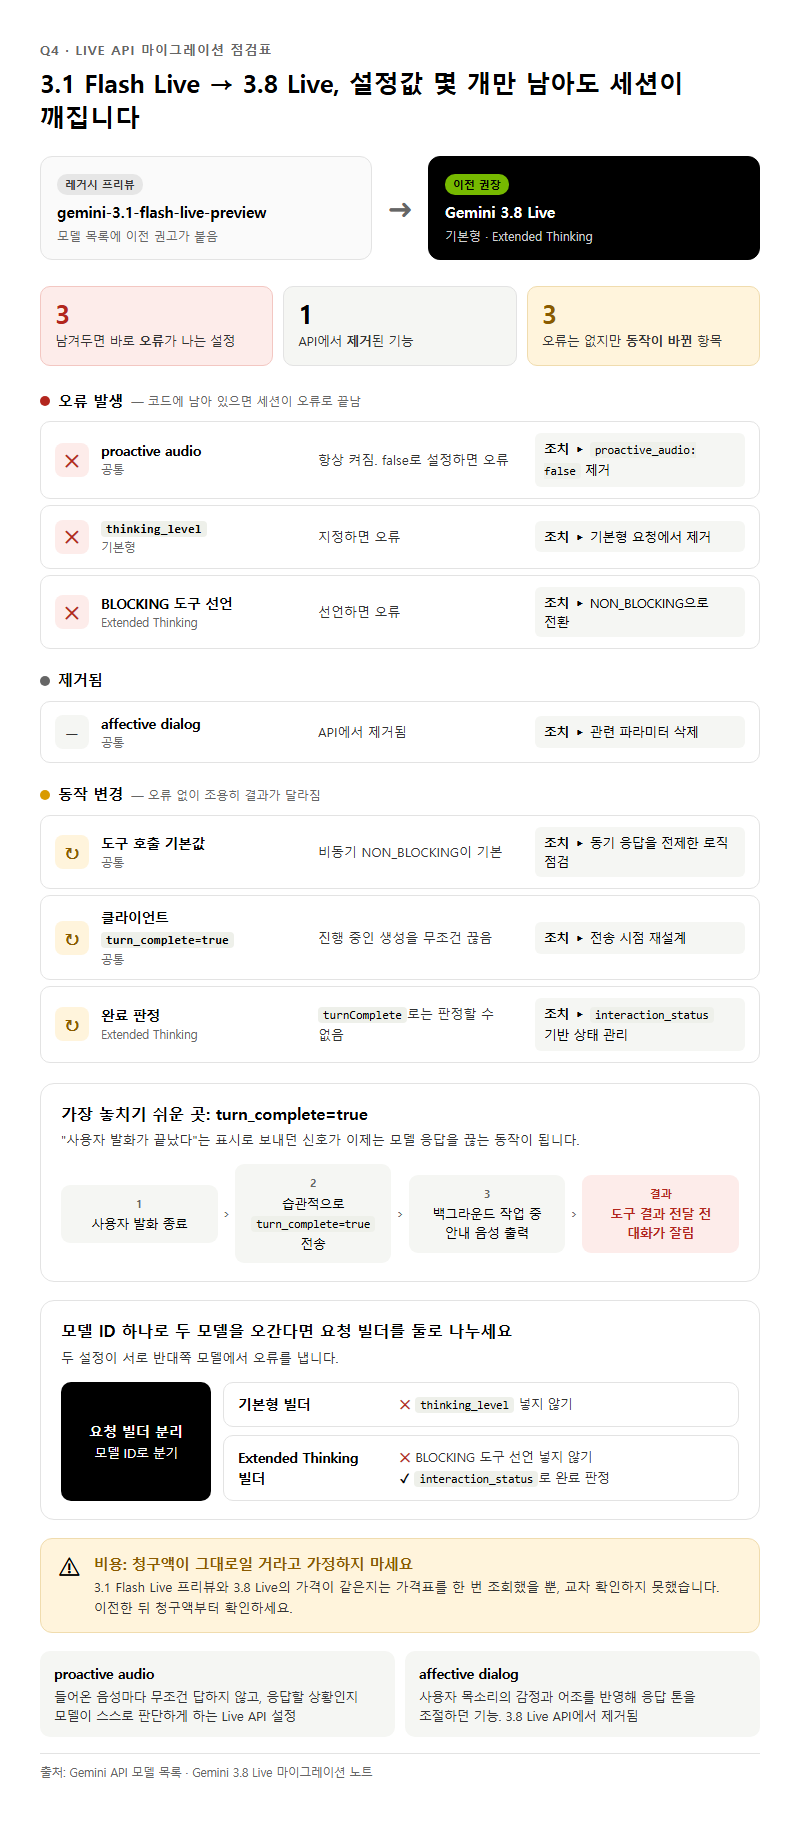
gemini-3.1-flash-live-preview는 레거시 프리뷰로 분류됐고, Gemini API 모델 목록에는 3.8 Live로 옮기라는 권고가 붙었습니다. 마이그레이션 노트를 보면 설정값 몇 개만 남아 있어도 세션이 오류로 끝나는 변경이 여럿입니다.
| 변경 항목 | 3.8 Live의 동작 | 필요한 조치 |
|---|---|---|
| 도구 호출 기본값 | 비동기 NON_BLOCKING이 기본 | 동기 응답을 전제한 로직 점검 |
| proactive audio | 항상 켜짐, false로 설정하면 오류 | proactive_audio: false 설정 제거 |
| affective dialog | API에서 제거됨 | 관련 파라미터 삭제 |
클라이언트가 보내는 turn_complete=true |
진행 중인 생성을 무조건 끊음 | 전송 시점 재설계 |
thinking_level (기본형) |
지정하면 오류 | 기본형 요청에서 제거 |
| BLOCKING 도구 선언 (Extended Thinking) | 선언하면 오류 | NON_BLOCKING으로 전환 |
| 완료 판정 (Extended Thinking) | turnComplete로 판정 불가 |
interaction_status 기반 상태 관리로 수정 |
실무에서 놓치기 쉬운 건 turn_complete=true 전송입니다. 사용자 발화가 끝났다는 표시로 무심코 보내던 코드가 이제는 모델이 말하고 있던 응답을 끊어버리는 동작이 됩니다. Extended Thinking은 백그라운드 작업 중에도 안내 음성을 내기 때문에, 이 신호를 잘못 보내면 도구 결과가 전달되기도 전에 대화가 잘릴 수 있습니다.
모델 ID 하나로 두 모델을 오가는 구조라면 요청 빌더를 둘로 나누는 것이 좋습니다. thinking_level과 BLOCKING 도구 선언이 서로 반대쪽 모델에서 오류를 내서입니다. 기본형은 thinking_level을 받지 않고, Extended Thinking은 BLOCKING 선언을 받지 않습니다.
비용 쪽에도 확인할 것이 남아 있습니다. 3.1 Flash Live 프리뷰와 3.8 Live의 가격이 같은지는 가격표를 한 번 조회했을 뿐 교차 확인하지 못했습니다. 이전 후 청구액이 그대로일 거라고 가정하지 않는 편이 좋습니다.
용어 풀이
1. proactive audio — 들어온 음성마다 무조건 답하지 않고, 모델이 응답할 상황인지 스스로 판단하도록 하는 Live API 설정입니다.
2. affective dialog — 사용자 목소리의 감정과 어조를 반영해 응답 톤을 조절하던 기능으로, 3.8 Live API에서는 제거됐습니다.
Q5. GPT-Live-1이나 Grok Voice와 비교하면 어떤 실시간 대화 구조를 골라야 하나요?
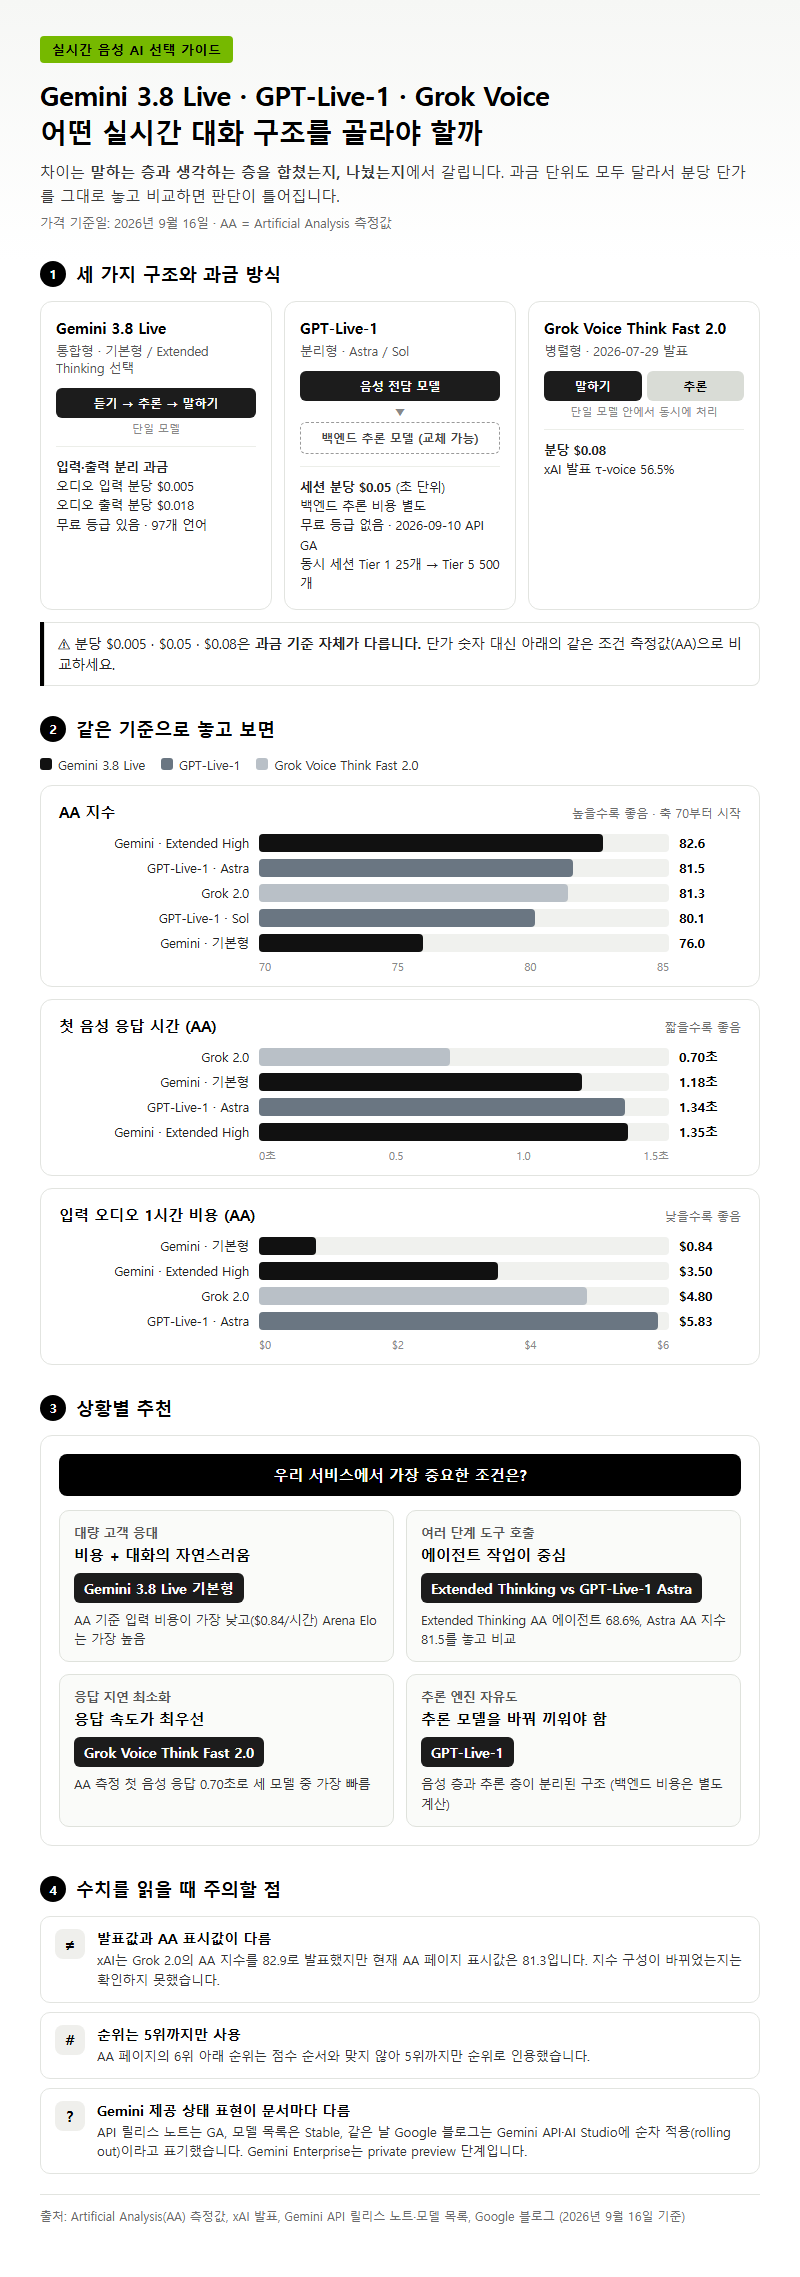
실시간 음성 모델은 말하는 층과 생각하는 층을 합쳤는지, 나눴는지에 따라 세 갈래로 나뉩니다. 과금 단위도 제각각이라 분당 단가를 그대로 놓고 비교하면 판단이 틀어집니다. 아래 가격은 2026년 9월 16일 기준입니다.
| 구분 | Gemini 3.8 Live | GPT-Live-1 | Grok Voice Think Fast 2.0 |
|---|---|---|---|
| 구조 | 단일 모델이 듣고 추론하고 말함, 기본형과 Extended Thinking 중 선택 | 음성 전담 모델 뒤에 별도 백엔드 추론 모델 | 말하는 동안 병렬로 추론하는 단일 모델 |
| 과금 단위 | 입력·출력 분리 (오디오 입력 분당 $0.005, 출력 분당 $0.018) | 세션 분당 $0.05, 초 단위, 백엔드 비용 별도 | 분당 $0.08 |
| AA 지수 | 82.6(Ext High) / 76.0(기본형) | 81.5(Astra) / 80.1(Sol) | 81.3 |
| 첫 음성 응답(AA) | 1.35초 / 1.18초 | 1.34초(Astra) | 0.70초 |
| 입력 오디오 1시간 비용(AA) | $3.50 / $0.84 | $5.83(Astra) | $4.80 |
| 기타 조건 | 무료 등급 있음, 97개 언어 | v1/live/sessions 엔드포인트, 동시 세션 Tier 1 25개부터 Tier 5 500개, 무료 등급 없음, 2026-09-10 API GA |
2026-07-29 발표, xAI 발표 τ-voice 56.5% |
상황별로 고르면 이렇습니다.
- 대량 고객 응대처럼 비용과 대화의 자연스러움이 중요하면 Gemini 3.8 Live 기본형이 맞습니다. AA 기준 입력 비용이 가장 낮고 Arena Elo는 가장 높습니다.
- 여러 단계의 도구 작업이 중심이면 Extended Thinking(AA 에이전트 68.6%)과 GPT-Live-1 Astra(AA 지수 81.5)를 놓고 비교할 만합니다.
- 응답 속도가 최우선이면 AA 측정 0.70초인 Grok 2.0이 유리합니다.
- 추론 모델을 원하는 대로 바꿔 끼워야 한다면 음성 층과 추론 층이 분리된 GPT-Live-1 구조가 적합합니다.
발표 수치와 AA 표시값이 어긋나는 곳도 있습니다. xAI는 Grok 2.0의 AA 지수를 82.9로 발표했지만 현재 AA 페이지에는 81.3으로 나옵니다. 지수 구성이 바뀌었는지는 확인하지 못했습니다. AA 페이지의 6위 아래 순위는 점수 순서와 맞지 않아서, 이 글에서는 5위까지만 순위로 썼습니다.
제공 상태도 문서마다 표현이 다릅니다. Gemini API 릴리스 노트는 두 모델을 GA로, 모델 목록은 Stable로 표시합니다. 그런데 같은 날 Google 블로그는 Gemini API와 AI Studio에 순차 적용(rolling out)된다고 썼습니다. Gemini Enterprise는 private preview이고, Gemini Enterprise for Customer Experience는 출시 예정입니다. 소비자 제품에서는 기본형이 Search Live에, Extended Thinking이 Gemini Live와 Workspace(Gmail·Docs·Keep)에 들어갑니다.
아직 확인되지 않은 항목은 아래와 같습니다.
- Workspace 요금제 조건(Docs는 Pro/Ultra, Gmail·Keep은 전체 구독자)은 블로그를 한 번 조회해서만 나온 내용이고, 제공 국가와 언어는 확인하지 못했습니다.
- Gemini Enterprise Agent Platform(구 Vertex AI)에서의 GA 여부와 제공 지역도 찾지 못했습니다.
- SynthID 워터마크 적용은 MarkTechPost 보도에서만 확인돼 공식 확인이 필요합니다.
- MarkTechPost에 따르면 두 모델 모두 호스팅 전용이라 가중치 공개나 자체 설치가 불가능합니다.
정리
Gemini 3.8 Live는 가격표는 하나지만 대화 구조는 두 가지입니다. 도구 실행이 끝날 때까지 기다렸다가 답하는 저지연 기본형, 그리고 생각하는 동안에도 안내 음성을 내는 Extended Thinking입니다. 발표된 1위 성적은 Extended Thinking High 설정에 한정된 결과이고, 대화 자연스러움과 과제 성공률, AA 측정 비용에서는 기본형이 앞섭니다. 3.1 Flash Live에서 옮긴다면 turn_complete 전송, proactive_audio: false, thinking_level, BLOCKING 도구 선언부터 점검하세요. 추론 토큰 과금 방식과 세션 한도는 아직 공식 확인 전입니다. 도입 범위는 실제 트래픽으로 비용과 지연을 측정한 뒤에 정하는 것이 맞습니다.
참고 자료
조사 기준일: 2026년 09월 16일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (2026-09-16 확인)
– https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-gemini-3-8-live-extended-thinking/
– https://blog.google/innovation-and-ai/technology/developers-tools/build-real-time-voice-applications-gemini-audio/
– https://deepmind.google/models/model-cards/gemini-3-8-audio/
– https://ai.google.dev/gemini-api/docs/models
– https://ai.google.dev/gemini-api/docs/models/gemini-3.8-live
– https://ai.google.dev/gemini-api/docs/models/gemini-3.8-live-extended-thinking
– https://ai.google.dev/gemini-api/docs/live-api/thinking
– https://ai.google.dev/gemini-api/docs/live-api/capabilities
– https://ai.google.dev/gemini-api/docs/pricing
– https://ai.google.dev/gemini-api/docs/changelog
– https://developers.openai.com/api/docs/models/gpt-live-1
– https://developers.openai.com/api/docs/changelog
– https://x.ai/news/grok-voice-think-fast-2
– (접근 실패, 403) https://openai.com/index/introducing-gpt-live-1-in-the-api/
Tier 2 (2026-09-16 확인)
– https://artificialanalysis.ai/speech-to-speech
– https://9to5google.com/2026/09/15/gemini-3-8-live-announced/
– https://www.marktechpost.com/2026/09/15/google-releases-gemini-3-8-live-and-3-8-live-extended-thinking-for-production-grade-voice-agents/
– https://www.thurrott.com/a-i/google-gemini-a-i/341685/google-announces-gemini-3-8-live-and-3-8-live-extended-thinking
– https://sierra.ai/blog/tau-voice-benchmarking-real-time-voice-agents-on-real-world-tasks
답글 남기기