
유클리드(EUCLYD)의 3100억 원 투자 소식을 정리했습니다. 전력비를 줄인다는 설계 구조, ‘100배 효율’ 주장이 모델링 값이라는 점, 2027년에서 2028년으로 잡힌 인도 일정, 아직 확인되지 않은 항목까지 2026년 9월 21일 기준으로 담았습니다.
유클리드3100억 개요
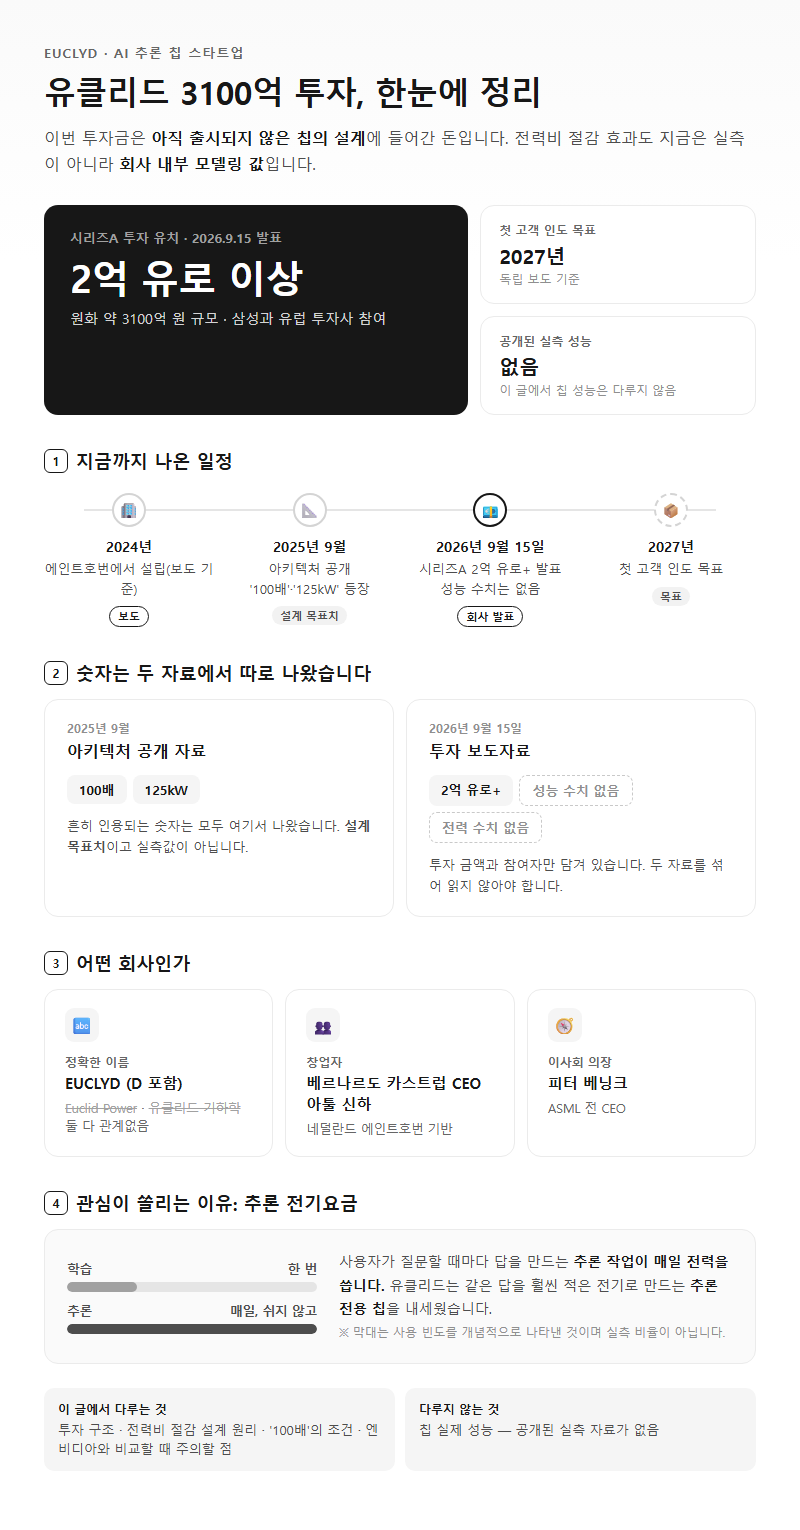
유클리드 3100억 투자는 아직 나오지 않은 칩의 설계에 들어간 돈입니다. 유클리드가 말하는 AI 전력비 절감 구조도 지금은 실측이 아니라 회사 내부 모델링 값입니다. 회사는 2026년 9월 15일 2억 유로 이상의 시리즈A 유치를 발표했지만, 첫 고객 인도 목표는 2027년입니다(독립 보도 기준). 이 글에서는 투자 구조, 전력비를 줄이는 설계 원리, ‘100배’ 주장의 정확한 조건, 엔비디아와 비교할 때 주의할 점을 차례로 봅니다. 칩의 실제 성능은 공개된 실측 자료가 없어 다루지 않습니다.
이름부터 정리하겠습니다. 여기서 말하는 유클리드는 네덜란드 에인트호번의 AI 반도체 스타트업 EUCLYD(D가 들어간 철자)입니다. 이름이 비슷한 에너지 기업 Euclid Power나 유클리드 기하학과는 관계가 없습니다. 창업자는 베르나르도 카스트럽 CEO와 아툴 신하이고, 설립 연도는 2024년으로 보도됐습니다.
이 소식에 관심이 쏠리는 건 AI 운영비에서 전기요금이 차지하는 몫이 크기 때문입니다. 모델을 한 번 학습시키는 일보다, 사용자가 질문할 때마다 답을 만드는 추론 작업이 매일 쉬지 않고 전력을 씁니다. 유클리드는 같은 답을 훨씬 적은 전기로 만드는 추론 전용 칩을 내세웠습니다. 삼성과 유럽 투자사들이 이 설계에 돈을 넣었고, ASML 전 CEO 피터 베닝크가 이사회 의장으로 합류했습니다.
알아둘 점이 하나 있습니다. 이번 투자 보도자료에는 성능·전력 수치가 하나도 없습니다. 흔히 인용되는 ‘100배’, ‘125kW’ 같은 숫자는 2025년 9월 아키텍처 공개 때 나온 설계 목표치입니다. 그래서 이 글은 두 자료를 나눠서 읽습니다.
1. ‘3100억’은 정확히 얼마인가
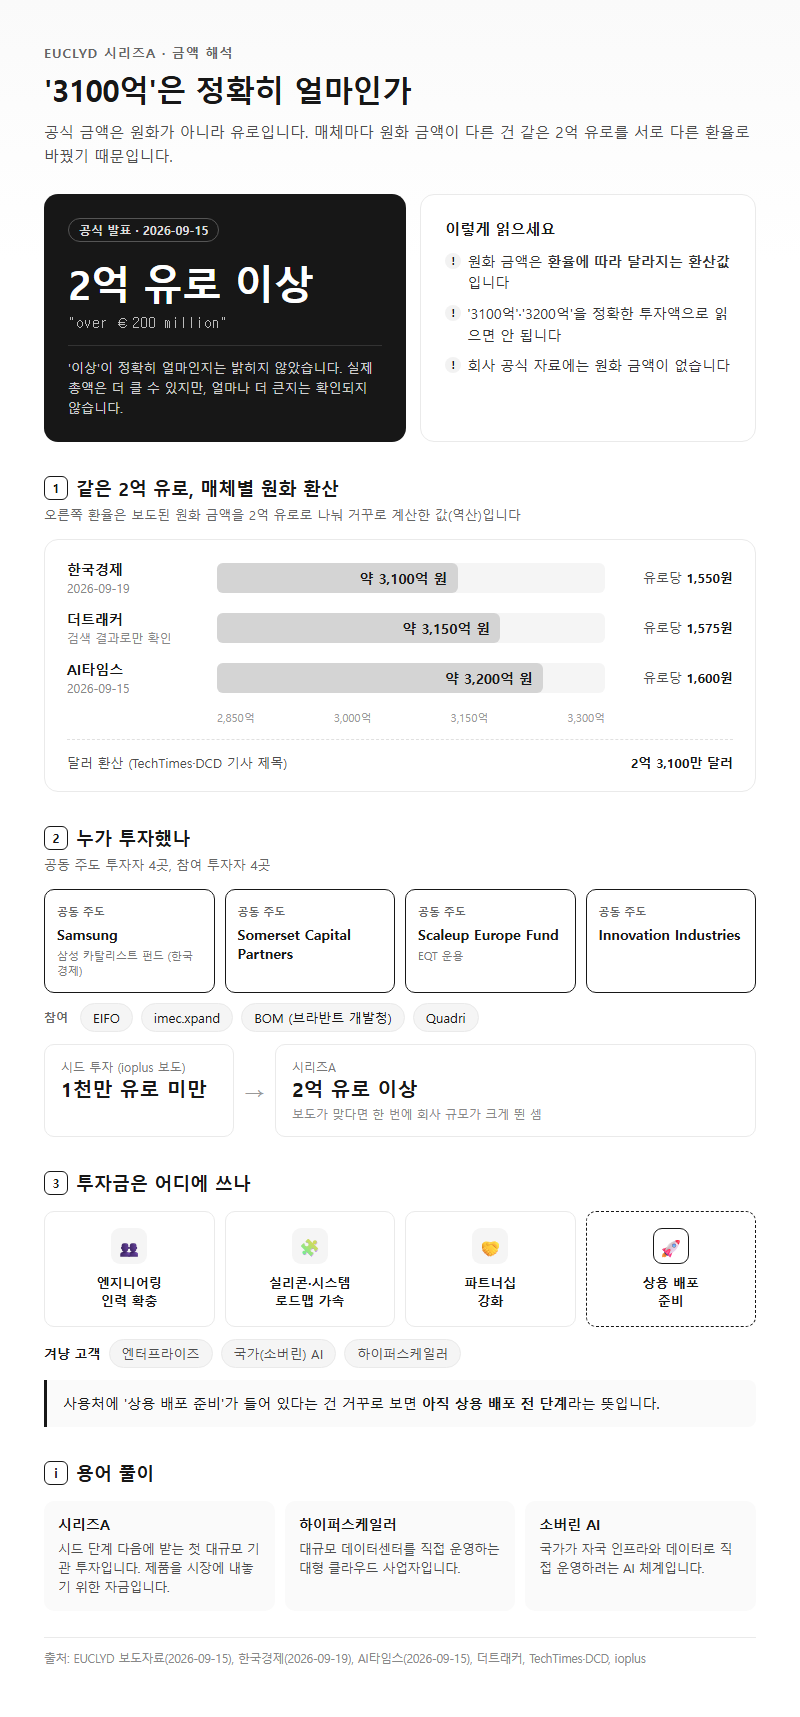
회사 공식 자료에는 원화 금액이 없습니다. 공식 표현은 ‘over €200 million’, 즉 2억 유로 이상이고, ‘이상’이 정확히 얼마인지는 밝히지 않았습니다. 한국 매체마다 금액이 다르게 나온 이유도 여기 있습니다. 같은 2억 유로를 각자 다른 환율로 바꿨을 뿐입니다.
| 표기 | 출처 | 비고 |
|---|---|---|
| 2억 유로 이상 | EUCLYD 보도자료 (2026-09-15) | 공식 금액, 정확한 총액은 비공개 |
| 약 3100억 원 | 한국경제 (2026-09-19) | 유로당 1,550원이면 나오는 값(역산) |
| 약 3200억 원 | AI타임스 (2026-09-15) | 유로당 1,600원이면 나오는 값(역산) |
| 약 3150억 원 | 더트래커 | 검색 결과로만 확인 |
| 2억 3100만 달러 | TechTimes·DCD 제목 | 달러 환산 |
‘3100억’이나 ‘3200억’을 정확한 투자액처럼 읽으면 안 됩니다. 원화 금액은 환율에 따라 달라지는 환산값입니다. 실제 총액은 이보다 클 수 있지만, 얼마나 더 큰지는 지금 확인되지 않습니다.
투자자 구성은 다음과 같습니다. 공동 주도 투자자는 네 곳입니다.
| 구분 | 투자자 |
|---|---|
| 공동 주도 (4곳) | Samsung, Somerset Capital Partners, Scaleup Europe Fund(EQT 운용), Innovation Industries |
| 참여 | EIFO, imec.xpand, BOM(브라반트 개발청), Quadri |
한국경제는 삼성이 삼성 카탈리스트 펀드로 참여했다고 전했습니다. ioplus 보도에 따르면 시드 투자는 1천만 유로 미만이었습니다. 이 보도가 맞다면 시리즈A 한 번으로 회사 규모가 크게 뛴 셈입니다.
회사가 밝힌 투자금 사용처는 엔지니어링 인력 확충, 실리콘·시스템 로드맵 가속, 파트너십 강화, 상용 배포 준비 네 가지입니다. 겨냥하는 고객은 엔터프라이즈, 국가(소버린) AI, 하이퍼스케일러입니다. 사용처에 ‘상용 배포 준비’가 들어 있다는 건 거꾸로 보면 아직 상용 배포 전 단계라는 뜻입니다.
용어 풀이
1. 시리즈A — 스타트업이 시드 단계 다음에 받는 첫 대규모 기관 투자로, 제품을 시장에 내놓기 위한 자금입니다.
2. 하이퍼스케일러 — 대규모 데이터센터를 직접 운영하는 대형 클라우드 사업자를 가리킵니다.
3. 소버린 AI — 국가가 자국 인프라와 데이터로 직접 운영하려는 AI 체계를 말합니다.
2. 전력비를 줄이는 세 가지 설계 원리
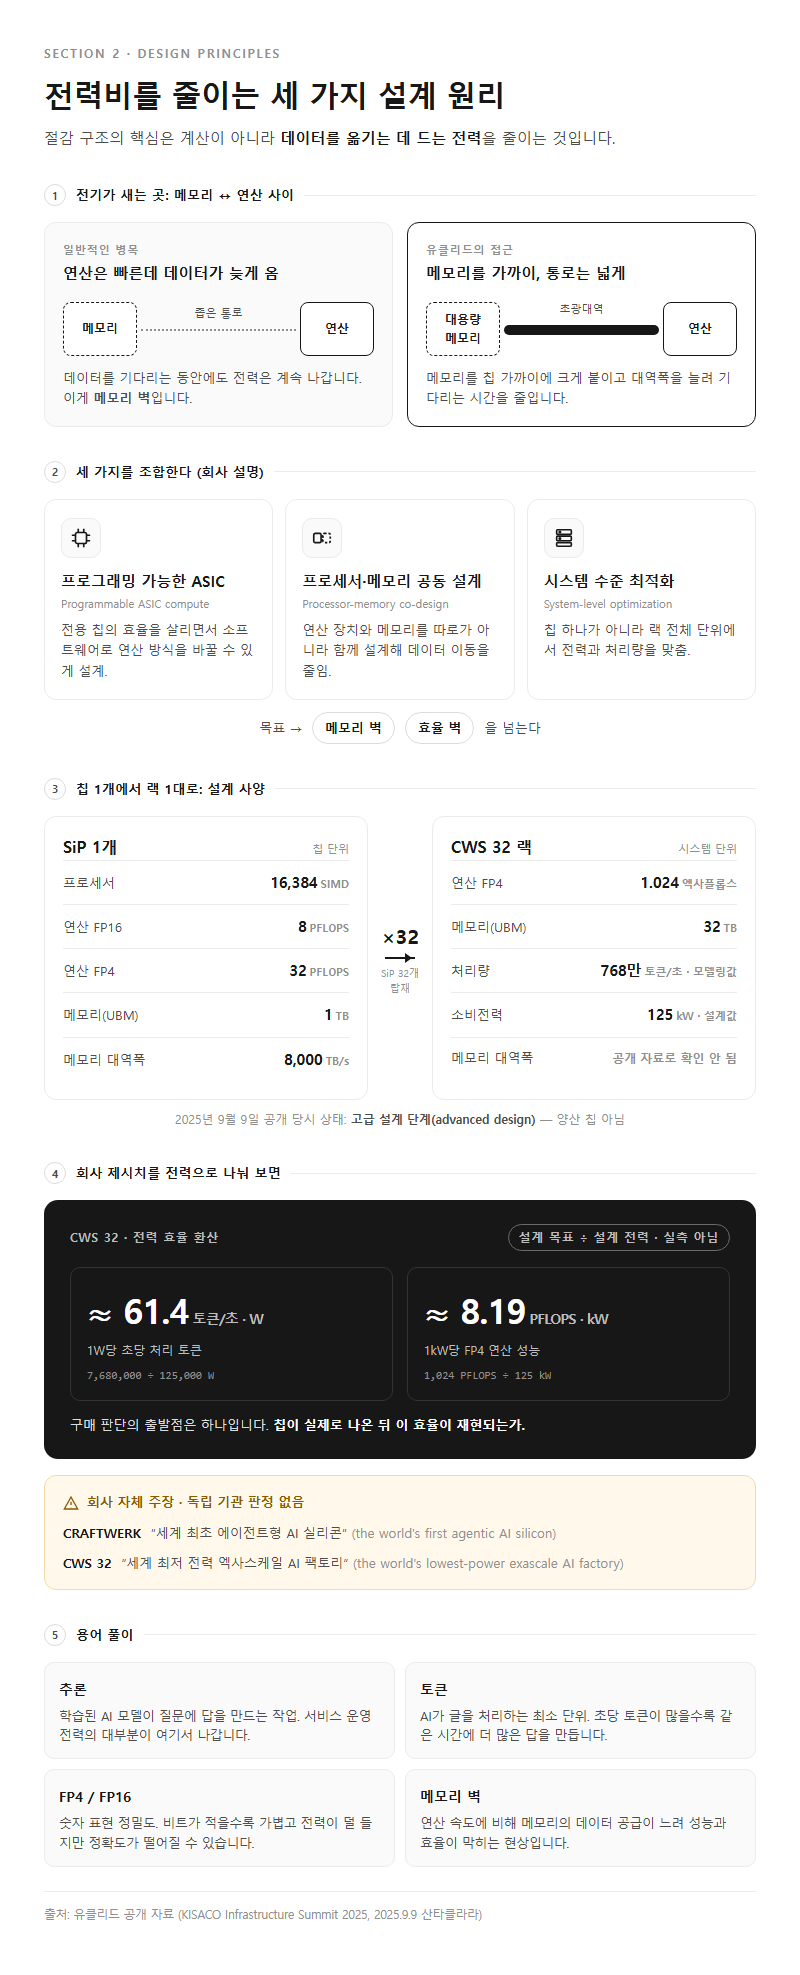
유클리드가 내세우는 절감 구조의 핵심은 데이터를 옮기는 데 드는 전력을 줄이는 것입니다. 회사 설명으로는 세 가지를 조합합니다. 프로그래밍 가능한 ASIC 연산, 프로세서와 메모리를 함께 설계하는 방식(processor-memory co-design), 시스템 수준 최적화입니다. 회사는 이 조합으로 ‘메모리 벽’과 ‘효율 벽’을 넘는다고 말합니다.
풀어 말하면 이렇습니다. AI 칩이 전기를 많이 쓰는 이유는 계산 자체보다 메모리와 연산 장치 사이를 오가는 데이터 이동에 있습니다. 연산 장치가 아무리 빨라도 메모리에서 데이터를 제때 가져오지 못하면, 기다리는 동안 전력만 씁니다. 유클리드는 메모리를 칩 가까이에 크게 붙이고 대역폭을 크게 늘려 이 병목을 줄이려 합니다.
2025년 9월 9일 산타클라라에서 열린 KISACO Infrastructure Summit 2025에서 공개된 칩(SiP) 하나의 설계 사양은 아래와 같습니다. 당시 상태는 회사 표현으로 ‘advanced design’, 즉 고급 설계 단계였습니다.
| 항목 | SiP 1개 | CWS 32 랙 (SiP 32개) |
|---|---|---|
| 프로세서 | 자체 설계 SIMD 16,384개 | — |
| 연산 성능 | FP16 8 PFLOPS / FP4 32 PFLOPS | FP4 1.024 엑사플롭스 |
| 메모리 용량(UBM) | 1TB | 32TB |
| 메모리 대역폭 | 8,000TB/s | 공개 자료로 확인 안 됨 |
| 처리량 | — | 초당 768만 토큰(모델링값) |
| 소비전력 | — | 125kW(설계값) |
회사 제시치를 그대로 나누면 CWS 32는 1W당 초당 약 61.4 토큰, 1kW당 FP4 약 8.19 PFLOPS가 나옵니다. 설계 목표를 나눗셈한 값일 뿐 실측은 아닙니다. 모든 판단은 칩이 실제로 나온 뒤 이 효율이 재현되느냐에서 출발합니다.
회사는 CRAFTWERK를 ‘the world’s first agentic AI silicon'(세계 최초 에이전트형 AI 실리콘)으로, CWS 32를 ‘the world’s lowest-power exascale AI factory'(세계 최저 전력 엑사스케일 AI 팩토리)로 부릅니다. 두 표현 모두 회사 주장이고 독립 기관의 판정은 없습니다.
용어 풀이
1. 추론 — 이미 학습된 AI 모델이 사용자 질문에 답을 만들어내는 작업으로, 서비스 운영 전력의 대부분이 여기서 나갑니다.
2. 토큰 — AI가 글을 처리하는 최소 단위로, 초당 토큰 수가 많을수록 같은 시간에 더 많은 답을 만듭니다.
3. FP4 / FP16 — 숫자를 표현하는 정밀도로, 비트 수가 적을수록 계산이 가볍고 전력이 덜 들지만 정확도가 떨어질 수 있습니다.
4. 메모리 벽 — 연산 속도에 비해 메모리가 데이터를 공급하는 속도가 느려 성능과 효율이 막히는 현상입니다.
3. ‘100배 절감’의 정확한 의미
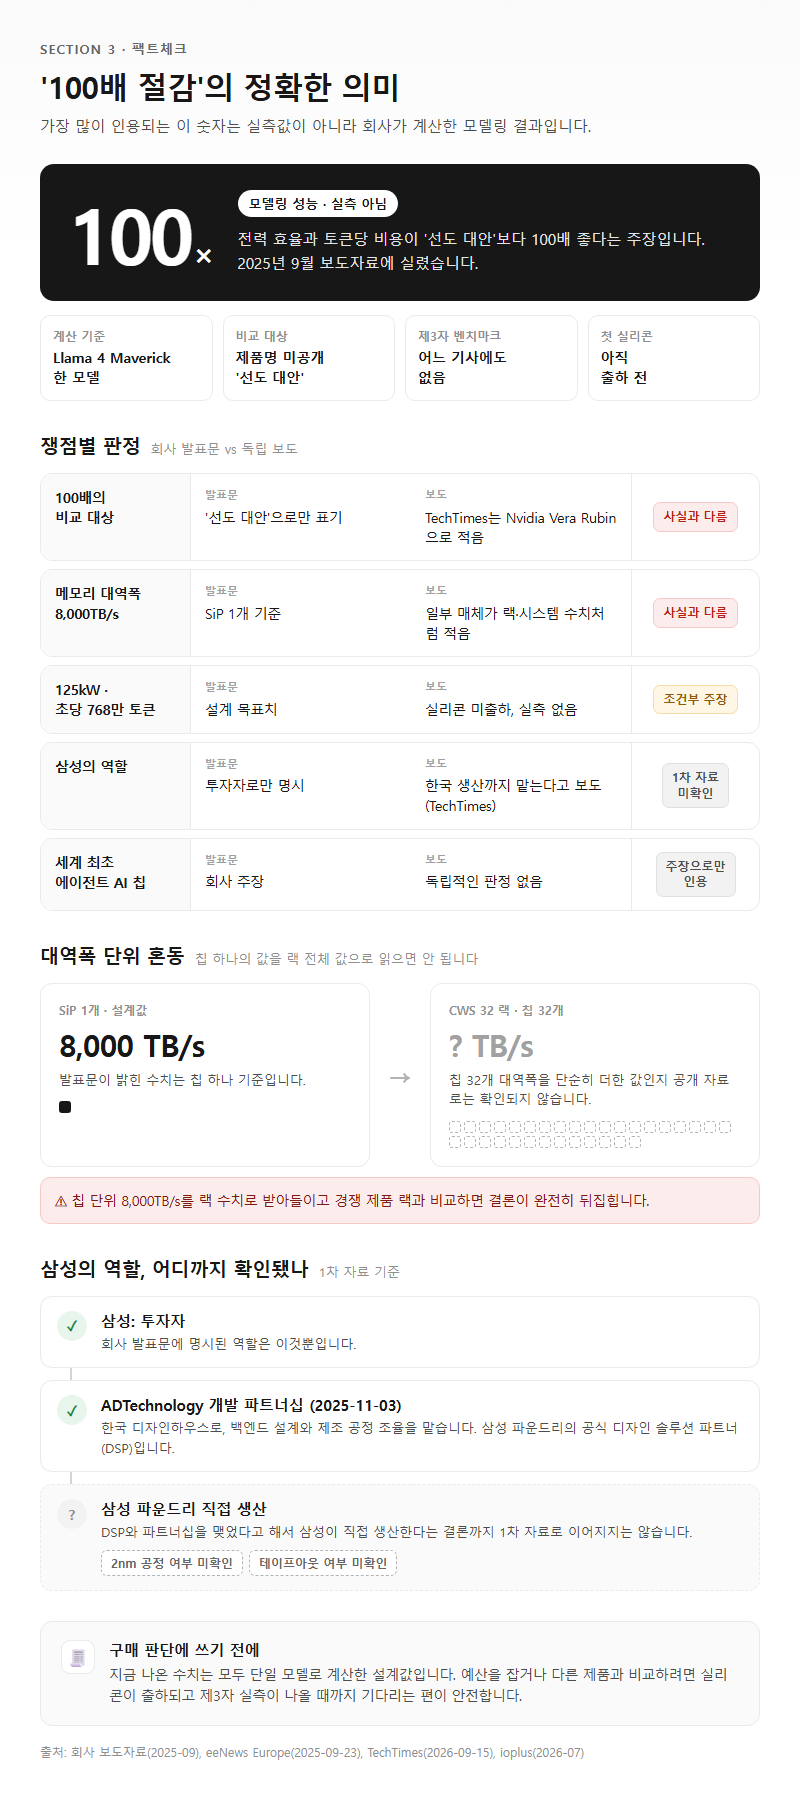
가장 많이 인용되는 ‘100배’는 실측이 아니라 모델링 성능입니다. 2025년 9월 보도자료에 적힌 내용은 전력 효율과 토큰당 비용이 선도 대안보다 100배 좋다는 것이고, 기준은 Llama 4 Maverick 한 모델의 모델링 결과입니다. 비교 대상 제품은 밝히지 않았습니다.
eeNews Europe(2025-09-23)도 같은 내용을 전했습니다. 수치는 ‘모델링 성능’이고, 비교 대상은 특정 제품이 아니라 ‘오늘날 선도적 추론 대안’이라는 설명입니다. 제3자의 실측 벤치마크는 어느 기사에도 없습니다. TechTimes(2026-09-15)와 ioplus(2026-07)는 첫 실리콘이 아직 출하되지 않았다고 적었습니다.
발표문과 다르게 쓴 보도도 있습니다. 쟁점별로 정리하면 다음과 같습니다.
| 쟁점 | 회사 발표문 | 독립 보도 | 판정 |
|---|---|---|---|
| 100배의 비교 대상 | ‘선도 대안’으로만 표기 | TechTimes는 Nvidia Vera Rubin으로 적음 | 발표문에 Vera Rubin이라는 이름이 없어 사실과 다름 |
| 메모리 대역폭 8,000TB/s | SiP 1개 기준 | 일부 매체는 랙·시스템 수치처럼 적음 | 칩과 랙 단위가 어긋나 사실과 다름 |
| 125kW·초당 768만 토큰 | 설계 목표치 | 실리콘 미출하, 실측 없음 | 모델링·단일 모델 조건부 주장 |
| 삼성의 역할 | 투자자로만 명시 | 한국 생산까지 맡는다고 보도(TechTimes) | 생산 주체는 1차 자료 미확인 |
| 세계 최초 에이전트 AI 칩 | 회사 주장 | 독립 판정 없음 | 주장으로만 인용 |
대역폭 단위 혼동은 특히 조심해야 합니다. 8,000TB/s는 칩 하나의 설계값인데, 이걸 랙 전체 수치로 읽으면 경쟁 제품과 비교할 때 결론이 완전히 틀어집니다. CWS 32 랙의 대역폭이 칩 32개 대역폭의 단순 합인지도 공개 자료로는 확인되지 않습니다.
삼성의 역할도 확인된 범위가 좁습니다. 1차 자료로 확인되는 건 2025년 11월 3일 한국 디자인하우스 ADTechnology와 맺은 개발 파트너십입니다. ADTechnology는 백엔드 설계와 제조 공정 조율을 맡고, 삼성 파운드리의 공식 디자인 솔루션 파트너(DSP)입니다. 그렇다고 삼성 파운드리가 직접 생산한다는 결론까지 1차 자료로 이어지지는 않습니다. 2nm 공정인지, 테이프아웃을 마쳤는지도 확인되지 않았습니다.
4. 엔비디아 Vera Rubin과 비교할 때 주의할 점
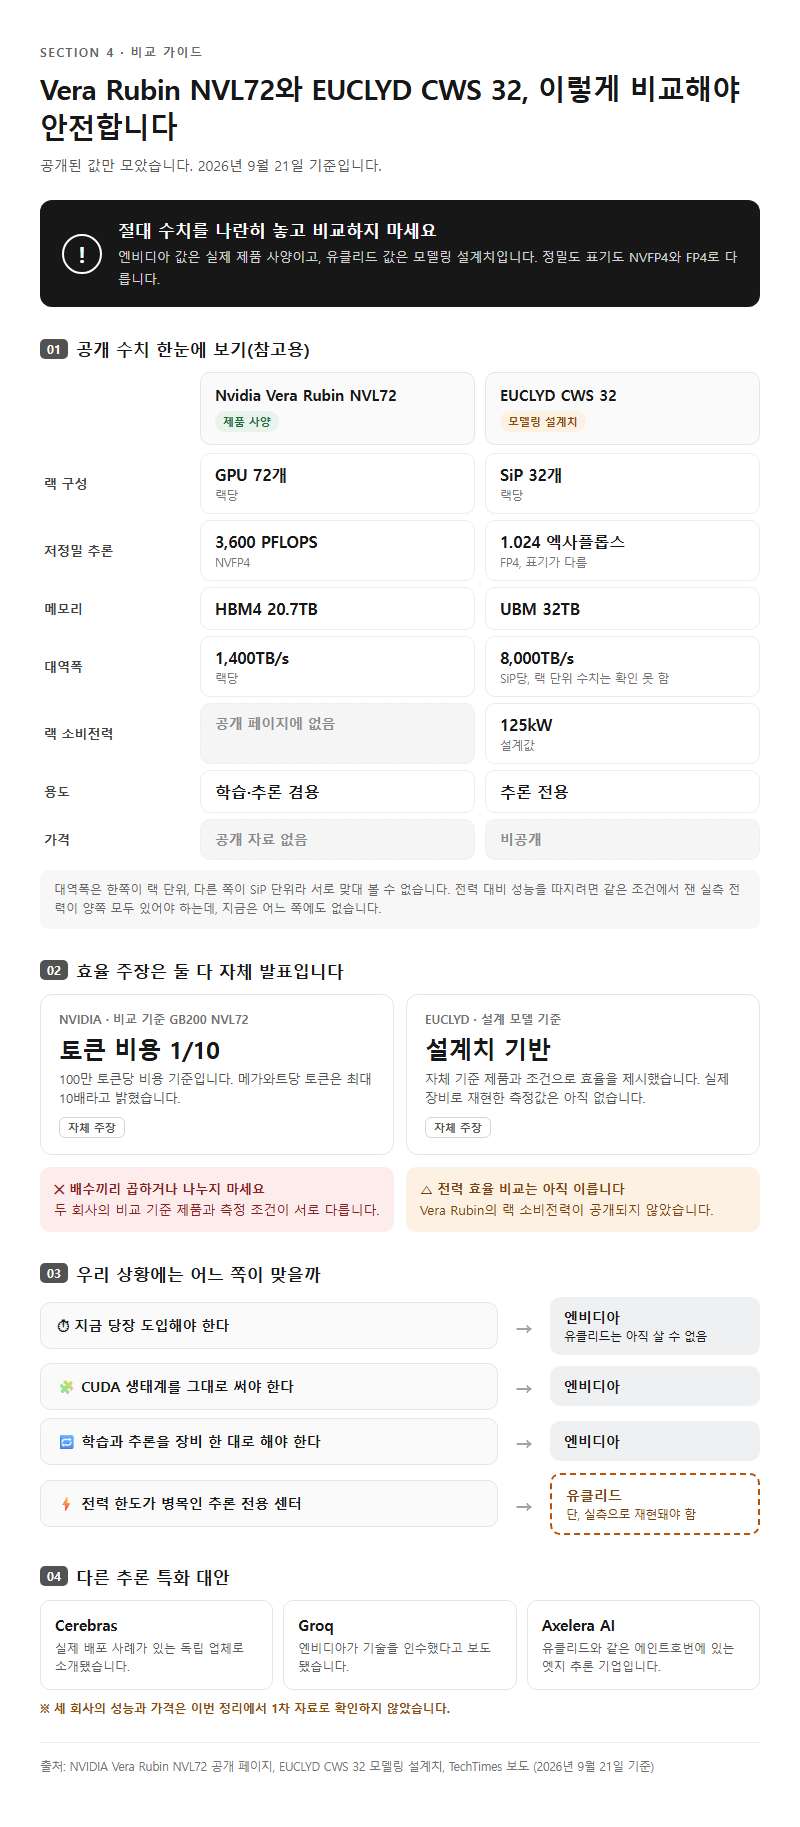
결론부터 말하면 두 제품의 절대 수치를 나란히 놓고 비교하면 안 됩니다. 엔비디아 수치는 실제 제품 사양이고, 유클리드 수치는 모델링 설계치입니다. 정밀도 표기도 NVFP4와 FP4로 다릅니다. 참고용으로 공개된 값만 정리했습니다(2026년 9월 21일 기준).
| 항목 | Nvidia Vera Rubin NVL72 | EUCLYD CWS 32 |
|---|---|---|
| 수치 성격 | 제품 사양 | 모델링 설계치 |
| 구성 | 랙당 GPU 72개 | 랙당 SiP 32개 |
| 저정밀 추론 성능 | NVFP4 3,600 PFLOPS | FP4 1.024 엑사플롭스 |
| 메모리 | HBM4 20.7TB | UBM 32TB |
| 대역폭 | 랙당 1,400TB/s | SiP당 8,000TB/s(랙 수치 미확인) |
| 랙 소비전력 | 해당 페이지에 없음 | 125kW(설계값) |
| 용도 | 학습·추론 겸용 | 추론 전용 |
| 가격 | 공개 자료 없음 | 비공개 |
엔비디아도 자체 효율 주장을 내놓았습니다. Vera Rubin은 GB200 NVL72보다 100만 토큰당 비용이 10분의 1, 메가와트당 토큰은 최대 10배라고 합니다. 이것 역시 엔비디아 자체 주장입니다. 두 회사가 서로 다른 기준 제품과 조건으로 효율을 말하고 있으니, 배수끼리 곱하거나 나눠 비교해 봐야 의미가 없습니다.
Vera Rubin NVL72의 랙 소비전력이 공개 페이지에 없다는 점도 비교를 어렵게 합니다. 전력 대비 성능을 따지려면 양쪽 모두 같은 조건에서 잰 실측 전력이 있어야 하는데, 지금은 어느 쪽에도 그 값이 없습니다.
어느 쪽이 유리한지는 조건에 따라 갈립니다.
| 상황 | 유리한 쪽 |
|---|---|
| 지금 당장 도입해야 할 때 | 엔비디아 (유클리드는 구매 불가) |
| CUDA 생태계를 그대로 써야 할 때 | 엔비디아 |
| 학습과 추론을 한 장비로 해야 할 때 | 엔비디아 |
| 전력 한도가 병목인 추론 전용 센터 | 유클리드 (단, 실측 재현이 전제) |
다른 추론 특화 대안도 있습니다. TechTimes는 실제 배포 사례가 있는 독립 업체로 Cerebras를 언급했고, Groq 기술은 엔비디아가 인수했다고 보도했습니다. 같은 에인트호번의 엣지 추론 기업 Axelera AI도 이 기사에 나옵니다. 이들의 성능과 가격은 이번 정리에서 1차 자료로 확인하지 않았습니다.
5. 자주 묻는 질문과 아직 확인되지 않은 것
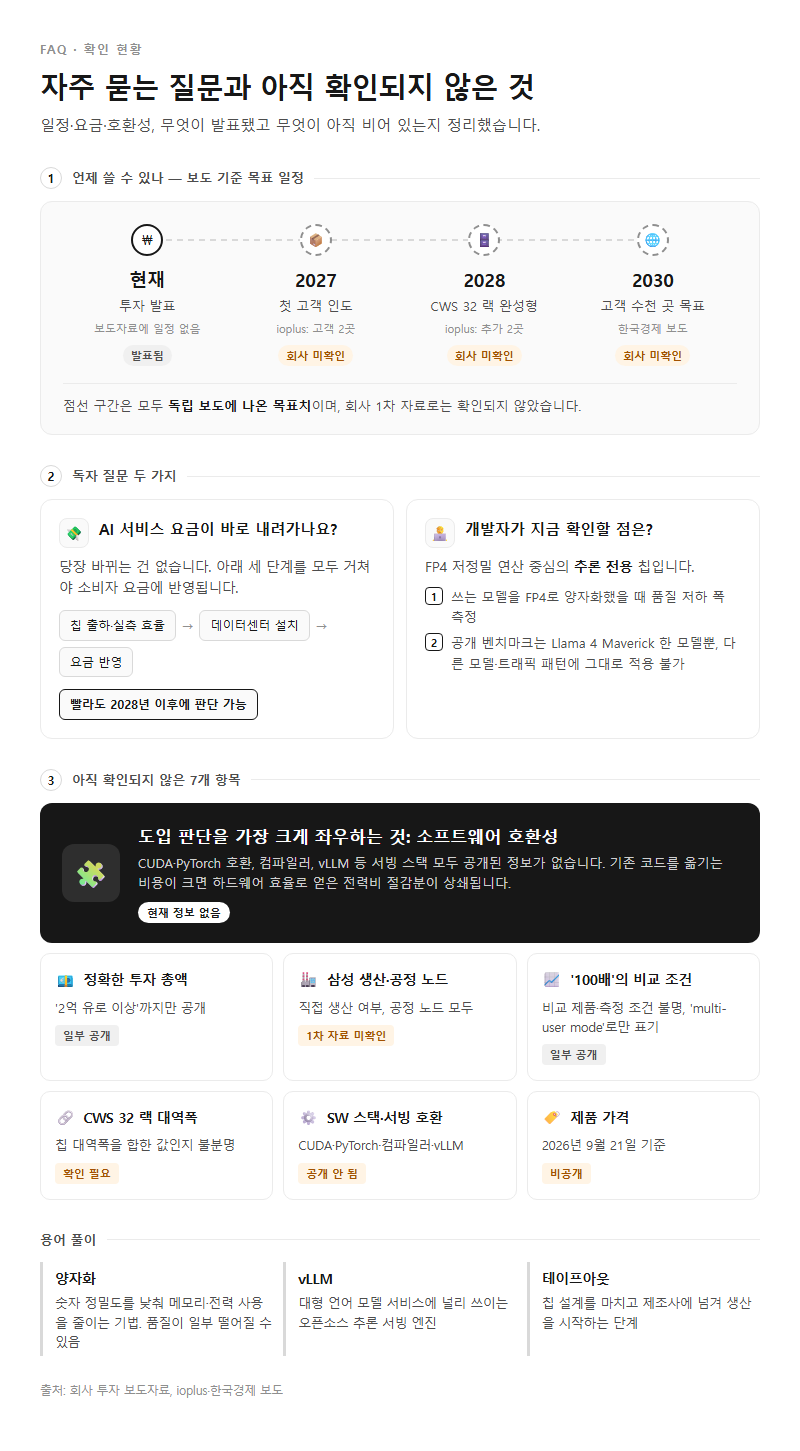
언제 쓸 수 있나요? 투자 보도자료에는 일정이 없습니다. 독립 보도로는 2027년 첫 고객 인도, 2028년 CWS 32 랙 완성형이 목표입니다. ioplus는 2027년에 고객 2곳, 2028년에 추가 2곳에 인도한다고 전했고, 한국경제는 2030년까지 고객 수천 곳 확보가 목표라고 보도했습니다. 셋 다 회사 1차 자료로는 확인되지 않은 목표치입니다.
AI 서비스 요금이 바로 내려가나요? 당장 바뀌는 건 없습니다. 칩이 출하돼 실측 효율이 확인되고, 데이터센터에 실제로 깔리고, 운영사가 그 절감분을 요금에 반영해야 소비자에게 닿습니다. 목표 시점을 감안하면 빨라도 2028년 이후에야 판단할 수 있습니다.
개발자가 지금 확인할 점은 무엇인가요? 이 칩은 FP4 저정밀 연산 중심의 추론 전용입니다. 쓰는 모델을 FP4로 양자화했을 때 품질이 얼마나 떨어지는지부터 봐야 합니다. 공개된 벤치마크 조건도 Llama 4 Maverick 한 모델뿐이라 다른 모델과 트래픽 패턴에는 그대로 적용할 수 없습니다.
아직 확인되지 않은 항목은 다음과 같습니다.
| 항목 | 현재 상태 |
|---|---|
| 정확한 투자 총액 | ‘2억 유로 이상’까지만 공개 (확인 필요) |
| 삼성의 직접 생산 여부·공정 노드 | 1차 자료 미확인 |
| 100배의 비교 제품과 측정 조건 | ‘multi-user mode’ 수준으로만 표기 |
| CWS 32 랙 대역폭 | 칩 대역폭의 합인지 확인 필요 |
| 소프트웨어 스택(CUDA·PyTorch 호환, 컴파일러) | 1차 자료에 언급 없음 |
| vLLM 등 기존 서빙 스택 호환성 | 공개 안 됨 |
| 제품 가격 | 비공개(2026년 9월 21일 기준) |
이 가운데 도입 판단을 가장 크게 좌우하는 건 소프트웨어 호환성입니다. 하드웨어 효율이 아무리 좋아도 기존 코드를 옮기는 비용이 크면 전력비 절감분이 상쇄됩니다. 그런데 이 부분은 현재 아무 정보도 없습니다.
용어 풀이
1. 양자화 — 모델의 숫자 정밀도를 낮춰 메모리와 전력 사용을 줄이는 기법으로, 품질이 일부 떨어질 수 있습니다.
2. vLLM — 대형 언어 모델을 서비스로 띄울 때 널리 쓰이는 오픈소스 추론 서빙 엔진입니다.
3. 테이프아웃 — 칩 설계를 마치고 제조사에 넘겨 생산을 시작하는 단계입니다.
정리
유클리드의 3100억 원 규모 투자는 2억 유로 이상을 원화로 환산한 값이고, 이 돈은 아직 출하되지 않은 추론 전용 칩 설계에 들어갔습니다. 전력비 절감 구조의 핵심은 프로세서와 메모리를 함께 설계해 데이터 이동에 드는 전력을 줄이는 데 있습니다. 다만 ‘100배’와 ‘125kW’는 Llama 4 Maverick 기준 모델링 값이고, 비교 대상 제품도 공개되지 않았습니다. 2027년 첫 인도, 2028년 상용화 일정 역시 독립 보도로만 확인됩니다. 실측 벤치마크와 소프트웨어 호환성이 공개되기 전까지는 가능성으로만 보는 것이 정확합니다.
참고 자료
조사 기준일: 2026년 09월 21일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (확인일은 모두 2026-09-21)
– EUCLYD 투자 보도자료 (PR Newswire): https://www.prnewswire.com/in/news-releases/euclyd-raises-over-200-million-to-break-the-ai-efficiency-wall-302878043.html
– EUCLYD 공식 사이트 보도자료: https://euclyd.ai/press-release
– EUCLYD 공식 사이트: https://euclyd.ai/
– CRAFTWERK 공개 보도자료 (EIN Presswire, 2025-09-09): https://www.einpresswire.com/article/847010862/euclyd-unveils-craftwerk-the-world-s-most-power-efficient-exascale-token-factory-for-agentic-ai
– ADTechnology 공동 보도자료 (2025-11-03): https://www.technologypresswirenetherlands.com/article/863902238-adtechnology-collaborates-with-euclyd-to-develop-ultra-efficient-ai-chip-for-datacenters
– NVIDIA Vera Rubin NVL72 사양 페이지: https://www.nvidia.com/en-us/data-center/vera-rubin-nvl72/
– 참고: euclyd.ai에 있던 CRAFTWERK·ADTechnology 원문 페이지는 404로 열리지 않아, 같은 보도자료의 배포처 사본으로 대조했습니다.
Tier 2 (확인일은 모두 2026-09-21)
– TechTimes (2026-09-15): https://www.techtimes.com/articles/327569/20260915/euclyd-raises-200m-samsung-funds-builds-its-rival-chip-nvidia-inference.htm
– eeNews Europe (2025-09-23): https://www.eenewseurope.com/en/euclyd-unveils-craftwerk-exascale-inference-architecture-targets-agentic-ai-at-record-efficiency/
– ioplus (2026-07): https://ioplus.nl/en/posts/euclyd-is-all-in-to-free-ai-from-its-power-problem
– 한국경제 (2026-09-19): https://www.hankyung.com/article/2026091839056
– AI타임스 (2026-09-15): https://www.aitimes.com/news/articleView.html?idxno=215270
– 확인 실패: TechRadar(본문이 잘려 읽지 못함), DCD(403 오류로 접속 불가)
답글 남기기