
LLM 에이전트는 웹 검색 여부를 모델이 스스로 결정합니다. OpenAI·Claude·Gemini API의 검색 결정 방식, 인용 구조, 비용 계산법, 검색 오류 감지법을 2026년 9월 기준 공식 문서와 독립 연구로 비교했습니다.
LLM에이전트웹검색 핵심만 먼저 정리하면
LLM 에이전트의 웹 검색은 개발자가 매번 켜는 기능이 아닙니다. LLM 에이전트가 질문을 보고 검색할지 스스로 판단합니다. OpenAI Responses API도 tool_choice: "auto"가 기본값이라 검색은 선택 사항으로 남습니다. Anthropic은 최근 사건이나 현재 가격처럼 바뀌는 정보일 때만 검색하도록 기준을 문서에 적어 두었고, Gemini는 구체적인 결정 기준을 공개하지 않습니다.
검색 결과는 인용 형태로 답변에 붙습니다. 하지만 인용이 달렸다고 해서 그 문서가 실제 근거로 쓰였다는 보장은 없습니다. 독립 연구에서는 인용의 최대 57%가 사후에 끼워 맞춘 것이었고, 인용 URL의 3–13%는 존재한 적이 없는 주소였습니다. 이 글은 OpenAI·Claude·Gemini 세 API의 검색 결정 방식, 검색 결과가 답변에 반영되는 구조, 비용 계산법, 운영 중 놓치기 쉬운 예외를 2026년 9월 20일 기준 공식 문서와 제3자 연구로 대조해 정리했습니다.
Q1. LLM 에이전트는 언제 웹 검색을 하고, 언제 건너뛰나요?
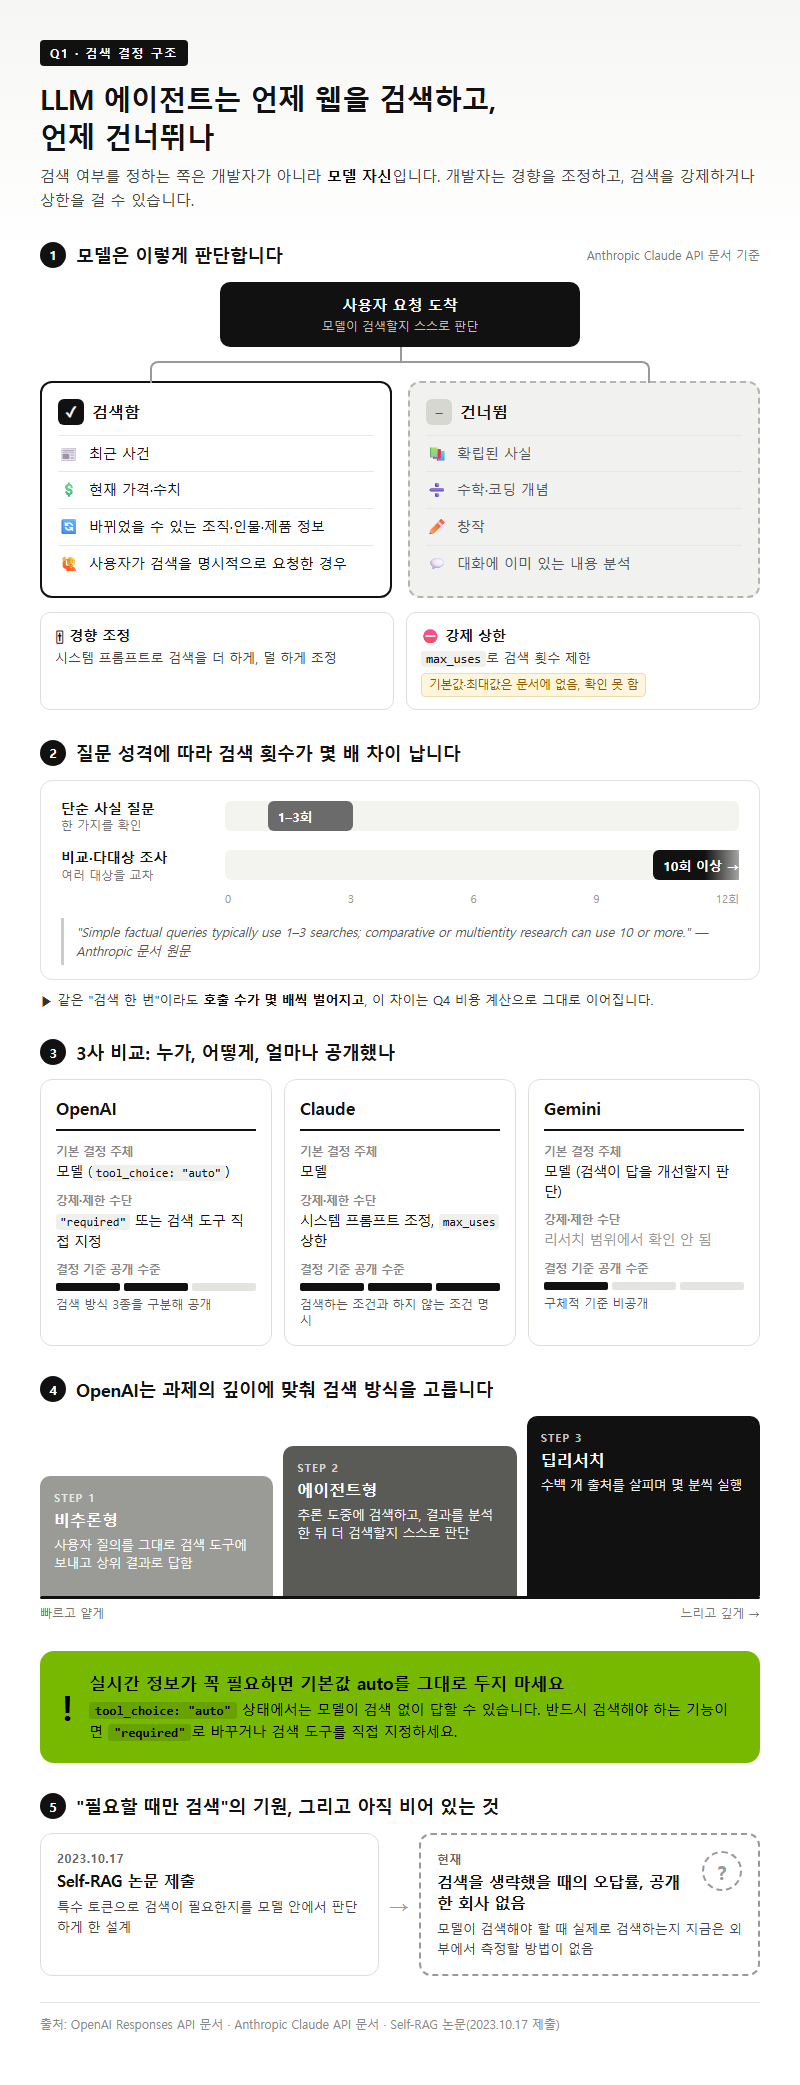
검색 여부를 정하는 주체는 개발자가 아니라 모델 자신입니다. OpenAI Responses API는 tool_choice: "auto"가 기본값이고, 이때 모델은 검색하지 않고 답할 수도 있습니다. 반드시 검색하게 하려면 tool_choice를 "required"로 두거나 검색 도구를 직접 지정합니다. 실시간 정보가 꼭 필요한 기능이라면 기본값 auto를 그대로 두면 안 됩니다.
결정 기준을 가장 구체적으로 공개한 곳은 Anthropic입니다. Claude API 문서를 보면, 검색하는 경우는 최근 사건, 현재 가격·수치, 바뀌었을 수 있는 조직·인물·제품 정보, 그리고 사용자가 검색을 명시적으로 요청한 경우입니다. 확립된 사실, 수학·코딩 개념, 창작, 대화에 이미 있는 내용을 분석하는 요청에는 검색하지 않습니다. 이 경향은 시스템 프롬프트로 조정하고, 강제 상한은 max_uses로 겁니다. 다만 max_uses의 기본값과 최대값은 문서에 나와 있지 않아 확인하지 못했습니다.
검색 횟수도 Anthropic 문서에 기준이 있습니다. 원문은 “Simple factual queries typically use 1–3 searches; comparative or multientity research can use 10 or more.”입니다. 단순한 사실 질문은 1–3회, 여러 대상을 비교하는 조사는 10회 이상 검색한다는 뜻입니다. 같은 “검색 한 번”이라도 질문의 성격에 따라 호출 수가 몇 배씩 벌어지며, 이 차이는 Q4의 비용 계산으로 그대로 이어집니다.
| 구분 | OpenAI | Claude | Gemini |
|---|---|---|---|
| 기본 결정 주체 | 모델(tool_choice: "auto") |
모델 | 모델(검색이 답을 개선할지 판단) |
| 강제·제한 수단 | "required" 또는 도구 직접 지정 |
시스템 프롬프트 조정, max_uses 상한 |
리서치 범위에서 확인 안 됨 |
| 결정 기준 공개 수준 | 검색 방식 3종을 구분해 공개 | 검색하는 조건과 하지 않는 조건 명시 | 구체적 기준 비공개 |
OpenAI는 검색 방식을 셋으로 나눕니다. 첫째 비추론형은 사용자 질의를 그대로 검색 도구에 보내고 상위 결과로 답합니다. 둘째 에이전트형은 추론하는 도중에 검색하고, 결과를 분석한 뒤 더 검색할지 스스로 판단합니다. 셋째 딥리서치는 수백 개 출처를 살피며 몇 분씩 실행됩니다. 과제의 깊이에 맞춰 검색 방식을 고를 수 있다는 것이 OpenAI 구조의 특징입니다.
“필요할 때만 검색한다”는 설계는 2023년 10월 17일 제출된 Self-RAG 논문으로 거슬러 올라갑니다. 이 논문은 특수 토큰으로 검색 필요 여부를 모델 안에서 판단하게 했습니다. 문제는 검색을 생략했을 때의 오답률을 공개한 회사가 없다는 점입니다. 모델이 검색해야 할 때 실제로 검색하는지, 지금은 외부에서 측정할 방법이 없습니다.
용어 풀이
1. 반영 토큰(reflection token) — 모델이 답을 만드는 도중에 “지금 문서를 가져와야 하는가”, “가져온 문서가 관련 있는가”를 스스로 표시하도록 학습시킨 특수 토큰입니다.
2. 에이전트형 검색 — 한 번 검색하고 끝나지 않고, 결과를 읽은 뒤 추가 검색 여부를 모델이 반복해서 판단하는 방식입니다.
Q2. 검색 결과는 답변에 어떻게 반영되고, 인용은 어떤 구조로 붙나요?
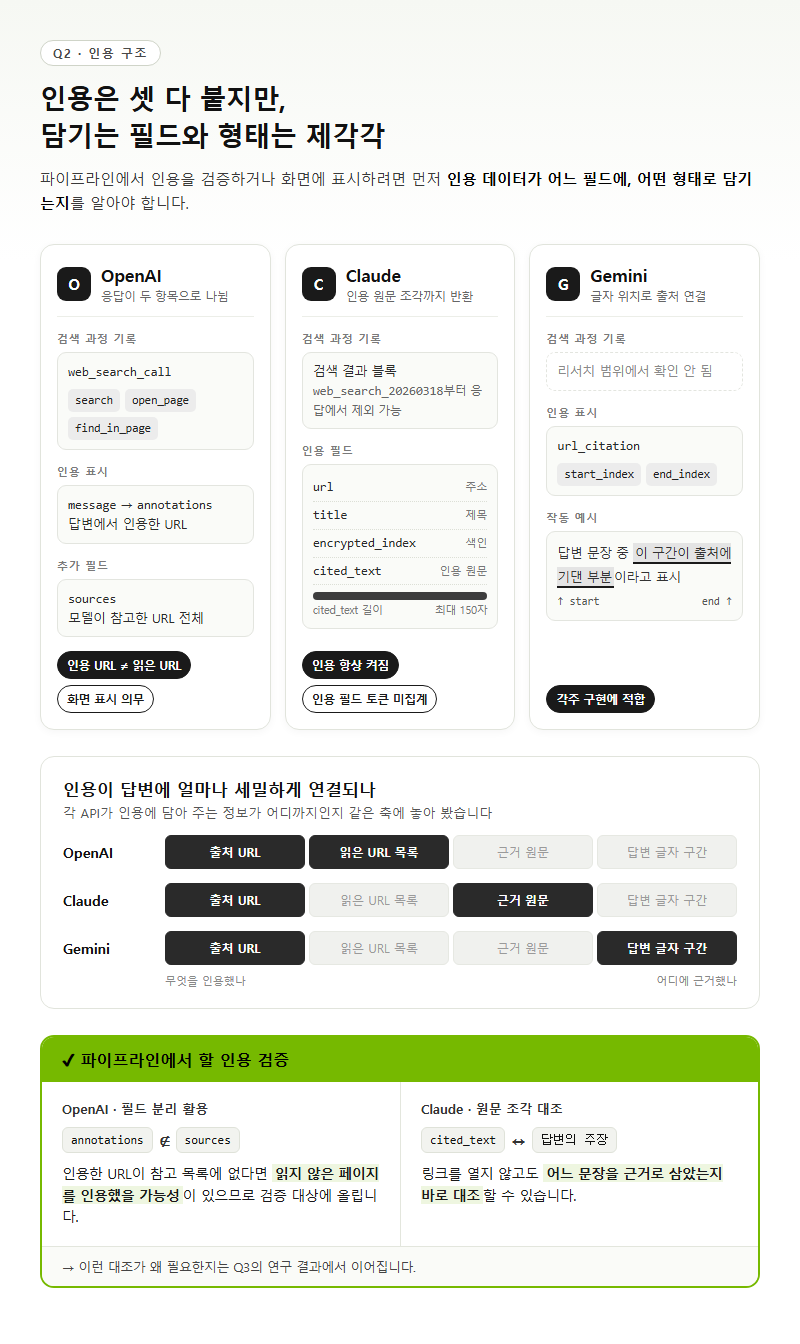
세 API 모두 검색 결과를 인용으로 답변에 연결하지만, 인용 데이터를 어떤 필드에 어떤 형태로 담는지는 서로 다릅니다. 파이프라인에서 인용을 검증하거나 화면에 표시하려면 이 차이부터 알아야 합니다.
OpenAI의 응답은 두 부분으로 나뉩니다. 하나는 web_search_call 항목으로, 모델이 한 행동이 search·open_page·find_in_page 세 종류로 기록됩니다. 다른 하나는 message 항목이며, 답변에서 인용한 URL은 annotations에 담깁니다. 이와 별도로 sources 필드는 모델이 참고한 URL 전체를 돌려줍니다. 인용된 URL과 실제로 읽은 URL이 따로 존재하는 셈입니다. OpenAI는 인용을 사용자 화면에 보이도록 표시하는 것을 의무로 정해 두었습니다.
Claude는 인용이 항상 켜져 있어 끌 수 없습니다. 각 인용에는 url·title·encrypted_index와 함께 cited_text가 붙습니다. 인용된 원문 조각이며 최대 150자입니다. 인용 필드는 토큰 사용량에 잡히지 않습니다. Claude 구조의 강점은 여기 있습니다. 사람이 링크를 열지 않고도 어느 문장을 근거로 삼았는지 바로 대조할 수 있습니다.
Gemini는 url_citation에 start_index와 end_index를 붙여, 답변의 몇 번째 글자부터 몇 번째 글자까지가 해당 출처에 기댄 부분인지 표시합니다. 답변 문장과 출처를 글자 위치 단위로 연결하는 방식이라, 화면에 각주를 다는 구현에 잘 맞습니다.
| 공급사 | 검색 과정 기록 | 인용 표시 방식 | 운영상 특징 |
|---|---|---|---|
| OpenAI | web_search_call(search·open_page·find_in_page) |
message의 annotations에 URL |
sources로 참고 URL 전체 반환 |
| Claude | 검색 결과 블록(web_search_20260318부터 응답에서 제외 가능) |
url·title·encrypted_index·cited_text(최대 150자) | 인용 항상 켜짐, 인용 필드는 토큰 미집계 |
| Gemini | 리서치 범위에서 확인 안 됨 | url_citation의 start_index·end_index |
답변 내 글자 구간으로 출처 연결 |
실무에서 가장 쓸모 있는 구조는 OpenAI의 필드 분리입니다. annotations에 있는 URL이 sources에 없다면 모델이 읽지 않은 페이지를 인용했을 가능성이 있으니 검증 대상에 올려야 합니다. Claude에서는 cited_text가 답변의 주장과 실제로 맞는지 확인하는 단계가 같은 역할을 합니다. 이런 대조가 왜 필요한지는 Q3의 연구 결과가 보여 줍니다.
Q3. 답변에 출처 링크가 붙어 있으면 그 내용을 믿어도 되나요?
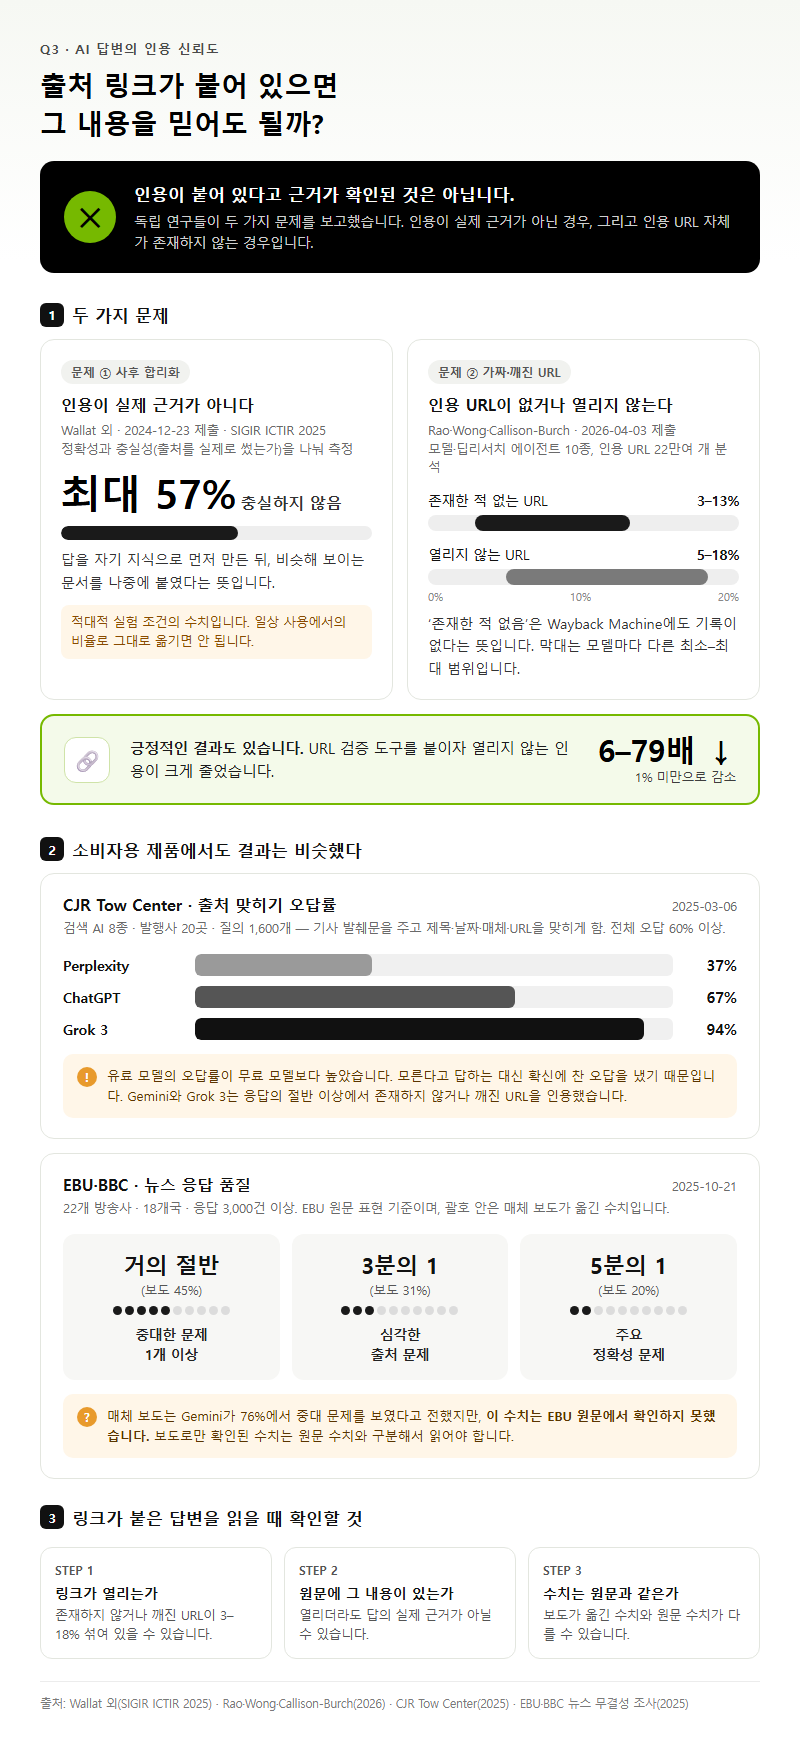
결론부터 말하면 인용이 붙어 있다는 사실만으로는 근거가 확인되지 않습니다. 인용 품질을 측정한 독립 연구들은 두 가지 문제를 보고합니다. 하나는 인용이 실제 근거가 아닌 경우이고, 다른 하나는 인용 URL 자체가 존재하지 않는 경우입니다.
첫 번째 문제는 Wallat 외 연구(2024년 12월 23일 제출, SIGIR ICTIR 2025)가 다뤘습니다. 이 연구는 인용이 맞는지(정확성)와 모델이 그 출처를 실제로 사용했는지(충실성)를 나눠 측정했습니다. 실험에서 인용의 최대 57%가 충실하지 않았습니다. 모델이 자기 지식으로 답을 먼저 만들고, 비슷해 보이는 문서를 나중에 붙였다는 뜻입니다. 이른바 사후 합리화입니다. 이 수치는 적대적 실험 조건에서 나왔으므로 일상적인 사용에서의 비율로 그대로 옮기면 안 됩니다.
두 번째 문제는 Rao·Wong·Callison-Burch 연구(2026년 4월 3일 제출)가 측정했습니다. 모델과 딥리서치 에이전트 10종이 낸 인용 URL 22만여 개를 분석했더니, 3–13%는 존재한 적이 없는 URL이었습니다. Wayback Machine에도 기록이 없었다는 뜻입니다. 5–18%는 열리지 않았습니다. 긍정적인 결과도 있습니다. URL 검증 도구를 붙이자 열리지 않는 인용이 6–79배 줄어 1% 미만이 됐습니다.
| 조사 | 발표 시점 | 규모 | 핵심 결과 |
|---|---|---|---|
| Wallat 외 | 2024-12-23 | 적대적 실험 | 충실하지 않은 인용 최대 57% |
| Rao 외 | 2026-04-03 | 모델·에이전트 10종, URL 22만여 개 | 존재하지 않는 URL 3–13%, 열리지 않는 URL 5–18% |
| CJR Tow Center | 2025-03-06 | 검색 AI 8종, 발행사 20곳, 질의 1,600개 | 전체 오답 60% 이상 |
| EBU·BBC | 2025-10-21 | 22개 방송사, 18개국, 응답 3,000건 이상 | 거의 절반이 중대 문제 1개 이상 |
소비자용 제품을 시험한 조사에서도 결과는 비슷했습니다. CJR Tow Center는 기사 발췌문을 주고 제목·날짜·매체·URL을 맞히게 했는데, 오답률이 Perplexity 37%, ChatGPT 67%, Grok 3 94%였습니다. 유료 모델의 오답률이 무료 모델보다 높았습니다. 모른다고 답하는 대신 확신에 찬 오답을 냈기 때문입니다. Gemini와 Grok 3는 응답의 절반 이상에서 존재하지 않거나 깨진 URL을 인용했습니다.
EBU·BBC 조사는 EBU 원문 기준으로 거의 절반이 중대한 문제를 1개 이상, 3분의 1이 심각한 출처 문제, 5분의 1이 주요 정확성 문제를 보였습니다. 이 조사를 전한 매체 보도는 각각 45%·31%·20%로 옮겼고, Gemini가 76%에서 중대 문제를 보였다고 전했습니다. 다만 Gemini 76%는 EBU 원문에서 확인하지 못한 수치입니다.
이 결과를 해석할 때 주의할 점이 있습니다. 매체 보도로만 확인된 수치이지만 OpenAI GPT-4o search preview는 짧은 사실 질문 벤치마크인 SimpleQA에서 90%, mini는 88%를 기록했습니다(OpenAI 원문은 접속이 차단돼 대조하지 못했습니다). 같은 계열 제품이 출처 식별 과제에서는 67% 오답을 냈으니, 사실을 맞히는 능력과 출처를 정확히 대는 능력은 별개입니다. CJR·EBU 조사는 소비자용 챗 제품이 대상이었고, 2026년 API 도구, 특히 동적 필터링 이후 버전을 제3자가 다시 측정한 자료는 찾지 못했습니다.
용어 풀이
1. SimpleQA — 정답이 하나로 정해진 짧은 사실 질문에 모델이 맞게 답하는지를 재는 OpenAI의 벤치마크입니다.
2. Wayback Machine — 인터넷 아카이브가 운영하는 웹페이지 보관 서비스로, 과거에 존재했던 URL인지 확인하는 기준으로 쓰입니다.
Q4. 웹 검색 API 비용은 어떻게 계산해야 오판하지 않나요?
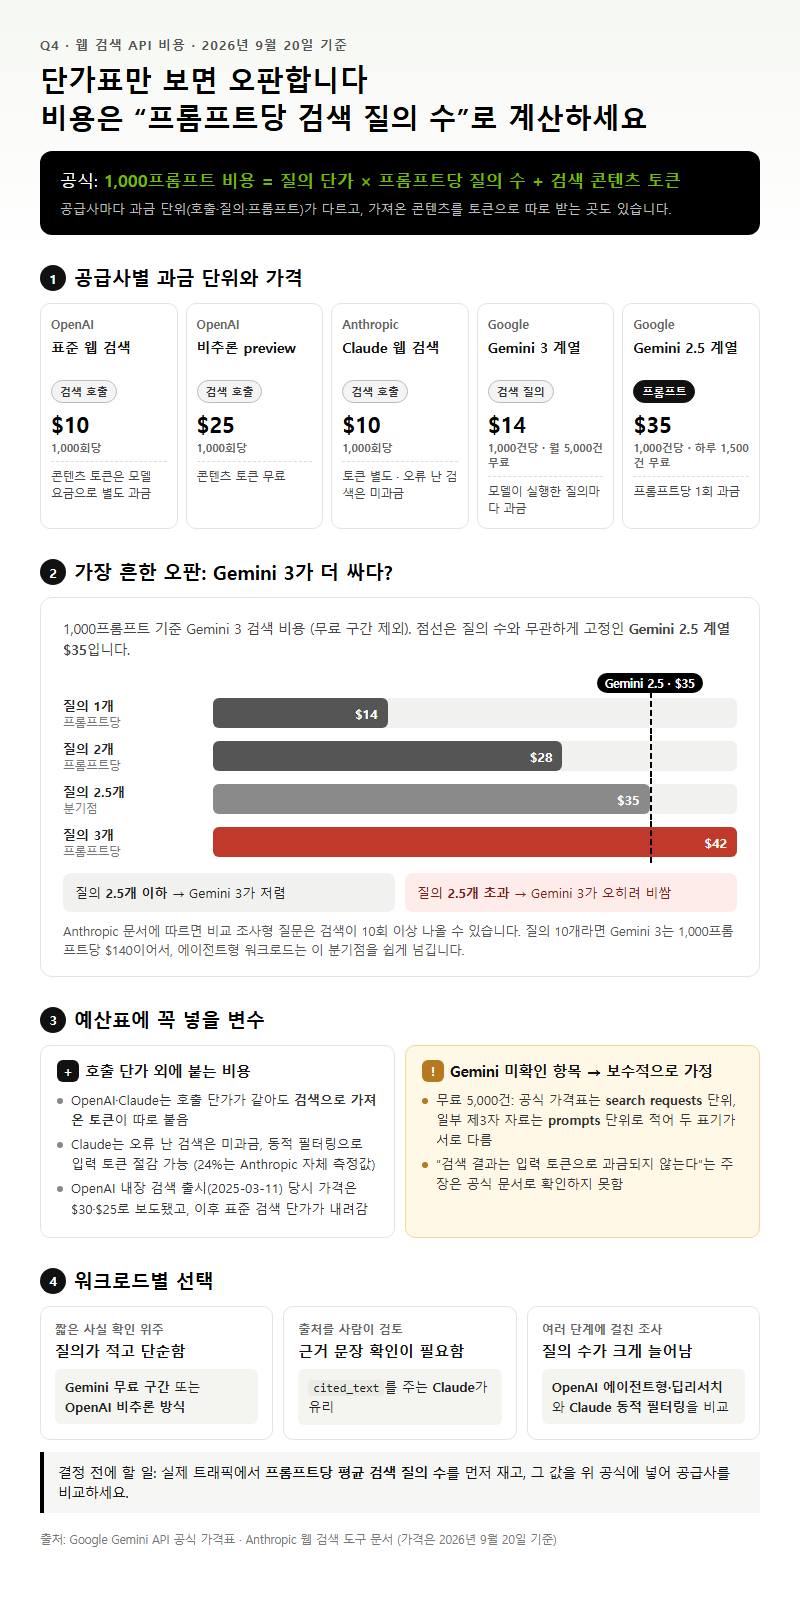
비용은 단가표가 아니라 “프롬프트 하나당 검색 질의 수”로 계산해야 합니다. 공급사마다 과금 단위가 다르고, 검색으로 가져온 콘텐츠를 토큰으로 따로 받는 곳도 있기 때문입니다. 아래 가격은 모두 2026년 9월 20일 기준입니다.
| 공급사·모델 | 과금 단위 | 가격(2026-09-20 기준) | 추가 조건 |
|---|---|---|---|
| OpenAI 표준 웹 검색 | 검색 호출 | 1,000회당 10달러 | 가져온 콘텐츠 토큰은 모델 요금으로 별도 과금 |
| OpenAI 비추론 preview | 검색 호출 | 1,000회당 25달러 | 콘텐츠 토큰 무료 |
| Claude 웹 검색 | 검색 호출 | 1,000회당 10달러 | 토큰 별도, 오류 난 검색은 미과금 |
| Gemini 3 계열 | 검색 질의 | 월 5,000건 무료, 이후 1,000건당 14달러 | 모델이 실행한 질의마다 과금 |
| Gemini 2.5 계열 | 프롬프트 | 하루 1,500건 무료, 이후 1,000건당 35달러 | 프롬프트당 1회 과금 |
가장 오판하기 쉬운 곳은 Gemini입니다. 단가만 보면 Gemini 3의 14달러가 2.5의 35달러보다 싸 보이지만, 과금 단위가 프롬프트에서 질의로 바뀌었습니다. 프롬프트 하나에 질의가 2.5개를 넘으면 Gemini 3가 오히려 비쌉니다. 질의가 3개라면 1,000프롬프트당 42달러로 2.5 계열보다 비용이 커집니다. Anthropic 문서가 밝히듯 비교 조사형 질문은 검색이 10회 이상 나올 수 있어서, 에이전트형 워크로드는 이 분기점을 넘기기 쉽습니다.
Gemini에는 확인이 끝나지 않은 항목이 두 가지 있습니다. 공식 가격표는 Gemini 3의 무료 한도 5,000건을 search requests 단위로 적지만, 일부 제3자 자료는 prompts 단위로 적어 두 표기가 서로 맞지 않습니다. 검색 결과가 입력 토큰으로 과금되지 않는다는 주장도 공식 문서에서 확인하지 못했습니다. 예산을 잡을 때는 두 항목 모두 보수적으로 가정하는 편이 안전합니다.
OpenAI와 Claude는 호출 단가가 같아도 검색으로 가져온 토큰이 추가로 붙는다는 점을 계산에 넣어야 합니다. 참고로 OpenAI가 2025년 3월 11일 Responses API 내장 검색 도구를 출시할 당시 가격은 1,000건당 30달러와 25달러였다고 매체가 보도했고, 이후 표준 검색 단가가 내려갔습니다. Claude는 오류가 난 검색에 요금을 받지 않고, 동적 필터링으로 입력 토큰을 줄일 수 있습니다. 다만 그 절감 폭(24%)은 Anthropic의 자체 측정값입니다.
조건별로 정리하면 이렇습니다. 짧은 사실 확인이 대부분인 서비스는 Gemini 무료 구간이나 OpenAI 비추론 방식이 맞습니다. 출처를 사람이 검토해야 하는 업무라면 cited_text를 주는 Claude가 유리합니다. 여러 단계에 걸친 조사라면 OpenAI 에이전트형·딥리서치나 Claude 동적 필터링을 비교 대상으로 두되, 프롬프트당 평균 질의 수를 먼저 로그로 측정한 뒤 단가를 곱해야 합니다.
Q5. 도입할 때 놓치기 쉬운 오류 처리와 플랫폼 제약은 무엇인가요?
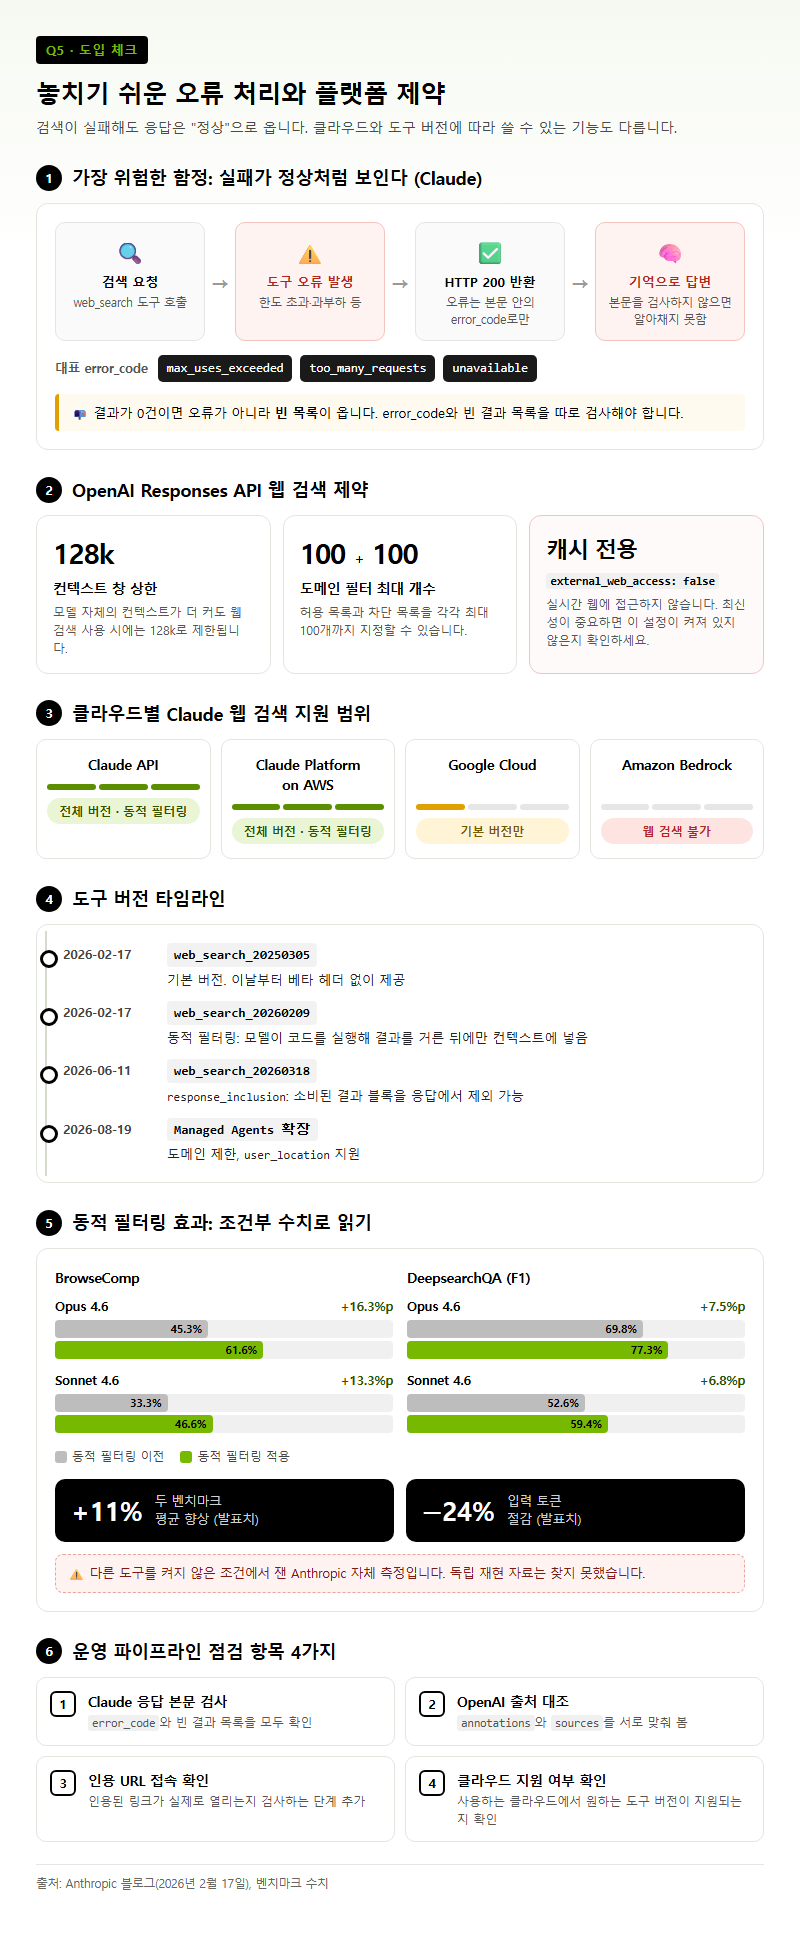
가장 위험한 함정은 검색 실패가 정상 응답처럼 보이는 구조입니다. Claude는 검색 도구에서 오류가 나도 HTTP 200을 돌려주고, 오류는 본문 안의 error_code로만 표시합니다. 대표 코드는 max_uses_exceeded·too_many_requests·unavailable입니다. 결과가 0건이면 오류가 아니라 빈 목록이 옵니다. 호출 측이 본문을 직접 검사하지 않으면, 모델이 검색 없이 기억만으로 답했다는 사실을 알아채지 못합니다.
OpenAI에도 알아 둘 제약이 있습니다. Responses API 웹 검색은 모델 자체의 컨텍스트가 더 크더라도 컨텍스트 창이 128k로 제한됩니다. 도메인 필터는 허용 목록과 차단 목록 각각 최대 100개까지 지정할 수 있습니다. external_web_access: false로 두면 실시간 웹에 접근하지 않고 캐시만 쓰는 모드로 동작합니다. 최신성이 중요한 기능이라면 이 설정이 켜져 있지 않은지 확인해야 합니다.
Claude는 도구 버전과 사용하는 클라우드에 따라 쓸 수 있는 기능이 달라집니다. Amazon Bedrock에서는 웹 검색 자체를 쓸 수 없고, Google Cloud에서는 기본 버전만 됩니다. 동적 필터링까지 전체 버전을 쓸 수 있는 곳은 Claude API와 Claude Platform on AWS입니다.
| 도구 버전 | 핵심 기능 | 적용 시점 |
|---|---|---|
web_search_20250305 |
기본 버전 | 2026-02-17부터 베타 헤더 없이 제공 |
web_search_20260209 |
동적 필터링: 모델이 코드를 실행해 결과를 거른 뒤에만 컨텍스트에 넣음 | 2026-02-17 도입 |
web_search_20260318 |
response_inclusion: 소비된 결과 블록을 응답에서 제외 가능 |
2026-06-11 출시 |
| Managed Agents 확장 | 도메인 제한, user_location |
2026-08-19 |
동적 필터링의 효과는 조건부 수치로 읽어야 합니다. Anthropic 블로그(2026년 2월 17일)에 따르면 BrowseComp 점수가 Opus 4.6은 45.3%에서 61.6%로, Sonnet 4.6은 33.3%에서 46.6%로 올랐습니다. DeepsearchQA(F1)는 Opus 4.6이 69.8%에서 77.3%로, Sonnet 4.6이 52.6%에서 59.4%로 올랐고, 두 벤치마크 평균 11% 향상과 입력 토큰 24% 절감을 함께 발표했습니다. 하지만 이는 다른 도구를 켜지 않은 조건에서 잰 자사 측정이며, 독립 재현 자료는 찾지 못했습니다.
운영 파이프라인에 넣을 점검 항목은 네 가지입니다. ① Claude 응답 본문의 error_code와 빈 결과 목록 검사, ② OpenAI annotations와 sources 대조, ③ 인용 URL이 실제로 열리는지 확인하는 단계, ④ 사용하는 클라우드에서 원하는 도구 버전이 지원되는지 사전 확인입니다. 특히 ③은 Q3의 연구에서 열리지 않는 인용을 1% 미만으로 낮춘 방법이라 투입 대비 효과가 큽니다. 반면 max_uses의 기본값·상한과 검색 생략 시 오답률은 공개 자료로 확인할 수 없으니, 직접 로그를 쌓아 판단해야 합니다.
용어 풀이
1. BrowseComp — 여러 웹페이지를 단계적으로 탐색해야 찾을 수 있는 정보를 에이전트가 맞히는지 평가하는 벤치마크입니다.
2. F1 점수 — 정밀도(답한 것 중 맞은 비율)와 재현율(맞혀야 할 것 중 맞힌 비율)의 조화평균으로, 둘을 한 숫자로 묶어 보여 줍니다.
정리
LLM 에이전트의 웹 검색은 모델이 검색 여부를 결정하고, 결과를 인용으로 붙이는 구조입니다. 최신 정보가 반드시 필요하다면 tool_choice: "required"처럼 검색을 강제하는 설정을 명시해야 합니다. 인용 형태는 OpenAI의 annotations·sources, Claude의 cited_text, Gemini의 글자 구간 표시로 제각각입니다. 연구에서는 인용이 실제 근거가 아니거나 존재하지 않는 URL인 사례가 적지 않게 확인됐습니다. 도입할 때는 단가보다 프롬프트당 검색 질의 수, 본문 속 오류 코드, URL 실존 검증 세 가지를 먼저 점검해야 비용과 신뢰도를 함께 지킬 수 있습니다.
참고 자료
조사 기준일: 2026년 09월 20일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (확인일 2026-09-20)
– OpenAI Web search 문서: https://developers.openai.com/api/docs/guides/tools-web-search
– OpenAI 가격표: https://developers.openai.com/api/docs/pricing
– Claude Web search tool 문서: https://platform.claude.com/docs/en/agents-and-tools/tool-use/web-search-tool
– Claude 릴리스 노트: https://platform.claude.com/docs/en/release-notes/overview
– Claude 블로그 “Improved Web Search with Dynamic Filtering” (2026-02-17): https://claude.com/blog/improved-web-search-with-dynamic-filtering
– Gemini Grounding with Google Search 문서: https://ai.google.dev/gemini-api/docs/google-search
– Gemini 가격표: https://ai.google.dev/gemini-api/docs/pricing
– Self-RAG: https://arxiv.org/abs/2310.11511
– OpenAI “New tools for building agents”: https://openai.com/index/new-tools-for-building-agents/
Tier 2 (확인일 2026-09-20)
– CJR Tow Center: https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
– EBU News Integrity in AI Assistants: https://www.ebu.ch/research/open/report/news-integrity-in-ai-assistants
– Dataconomy 보도: https://dataconomy.com/2026/04/06/ebu-and-bbc-study-finds-ai-assistants-often-misreport-news/
– Wallat 외 “Correctness is not Faithfulness in RAG Attributions”: https://arxiv.org/abs/2412.18004
– Rao 외 “Detecting and Correcting Reference Hallucinations…”: https://arxiv.org/abs/2604.03173
– The Decoder (2025-03-11): https://the-decoder.com/openai-launches-new-tools-for-building-ai-agents/
답글 남기기