
LFM2.5-VL-3B-DSpark는 배치 1과 greedy 조건에서 디코드가 최대 3.13배 빨라지지만, 종단간 기준으로는 1.30~2.62배입니다. H100, M5 Max, M3 Ultra 환경의 속도 차이와 배치 크기에 따른 효과 감소, 라이선스 조건을 정리했습니다.
LFM2.5VLDSpark, 무엇을 기준으로 비교해야 할까
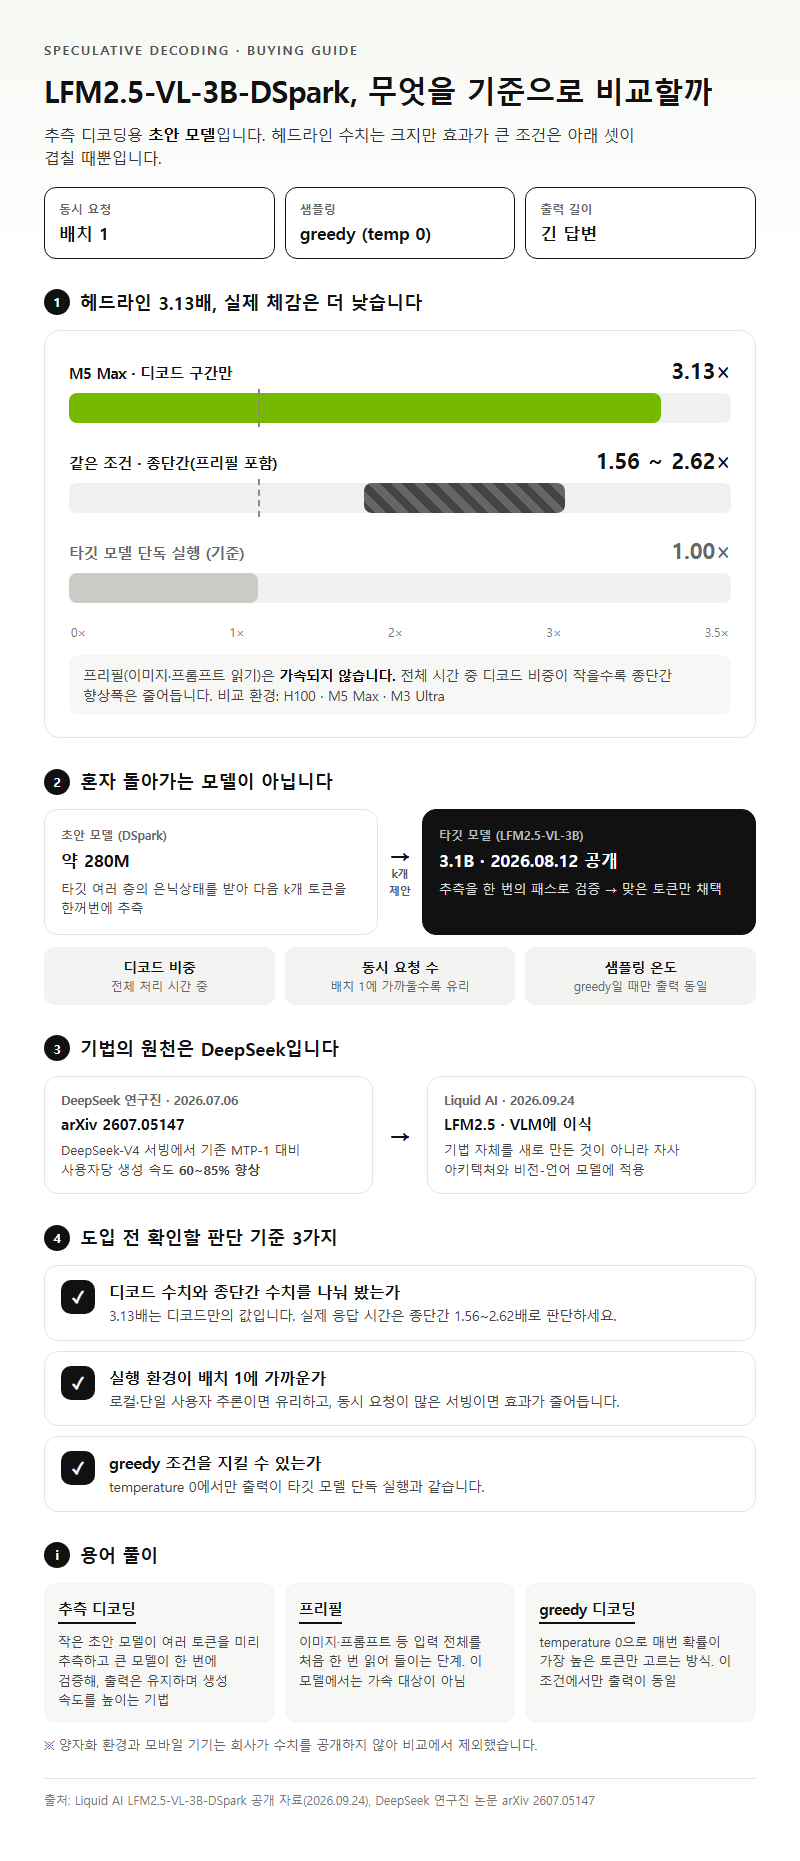
LFM2.5-VL-3B-DSpark는 추측 디코딩용 초안 모델이고, 효과가 큰 조건은 배치 1, greedy, 긴 답변뿐입니다. Liquid AI가 2026년 9월 24일 공개한 수치의 헤드라인은 M5 Max 디코드 3.13배입니다. 그런데 같은 조건에서 종단간 속도 향상은 1.56~2.62배로 줄어듭니다. 이 글에서는 LFM2.5-VL-3B-DSpark의 추론 가속 구조를 살펴보고 H100·M5 Max·M3 Ultra 세 환경의 수치를 비교합니다. 양자화 환경과 모바일 기기는 회사가 수치를 공개하지 않아 다루지 않습니다.
비교 기준부터 정하는 이유는 이 모델이 혼자 돌아가는 모델이 아니기 때문입니다. 2026년 8월 12일 공개된 LFM2.5-VL-3B(3.1B)에 약 280M 파라미터의 초안 모델을 붙이는 구조입니다. 초안 모델은 타깃 모델 여러 층의 은닉상태를 받아 다음 k개 토큰을 한꺼번에 추측하고, 타깃 모델은 이 추측을 한 번의 패스로 검증합니다. 그래서 “몇 배 빨라지나”는 모델 성능만으로 정해지지 않습니다. 디코드가 전체 처리 시간에서 차지하는 비중, 동시 요청 수, 샘플링 온도가 결과를 바꿉니다.
기법 자체는 Liquid AI가 만든 것이 아닙니다. 원천은 DeepSeek 연구진의 논문(arXiv 2607.05147, 2026년 7월 6일 제출)입니다. 이 논문은 DeepSeek-V4 서빙에서 기존 MTP-1보다 사용자당 생성 속도가 60~85% 빨라졌다고 보고했습니다. Liquid AI는 이 기법을 LFM2.5 아키텍처와 VLM에 이식했습니다. 판단 기준은 세 가지입니다. 디코드와 종단간 수치를 나눠 볼 것, 실행 환경이 배치 1에 가까운지 확인할 것, greedy 조건을 지킬 수 있는지 따질 것.
용어 풀이
1. 추측 디코딩 — 작은 초안 모델이 여러 토큰을 미리 추측하고 큰 모델이 한 번에 검증해, 출력은 유지하면서 생성 속도를 높이는 기법입니다.
2. 프리필 — 이미지와 프롬프트 같은 입력 전체를 모델이 처음 한 번 읽어 들이는 단계로, 이 모델에서는 가속 대상이 아닙니다.
3. greedy 디코딩 — temperature 0으로 매번 확률이 가장 높은 토큰만 고르는 방식으로, 이 조건에서만 출력이 타깃 모델 단독 실행과 같습니다.
비교 기준 정리
LFM2.5-VL-3B-DSpark 수치는 아래 기준과 하나씩 대조하며 읽어야 합니다. 회사가 공개한 측정 조건은 FP16, 배치 1, temperature 0입니다. 최대 출력은 2,048토큰, 답변 길이 중앙값은 90토큰이었습니다. 과제는 MMSpec 기반 6종(General VQA, Text VQA, 캡셔닝, Chart VQA, 복합 추론, 멀티턴 대화)입니다. 조건이 하나만 달라도 수치를 그대로 옮겨 쓸 수 없습니다.
| 비교 항목 | 기준·단위 | 공개 조건 | 주의점 |
|---|---|---|---|
| 디코드 속도 향상 | 배수(×) | 배치 1, greedy | 헤드라인 수치(최대 3.13배)가 이 값 |
| 종단간 속도 향상 | 배수(×) | 같은 조건 | 비전 인코딩·프리필 포함, 체감에 더 가까운 값 |
| 수락 길이 | 검증 1회당 수락 토큰 수 | temperature 0 | 3.24~4.57개, 온도를 올리면 낮아짐 |
| 배치 크기 | 동시 요청 수 | 공식 수치는 배치 1만 | 서빙 환경에서는 효과가 빠르게 줄어듦 |
| 정밀도 | FP16/BF16 | 16비트만 측정 | Q4 등 양자화 효과는 공개되지 않음 |
| 추가 파라미터 | M 단위 | 279.5M(BF16) | 배포 모델 전체 파라미터 8.9% 증가 |
| 라이선스 | 상업 이용 조건 | LFM Open License v1.0 | 연매출 1,000만 달러 이상 기업은 제한 |
가장 흔한 오독은 디코드 수치를 체감 속도로 받아들이는 것입니다. Liquid AI도 가속되는 것은 디코드 단계뿐이라고 직접 밝혔습니다. 비전 인코딩과 프리필은 그대로이니 전체 속도 향상은 암달의 법칙에 묶입니다. 공개 수치를 암달의 법칙으로 역산하면, M5 Max에서 기존 처리 시간 중 디코드 비중은 TextVQA가 약 57%, COCO 캡셔닝이 약 90%입니다. 답변이 짧고 입력 처리가 무거운 과제라면 디코드를 아무리 줄여도 전체 시간은 크게 줄지 않습니다.
구조 사양도 비교 기준에 들어갑니다. 초안 모델은 어텐션 층 4개, 블록 크기 9로 구성됩니다. 파라미터는 디코더 193.0M, 은닉상태 투영 21.0M, Markov head 65.5M입니다. 모델카드 기준 hidden은 2048, GQA는 32/8 헤드, 어휘는 128,000이며 Markov head(rank 256)와 confidence head가 들어갑니다. 블록 크기는 학습 때 9로 고정이지만, 추론 때는 하드웨어에 따라 8 또는 9를 씁니다.
용어 풀이
1. 수락 길이 — 초안 모델이 추측한 토큰 가운데 타깃 모델이 검증 한 번에 받아들인 개수로, 클수록 가속 효과가 큽니다.
2. 암달의 법칙 — 전체 작업 중 일부만 빨라지면 전체 속도 향상은 빨라지지 않은 나머지 부분의 비중에 제한된다는 원리입니다.
옵션·유형별 비교
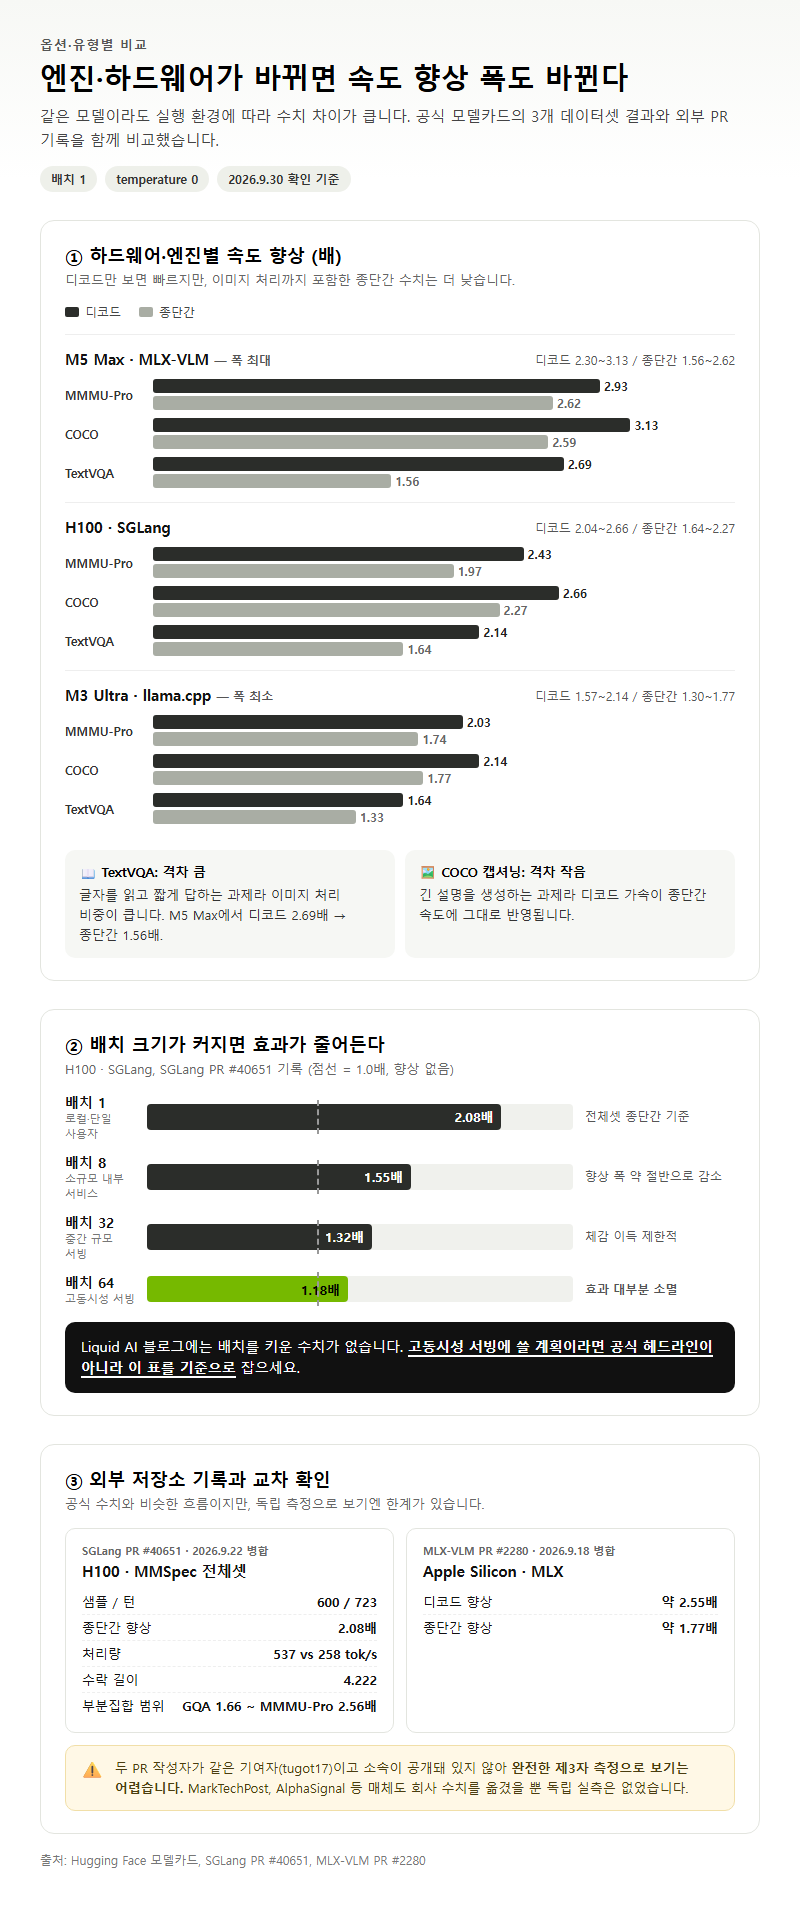
같은 모델이라도 실행 엔진과 하드웨어가 바뀌면 수치 차이가 큽니다. 아래 표는 Hugging Face 모델카드에 실린 3개 데이터셋 결과로, 조건은 모두 배치 1, temperature 0입니다(2026년 9월 30일 확인 기준).
| 하드웨어·엔진 | MMMU-Pro (디코드/종단간) | COCO (디코드/종단간) | TextVQA (디코드/종단간) | 공식 범위 (디코드 / 종단간) |
|---|---|---|---|---|
| H100 · SGLang | 2.43 / 1.97배 | 2.66 / 2.27배 | 2.14 / 1.64배 | 2.04~2.66 / 1.64~2.27배 |
| M5 Max · MLX-VLM | 2.93 / 2.62배 | 3.13 / 2.59배 | 2.69 / 1.56배 | 2.30~3.13 / 1.56~2.62배 |
| M3 Ultra · llama.cpp | 2.03 / 1.74배 | 2.14 / 1.77배 | 1.64 / 1.33배 | 1.57~2.14 / 1.30~1.77배 |
TextVQA 행을 보면 M5 Max에서 디코드는 2.69배인데 종단간은 1.56배에 그칩니다. 글자를 읽고 짧게 답하는 과제라 이미지 처리 비중이 크기 때문입니다. 긴 설명을 생성하는 COCO 캡셔닝은 반대로 디코드와 종단간 격차가 작습니다. 하드웨어별로는 Apple Silicon M5 Max와 MLX 조합의 폭이 가장 컸고, M3 Ultra와 llama.cpp 조합이 가장 작았습니다.
외부 저장소 기록과도 맞춰봤습니다. SGLang PR #40651(2026년 9월 22일 병합)은 H100에서 MMSpec 전체 테스트셋(600샘플/723턴)을 돌려 종단간 2.08배(537 vs 258 tok/s), 수락 길이 4.222를 보고했습니다. 부분집합별로는 GQA 1.66배부터 MMMU-Pro 2.56배까지 벌어졌습니다. MLX-VLM PR #2280(2026년 9월 18일 병합)의 결과는 디코드 약 2.55배, 종단간 약 1.77배였습니다. 다만 두 PR의 작성자가 같은 기여자(tugot17)이고 소속이 공개돼 있지 않아 완전한 제3자 측정으로 보기는 어렵습니다. MarkTechPost, AlphaSignal 같은 매체도 회사 수치를 옮겼을 뿐 독립 실측은 내지 않았습니다.
서빙 환경에 가장 직결되는 값은 배치 크기에 따른 변화입니다. 같은 SGLang PR에 이렇게 기록돼 있습니다.
| 배치 크기 | 속도 향상 (H100 · SGLang) | 해석 |
|---|---|---|
| 1 | 2.08배 (전체셋 종단간) | 로컬·단일 사용자 환경 |
| 8 | 1.55배 | 소규모 내부 서비스 |
| 32 | 1.32배 | 중간 규모 서빙 |
| 64 | 1.18배 | 고동시성 서빙, 효과 대부분 소멸 |
Liquid AI 블로그에는 배치를 키운 수치가 없습니다. 고동시성 서빙에 쓸 계획이라면 공식 헤드라인 말고 이 표를 기준으로 잡으세요.
상황별 추천
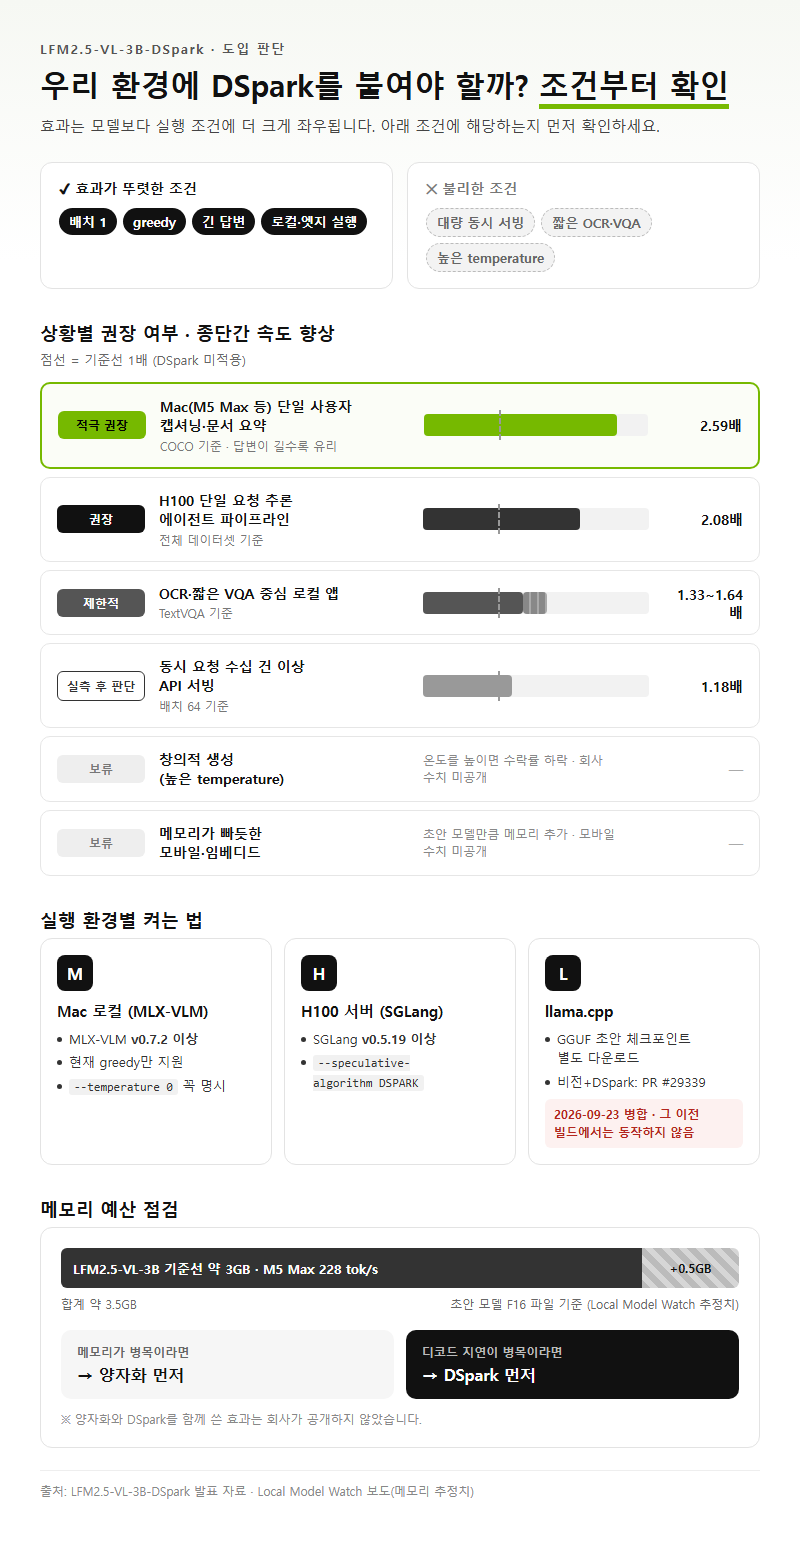
LFM2.5-VL-3B-DSpark를 붙일지는 실행 환경 조건을 보고 정하면 됩니다. 효과가 뚜렷한 조건은 배치 1, greedy, 긴 답변, 로컬 또는 엣지 실행입니다. 대량 동시 서빙, 짧은 답변 위주의 OCR·VQA, 높은 temperature에서는 불리합니다. 사용 목적별로 나누면 다음과 같습니다.
| 상황 | 권장 여부 | 근거 |
|---|---|---|
| Mac(M5 Max 등)에서 단일 사용자 캡셔닝·문서 요약 | 적극 권장 | COCO 종단간 2.59배, 긴 답변일수록 유리 |
| H100 단일 요청 추론·에이전트 파이프라인 | 권장 | 전체셋 종단간 2.08배 |
| OCR·짧은 VQA 중심 로컬 앱 | 제한적 | TextVQA 종단간 1.33~1.64배 |
| 동시 요청 수십 건 이상 API 서빙 | 실측 후 판단 | 배치 64에서 1.18배 |
| 창의적 생성(높은 temperature) | 보류 | 온도를 높이면 수락률이 떨어지며, 회사는 수치를 공개하지 않음 |
| 메모리가 빠듯한 모바일·임베디드 | 보류 | 초안 모델 추가 부담, 모바일 수치 미공개 |
Mac 로컬 사용자는 MLX-VLM v0.7.2 이상이 필요합니다. MLX-VLM은 현재 greedy만 지원하니 --temperature 0을 꼭 명시해야 합니다. H100 서버 운영자는 SGLang v0.5.19 이상에서 --speculative-algorithm DSPARK 옵션으로 켜면 됩니다. llama.cpp 사용자는 GGUF 초안 체크포인트를 따로 받아야 합니다. 비전 타깃과 DSpark를 함께 쓰는 기능(PR #29339)은 발표 하루 전인 2026년 9월 23일에 병합됐으므로 그 이전 빌드에서는 동작하지 않습니다.
메모리 예산도 따져봐야 합니다. 기준선인 LFM2.5-VL-3B는 약 3GB 메모리로 M5 Max에서 228 tok/s가 나옵니다. 여기에 초안 모델을 붙이면 F16 파일 기준 약 0.5GB가 늘어나는데, Local Model Watch 보도에 실린 추정치입니다. 메모리가 병목이면 양자화부터, 디코드 지연이 병목이면 DSpark부터 검토하는 게 순서입니다. 두 방식을 함께 썼을 때의 효과는 회사가 공개하지 않았습니다.
자주 하는 실수
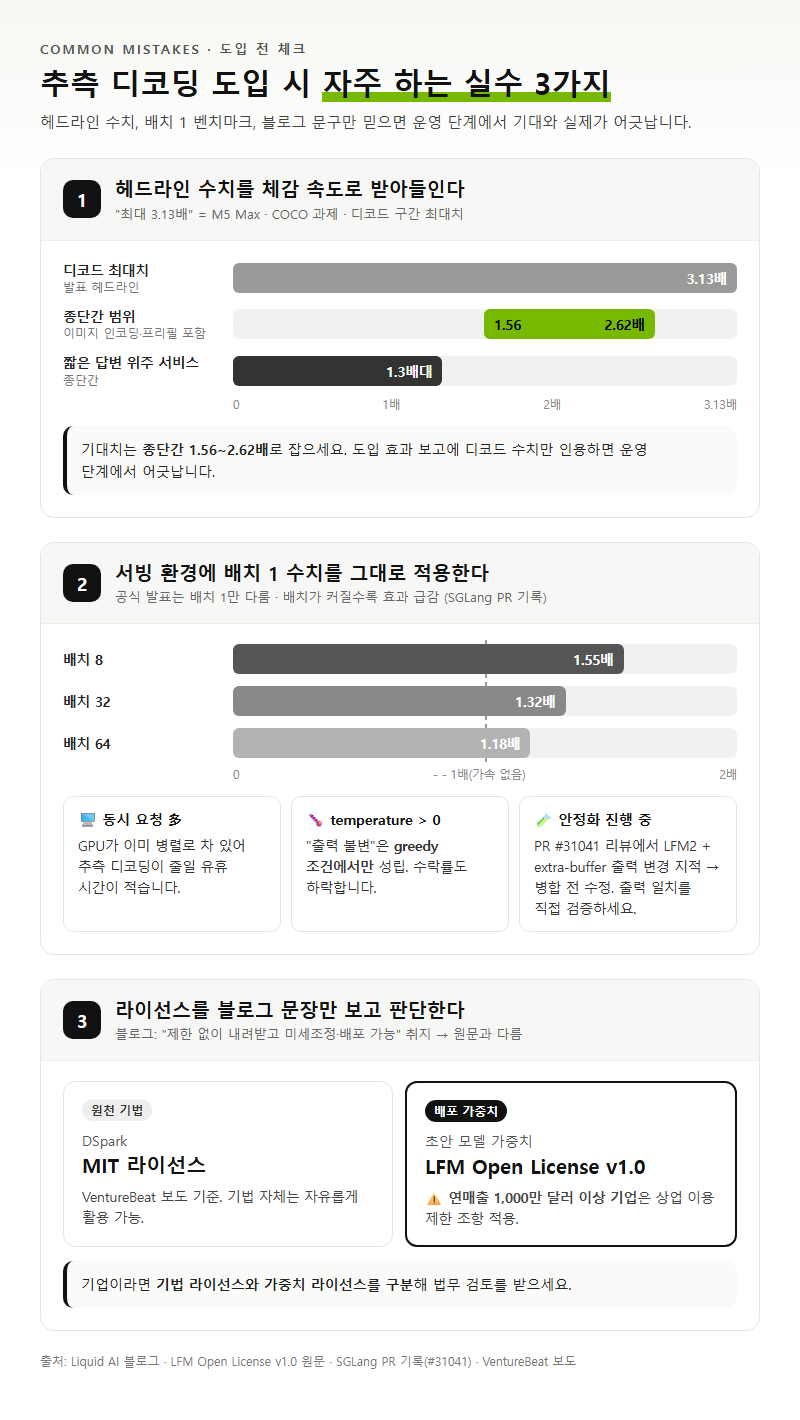
첫째, 헤드라인 수치를 체감 속도로 받아들이는 실수입니다. “최대 3.13배”는 M5 Max에서 COCO 과제를 돌린 디코드 최대치입니다. 사용자가 느끼는 응답 시간에는 이미지 인코딩과 프리필이 포함되므로, 기대치는 같은 환경의 종단간 범위인 1.56~2.62배로 잡아야 합니다. 짧은 답변 위주의 서비스라면 종단간 1.3배대까지 떨어질 수 있습니다. 도입 효과를 보고하면서 디코드 수치만 인용하면 운영 단계에서 기대와 실제가 어긋납니다.
둘째, 서빙 환경에 배치 1 수치를 그대로 적용하는 실수입니다. 공식 발표는 배치 1만 다룹니다. SGLang PR 기록에서는 배치 8에서 1.55배, 32에서 1.32배, 64에서 1.18배로 효과가 빠르게 줄어듭니다. 동시 요청이 많은 API 서버는 GPU가 이미 병렬로 채워져 있어서 추측 디코딩이 줄여줄 유휴 시간이 적습니다. temperature를 0보다 높이면 출력이 타깃 모델 단독 실행과 완전히 같다는 전제가 깨지고 수락률도 떨어집니다. 회사가 밝힌 “출력 불변”은 greedy 조건에서만 성립합니다. 안정성 문제도 있었습니다. SGLang 텍스트용 PR #31041 리뷰에서 LFM2 계열을 extra-buffer 전략에 넣으면 출력이 바뀐다는 지적이 나왔고, 병합 전에 수정됐습니다. 아직 안정화 중인 기능이니 도입 전에 출력이 일치하는지 직접 검증하는 편이 안전합니다.
셋째, 라이선스를 블로그 문장만 보고 판단하는 실수입니다. Liquid AI 블로그는 제한 없이 내려받고 미세조정하고 배포할 수 있다는 취지로 소개합니다. 하지만 LICENSE 원문인 LFM Open License v1.0에는 연매출 1,000만 달러 이상 기업의 상업 이용 제한 조항이 있습니다. 원천 기법인 DSpark는 VentureBeat 보도 기준 MIT 라이선스지만, 배포되는 초안 모델 가중치에는 LFM 라이선스가 적용됩니다. 기업이라면 기법 라이선스와 가중치 라이선스를 구분해서 법무 검토를 받아야 합니다.
정리
LFM2.5-VL-3B-DSpark는 약 280M 파라미터의 초안 모델을 기존 3.1B VLM에 붙여 디코드 단계만 가속합니다. 공식 수치로는 디코드 1.57~3.13배, 종단간 1.30~2.62배입니다. 답변이 길수록 효과가 크고, 동시 요청이 많을수록 줄어듭니다. 양자화, 높은 temperature, 모바일 환경에서의 효과는 회사가 아직 공개하지 않았습니다.
한 줄로 정리하면, 배치 1·greedy·긴 답변 조건의 로컬 추론이라면 붙이고, 고동시성 서빙이라면 배치별 실측 후 결정하면 됩니다.
참고 자료 (2026년 9월 30일 확인)
– Liquid AI 블로그: https://www.liquid.ai/blog/lfm2-5-vl-dspark
– Hugging Face 모델카드: https://huggingface.co/LiquidAI/LFM2.5-VL-3B-DSpark
– LFM Open License v1.0: https://huggingface.co/LiquidAI/LFM2.5-VL-3B-DSpark/blob/main/LICENSE
– DSpark 원 논문: https://arxiv.org/abs/2607.05147
– SGLang PR #40651: https://github.com/sgl-project/sglang/pull/40651
– MLX-VLM PR #2280: https://github.com/Blaizzy/mlx-vlm/pull/2280
– llama.cpp PR #29339: https://github.com/ggml-org/llama.cpp/pull/29339
– MMSpec 논문: https://arxiv.org/abs/2603.14989
– VentureBeat 2026년 6월 29일 보도 (보도 인용): https://venturebeat.com/orchestration/deepseek-open-sources-dspark-a-new-framework-to-speed-up-llm-inference-by-up-to-85
참고 자료
조사 기준일: 2026년 09월 30일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (확인일 2026-09-30)
– https://www.liquid.ai/blog/lfm2-5-vl-dspark
– https://huggingface.co/LiquidAI/LFM2.5-VL-3B-DSpark
– https://huggingface.co/LiquidAI/LFM2.5-VL-3B-DSpark/blob/main/LICENSE
– https://huggingface.co/blog/LiquidAI/lfm2-5-vl-dspark
– https://www.liquid.ai/blog/lfm2.5-dspark
– https://www.liquid.ai/blog/lfm2-5-vl-3b
– https://arxiv.org/abs/2607.05147
Tier 2 (확인일 2026-09-30)
– https://github.com/sgl-project/sglang/pull/40651
– https://github.com/sgl-project/sglang/pull/31041
– https://github.com/Blaizzy/mlx-vlm/pull/2280
– https://github.com/ggml-org/llama.cpp/pull/29339
– https://arxiv.org/abs/2603.14989
– https://www.marktechpost.com/2026/09/25/liquid-ai-releases-lfm2-5-vl-3b-dspark-speculative-decoding-for-vision-language-models-with-up-to-3-13x-faster-decoding/
– https://alphasignal.ai/news/liquid-ai-s-lfm2-5-vl-dspark-makes-vision-ai-3-13x-faster-on-apple-silicon
– https://venturebeat.com/orchestration/deepseek-open-sources-dspark-a-new-framework-to-speed-up-llm-inference-by-up-to-85
– https://localmodelwatch.tsuchitsuchi.com/en/2026/09/25/liquidai-lfm2-5-vl-dspark-released/
답글 남기기