
MuJoCo Warp는 지연 시간이 아니라 처리량에 맞춘 GPU 병렬 로봇 시뮬레이터입니다. nworld·nconmax 메모리 구조, MJX 대비 475배 주장과 독립 벤치마크 결과, 도입 시 주의점을 2026년 9월 기준으로 정리했습니다.
MJWarp 핵심만 먼저 정리하면
MuJoCo Warp(MJWarp)는 스텝 하나를 빨리 계산하는 엔진이 아니라, 독립된 세계 수십만 개를 한꺼번에 돌리는 처리량 엔진입니다. 로봇 한 대를 실시간으로 제어한다면 CPU MuJoCo가 낫고, 강화학습처럼 병렬 환경을 대량으로 돌릴 때 MuJoCo Warp가 제 역할을 합니다. 독립 벤치마크(GPUSimBench, RTX 5070 12GB)에서는 Franka 장면에서 MJX 대비 약 1.86배, 자유낙하 장면에서 약 31.1배 빨랐습니다. NVIDIA가 발표한 475배와는 거리가 큽니다. 이 글에서는 MuJoCo Warp의 병렬화 구조와 메모리 설정, 발표 수치와 독립 측정 사이의 간극, 도입할 때 걸리는 제약을 2026년 9월 29일 기준으로 다룹니다. 미분 가능 시뮬레이션과 렌더러 성능은 공개된 독립 측정이 없어 자세히 다루지 않습니다.
MuJoCo Warp는 NVIDIA와 Google DeepMind가 함께 개발하고 Newton 프로젝트의 일부로 관리하는 오픈소스(Apache 2.0)입니다. 첫 공개는 2025년 3월 18일 GTC 2025였고, 최신 버전은 3.14.0(2026년 9월 22일 배포)입니다. PyPI의 개발 상태 표기는 아직 “3 – Alpha”입니다.
Q1. MuJoCo Warp는 어떤 구조로 수십만 개 환경을 GPU에서 동시에 돌리나요?
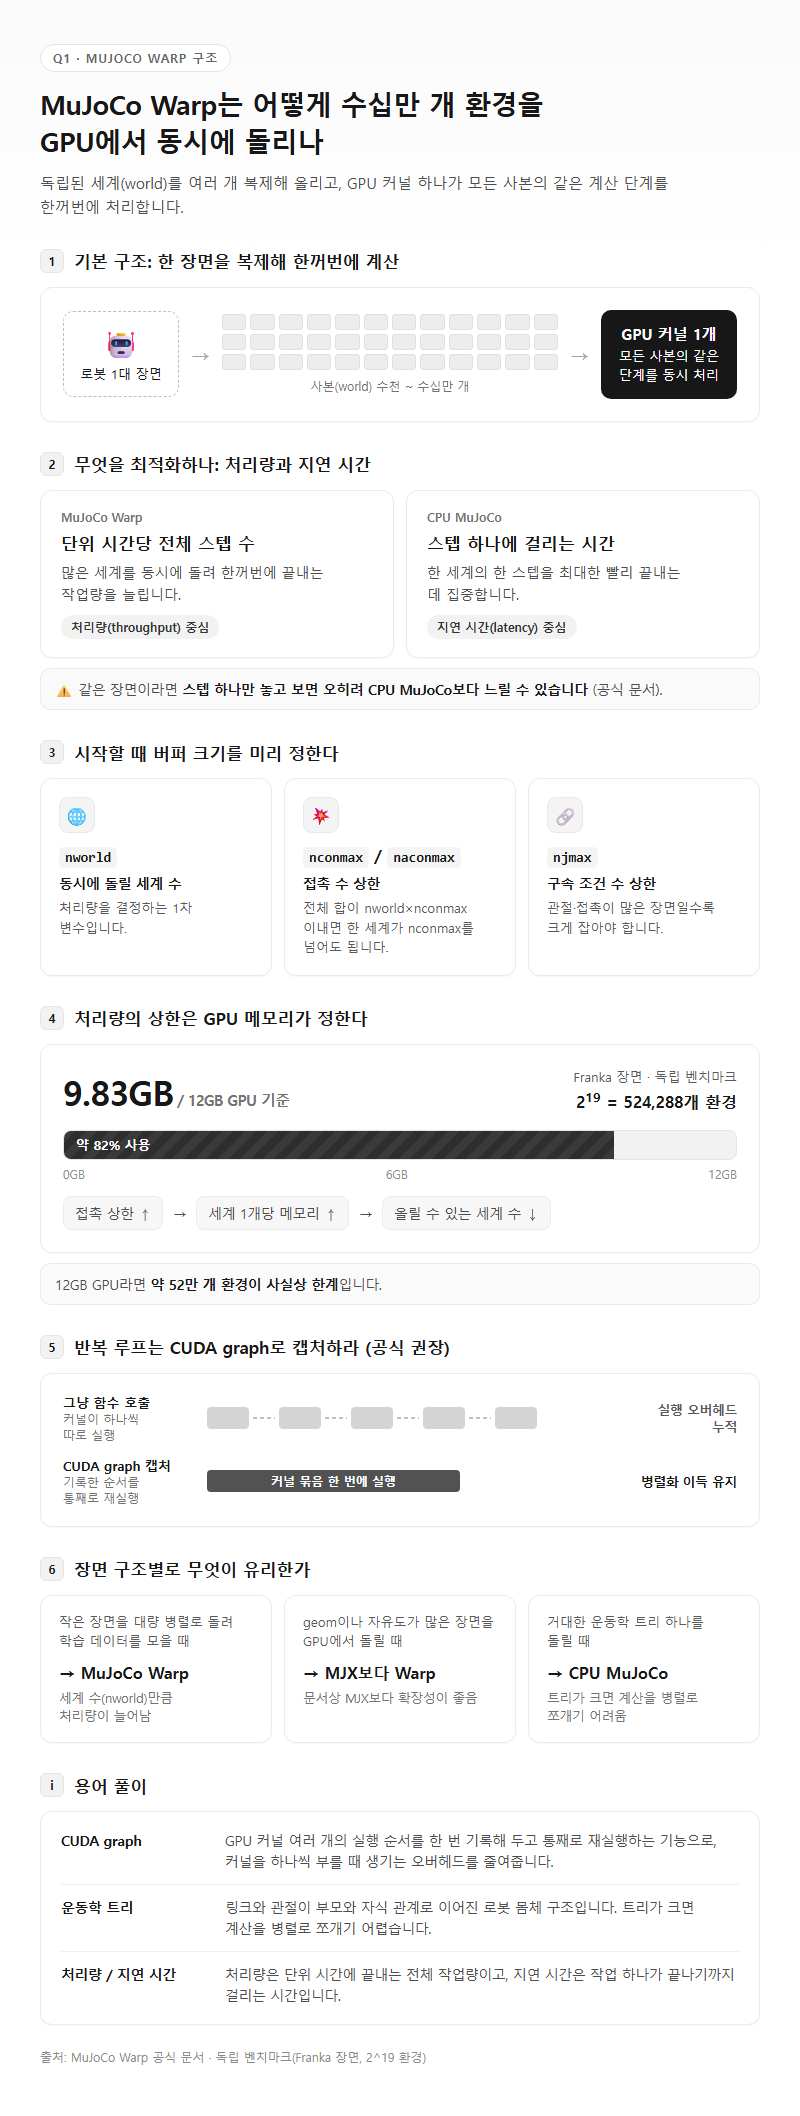
여러 개의 독립된 세계(world)를 한 번에 올려 병렬로 계산하는 구조입니다. 로봇 한 대가 있는 장면을 복제해 수천에서 수십만 개의 사본을 만들고, GPU 커널 하나가 사본 전체의 같은 계산 단계를 한꺼번에 처리합니다. 공식 문서도 설계 목표를 구분해 둡니다. MuJoCo Warp는 단위 시간당 전체 스텝 수를, CPU MuJoCo는 스텝 하나에 걸리는 시간을 최적화합니다. 그래서 같은 장면이라면 스텝 하나는 오히려 CPU MuJoCo보다 느릴 수 있다고 문서에 적혀 있습니다.
GPU는 실행 중에 메모리를 늘리기 어렵습니다. 시작할 때 버퍼 크기를 미리 정해야 하고, 이때 쓰는 파라미터는 다음과 같습니다.
| 파라미터 | 의미 | 설정 시 유의점 |
|---|---|---|
nworld |
동시에 돌릴 세계(환경) 수 | 처리량을 결정하는 1차 변수 |
nconmax / naconmax |
접촉 수 상한 | 전체 합이 nworld×nconmax 이내면 한 세계가 nconmax를 넘어도 됨 |
njmax |
구속 조건 수 상한 | 관절·접촉이 많은 장면일수록 크게 잡아야 함 |
결국 처리량의 상한은 GPU 메모리가 정합니다. 접촉 상한을 넉넉하게 잡으면 한 번에 올릴 수 있는 세계 수가 줄어듭니다. 독립 벤치마크에서 MuJoCo Warp가 Franka 장면으로 2^19(524,288)개 환경을 돌렸을 때 메모리는 9.83GB였습니다. 12GB GPU라면 사실상 이 정도가 한계입니다.
실행 방식도 알아둘 점이 있습니다. 함수를 그냥 호출하면 커널이 하나씩 따로 실행되므로, 공식 문서는 반복 루프를 CUDA graph로 캡처하라고 권장합니다. 이 과정을 빼면 커널 실행 오버헤드 탓에 병렬화 이득이 크게 줄어듭니다.
확장성에는 조건이 붙습니다. 문서에는 “MJWarp scales better than MJX for scenes with many geoms or degrees of freedom, but not as well as MuJoCo for single large kinematic trees.”라고 적혀 있습니다. geom이나 자유도가 많은 장면에서는 MJX보다 확장성이 좋지만, 거대한 운동학 트리 하나를 돌릴 때는 CPU MuJoCo가 낫다는 얘기입니다.
용어 풀이
1. CUDA graph — GPU 커널 여러 개의 실행 순서를 한 번 기록해 두고 통째로 재실행하는 기능으로, 커널을 하나씩 부를 때 생기는 오버헤드를 줄여줍니다.
2. 운동학 트리(kinematic tree) — 링크와 관절이 부모와 자식 관계로 이어진 로봇 몸체 구조를 말합니다. 트리가 크면 계산을 병렬로 쪼개기 어렵습니다.
3. 처리량(throughput)과 지연 시간(latency) — 처리량은 단위 시간에 끝내는 전체 작업량이고, 지연 시간은 작업 하나가 끝나기까지 걸리는 시간입니다.
Q2. MJX보다 475배 빠르다는 NVIDIA 발표, 실제로도 그만큼 나오나요?
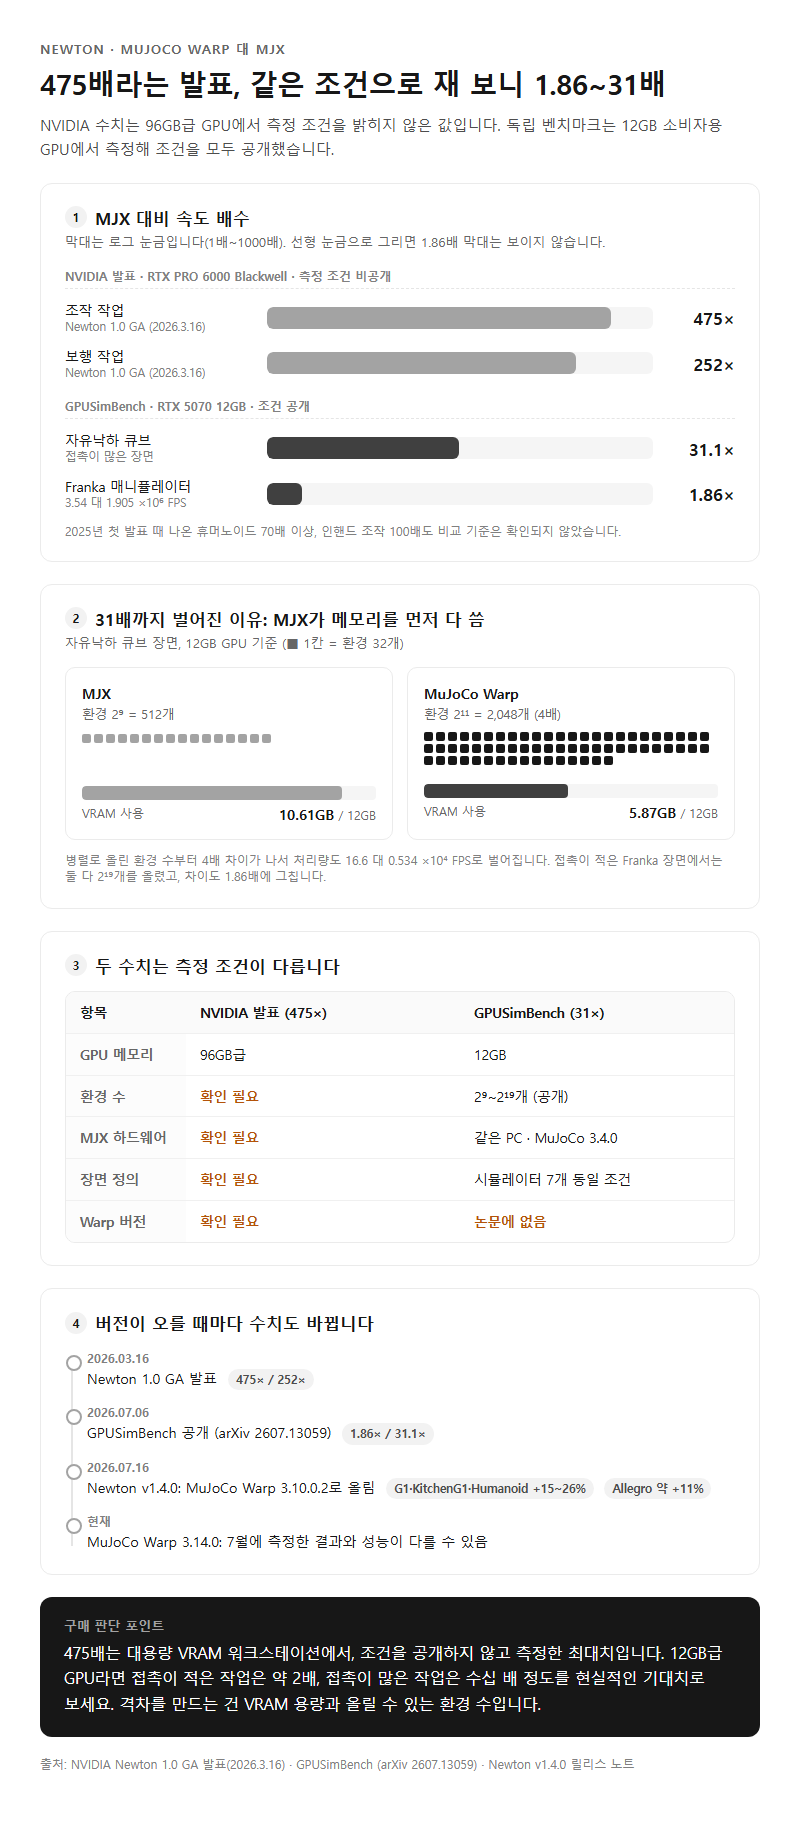
조건이 맞아야만 나오는 수치입니다. NVIDIA는 2026년 3월 16일 Newton 1.0 GA를 발표하면서 RTX PRO 6000 Blackwell 기준으로 조작 작업 475배, 보행 작업 252배라고 밝혔습니다. 하지만 발표문에는 환경 수, MJX 쪽 하드웨어, 장면 정의가 빠져 있어 측정 조건은 확인 필요 상태입니다. 2025년 첫 발표 때 내놓은 휴머노이드 70배 이상, 인핸드 조작 100배도 비교 기준을 확인하지 못했습니다.
독립 연구진이 2026년 7월 6일 공개한 GPUSimBench(arXiv 2607.13059)는 시뮬레이터 7개를 같은 조건에서 비교했습니다. 측정 환경은 RTX 5070 12GB, i5-13400F, RAM 32GB이고, MJX는 MuJoCo 3.4.0을 썼습니다.
| 장면 | MuJoCo Warp | MJX | 처리량 비율 |
|---|---|---|---|
| Franka 매니퓰레이터 | 2^19개 환경, 3.54×10^6 FPS, 9.83GB | 2^19개 환경, 1.905×10^6 FPS | 약 1.86배 |
| 자유낙하 큐브 | 2^11개 환경, 16.6×10^4 FPS, 5.87GB | 2^9개 환경, 0.534×10^4 FPS, 10.61GB | 약 31.1배 |
두 결과가 크게 벌어진 이유는 접촉이 많은 장면에서 MJX가 메모리를 먼저 소진하기 때문입니다. 자유낙하 장면에서 MJX는 환경을 2^9개밖에 올리지 못하고도 메모리를 10.61GB 썼습니다. MuJoCo Warp는 그 4배인 2^11개를 5.87GB로 돌렸습니다. 병렬 수부터 다르니 처리량 격차도 커집니다.
475배와 31배의 차이는 GPU 메모리 규모(96GB급과 12GB), 장면, MuJoCo Warp 버전이 모두 다른 데서 옵니다. GPUSimBench는 측정에 쓴 MuJoCo Warp 버전을 논문에 밝히지 않았습니다. 2026년 7월 측정이라 현재 3.14.0과는 성능이 다를 수 있습니다. 참고로 Newton v1.4.0(2026년 7월 16일) 릴리스 노트에 따르면, MuJoCo Warp를 3.10.0.2로 올린 뒤 G1·KitchenG1·Humanoid 워크로드가 15-26%, Allegro가 약 11% 빨라졌습니다. 버전마다 수치가 계속 움직이고 있습니다.
Q3. CPU MuJoCo, MJX, Isaac Lab과 비교하면 언제 MuJoCo Warp를 골라야 하나요?
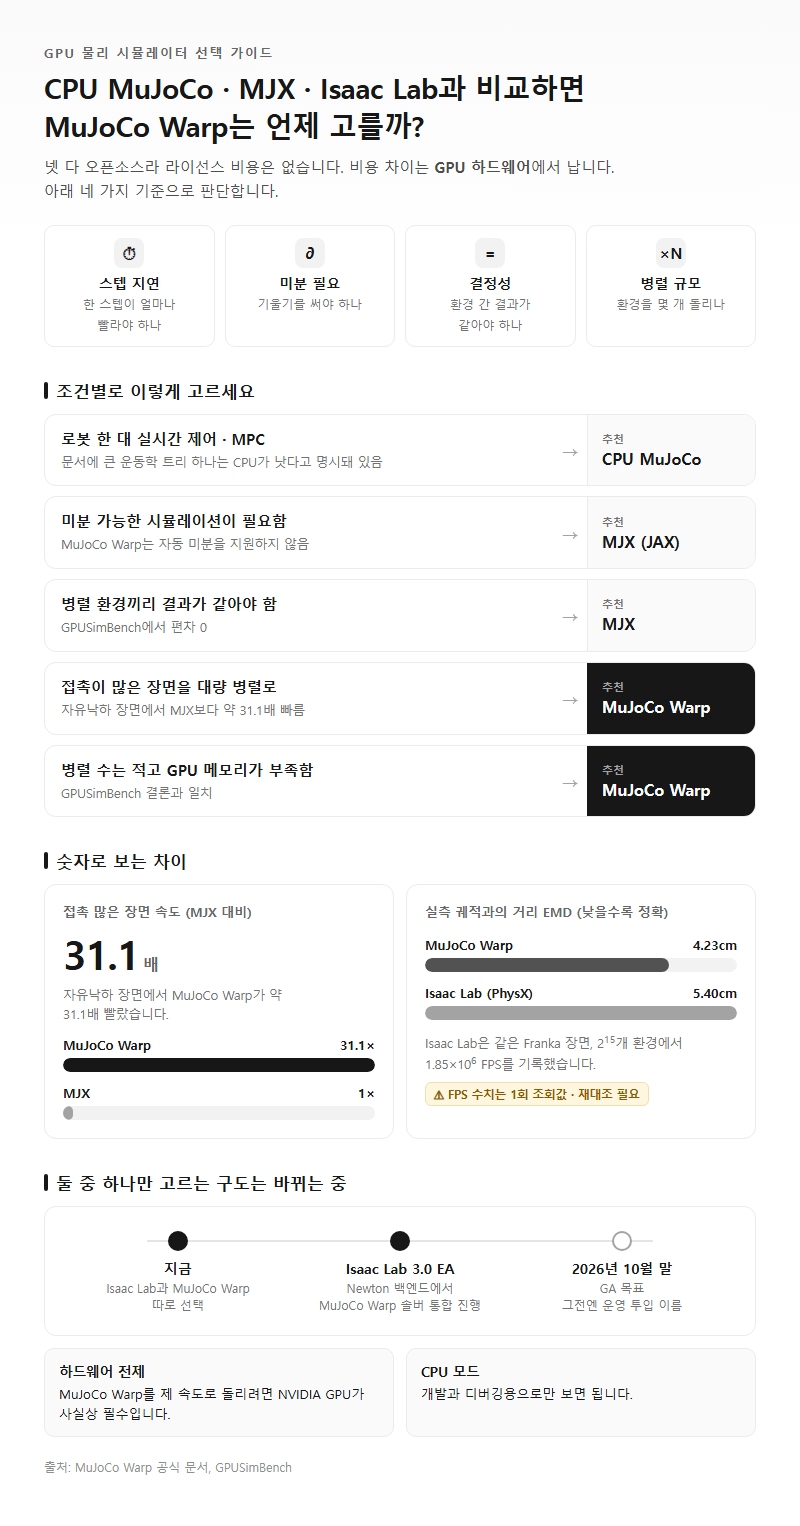
한 스텝의 지연, 미분 필요 여부, 결정성, 병렬 규모 네 가지로 판단합니다. 넷 다 오픈소스라 라이선스 비용은 따질 필요가 없고, 비용 차이는 GPU 하드웨어에서 납니다.
| 조건 | 적합한 선택 | 근거 |
|---|---|---|
| 로봇 한 대 실시간 제어, MPC | CPU MuJoCo | 문서가 큰 운동학 트리 하나는 CPU가 낫다고 명시 |
| 미분 가능 시뮬레이션 필요 | MJX(JAX) | MuJoCo Warp는 자동 미분 미지원 |
| 병렬 환경 간 결정성 필요 | MJX | GPUSimBench에서 편차 0 |
| 접촉 많은 장면 대량 병렬 | MuJoCo Warp | 자유낙하 장면에서 MJX 대비 약 31.1배 |
| 적은 병렬 수, GPU 메모리 부족 | MuJoCo Warp | GPUSimBench 결론과 일치 |
GPUSimBench의 결론도 같은 방향입니다. 원문은 “If GPU memory is the primary bottleneck and only a small number of parallel environments is needed, MuJoCo Warp is a practical choice.”로, GPU 메모리가 병목이고 병렬 수가 많지 않을 때 실용적이라고 평가했습니다.
Isaac Lab(PhysX)은 같은 Franka 장면에서 2^15개 환경으로 1.85×10^6 FPS를 기록했습니다. 다만 리서치 과정에서 한 번만 조회한 값이라 재대조가 필요합니다. 실측 궤적과의 거리(EMD)는 Isaac Lab 5.40cm, MuJoCo Warp 4.23cm였습니다.
둘 중 하나를 고르는 구도도 달라지고 있습니다. Isaac Lab 3.0은 Newton 백엔드에서 MuJoCo Warp 솔버를 고를 수 있도록 통합을 진행 중입니다. 아직 Early Access 단계이고 GA 목표가 2026년 10월 말이라 운영 환경에 바로 넣기엔 이릅니다. MuJoCo Warp를 제 속도로 돌리려면 NVIDIA GPU가 사실상 필수이고, CPU 모드는 개발·디버깅용으로 보면 됩니다.
Q4. MuJoCo Warp를 설치하거나 MJX에서 옮겨갈 때 무엇을 확인해야 하나요?
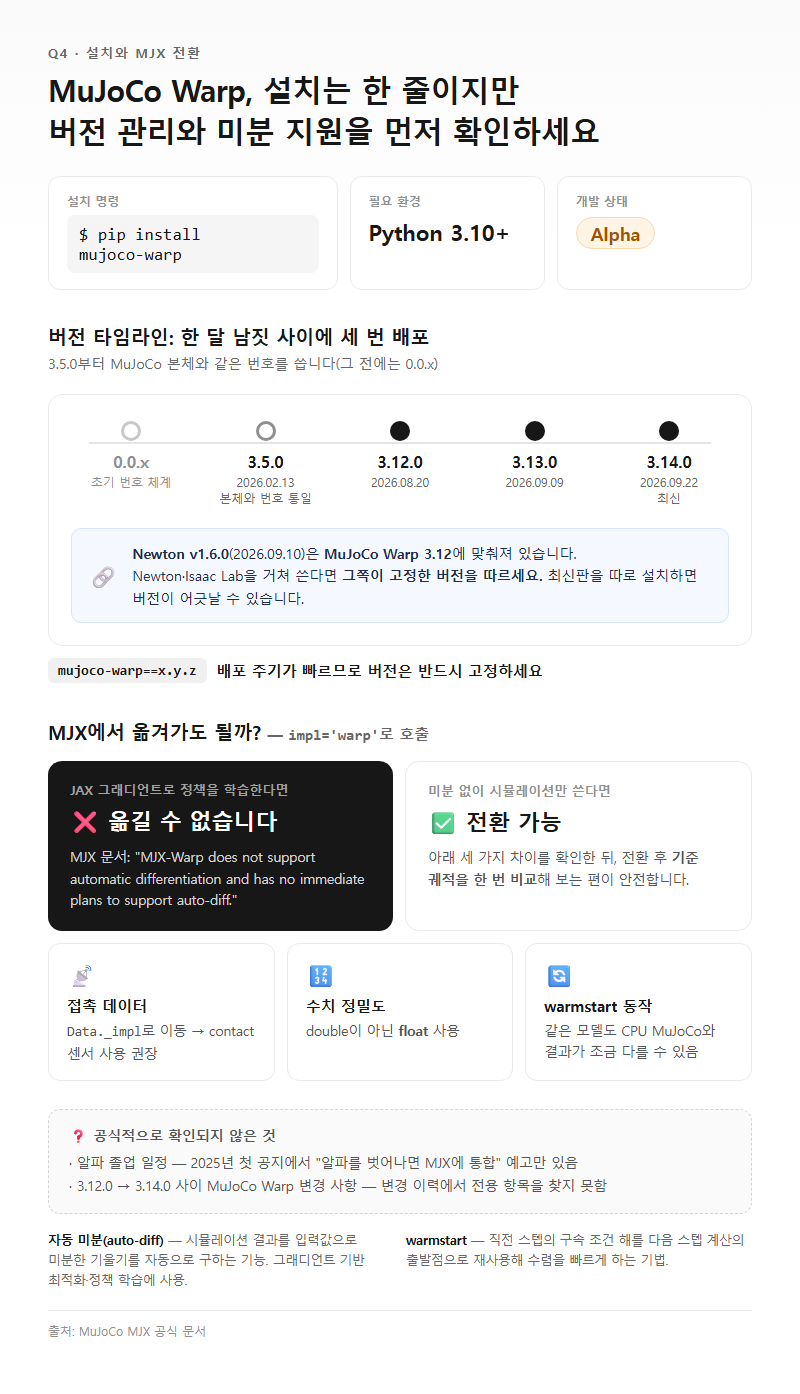
설치 명령은 pip install mujoco-warp이고 Python 3.10 이상이 필요합니다. 정작 신경 쓸 부분은 버전 관리입니다. 2026년 8월 20일 3.12.0, 9월 9일 3.13.0, 9월 22일 3.14.0으로 한 달 남짓한 사이에 세 번 배포됐고, 상태 표기는 아직 Alpha입니다. 버전은 반드시 고정하세요.
| 항목 | 내용 |
|---|---|
| 버전 체계 | 2026년 2월 13일 배포된 3.5.0부터 MuJoCo 본체와 같은 번호 사용(그 전은 0.0.x) |
| 상위 프레임워크 연동 | Newton 최신판 v1.6.0(2026년 9월 10일)은 MuJoCo Warp 3.12에 맞춰져 있음 |
| MJX에서 전환 | impl='warp'로 호출 가능, 단 자동 미분 불가 |
| 접촉 데이터 접근 | Data._impl로 이동했으므로 contact 센서 사용 권장 |
| 수치 정밀도 | double이 아니라 float 사용 |
Newton이나 Isaac Lab을 거쳐 쓴다면 그쪽이 고정한 MuJoCo Warp 버전을 따라가야 합니다. 최신판을 따로 설치하면 상위 프레임워크와 버전이 어긋날 수 있습니다.
MJX에서 옮겨갈 때 가장 큰 걸림돌은 미분입니다. MJX 문서에는 “MJX-Warp does not support automatic differentiation and has no immediate plans to support auto-diff.”라고 명시돼 있습니다. JAX 그래디언트를 정책 학습에 쓰던 파이프라인은 옮길 수 없다는 뜻입니다. float 정밀도와 warmstart 동작 차이 때문에 같은 모델이라도 CPU MuJoCo와 결과값이 조금 다를 수 있습니다. 전환 후에는 기준 궤적을 한 번 비교해 보는 편이 안전합니다.
2025년 첫 공지에서는 알파를 벗어나면 MJX에 통합하겠다고 예고했지만, 알파 졸업 일정은 공식적으로 확인되지 않았습니다. 3.12.0에서 3.14.0 사이에 MuJoCo Warp 쪽 변경 사항도 변경 이력에서 전용 항목을 찾지 못해 확인하지 못했습니다.
용어 풀이
1. 자동 미분(auto-diff) — 시뮬레이션 결과를 입력값으로 미분한 기울기를 자동으로 구해 주는 기능으로, 그래디언트 기반 최적화나 정책 학습에 씁니다.
2. warmstart — 직전 스텝의 구속 조건 해를 다음 스텝 계산의 출발점으로 재사용해 수렴을 빠르게 하는 기법입니다.
Q5. GPU에서 돌리면 결과가 매번 달라진다는데, 재현성이나 미지원 기능은 어느 정도인가요?
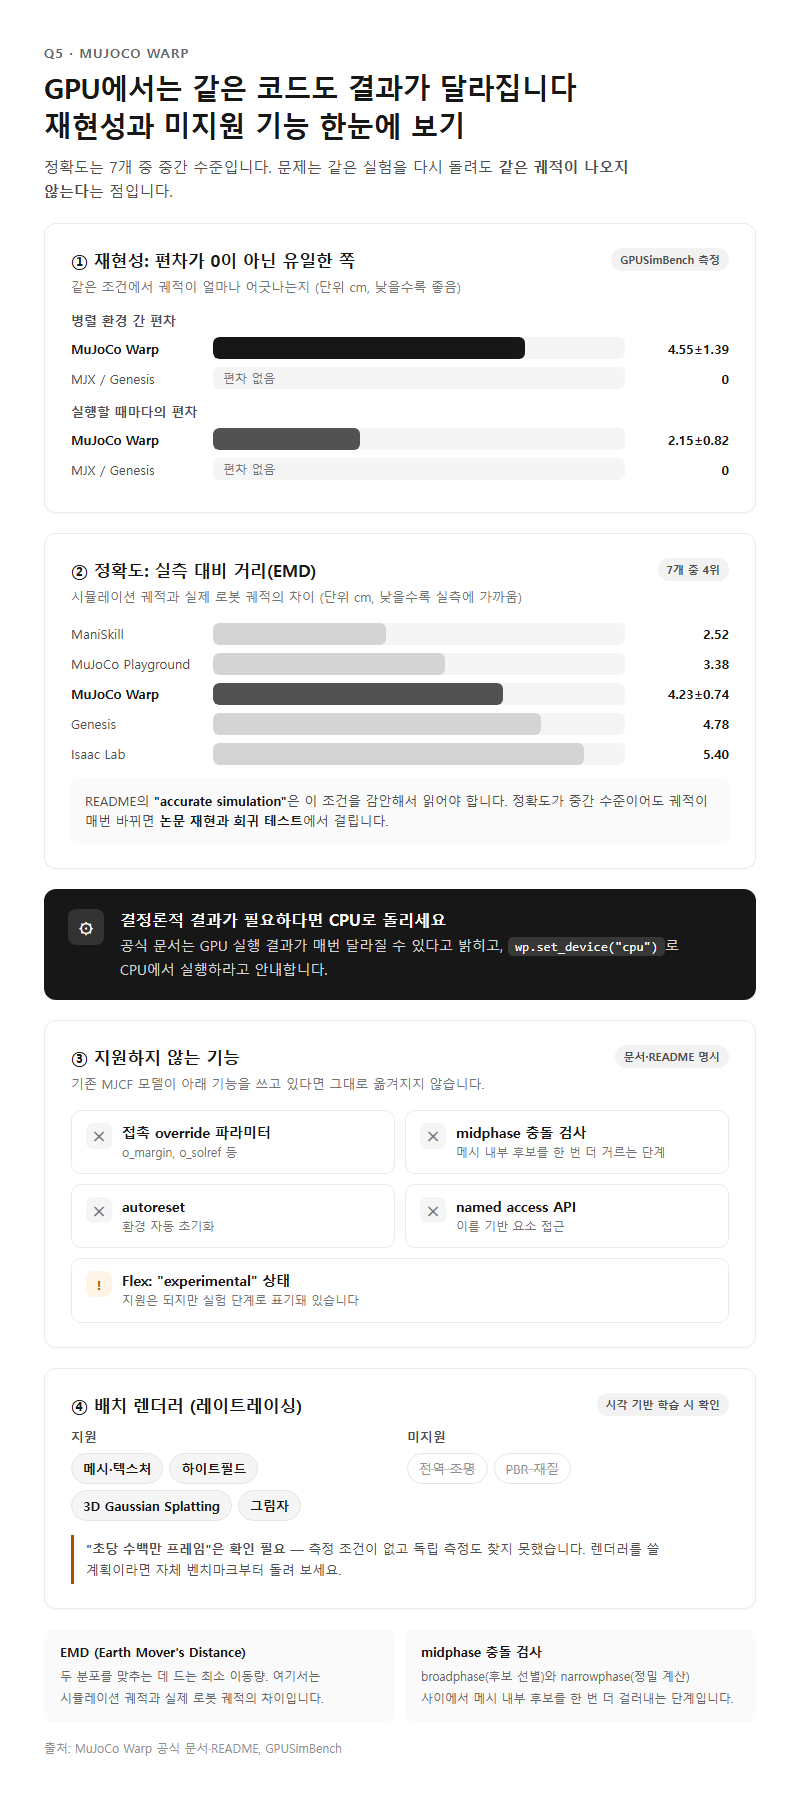
맞습니다. 공식 문서는 GPU에서 같은 코드를 다시 돌려도 결과가 달라질 수 있다고 밝히고, 결정론적 결과가 필요하면 wp.set_device("cpu")로 CPU에서 돌리라고 안내합니다. 이 편차는 GPUSimBench가 실제로 측정했습니다.
| 지표 | MuJoCo Warp | MJX / Genesis |
|---|---|---|
| 병렬 환경 간 편차 | 4.55±1.39cm | 0 |
| 실행할 때마다의 편차 | 2.15±0.82cm | 0 |
| 실측 대비 거리(EMD) | 4.23±0.74cm (7개 중 4위) | Genesis 4.78cm |
EMD만 보면 ManiSkill 2.52cm, MuJoCo Playground 3.38cm보다 크고 Genesis 4.78cm, Isaac Lab 5.40cm보다는 작습니다. 정확도는 중간 수준입니다. 문제는 같은 실험을 다시 돌려도 같은 궤적이 나오지 않는다는 점으로, 논문 재현이나 회귀 테스트에서 걸립니다. README에 적힌 “accurate simulation”도 이 조건을 감안해서 읽어야 합니다.
지원하지 않는 기능은 문서와 README에 명시돼 있습니다. 접촉 override 파라미터(o_margin, o_solref 등), midphase 충돌, autoreset, named access API가 없고, Flex는 “experimental” 상태입니다. 기존 MJCF 모델이 이런 기능에 기대고 있다면 그대로 옮겨지지 않습니다.
배치 렌더러는 레이트레이싱 방식입니다. 메시·텍스처, 하이트필드, 3D Gaussian Splatting, 그림자는 지원하지만 전역 조명과 PBR 재질은 지원하지 않습니다. README는 초당 수백만 프레임을 내세우지만 측정 조건이 없고 독립 측정도 찾지 못해 확인 필요 상태입니다. 시각 기반 정책 학습에 렌더러를 쓸 계획이라면 자체 벤치마크부터 돌려 보세요.
용어 풀이
1. EMD(Earth Mover’s Distance) — 두 분포를 서로 맞추는 데 드는 최소 이동량으로, 여기서는 시뮬레이션 궤적이 실제 로봇 궤적과 얼마나 다른지를 나타냅니다.
2. midphase 충돌 검사 — 대략적인 후보 선별(broadphase)과 정밀 계산(narrowphase) 사이에서 메시 내부 후보를 한 번 더 걸러내는 단계입니다.
정리
MuJoCo Warp는 nworld·nconmax·njmax로 GPU 메모리를 미리 잡아 두고 독립된 세계 수십만 개를 한꺼번에 돌리는 처리량 중심 구조입니다. 반복 호출을 CUDA graph로 캡처해야 병렬화 이득을 제대로 얻습니다. MJX 대비 475배라는 발표는 측정 조건이 공개되지 않았고, RTX 5070 12GB 환경의 독립 측정에서는 장면에 따라 약 1.86배에서 31.1배 사이였습니다. 자동 미분 미지원, float 정밀도, GPU 실행 간 편차, Alpha 상태의 잦은 배포를 감안하면 2026년 9월 기준으로는 역할을 나누는 편이 무리가 적습니다. 미분이나 결정성이 필요한 작업은 MJX나 CPU MuJoCo에 두고, 접촉이 많은 대량 병렬 강화학습에 MuJoCo Warp를 쓰는 식입니다. 도입한다면 버전을 고정하고, Newton이나 Isaac Lab을 거쳐 쓸 때는 그쪽이 고정한 버전을 따르세요.
참고 자료
조사 기준일: 2026년 09월 29일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (확인일 2026-09-29)
– https://mujoco.readthedocs.io/en/latest/mjwarp/
– https://raw.githubusercontent.com/google-deepmind/mujoco/main/doc/mjwarp/index.rst (인용문 대조용 원본)
– https://github.com/google-deepmind/mujoco_warp
– https://pypi.org/project/mujoco-warp/
– https://github.com/google-deepmind/mujoco/discussions/2511
– https://mujoco.readthedocs.io/en/stable/mjx.html
– https://developer.nvidia.com/blog/announcing-newton-an-open-source-physics-engine-for-robotics-simulation/
– https://developer.nvidia.com/blog/newton-adds-contact-rich-manipulation-and-locomotion-capabilities-for-industrial-robotics/
– https://blogs.nvidia.com/blog/newton-physics-engine-openusd/
– https://github.com/newton-physics/newton/releases (v1.4.0 태그 포함)
– https://github.com/isaac-sim/IsaacLab/releases/tag/v3.0.0-EA
– https://isaac-sim.github.io/IsaacLab/main/source/experimental-features/newton-physics-integration/index.html
Tier 2 (확인일 2026-09-29)
– https://arxiv.org/html/2607.13059v1 (GPUSimBench, 두 번 조회해 대조)
– https://www.linuxjournal.com/content/linux-foundation-welcomes-newton-next-open-physics-engine-robotics
– https://arxiv.org/abs/2601.22074 (mjlab 논문, 초록에 처리량 수치 없음)
답글 남기기