
NVIDIA Kumo Tabular는 행 attention·열 attention·인컨텍스트 attention 구조로 표 데이터를 학습 없이 예측하는 모델입니다. 학습 범위, TabArena 수치, 라이선스, 설치 조건을 TabPFN-3.5·LimiX-2와 비교해 2026년 10월 기준으로 정리했습니다.
KumoTabular, 무엇을 기준으로 비교해야 할까
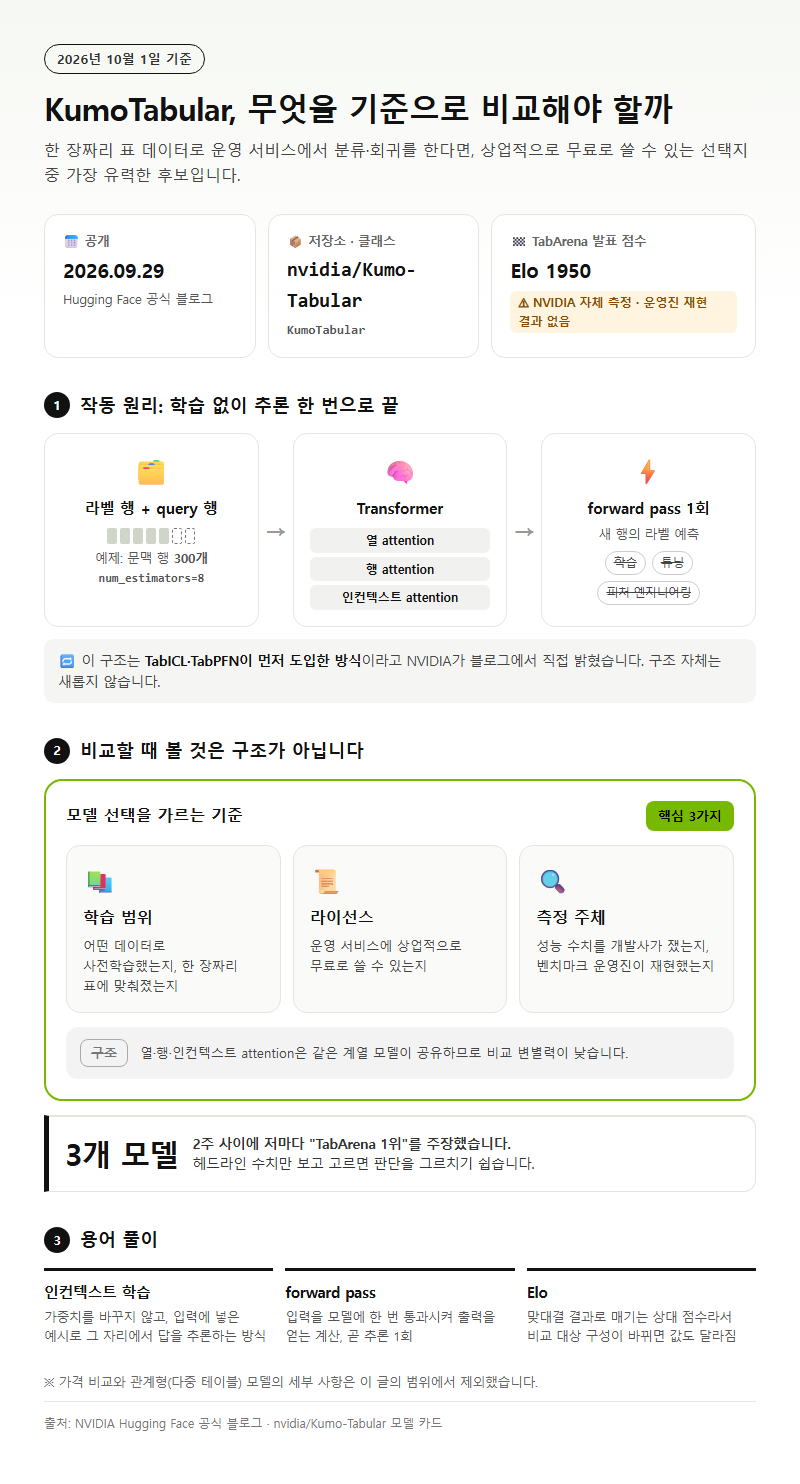
한 장짜리 표 데이터로 운영 서비스에서 분류·회귀를 해야 한다면, 2026년 10월 1일 기준으로 NVIDIA Kumo Tabular가 상업적으로 무료로 쓸 수 있는 선택지 중 가장 유력한 후보입니다. NVIDIA는 이 모델이 TabArena에서 Elo 1950을 기록했다고 발표했습니다. 다만 자사가 측정한 값이고, 벤치마크 운영진의 재현 결과는 아직 나오지 않았습니다. 이 글에서는 Kumo Tabular의 구조와 학습 범위, 크기별 차이, 경쟁 모델과의 라이선스·성능 차이를 비교합니다. 가격 비교와 관계형(다중 테이블) 모델의 세부 사항은 범위에서 뺐습니다.
Kumo Tabular는 NVIDIA가 2026년 9월 29일 Hugging Face 공식 블로그로 공개한 표 데이터 전용 오픈 파운데이션 모델입니다. 저장소 이름은 nvidia/Kumo-Tabular, 코드상 클래스명은 KumoTabular입니다. NVIDIA는 이 모델을 “predicts the labels of new rows in a single forward pass, with no training, no tuning, and no feature engineering”이라고 소개합니다. 모델을 따로 학습시키지 않고 추론 한 번으로 새 행의 라벨을 맞힌다는 말입니다.
작동 원리는 인컨텍스트 학습입니다. 라벨이 붙은 행을 문맥으로 넣고 라벨이 없는 행(query)을 함께 넣으면 답이 나옵니다. 모델 카드 예제는 문맥 행 300개에 num_estimators=8을 지정합니다. 내부는 열 attention, 행 attention, 인컨텍스트 attention을 갖춘 Transformer입니다. NVIDIA는 이 구조가 TabICL·TabPFN이 먼저 도입한 방식이라고 블로그에서 직접 밝혔습니다. 구조 자체는 새롭지 않습니다.
비교를 가르는 건 구조가 아니라 학습 범위, 라이선스, 성능 수치를 누가 측정했는지 세 가지입니다. 같은 구조 계열의 모델 셋이 2주 사이에 저마다 “TabArena 1위”를 주장했으니, 헤드라인 수치만 보고 고르면 판단을 그르치기 쉽습니다.
용어 풀이
1. 인컨텍스트 학습 — 모델 가중치를 바꾸지 않고, 입력에 예시를 넣어 그 자리에서 답을 추론하게 하는 방식입니다.
2. forward pass — 입력을 모델에 한 번 통과시켜 출력을 얻는 계산 과정으로, 추론 1회를 뜻합니다.
3. Elo — 모델끼리 맞대결 결과로 매기는 상대 점수라서, 비교 대상 모델 구성이 바뀌면 값도 달라집니다.
비교 기준 정리
표 데이터 파운데이션 모델은 아래 항목으로 비교합니다. 가장 먼저 짚을 점은 학습 범위를 벗어난 표에서는 성능이 보장되지 않는다는 사실입니다. NVIDIA도 공식 블로그에서 “Accuracy may degrade on tables far beyond the training ranges or when the query rows come from a different distribution than the context rows”라고 경고합니다.
| 비교 항목 | 기준·단위 | Kumo Tabular 값 (2026년 10월 1일 기준) | 주의점 |
|---|---|---|---|
| 문맥 행 수 | 행 | 학습 3단계에서 최대 60,000행 | 이 범위를 넘으면 성능 보장 밖 |
| 열 수 | 열 | 전 단계 100열 이하로 학습 | 열이 많은 표는 차원 축소 필요 |
| 클래스 수 | 개 | 추론 1회당 10개 | 초과분은 ECOC로 우회 |
| 입력 타입 | 숫자형·범주형 | 이 둘만 직접 처리 | 텍스트·이미지·타임스탬프는 전처리 레시피 필요 |
| 모델 크기 | 파라미터 | 3종, 28M~215M | 크기별 정확한 수치는 비공개 |
| 가중치 라이선스 | 상업 이용 가능 여부 | OpenMDW-1.1, 상업 이용 가능 | 코드는 Apache 2.0 |
| 성능 수치 출처 | 자사 측정 / 제3자 | 전부 NVIDIA 자사 측정 | TabArena 운영진 재현 진행 중 |
| 설치 경로 | 패키지 관리자 | GitHub 설치 | PyPI 패키지는 빈 자리 표시용 |
학습 범위는 세 단계에 걸쳐 넓어졌습니다. 1단계는 1,024행·최대 100열 표로 학습했고, 2단계에서 문맥을 400~10,240행으로, 3단계에서 60,000행까지 늘렸습니다. 열은 끝까지 100개 이하였습니다. 행은 수만 건까지 괜찮지만, 열이 100개를 넘으면 모델이 한 번도 본 적 없는 입력이 됩니다.
학습 데이터는 전부 인공 데이터입니다. 구조적 인과 모델(SCM)로 생성한 표를 Small/Medium/Large가 각각 약 3,500만/7,100만/1억 3,700만 개 학습했습니다. 실제 기업 데이터를 한 번도 보지 않았다는 점은 장점이자 한계입니다. 데이터 유출 걱정은 없지만, 실제 업무 표와 인공 표의 분포가 다를 가능성은 직접 검증해야 합니다.
재현성도 따져봐야 합니다. 가중치와 추론 코드는 공개됐지만 NVIDIA 블로그 원문에는 “Our training recipe and artificial data generators will be released soon.”이라고 적혀 있습니다. 학습 레시피와 인공 데이터 생성기는 아직 공개 전이라, 도메인에 맞춰 다시 학습시키려는 팀은 공개 시점을 기다려야 합니다.
용어 풀이
1. SCM(구조적 인과 모델) — 변수 사이의 원인·결과 관계를 수식으로 정의해 그럴듯한 인공 데이터를 만들어내는 틀입니다.
2. ECOC(오류정정 출력 부호) — 클래스가 많을 때 이를 여러 개의 작은 분류 문제로 쪼개 조합하는 기법입니다.
옵션·유형별 비교
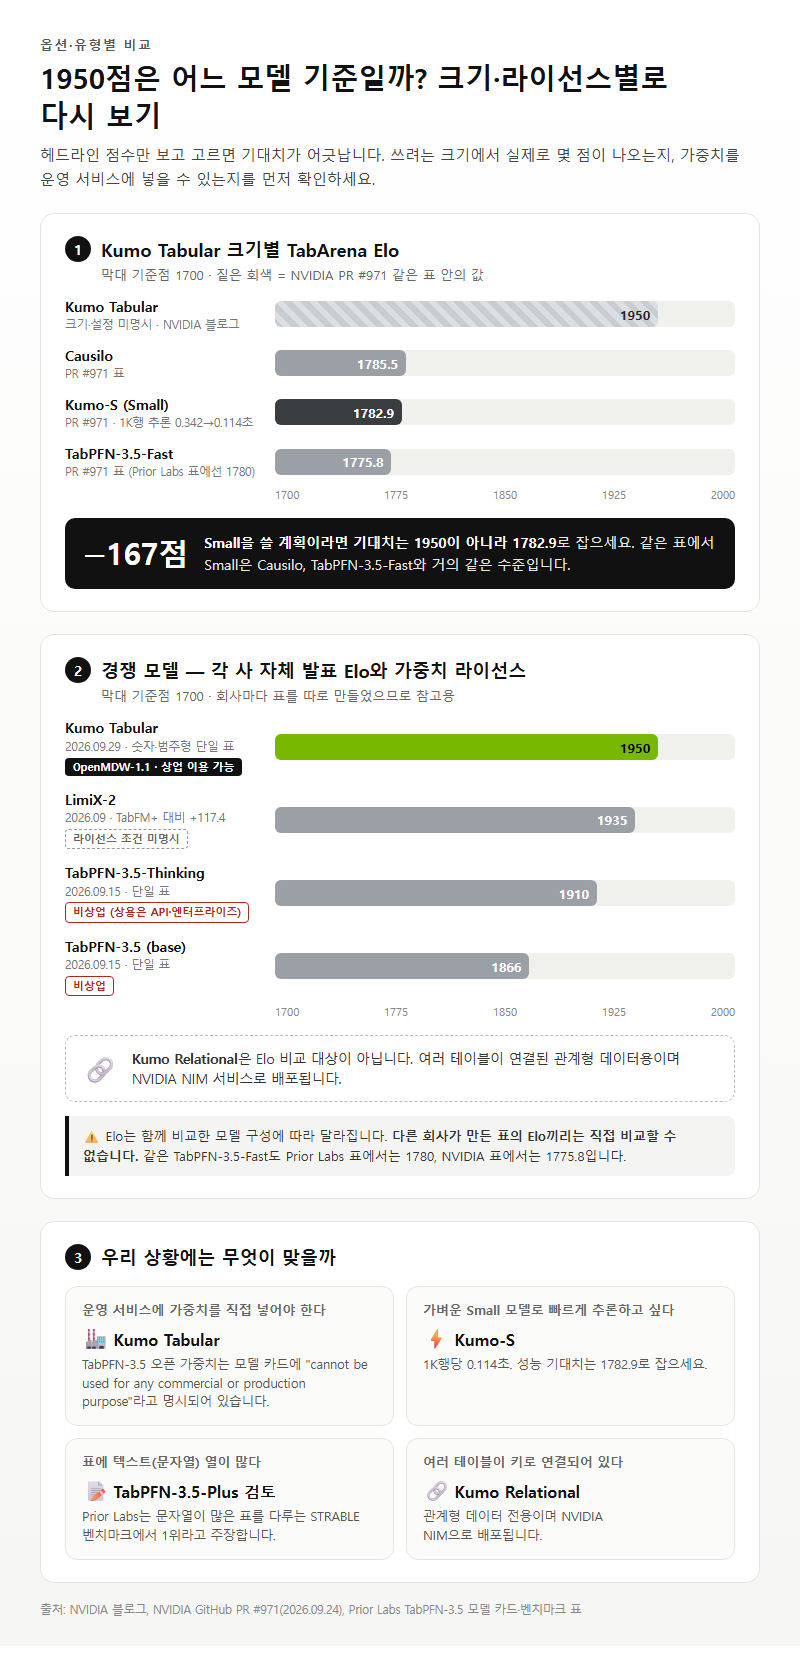
먼저 Kumo Tabular 안에서 크기별 차이를 보겠습니다. NVIDIA가 내세운 1950은 어느 크기·어떤 설정에서 나온 값인지 블로그에 나와 있지 않습니다. 반면 NVIDIA가 GitHub PR #971(2026년 9월 24일)에 올린 표에는 Small 모델만 따로 떼어낸 수치가 있습니다.
| 모델 | TabArena Elo | 측정 주체 | 비고 |
|---|---|---|---|
| Kumo Tabular (크기 미명시) | 1950 | NVIDIA 블로그 | 종합 1위 주장 |
| Kumo-S (Small) | 1782.9 | NVIDIA PR #971 | 1K행당 추론 0.342초 → 0.114초 |
| Causilo | 1785.5 | NVIDIA PR #971 표 | Kumo-S와 같은 표 |
| TabPFN-3.5-Fast | 1775.8 | NVIDIA PR #971 표 | Prior Labs 표에서는 1780 |
Small과 헤드라인 값은 약 170점 차이가 납니다. Small을 쓸 계획이라면 기대치는 1950이 아니라 1782.9에 맞추세요. 같은 표에서 Small은 Causilo, TabPFN-3.5-Fast와 거의 같은 수준입니다.
다음은 경쟁 모델과의 비교입니다. Elo는 비교 모델 구성에 따라 값이 바뀌므로 서로 다른 회사가 만든 표의 Elo끼리는 직접 비교가 성립하지 않습니다. 같은 TabPFN-3.5-Fast도 Prior Labs 표에서는 1780, NVIDIA 표에서는 1775.8로 나옵니다.
| 모델 | 공개 | TabArena Elo (자사 발표) | 가중치 라이선스 | 적합한 데이터 |
|---|---|---|---|---|
| Kumo Tabular | 2026년 9월 29일 | 1950 | OpenMDW-1.1, 상업 이용 가능 | 숫자·범주형 단일 표 |
| TabPFN-3.5-Thinking | 2026년 9월 15일 | 1910 | 비상업 (상용은 API·엔터프라이즈) | 단일 표 |
| TabPFN-3.5 (base) | 2026년 9월 15일 | 1866 | 비상업 | 단일 표 |
| LimiX-2 | 2026년 9월 | 1935 (TabFM+ 대비 117.4점 우위) | 회사가 조건을 명시하지 않음 | 단일 표 |
| Kumo Relational | NVIDIA NIM 서비스 | 해당 없음 | NIM 배포 | 여러 테이블이 연결된 관계형 데이터 |
라이선스 차이가 가장 결정적입니다. Prior Labs의 TabPFN-3.5 모델 카드는 오픈 가중치에 대해 “cannot be used for any commercial or production purpose”라고 명시합니다. 성능 헤드라인은 비슷해도 운영 서비스에 가중치를 직접 넣을 수 있는 건 Kumo Tabular 쪽입니다. 대신 Prior Labs는 TabPFN-3.5-Plus가 문자열이 많은 표를 다루는 STRABLE 벤치마크에서 1위라고 주장합니다. 텍스트 열이 많은 표라면 TabPFN 쪽도 검토해볼 만합니다.
NVIDIA는 다른 벤치마크 수치도 공개했습니다. BeyondArena에서는 Elo 1418, Improvability 7.78%로 1위, TALENT에서는 분류 정확도·log-loss·회귀 RMSE 평균 순위가 6.67·3.98·4.22로 종합 1위, ScoringBench에서는 Large와 Medium이 1·2위라고 합니다. 이 역시 모두 NVIDIA 자사 측정값입니다.
속도 수치는 매체마다 다르게 전해졌습니다. NVIDIA 블로그 원문에는 RTX 6000 Pro 1장 기준으로 LimiX-2보다 “17 faster”라고 배수 기호 없이 적혀 있습니다. HyperAI와 beri.net은 이를 17배로, Unite.AI는 같은 날 26배로 보도했습니다. 공식 수치가 정리되기 전까지는 Small 기준 1K행당 0.114초(NVIDIA 자체 측정)를 출발점으로 삼는 편이 안전합니다.
상황별 추천
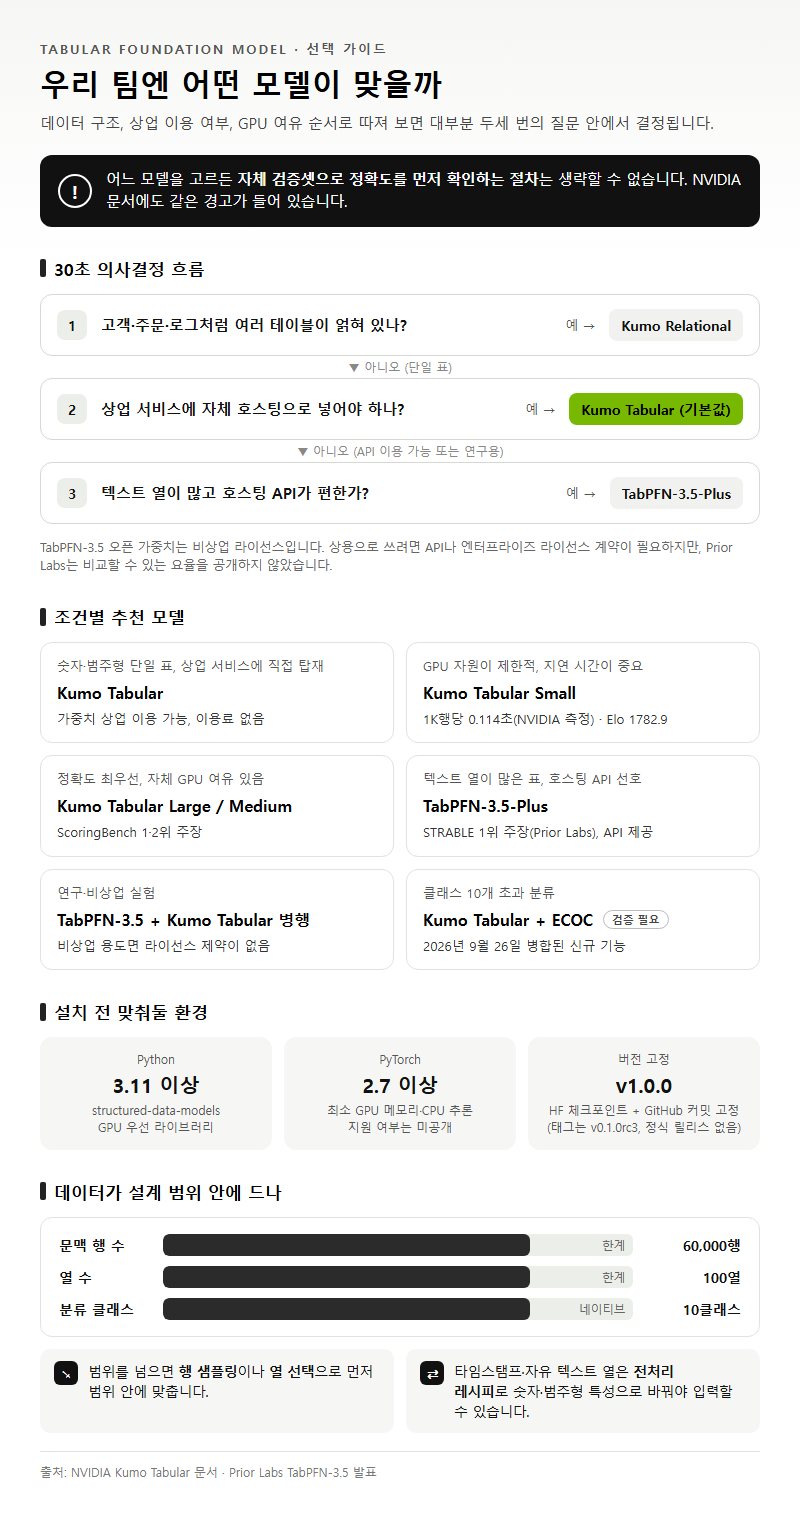
조건별 추천은 아래 표와 같습니다. 어느 경우든 자체 검증셋으로 정확도를 먼저 확인하는 절차는 생략할 수 없습니다. NVIDIA 문서에도 그 경고가 들어 있습니다.
| 상황 | 추천 | 이유 |
|---|---|---|
| 숫자·범주형 단일 표, 상업 서비스에 직접 탑재 | Kumo Tabular | 가중치 상업 이용 가능, 이용료 없음 |
| GPU 자원이 제한적, 지연 시간이 중요 | Kumo Tabular Small | 1K행당 0.114초(NVIDIA 측정), Elo 1782.9 |
| 정확도 최우선, 자체 GPU 여유 | Kumo Tabular Large 또는 Medium | ScoringBench 1·2위 주장 |
| 텍스트 열이 많은 표, 호스팅 API 선호 | TabPFN-3.5-Plus | STRABLE 1위 주장(Prior Labs), API 제공 |
| 연구·비상업 실험 | TabPFN-3.5 / Kumo Tabular 병행 | 비상업이면 라이선스 제약이 없음 |
| 고객·주문·로그 등 여러 테이블 | Kumo Relational | 관계형 데이터 전용, NIM 배포 |
| 클래스 10개 초과 분류 | Kumo Tabular + ECOC | 2026년 9월 26일 병합된 기능이라 검증 필요 |
사내 운영 서비스를 만드는 팀이라면 고민할 게 많지 않습니다. TabPFN-3.5 오픈 가중치는 비상업 라이선스라 운영에 넣을 수 없으니, 자체 호스팅이 조건이면 Kumo Tabular가 사실상 기본값입니다. 상용 TabPFN을 쓰려면 API나 엔터프라이즈 라이선스 계약이 필요한데, Prior Labs는 그 요율을 공개적으로 비교할 수 있는 형태로 내놓지 않았습니다.
설치 환경도 미리 맞춰둬야 합니다. Kumo Tabular 코드 라이브러리(structured-data-models)는 GPU 우선이며 Python 3.11 이상, PyTorch 2.7 이상이 필요합니다. GitHub 태그는 v0.1.0rc3까지 있고 정식 릴리스는 아직 없습니다. 운영 환경에 넣는다면 GitHub 커밋과 HF 체크포인트 버전(v1.0.0)을 고정해 두어야 같은 결과를 재현할 수 있습니다. 최소 GPU 메모리와 CPU 추론 지원 여부는 NVIDIA가 공개하지 않았습니다.
데이터 형태가 학습 범위 안에 드는지도 확인하세요. 문맥 60,000행·100열·네이티브 10클래스 안이면 설계된 범위입니다. 이를 넘으면 우선 행 샘플링이나 열 선택으로 범위 안에 맞춥니다. 타임스탬프나 자유 텍스트 열은 전처리 레시피로 숫자·범주형 특성으로 바꿔야 모델에 넣을 수 있습니다.
자주 하는 실수
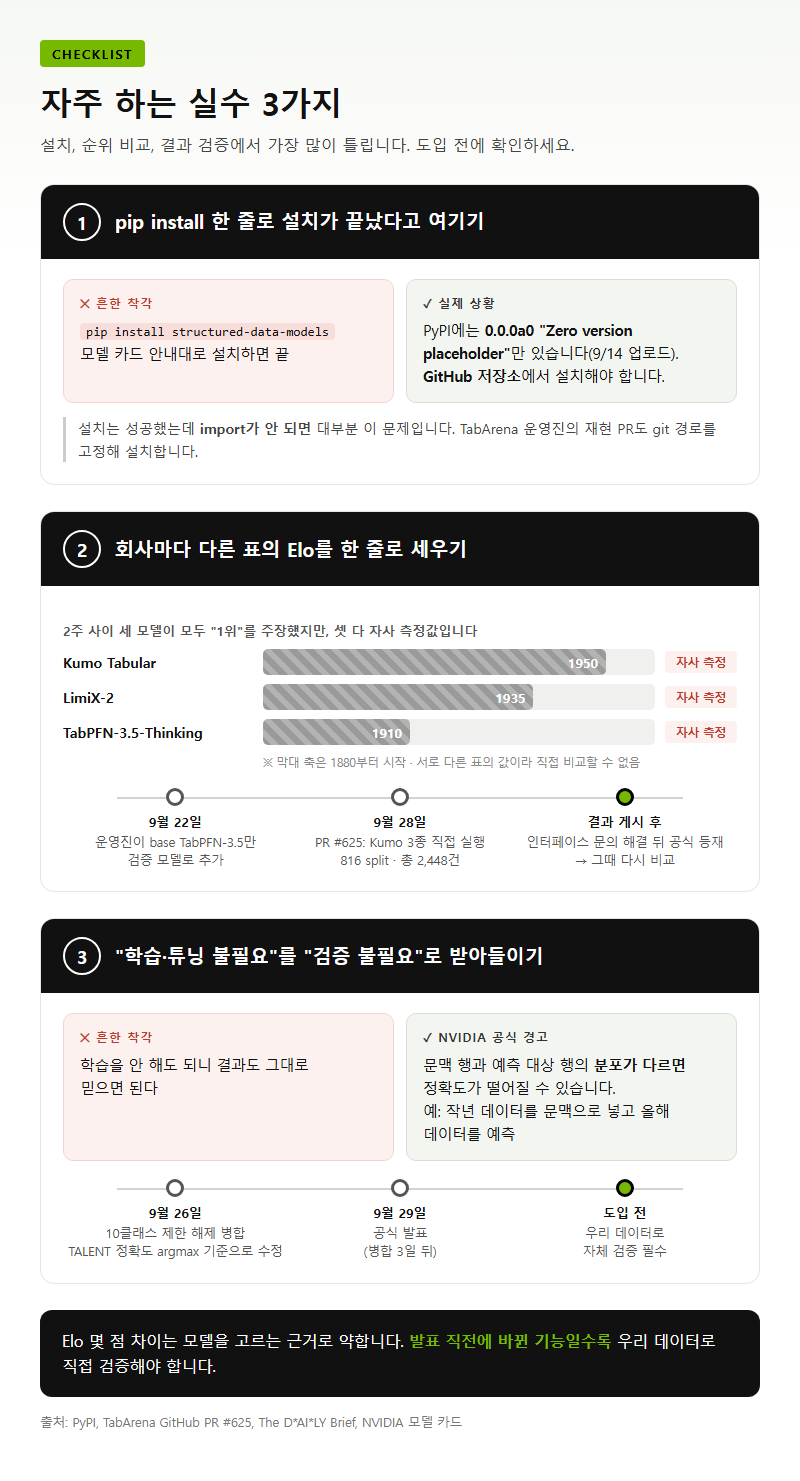
첫째, pip install structured-data-models로 설치를 끝냈다고 여기는 것입니다. 모델 카드는 이 명령을 안내하지만, 2026년 10월 1일 기준 PyPI에 올라온 것은 2026년 9월 14일 업로드된 0.0.0a0 “Zero version placeholder”뿐입니다. 실제 라이브러리는 GitHub 저장소에서 설치해야 하고, TabArena 운영진의 재현 PR도 git 경로를 고정해 설치합니다. 설치는 성공한 것처럼 보이는데 import가 안 된다면 대부분 이 문제입니다.
둘째, 회사마다 다른 표의 Elo를 한 줄로 세우는 것입니다. 2주 사이에 LimiX-2 1935, TabPFN-3.5-Thinking 1910, Kumo Tabular 1950까지 세 모델이 모두 1위를 주장했지만, 셋 다 자사 측정값입니다. The D*AI*LY Brief 보도에 따르면 벤치마크 운영진은 2026년 9월 22일 base TabPFN-3.5만 검증 모델로 추가했습니다. Elo 몇 점 차이로 모델을 고르는 것은 근거가 약합니다. TabArena 운영진은 2026년 9월 28일 PR #625를 열고 Kumo Tabular 3종을 816개 split, 총 2,448건 규모로 직접 돌리기 시작했습니다. 운영진은 인터페이스 문의가 해결돼야 공식 등재를 진행하겠다고 밝혔으니, 결과가 게시된 뒤 다시 비교하는 편이 정확합니다.
셋째, “학습·튜닝 불필요”를 “검증 불필요”로 받아들이는 것입니다. 모델을 학습시킬 필요가 없다는 것이지, 결과를 믿어도 된다는 뜻은 아닙니다. 문맥 행과 예측 대상 행의 분포가 다르면 정확도가 떨어질 수 있다고 NVIDIA가 직접 경고했습니다. 작년 데이터를 문맥으로 넣고 올해 데이터를 예측하는 경우가 여기에 해당합니다. 10클래스 제한 해제 기능은 발표 3일 전인 2026년 9월 26일에 병합됐고, 같은 PR에서 TALENT 정확도 산출 방식을 argmax 기준으로 바로잡기도 했습니다. 발표 직전에 바뀐 기능일수록 자체 검증이 더 필요합니다.
정리
Kumo Tabular는 TabICL·TabPFN과 같은 3중 attention 구조를 쓰는 표 데이터 인컨텍스트 모델입니다. 경쟁 모델과 실제로 갈리는 지점은 구조가 아니라 상업 이용이 가능한 오픈 가중치라는 점입니다. Elo 1950을 비롯한 성능 수치는 모두 NVIDIA 자사 측정값이고, Small 모델은 1782.9로 헤드라인 값보다 약 170점 낮습니다. 선택 기준은 한 줄이면 됩니다. 숫자·범주형 단일 표를 60,000행·100열·10클래스 안에서 운영 서비스에 쓴다면 Kumo Tabular를 고르되, 크기는 자사 GPU에서 직접 잰 속도로 정하고 정확도는 자체 검증셋으로 확인하십시오.
참고 자료
조사 기준일: 2026년 10월 01일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (확인일 2026-10-01)
– NVIDIA HF 블로그 “NVIDIA Kumo Tabular Sets a New Accuracy-Efficiency Frontier…” — https://huggingface.co/blog/nvidia/kumo-tabular (HTML 원문 직접 대조)
– HF 모델카드 — https://huggingface.co/nvidia/Kumo-Tabular (raw README + 파일 목록 API)
– GitHub NVIDIA/structured-data-models — https://github.com/NVIDIA/structured-data-models
– PR #971 — https://github.com/NVIDIA/structured-data-models/pull/971
– PR #992 — https://github.com/NVIDIA/structured-data-models/pull/992
– PyPI structured-data-models — https://pypi.org/project/structured-data-models/
– NVIDIA Kumo Relational 문서 — https://docs.nvidia.com/sdgm/rfm/overview
– TabPFN-3.5 기술 리포트 — https://priorlabs.ai/technical-reports/tabpfn-3-5
– TabPFN-3.5 arXiv — https://arxiv.org/html/2609.17895v1
– TabPFN-3.5 HF 모델카드(라이선스) — https://huggingface.co/Prior-Labs/tabpfn_3_5
– LimiX-2 arXiv — https://arxiv.org/html/2609.17488v1
Tier 2 (확인일 2026-10-01)
– TabArena PR #625 — https://github.com/autogluon/tabarena/pull/625
– The DAILY Brief — https://www.beri.net/article/nvidia-kumo-tabular-open-tabular-foundation-model-tabarena-commercial-license-vs-tabpfn-3-5
– Unite.AI — https://www.unite.ai/nvidia-releases-open-kumo-tabular-model-for-tabular-prediction/
– HyperAI — https://hyper.ai/en/stories/6af8dd1a3e49b29c06bd66ff6b430840
– Fortune (인수 보도) — https://fortune.com/2026/06/03/nvidia-snaps-up-kumo-ai-in-latest-acquisition/
– PYMNTS (4억 달러 보도) — https://www.pymnts.com/acquisitions/2026/nvidia-pays-400-million-dollars-ai-software-firm-kumo/ (본문 미열람, 검색 결과로만 확인)
답글 남기기