
기업 GPU 클러스터의 평균 이용률이 5%에 그친다는 측정이 나왔습니다. 미리 잡아 두기, 쪼개 쓰기, 되찾기라는 세 가지 구조로 GPU 클러스터 스케줄링이 유휴 GPU를 어떻게 줄이는지, 광고 수치는 어떻게 읽어야 하는지 정리했습니다.
엔비디아 GPU 개요
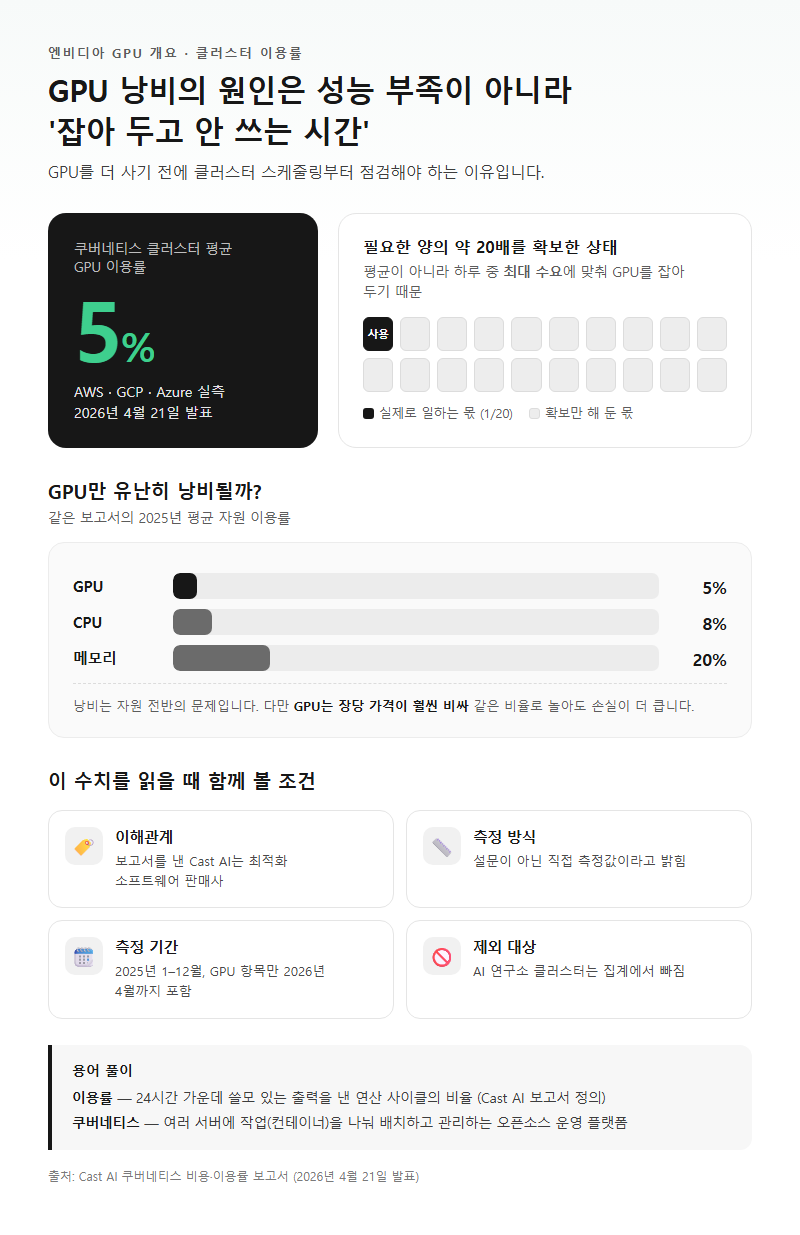
유휴 GPU 낭비의 주된 원인은 성능 부족이 아니라 ‘잡아 두고 안 쓰는 시간’입니다. GPU를 더 사기 전에 GPU 클러스터 스케줄링부터 손봐야 하는 이유입니다. Cast AI가 AWS·GCP·Azure의 쿠버네티스 클러스터를 측정해 2026년 4월 21일 발표한 보고서에 따르면 평균 GPU 이용률은 5%였습니다. 이 글에서는 낭비가 왜 생기는지, 엔비디아의 KAI Scheduler·Run:ai·Slurm과 알리바바의 Aegaeon이 어떤 구조로 낭비를 줄이는지, 광고 수치는 어떻게 읽어야 하는지를 다룹니다. 가격 비교는 공개된 자료가 부족해 뺐습니다.
AI 붐 이후 기업들은 앞다퉈 엔비디아 GPU를 확보했습니다. 그런데 그렇게 들여온 GPU 서버가 실제로 일하는 시간은 생각보다 훨씬 짧습니다. Cast AI는 이용률 5%를 “필요한 양의 약 20배를 확보한 상태”로 풀이했습니다. 하루 중 수요가 크게 출렁이니 기업들이 평균이 아니라 최대 수요에 맞춰 GPU를 잡아 둔다는 설명입니다.
이 수치는 조건과 함께 읽어야 합니다. 보고서를 낸 Cast AI는 최적화 소프트웨어를 파는 회사입니다. 설문이 아니라 직접 측정한 값이라고 밝혔지만 이해관계가 걸려 있습니다. 측정 기간은 2025년 1월부터 12월까지이고 GPU 항목만 2026년 4월까지 포함했으며, AI 연구소 클러스터는 빠졌습니다. 같은 보고서에서 2025년 평균 CPU 이용률은 8%, 메모리 이용률은 20%였습니다. GPU만 유난히 낭비되는 것은 아닌 셈이지만, GPU는 장당 가격이 훨씬 비싸 같은 낭비라도 손실이 더 큽니다.
용어 풀이
1. 이용률 — Cast AI 보고서의 정의로는 24시간 가운데 쓸모 있는 출력을 낸 연산 사이클의 비율입니다.
2. 쿠버네티스 — 여러 서버에 작업(컨테이너)을 나눠 배치하고 관리하는 오픈소스 운영 플랫폼입니다.
1. GPU 확보 경쟁이 낭비를 만드는 구조
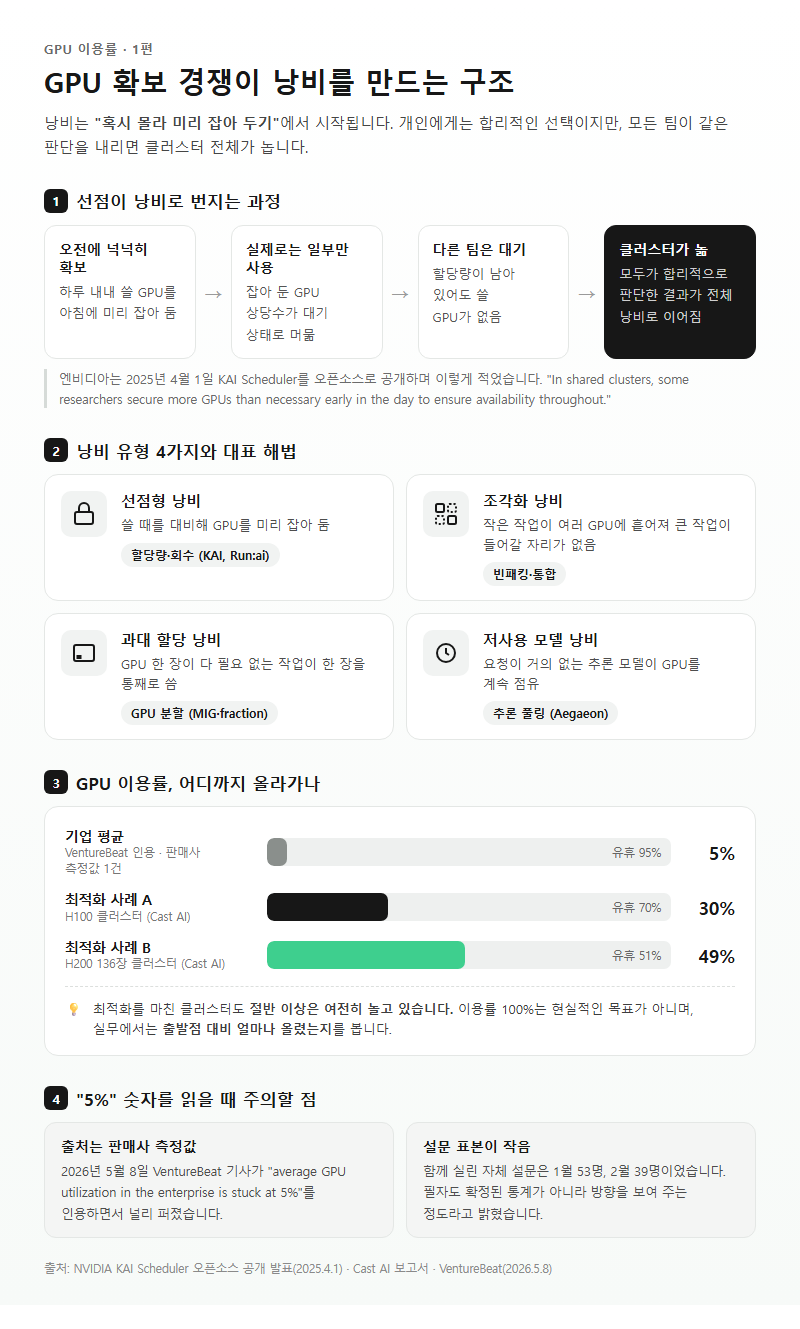
낭비는 “혹시 몰라 미리 잡아 두기”에서 시작됩니다. 엔비디아는 2025년 4월 1일 KAI Scheduler를 오픈소스로 공개하면서 공유 클러스터의 문제를 이렇게 적었습니다. “In shared clusters, some researchers secure more GPUs than necessary early in the day to ensure availability throughout.” 오전에 하루치 GPU를 넉넉히 잡아 두는 관행 탓에 다른 팀에 쓰지 않은 할당량이 남아 있어도 자원이 논다는 지적입니다.
개인 입장에서 보면 이 관행은 합리적입니다. 필요할 때 GPU를 못 구하면 일정이 밀리니 미리 잡아 두는 편이 안전하죠. 문제는 모든 팀이 같은 판단을 내리면 클러스터 전체가 빈다는 데 있습니다.
| 낭비 유형 | 어떻게 생기나 | 대표 해법 |
|---|---|---|
| 선점형 낭비 | 쓸 때를 대비해 GPU를 미리 잡아 둠 | 할당량·회수(KAI, Run:ai) |
| 조각화 낭비 | 작은 작업이 GPU 여러 장에 흩어져 큰 작업이 들어갈 자리가 없음 | 빈패킹·통합 |
| 과대 할당 낭비 | GPU 한 장이 필요 없는 작업이 한 장을 통째로 씀 | GPU 분할(MIG·fraction) |
| 저사용 모델 낭비 | 요청이 거의 없는 추론 모델이 GPU를 계속 점유 | 추론 풀링(Aegaeon) |
최적화 효과의 사례로 Cast AI 보고서는 두 곳을 들었습니다. H200 136장 클러스터에서 이용률 49%, 다른 조직의 H100에서 30%입니다. 평균 5%에 비하면 큰 차이지만, 최적화를 마친 클러스터도 절반 이상은 여전히 놀고 있습니다. 이용률 100%는 현실적인 목표가 아닙니다. 실무에서는 출발점보다 얼마나 올렸는지를 봅니다.
5%라는 숫자가 널리 퍼진 계기는 VentureBeat의 2026년 5월 8일 기사입니다. 기사는 “average GPU utilization in the enterprise is stuck at 5%”라고 인용했습니다. 함께 실린 자체 설문은 표본이 1월 53명, 2월 39명이었고, 필자 스스로도 통계적으로 확정된 결과가 아니라 방향을 보여 주는 정도라고 밝혔습니다. 5%는 판매사 측정값 하나라는 점을 기억해 두는 편이 안전합니다.
2. KAI Scheduler가 유휴 GPU를 되돌리는 다섯 장치
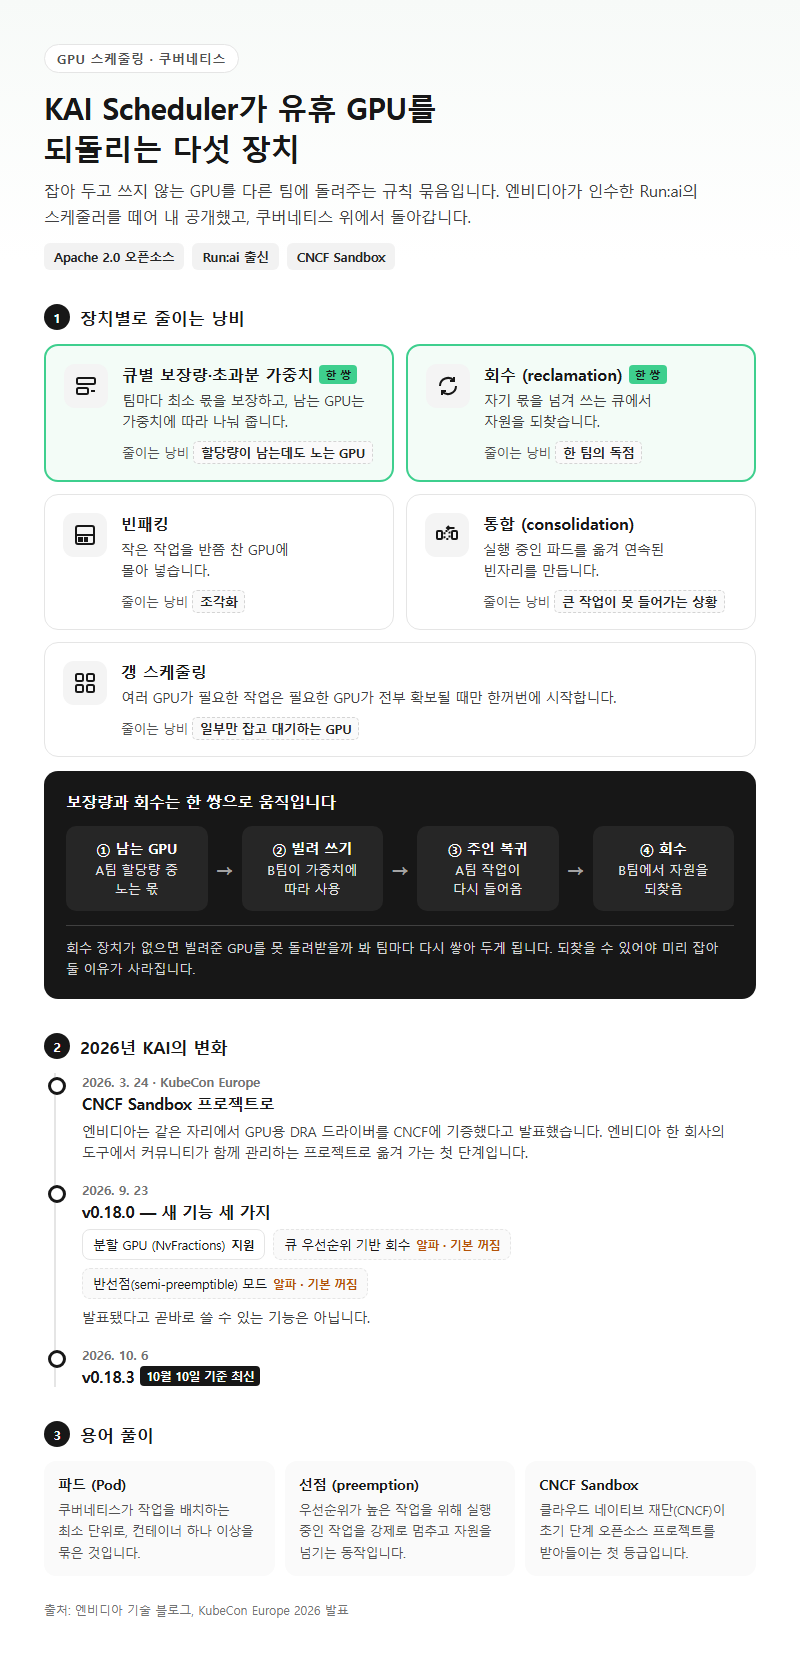
KAI Scheduler는 잡아 두고 쓰지 않는 GPU를 다른 팀에 돌려주는 규칙 묶음입니다. 엔비디아가 인수한 Run:ai의 스케줄러를 떼어 내 Apache 2.0 라이선스로 공개했고, 쿠버네티스 위에서 돌아갑니다. 엔비디아 기술 블로그가 설명한 장치는 다섯 가지입니다.
| 장치 | 하는 일 | 줄이는 낭비 |
|---|---|---|
| 큐별 보장량·초과분 가중치 | 팀마다 최소 몫을 보장하고, 남는 GPU는 가중치에 따라 나눠 줌 | 할당량이 남는데도 노는 GPU |
| 빈패킹 | 작은 작업을 반쯤 찬 GPU에 몰아 넣음 | 조각화 |
| 통합(consolidation) | 실행 중인 파드를 옮겨 연속된 빈자리를 만듦 | 큰 작업이 못 들어가는 상황 |
| 회수(reclamation) | 자기 몫을 넘겨 쓰는 큐에서 자원을 되찾음 | 한 팀의 독점 |
| 갱 스케줄링 | 여러 GPU가 필요한 작업은 전부 확보될 때만 한꺼번에 시작 | 일부만 잡고 대기하는 GPU |
보장량과 회수는 한 쌍으로 움직입니다. 남는 GPU를 다른 팀이 빌려 쓰되 원래 주인이 돌아오면 되찾을 수 있어야, 각 팀이 미리 잡아 둘 이유가 사라집니다. 회수 장치가 없으면 빌려준 GPU를 못 돌려받을까 봐 다시 쌓아 두게 됩니다.
KAI는 지금도 빠르게 바뀌고 있습니다. 2026년 9월 23일 나온 v0.18.0은 분할 GPU(NvFractions) 지원, 큐 우선순위 기반 회수, 반선점(semi-preemptible) 모드를 추가했습니다. 다만 뒤의 두 기능은 알파 단계이고 기본값이 꺼져 있습니다. 발표됐다고 곧바로 쓸 수 있는 기능은 아닙니다. 2026년 10월 10일 기준 최신 릴리스는 10월 6일에 나온 v0.18.3입니다.
KAI의 위상도 달라졌습니다. 엔비디아는 2026년 3월 24일 KubeCon Europe에서 GPU용 DRA 드라이버를 CNCF에 기증했다고 발표했고, 같은 자리에서 KAI Scheduler는 CNCF Sandbox 프로젝트가 됐습니다. 엔비디아 한 회사의 도구에서 커뮤니티가 함께 관리하는 프로젝트로 옮겨 가는 첫 단계입니다.
용어 풀이
1. 파드(Pod) — 쿠버네티스가 작업을 배치하는 최소 단위로, 컨테이너 하나 이상을 묶은 것입니다.
2. 선점(preemption) — 우선순위가 높은 작업을 위해 실행 중인 작업을 강제로 멈추고 자원을 넘기는 동작입니다.
3. CNCF Sandbox — 클라우드 네이티브 재단(CNCF)이 초기 단계 오픈소스 프로젝트를 받아들이는 첫 등급입니다.
3. GPU 한 장을 나눠 쓰는 두 방식, MIG와 분할 GPU
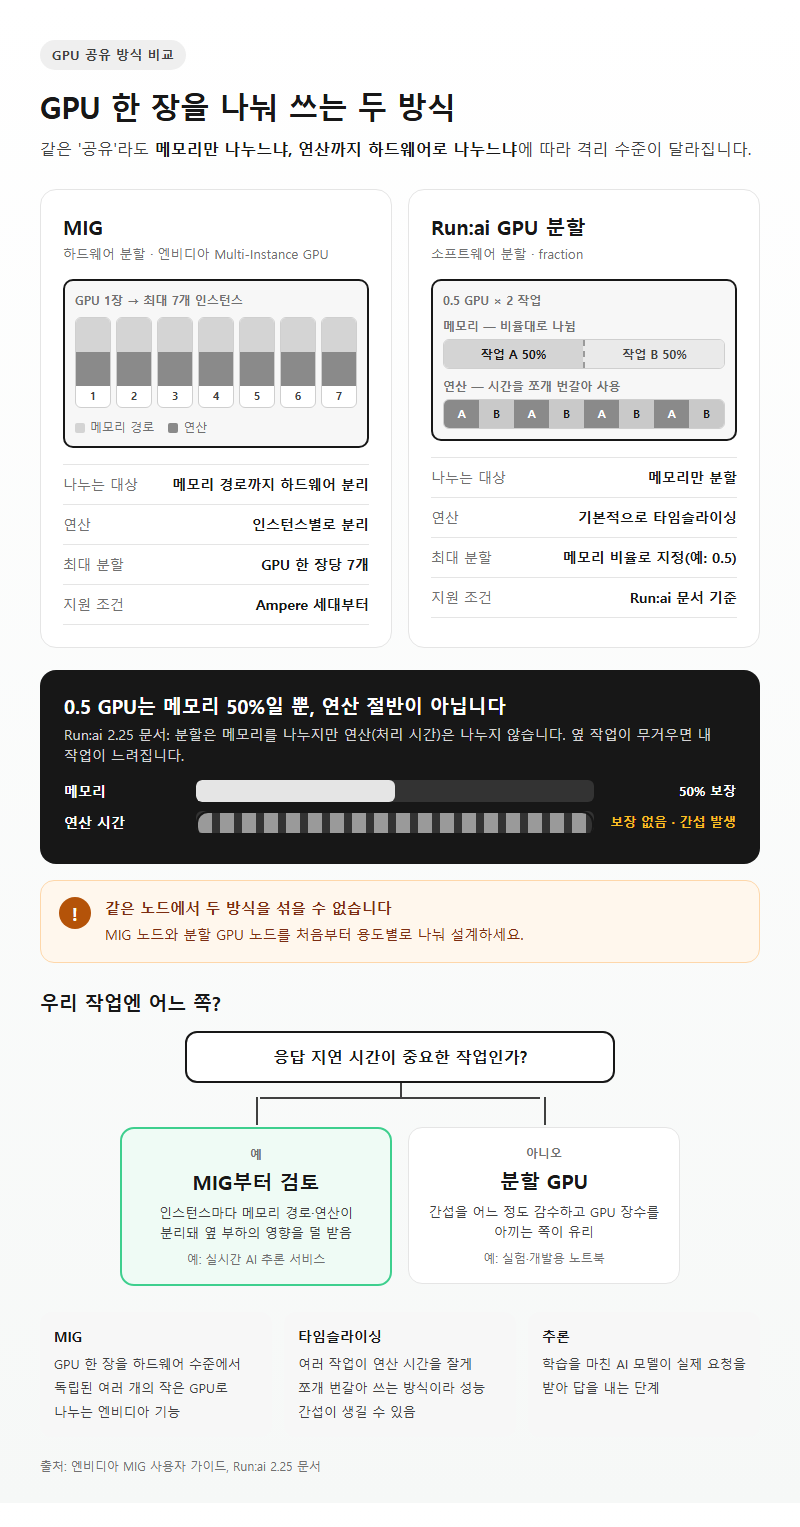
GPU를 나눠 쓴다는 말도 방식에 따라 격리 수준이 크게 다릅니다. 같은 ‘공유’라도 메모리만 나누느냐, 연산까지 하드웨어로 나누느냐에 따라 결과가 갈립니다. AI 추론 서비스처럼 응답 속도가 중요한 작업이라면 이 차이부터 확인해야 합니다.
| 항목 | MIG | Run:ai GPU 분할(fraction) |
|---|---|---|
| 나누는 대상 | 메모리 경로까지 하드웨어로 분리 | 메모리만 분할 |
| 연산 공유 | 인스턴스별로 분리 | 기본적으로 타임슬라이싱 |
| 최대 분할 수 | GPU 한 장당 7개 인스턴스 | 메모리 비율로 지정(예: 0.5) |
| 지원 조건 | Ampere 세대부터 | Run:ai 문서 기준 |
| 함께 쓰기 | 같은 노드에서 둘을 섞을 수 없음 | 같음 |
엔비디아 MIG 사용자 가이드에 따르면 MIG는 GPU 한 장을 “up to seven separate GPU Instances”로 나누고, 인스턴스마다 메모리 경로를 따로 둡니다. 한 인스턴스에 부하가 몰려도 다른 인스턴스는 영향을 덜 받습니다.
Run:ai의 분할은 다릅니다. Run:ai 2.25 문서는 분할이 “the memory split (i.e. 0.5 GPU means 50% of the GPU memory) but not the compute (processing time)”라고 적고 있습니다. 0.5 GPU는 메모리 50%일 뿐, 연산 절반을 보장하지 않습니다. 연산은 시간을 쪼개 번갈아 쓰므로 옆 작업이 무거우면 내 작업이 느려지는 간섭을 막지 못합니다.
판단 기준은 단순합니다. 지연 시간이 중요한 추론 서비스라면 MIG부터 검토하세요. 실험·개발용 노트북처럼 간섭을 어느 정도 견딜 수 있는 작업이라면 분할 GPU로 장수를 아끼는 쪽이 낫습니다. 두 방식은 같은 노드에서 섞을 수 없으니 노드 단위로 용도를 나눠 설계해야 합니다.
용어 풀이
1. MIG(Multi-Instance GPU) — GPU 한 장을 하드웨어 수준에서 독립된 여러 개의 작은 GPU로 나누는 엔비디아 기능입니다.
2. 타임슬라이싱 — 여러 작업이 GPU 연산 시간을 잘게 쪼개 번갈아 쓰는 방식이라 서로 성능 간섭이 생길 수 있습니다.
3. 추론 — 학습을 마친 AI 모델이 실제 요청을 받아 답을 내는 단계입니다.
4. 엔비디아 GPU 서버 운영 도구 지형 — KAI·Run:ai·Slurm·추론 풀링
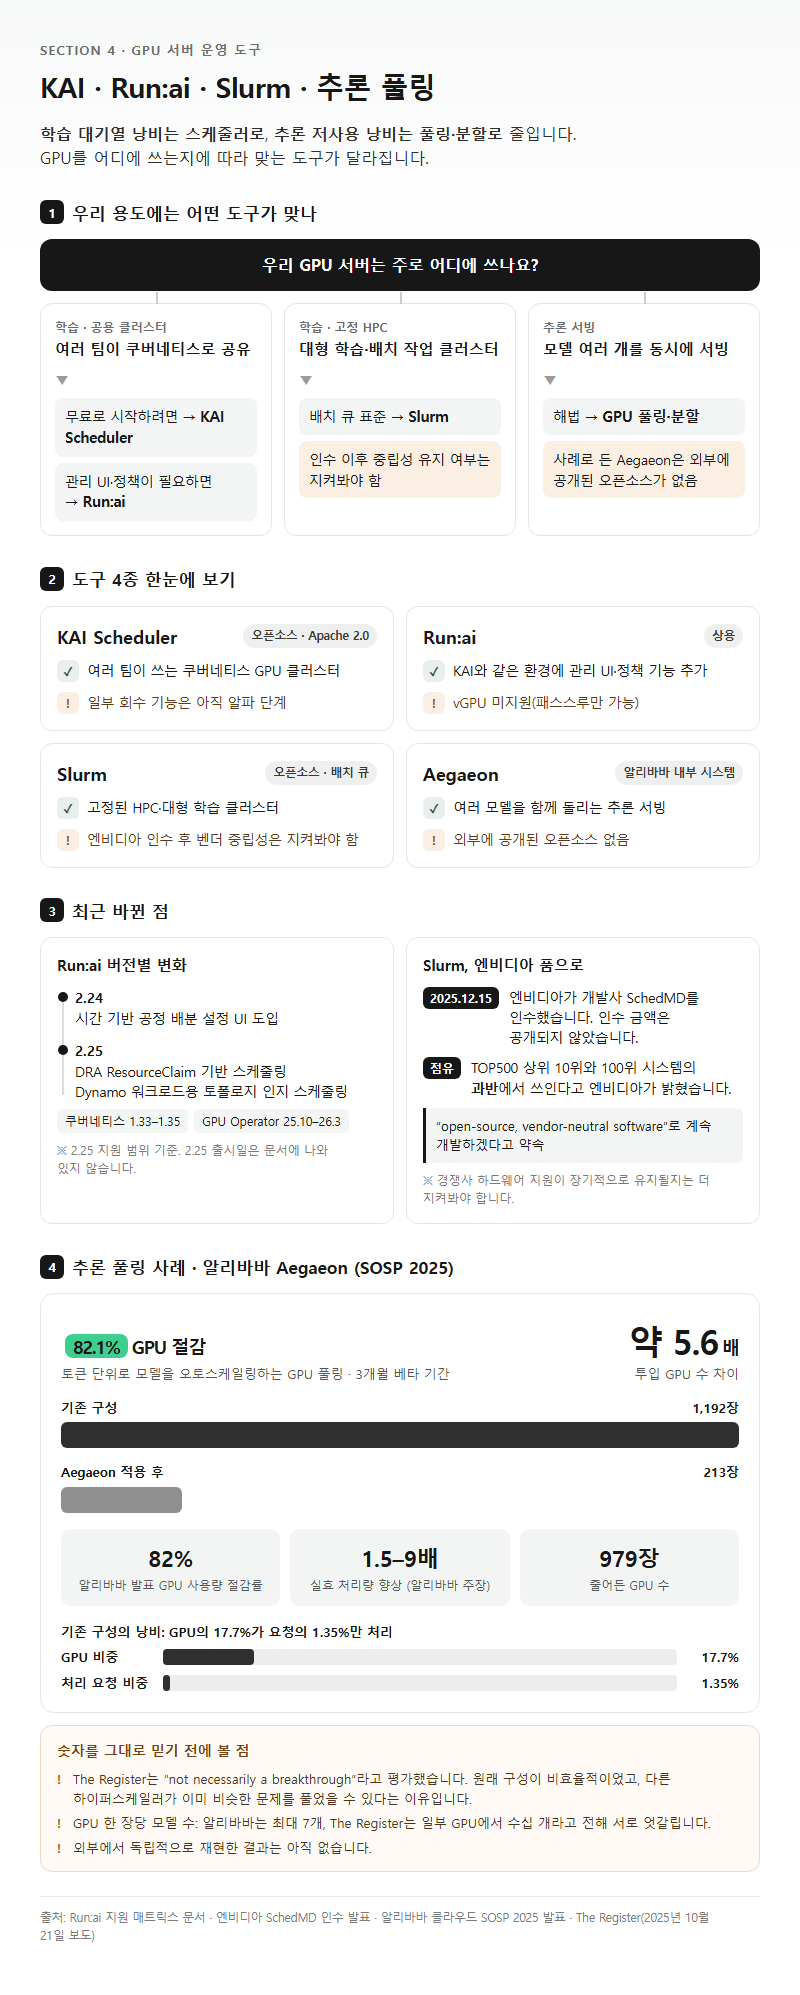
학습 대기열의 낭비는 스케줄러가, 추론의 저사용 낭비는 풀링과 분할이 줄입니다. 엔비디아 GPU 서버를 어디에 쓰느냐에 따라 맞는 도구가 다릅니다.
| 도구 | 성격 | 맞는 환경 | 확인된 제약 |
|---|---|---|---|
| KAI Scheduler | 오픈소스(Apache 2.0) | 여러 팀이 쓰는 쿠버네티스 GPU 클러스터 | 일부 회수 기능은 알파 |
| Run:ai | 상용 | 같은 환경 + 관리 UI·정책 | vGPU 미지원(패스스루만) |
| Slurm | 오픈소스 배치 큐 | 고정된 HPC·대형 학습 클러스터 | 엔비디아 인수 후 중립성은 지켜볼 일 |
| Aegaeon | 알리바바 내부 시스템 | 다수 모델 추론 서빙 | 외부에 공개된 오픈소스 없음 |
Run:ai는 2.24부터 시간 기반 공정 배분 설정 UI를 넣었고, 2.25부터 DRA ResourceClaim 기반 스케줄링과 Dynamo 워크로드용 토폴로지 인지 스케줄링을 지원합니다. Run:ai 지원 매트릭스 문서를 보면 2.25는 쿠버네티스 1.33~1.35, GPU Operator 25.10~26.3을 지원합니다. 2.25 출시일은 문서에 없습니다.
Slurm은 2025년 12월 15일 엔비디아가 개발사 SchedMD를 인수하면서 주목받았습니다. 엔비디아는 Slurm이 TOP500 상위 10위와 100위 시스템의 과반에서 쓰인다고 밝혔고, 인수 뒤에도 “open-source, vendor-neutral software”로 계속 개발하겠다고 했습니다. 인수 금액은 공개되지 않았습니다. 경쟁사 하드웨어 지원이 장기적으로 유지될지는 더 지켜봐야 합니다.
Aegaeon은 AI 추론 쪽 사례입니다. 알리바바 클라우드는 SOSP 2025에서 토큰 단위로 모델을 오토스케일링하는 이 GPU 풀링 방식을 발표하며 GPU 사용량 82% 절감, 실효 처리량 1.5~9배를 내세웠습니다. The Register 2025년 10월 21일 보도에 따르면 3개월 베타 기간에 GPU 1,192장을 213장으로 줄였습니다. 직접 계산하면 절감률 82.1%, 약 5.6배 차이입니다. 기존 구성에서는 GPU의 17.7%가 요청의 1.35%만 처리하고 있었다고 합니다.
같은 보도는 이 결과를 “not necessarily a breakthrough”라고 평했습니다. 원래 구성이 비효율적이었고, 다른 하이퍼스케일러가 이미 비슷한 문제를 풀었을 수 있다는 이유에서입니다. GPU 한 장당 모델 수도 알리바바는 최대 7개, The Register는 일부 GPU가 수십 개라고 전해 서로 엇갈립니다. 독립적으로 재현한 결과는 아직 없습니다.
5. 엔비디아 GPU AI 인프라 도입 전 FAQ
광고 수치는 무엇과 비교했는지부터 확인해야 합니다. 도입을 검토할 때 자주 걸리는 지점을 질문으로 정리했습니다.
“GPU 이용률 5배” 같은 수치는 믿어도 되나요?
Run:ai 제품 페이지는 “10x GPU Availability”, “20x Workloads Running”, “5x GPU Utilization”, “0 Manual Intervention”을 내걸고 있습니다. 그런데 2026년 10월 10일 기준 페이지에는 비교 기준과 측정 조건이 없습니다. 출발점이 Cast AI 평균인 5%라면 5배 올려도 25%입니다. 우리 클러스터의 현재 이용률을 먼저 재고, 그 값을 기준으로 개선폭을 따지는 편이 정확합니다.
쿠버네티스 DRA가 GA라는데 바로 써도 되나요?
쿠버네티스 v1.34(2025년 9월 1일 블로그)에서 resource.k8s.io 그룹의 핵심 API가 GA가 됐습니다. 하지만 일부 기능은 아직 베타·알파입니다. KAI도 DRA ResourceClaim 하나를 여러 파드가 나눠 쓸 때 유휴 GPU가 음수로 집계되던 버그를 2026년 9월에야 고쳤습니다. 발표 시점과 안정적으로 쓸 수 있는 시점 사이에는 시차가 있습니다. KAI는 v0.18.x 이상을 쓰는 것이 안전합니다.
회수 기능을 켜면 학습 작업이 날아가지 않나요?
그럴 수 있습니다. 회수와 선점은 실행 중인 작업을 강제로 내보낼 수 있다는 뜻입니다. 체크포인트를 남기지 않는 학습 작업은 보장량(in-quota) 안에서 돌리고, 초과분으로 빌려 쓰는 작업은 중간 저장을 전제로 설계해야 합니다.
GPU 공급이 부족하면 더 사는 게 답 아닌가요?
엔비디아 GPU 공급이 빠듯할수록 이미 가진 GPU의 이용률부터 보는 편이 비용 면에서 유리합니다. 다만 스케줄러는 수요 자체를 줄이지 못합니다. 최대 부하 시간대에 이미 모든 GPU가 꽉 차 있다면 스케줄링보다 증설이나 클라우드 임대를 따져 봐야 합니다.
용어 풀이
1. DRA(Dynamic Resource Allocation) — 쿠버네티스가 GPU 같은 특수 장치를 요청 조건에 맞춰 동적으로 배정하는 체계입니다.
2. 체크포인트 — 학습 중간 상태를 저장해 두는 것으로, 작업이 중단돼도 그 지점부터 다시 이어 갈 수 있게 합니다.
정리
GPU 클러스터의 낭비는 대부분 미리 잡아 두고 쓰지 않는 시간에서 생기며, Cast AI 측정으로는 평균 이용률이 5%였습니다. KAI Scheduler·Run:ai는 보장량과 회수로 잡아 둔 GPU를 다른 팀에 돌려주고, MIG와 분할 GPU는 한 장을 여럿이 나눠 쓰게 합니다. 다만 분할 GPU는 메모리만 나누고, 회수 관련 신기능 일부는 알파 단계라 기본값이 꺼져 있습니다. 도입을 판단할 때는 광고된 배수보다 우리 클러스터의 현재 이용률부터 재야 합니다.
참고 자료
조사 기준일: 2026년 10월 10일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (모두 2026-10-10 확인)
– https://developer.nvidia.com/blog/nvidia-open-sources-runai-scheduler-to-foster-community-collaboration/
– https://blogs.nvidia.com/blog/nvidia-at-kubecon-2026/
– https://blogs.nvidia.com/blog/nvidia-acquires-schedmd/
– https://www.nvidia.com/en-us/software/run-ai/
– https://run-ai-docs.nvidia.com/self-hosted/2.25/getting-started/whats-new/whats-new-2-25
– https://run-ai-docs.nvidia.com/self-hosted/2.25/platform-management/runai-scheduler/resource-optimization/fractions
– https://run-ai-docs.nvidia.com/self-hosted/2.25/getting-started/installation/support-matrix (보도 인용)
– https://docs.nvidia.com/datacenter/tesla/mig-user-guide/introduction.html
– https://github.com/NVIDIA/KAI-Scheduler/releases/tag/v0.18.0 · https://api.github.com/repos/NVIDIA/KAI-Scheduler/releases
– https://kubernetes.io/blog/2025/09/01/kubernetes-v1-34-dra-updates/
– https://www.alibabacloud.com/blog/alibaba-cloud-boosts-gpu-utilization-with-ai-infrastructure-breakthrough-at-sosp-2025_602623
– https://cast.ai/reports/kubernetes-optimization-report/
– https://cast.ai/press-release/2026-state-of-kubernetes-optimization-report/
– https://venturebeat.com/infrastructure/5-gpu-utilization-the-401-billion-ai-infrastructure-problem-enterprises-cant-keep-ignoring
– https://theregister.com/2025/10/21/alibaba_aegaeon_gpu_scheduling_improvements
– https://www.hpcwire.com/off-the-wire/nvidia-donates-dynamic-resource-allocation-driver-for-gpus-to-kubernetes-community/ (날짜 교차 확인용, 검색 결과로만 확인)
답글 남기기