
FLUX 3 Image Klein(5.6B)을 로컬에서 돌릴 때 필요한 VRAM, INT8·FP8·NVFP4 정밀도, 업샘플러 메모리, 라이선스 조건을 공식 문서와 독립 측정으로 대조했습니다. GPU 세대별 선택 기준도 함께 정리했습니다.
AI 이미지 생성 개요
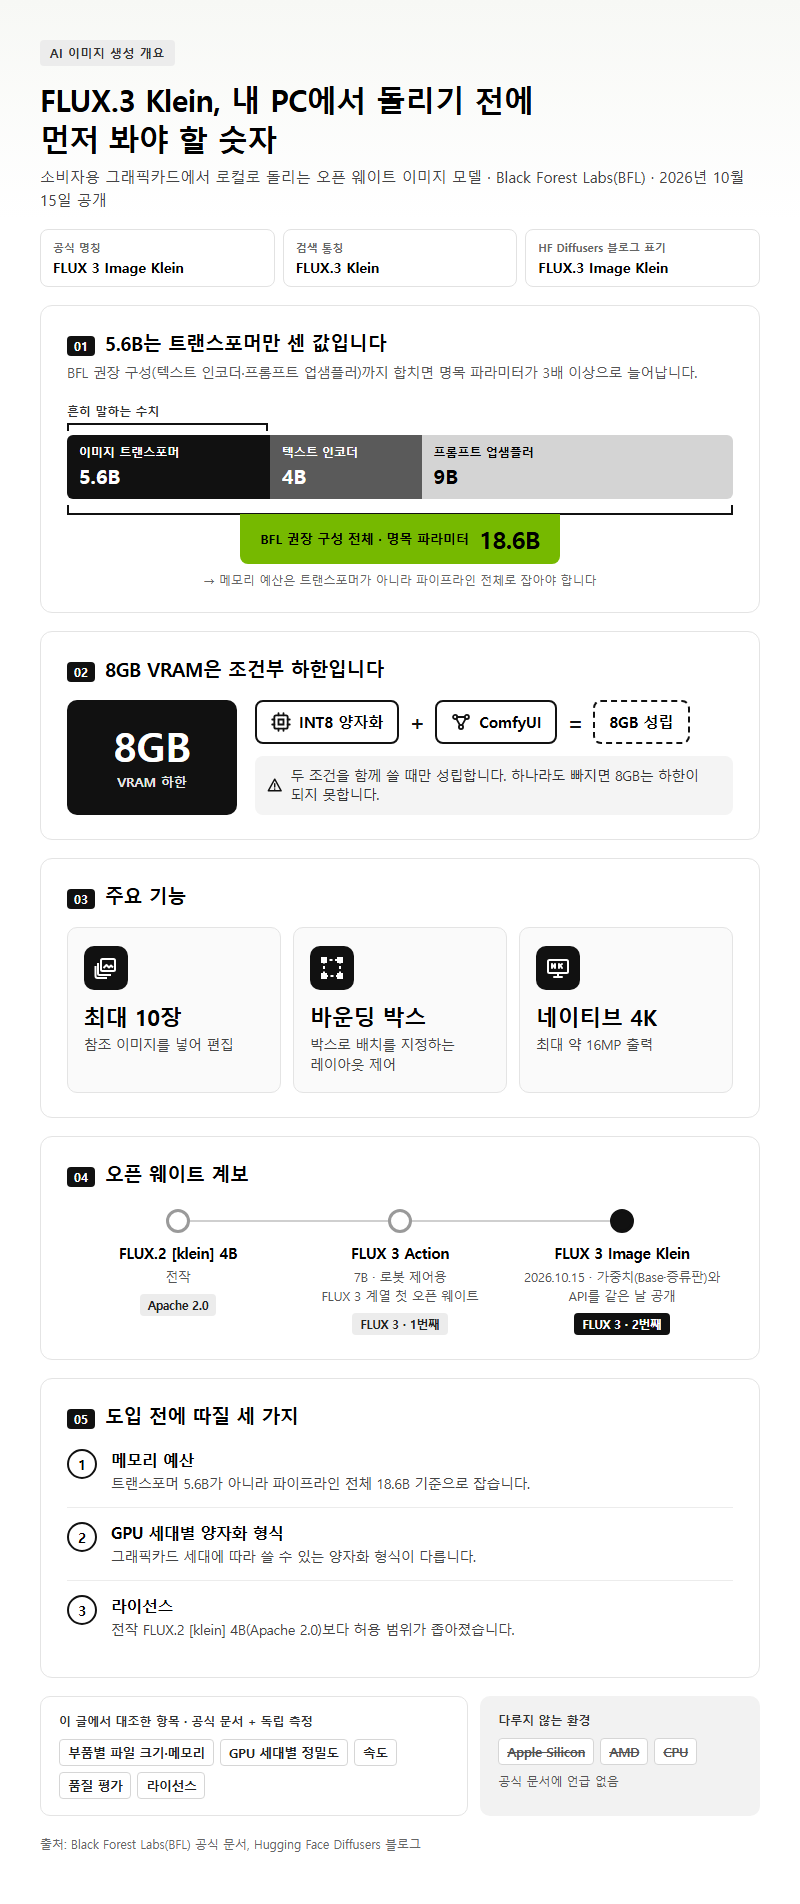
FLUX.3 Klein은 소비자용 그래픽카드에서 로컬로 돌릴 수 있는 오픈 웨이트 이미지 모델입니다. 다만 8GB VRAM은 INT8과 ComfyUI를 함께 쓸 때만 성립하는 하한입니다. 공식 명칭은 FLUX 3 Image Klein입니다. 흔히 말하는 5.6B는 이미지 트랜스포머만 센 값이고, 제작사 Black Forest Labs(BFL)가 권장하는 구성(텍스트 인코더 4B, 프롬프트 업샘플러 9B)까지 합치면 명목 파라미터는 18.6B입니다. 이 글에서는 파이프라인을 이루는 부품 4개의 파일 크기와 메모리, GPU 세대별 정밀도, 속도, 품질 평가, 라이선스를 공식 문서와 독립 측정으로 대조했습니다. Apple Silicon·AMD·CPU 환경은 공식 문서에 언급이 없어 다루지 않습니다.
BFL은 2026년 10월 15일 가중치(Base·증류판)와 API를 같은 날 공개했습니다. FLUX 3 계열에서 두 번째로 나온 오픈 웨이트이고, 첫 번째는 로봇 제어용 FLUX 3 Action(7B)이었습니다. 검색에서 많이 쓰는 FLUX.3 Klein은 통칭이고, Hugging Face Diffusers 블로그는 FLUX.3 Image Klein이라고 적었습니다. 기능은 참조 이미지 최대 10장 기반 편집, 바운딩 박스로 하는 레이아웃 제어, 네이티브 최대 4K(약 16MP) 출력입니다.
이 모델에 관심이 쏠리는 이유는 무료 AI 이미지 생성을 내 PC에서 하려는 수요에 정확히 맞춰 나왔기 때문입니다. 그런데 도입 판단에 걸리는 조건은 발표 문구보다 훨씬 많습니다. 메모리 예산은 트랜스포머가 아니라 파이프라인 전체로 잡아야 하고, GPU 세대에 따라 쓸 수 있는 양자화 형식이 다릅니다. 라이선스도 전작 FLUX.2 [klein] 4B(Apache 2.0)보다 좁아졌습니다. 아래에서 이 세 가지를 차례로 따져 봅니다.
1. FLUX.3 Klein 로컬 파이프라인은 부품 4개로 돌아간다
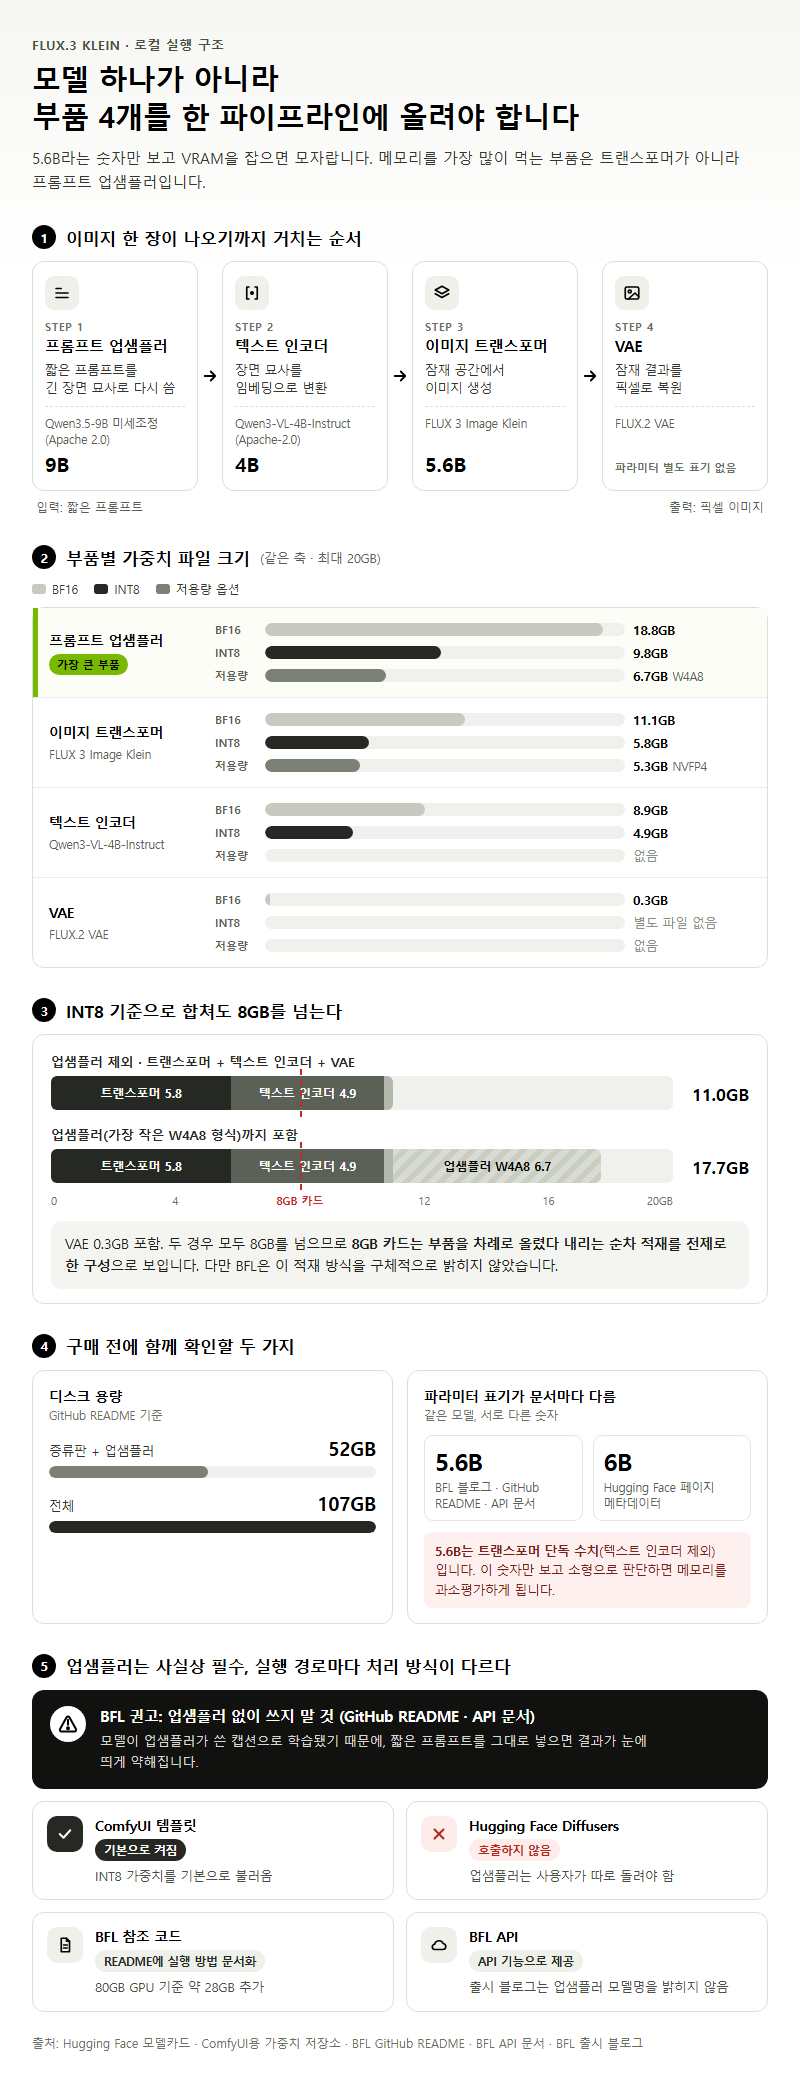
FLUX.3 Klein을 로컬에서 돌리려면 모델 하나가 아니라 부품 4개를 한 파이프라인으로 올려야 합니다. 순서는 이렇습니다. 짧은 프롬프트를 업샘플러가 긴 장면 묘사로 다시 쓰고, 텍스트 인코더가 이를 임베딩으로 바꿉니다. 이어서 5.6B 트랜스포머가 잠재 공간에서 이미지를 만들고, VAE가 그 결과를 픽셀로 복원합니다. Hugging Face 모델카드와 ComfyUI용 가중치 저장소에 공개된 부품별 사양은 다음과 같습니다.
| 부품 | 정체 | 파라미터 | BF16 파일 | INT8 파일 | 저용량 옵션 |
|---|---|---|---|---|---|
| 프롬프트 업샘플러 | Qwen3.5-9B 미세조정(Apache 2.0) | 9B | 18.8GB | 9.8GB | W4A8 6.7GB |
| 텍스트 인코더 | Qwen3-VL-4B-Instruct(Apache-2.0) | 4B | 8.9GB | 4.9GB | 없음 |
| 이미지 트랜스포머 | FLUX 3 Image Klein | 5.6B | 11.1GB | 5.8GB | NVFP4 5.3GB |
| VAE | FLUX.2 VAE | 별도 표기 없음 | 0.3GB | 별도 파일 없음 | 없음 |
가장 큰 부품은 트랜스포머가 아니라 업샘플러입니다. INT8 기준으로 트랜스포머·텍스트 인코더·VAE만 합쳐도 11.0GB이고, 업샘플러를 가장 작은 W4A8 형식으로 더하면 17.7GB가 됩니다. 두 경우 모두 8GB를 넘습니다. 결국 8GB 카드라면 부품을 차례로 올렸다 내리는 순차 적재를 전제로 한 구성으로 보이는데, BFL은 이 적재 방식을 구체적으로 밝히지 않았습니다. 디스크는 GitHub README 기준으로 증류판과 업샘플러만 52GB, 전체는 107GB가 필요합니다.
파라미터 표기도 문서마다 다릅니다. BFL 블로그·GitHub README·API 문서는 5.6B로 적었지만, 같은 Hugging Face 페이지의 메타데이터에는 6B로 나옵니다. 5.6B는 텍스트 인코더를 뺀 트랜스포머 단독 수치라, 5.6B만 보고 소형으로 판단하면 메모리를 과소평가하게 됩니다.
업샘플러는 사실상 선택 사항이 아닙니다. BFL은 GitHub README와 API 문서에서 업샘플러 없이 쓰지 말라고 권고했습니다. 모델이 업샘플러가 쓴 캡션으로 학습됐기 때문에 짧은 프롬프트를 그대로 넣으면 결과가 눈에 띄게 약해진다는 설명입니다. 문제는 실행 경로마다 업샘플러를 다루는 방식이 다르다는 점입니다.
| 실행 경로 | 업샘플러 처리 | 비고 |
|---|---|---|
| ComfyUI 템플릿 | 기본으로 켜짐 | INT8 가중치를 기본으로 불러옴 |
| Hugging Face Diffusers | 호출하지 않음 | 사용자가 따로 돌려야 함 |
| BFL 참조 코드 | README에 실행 방법 문서화 | 80GB GPU 기준 약 28GB 추가 |
| BFL API | API 기능으로 제공 | 출시 블로그는 업샘플러 모델명을 밝히지 않음 |
Diffusers로 서비스를 꾸린다면 방법은 두 가지입니다. 업샘플러를 별도 프로세스로 띄우거나, BFL이 제공하는 system_prompts.json을 써서 이미 운영 중인 다른 LLM에 프롬프트 확장을 맡기면 됩니다. 후자는 업샘플러 몫의 약 28GB를 아낄 수 있는 우회로입니다.
용어 풀이
1. 오픈 웨이트 — 가중치 파일을 내려받아 직접 실행할 수 있게 공개한 모델이며, 사용 범위는 별도 라이선스가 정합니다.
2. 텍스트 인코더 — 프롬프트 문장을 이미지 모델이 읽을 수 있는 수치 벡터(임베딩)로 바꾸는 언어 모델입니다.
3. VAE — 트랜스포머가 만든 압축된 잠재 표현을 실제 픽셀 이미지로 복원하는 디코더 부품입니다.
2. FLUX Klein VRAM 공식 하한이 8GB와 RTX 3090 둘인 이유
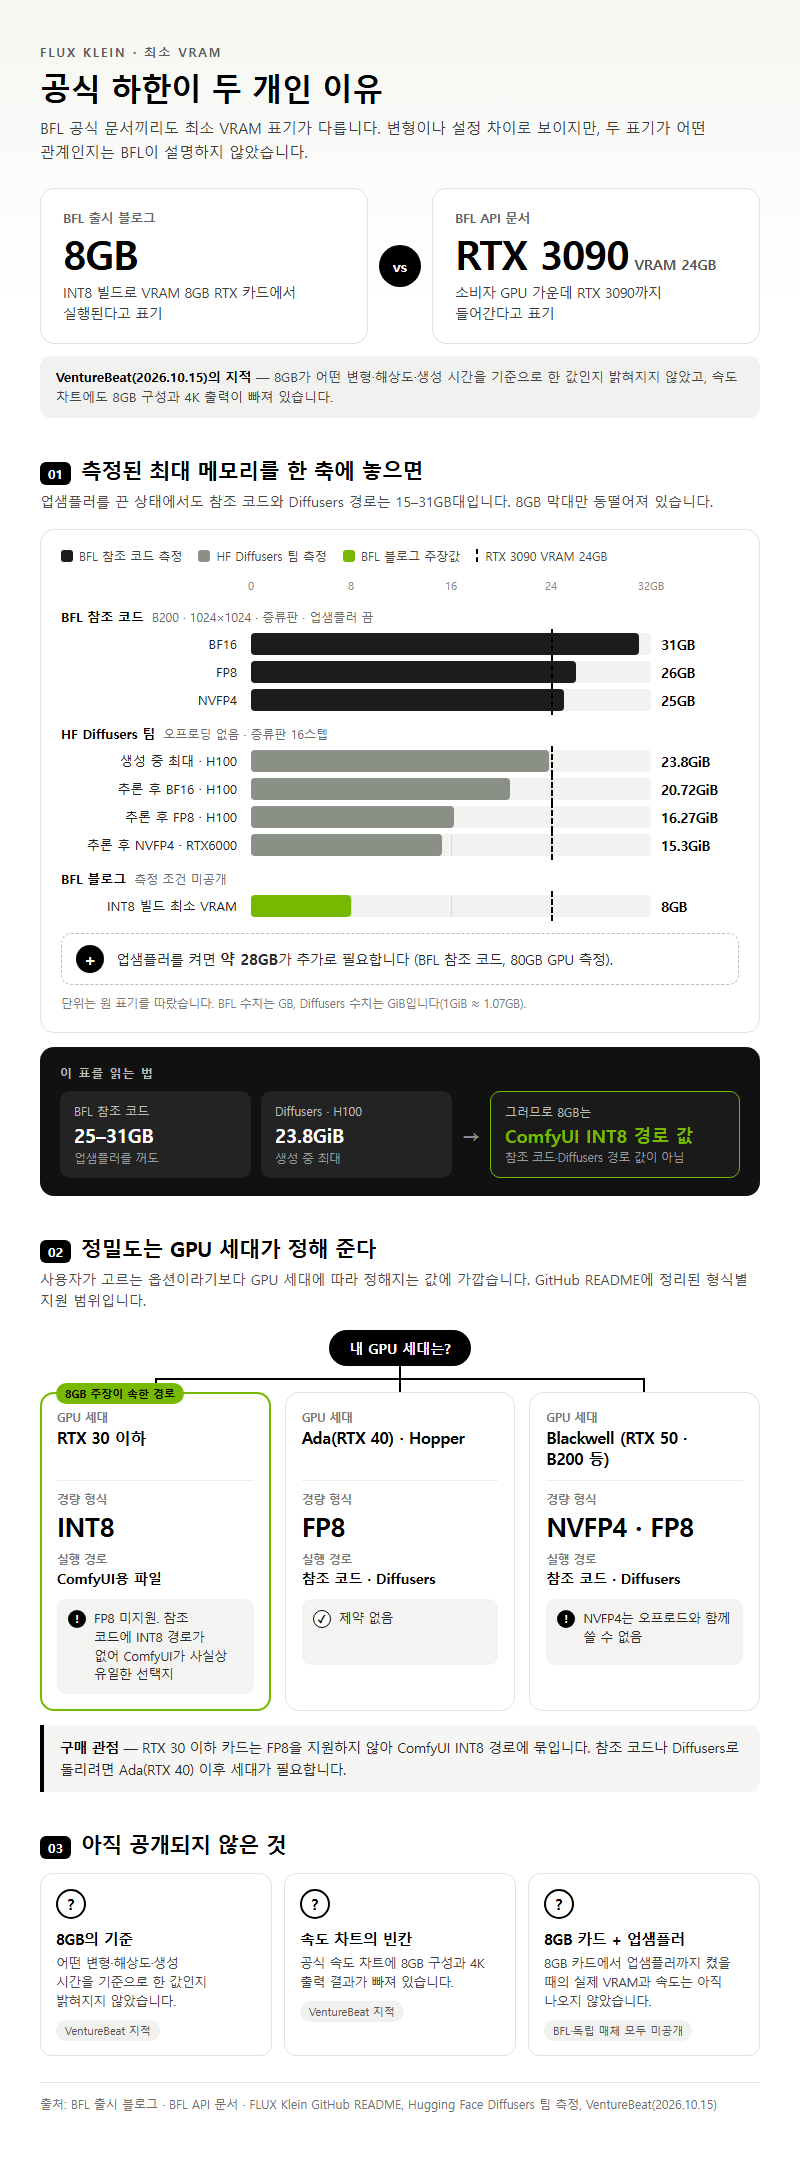
FLUX Klein의 최소 VRAM은 공식 문서끼리도 8GB와 RTX 3090으로 갈립니다. BFL 출시 블로그는 INT8 빌드로 8GB VRAM RTX 카드에서 돈다고 했고, API 문서는 소비자 GPU 가운데 RTX 3090까지 들어간다고 적었습니다. 변형이나 설정이 달라서 생긴 차이로 보이지만, BFL은 두 표기가 어떤 관계인지 설명하지 않았습니다. VentureBeat도 2026년 10월 15일 기사에서 이 부분을 짚었습니다. 8GB가 어떤 변형·해상도·생성 시간을 기준으로 한 값인지 밝혀지지 않았고, 속도 차트에도 8GB 구성과 4K 출력이 빠져 있다는 지적입니다.
| 측정 주체 | 환경·조건 | 정밀도·항목 | 메모리 |
|---|---|---|---|
| BFL 참조 코드 | B200, 1024×1024, 증류판, 업샘플러 끔 | BF16 | 최대 31GB |
| BFL 참조 코드 | 같은 조건 | FP8 | 최대 26GB |
| BFL 참조 코드 | 같은 조건 | NVFP4 | 최대 25GB |
| BFL 참조 코드 | 80GB GPU | 업샘플러 추가분 | 약 28GB |
| HF Diffusers 팀 | H100 80GB, 오프로딩 없음, 증류판 16스텝 | 생성 중 최대 | 23.8GiB |
| HF Diffusers 팀 | H100 | 추론 후 최대 할당 BF16 / FP8 | 20.72GiB / 16.27GiB |
| HF Diffusers 팀 | RTX6000 | 추론 후 최대 할당 NVFP4 | 15.3GiB |
| BFL 블로그 | INT8 빌드 | 최소 VRAM 주장 | 8GB |
이 표는 측정 조건을 함께 보면서 읽어야 합니다. BFL 참조 코드는 업샘플러를 꺼도 최대 25-31GB를 쓰고, Diffusers 팀 측정에서도 H100 최대치가 23.8GiB였습니다. 그러니 8GB 주장은 참조 코드나 Diffusers 경로가 아니라 ComfyUI INT8 경로에 해당하는 값으로 봐야 합니다. 8GB 카드에서 업샘플러까지 켰을 때의 실제 VRAM과 속도는 BFL도 독립 매체도 아직 공개하지 않았습니다.
정밀도는 사용자가 고르는 옵션이라기보다 GPU 세대가 정해 주는 값에 가깝습니다. GitHub README에 정리된 형식별 지원 범위를 옮기면 아래와 같습니다.
| GPU 세대 | 쓸 수 있는 경량 형식 | 실행 경로 | 제약 |
|---|---|---|---|
| RTX 30 이하 | INT8 | ComfyUI용 파일 | 참조 코드에 INT8 경로 없음 |
| Ada(RTX 40)·Hopper | FP8 | 참조 코드·Diffusers | 없음 |
| Blackwell(RTX 50, B200 등) | NVFP4, FP8 | 참조 코드·Diffusers | NVFP4는 오프로드와 함께 사용 불가 |
RTX 30 이하 카드는 FP8을 지원하지 않아 INT8이 유일한 경량 경로입니다. 그런데 BFL 참조 코드에는 이 경로가 없어서 ComfyUI가 사실상 유일한 선택지가 됩니다. Blackwell의 NVFP4는 트랜스포머 파일이 5.3GB로 가장 작습니다. 하지만 오프로드와 함께 쓸 수 없어서, VRAM이 작은 카드에서 부품을 내렸다 올리는 방식과는 맞지 않습니다.
ComfyUI는 0.41.0 이상 버전이 필요합니다. 템플릿은 INT8을 기본으로 불러오고, BF16 전환은 VRAM이 24GB를 넘을 때만 권장합니다. 참조 이미지는 템플릿에서 약 1MP로 줄여 처리됩니다. 가중치는 Hugging Face의 게이트 저장소에 있어서, 연락처를 제출하고 조건에 동의해야 내려받을 수 있습니다.
용어 풀이
1. 양자화(INT8·FP8·NVFP4) — 가중치를 더 적은 비트로 저장해 메모리와 연산량을 줄이는 기법이며, 지원 형식은 GPU 하드웨어 세대마다 다릅니다.
2. 오프로드 — 당장 쓰지 않는 모델 부품을 GPU 메모리에서 시스템 메모리로 내려 VRAM 사용량을 줄이는 방식입니다.
3. 증류판 16스텝과 Base 50스텝, GPU별 생성 속도
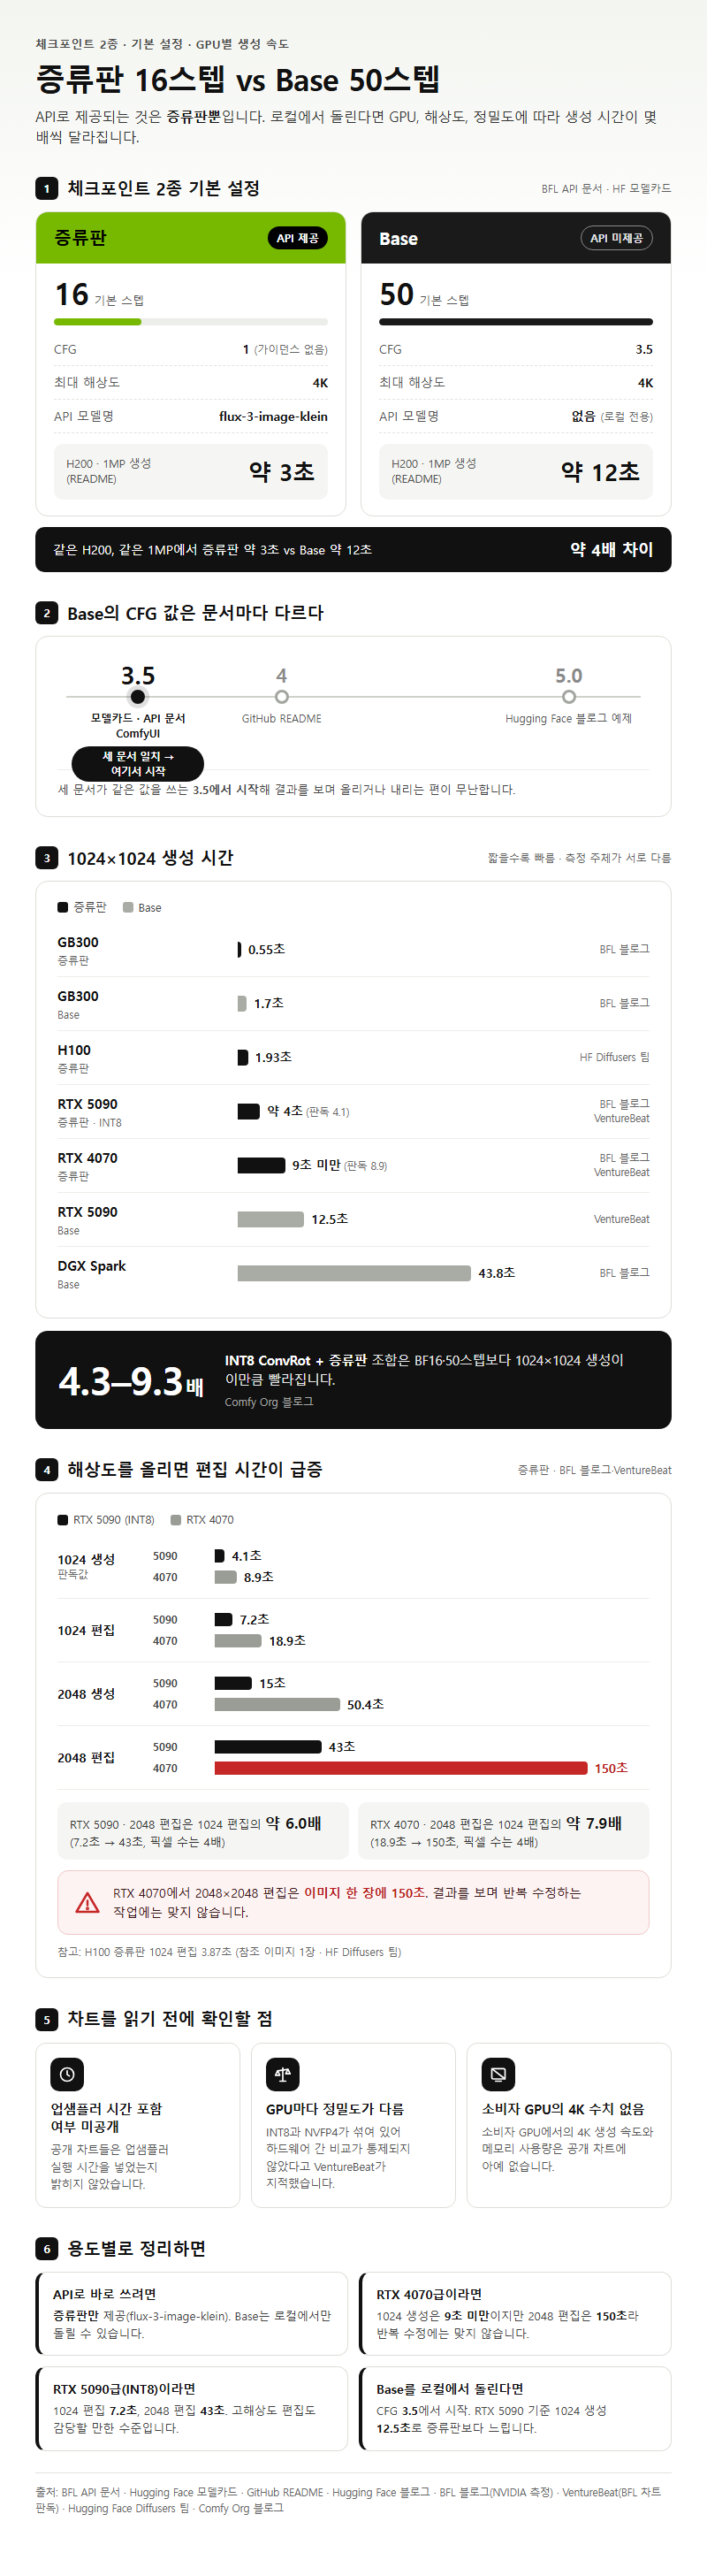
체크포인트는 2종이며, API로 제공되는 것은 증류판뿐입니다. BFL API 문서와 Hugging Face 모델카드에 나온 기본 설정은 다음과 같습니다.
| 항목 | 증류판 | Base |
|---|---|---|
| 기본 스텝 | 16 | 50 |
| CFG | 1(가이던스 없음) | 3.5 |
| 최대 해상도 | 4K | 4K |
| API 제공 | 제공(flux-3-image-klein) | 미제공 |
| H200 1MP 생성(README) | 약 3초 | 약 12초 |
Base의 CFG 값은 문서마다 다르게 적혀 있습니다. 모델카드·API 문서·ComfyUI는 3.5, GitHub README는 4, Hugging Face 블로그 예제는 5.0을 씁니다. 세 문서가 같은 값을 쓰는 3.5에서 시작해 결과를 보며 조정하는 편이 무난합니다.
속도는 측정 주체와 정밀도가 제각각이라 출처를 함께 봐야 합니다. 아래 표에는 BFL 블로그(NVIDIA 측정), VentureBeat의 BFL 차트 판독값, Hugging Face Diffusers 팀 실측을 모았습니다.
| GPU | 체크포인트·정밀도 | 1024 생성 | 1024 편집 | 2048 생성 | 2048 편집 | 출처 |
|---|---|---|---|---|---|---|
| GB300 | 증류판 | 0.55초 | 공개 안 됨 | 공개 안 됨 | 공개 안 됨 | BFL 블로그 |
| H100 | 증류판 | 1.93초 | 3.87초(참조 1장) | 공개 안 됨 | 공개 안 됨 | HF Diffusers 팀 |
| RTX 5090 | 증류판 INT8 | 약 4초(판독 4.1초) | 7.2초 | 15초 | 43초 | BFL 블로그·VentureBeat |
| RTX 4070 | 증류판 | 9초 미만(판독 8.9초) | 18.9초 | 50.4초 | 150초 | BFL 블로그·VentureBeat |
| GB300 | Base | 1.7초 | 공개 안 됨 | 공개 안 됨 | 공개 안 됨 | BFL 블로그 |
| RTX 5090 | Base | 12.5초 | 공개 안 됨 | 공개 안 됨 | 공개 안 됨 | VentureBeat |
| DGX Spark | Base | 43.8초 | 공개 안 됨 | 공개 안 됨 | 공개 안 됨 | BFL 블로그 |
실무에서 눈여겨볼 값은 해상도를 올렸을 때의 편집 시간입니다. RTX 4070에서 2048×2048 편집은 이미지 한 장에 150초가 걸려, 결과를 보며 반복 수정하는 작업에는 맞지 않습니다. 이 차트들은 업샘플러 실행 시간이 포함됐는지도 밝히지 않았습니다. VentureBeat는 GPU마다 정밀도가 달라(INT8과 NVFP4) 하드웨어 간 비교가 통제되지 않았다고도 지적했습니다. 소비자 GPU에서의 4K 생성 속도와 메모리는 공개 차트에 아예 없습니다.
Comfy Org 블로그는 INT8 ConvRot와 증류판을 조합하면 BF16·50스텝보다 1024×1024 생성이 4.3-9.3배 빨라진다고 밝혔습니다. RTX 5070은 71초에서 8초 미만으로, RTX 4070은 78초에서 9초 미만으로 줄었다는 설명입니다. 다만 누가 측정했는지는 밝히지 않았습니다.
전작 FLUX.2 [klein] 9B는 4스텝 증류에 GB200 BF16 기준 0.5초 미만을 내세웠는데, 이번 증류판은 16스텝입니다. 같은 하드웨어에서 두 모델을 비교한 속도는 공개되지 않았습니다. AlphaSignal 보도에 따르면 BFL은 출시 뒤 후속 안내에서 2K 해상도를 권장하고, ComfyUI 0.41.3 기준으로 워크플로를 개정했다고 합니다.
같은 보도는 업샘플러를 출시 후에 추가된 업그레이드로 소개했습니다. 하지만 GitHub README는 출시 시점부터 업샘플러를 문서화하고 있었고, OrcaRouter가 분석한 Hugging Face 메타데이터에서도 업샘플러 저장소 생성일은 2026년 10월 14일입니다. 업샘플러는 모델과 동시에 공개됐고, 나중에 나온 것은 권장 설정 안내로 보는 편이 맞습니다.
용어 풀이
1. 증류(Distillation) — 원래 모델의 결과를 더 적은 스텝으로 재현하도록 다시 학습시켜 생성 속도를 높이는 기법입니다.
2. CFG(Classifier-Free Guidance) — 프롬프트를 얼마나 강하게 따를지 정하는 가중치이며, 1로 두면 가이던스를 적용하지 않습니다.
3. 스텝 — 노이즈에서 출발해 이미지를 다듬어 가는 반복 횟수로, 많을수록 생성 시간이 늘어납니다.
4. AI 이미지 생성 순위에서 FLUX.3 Klein의 현재 위치
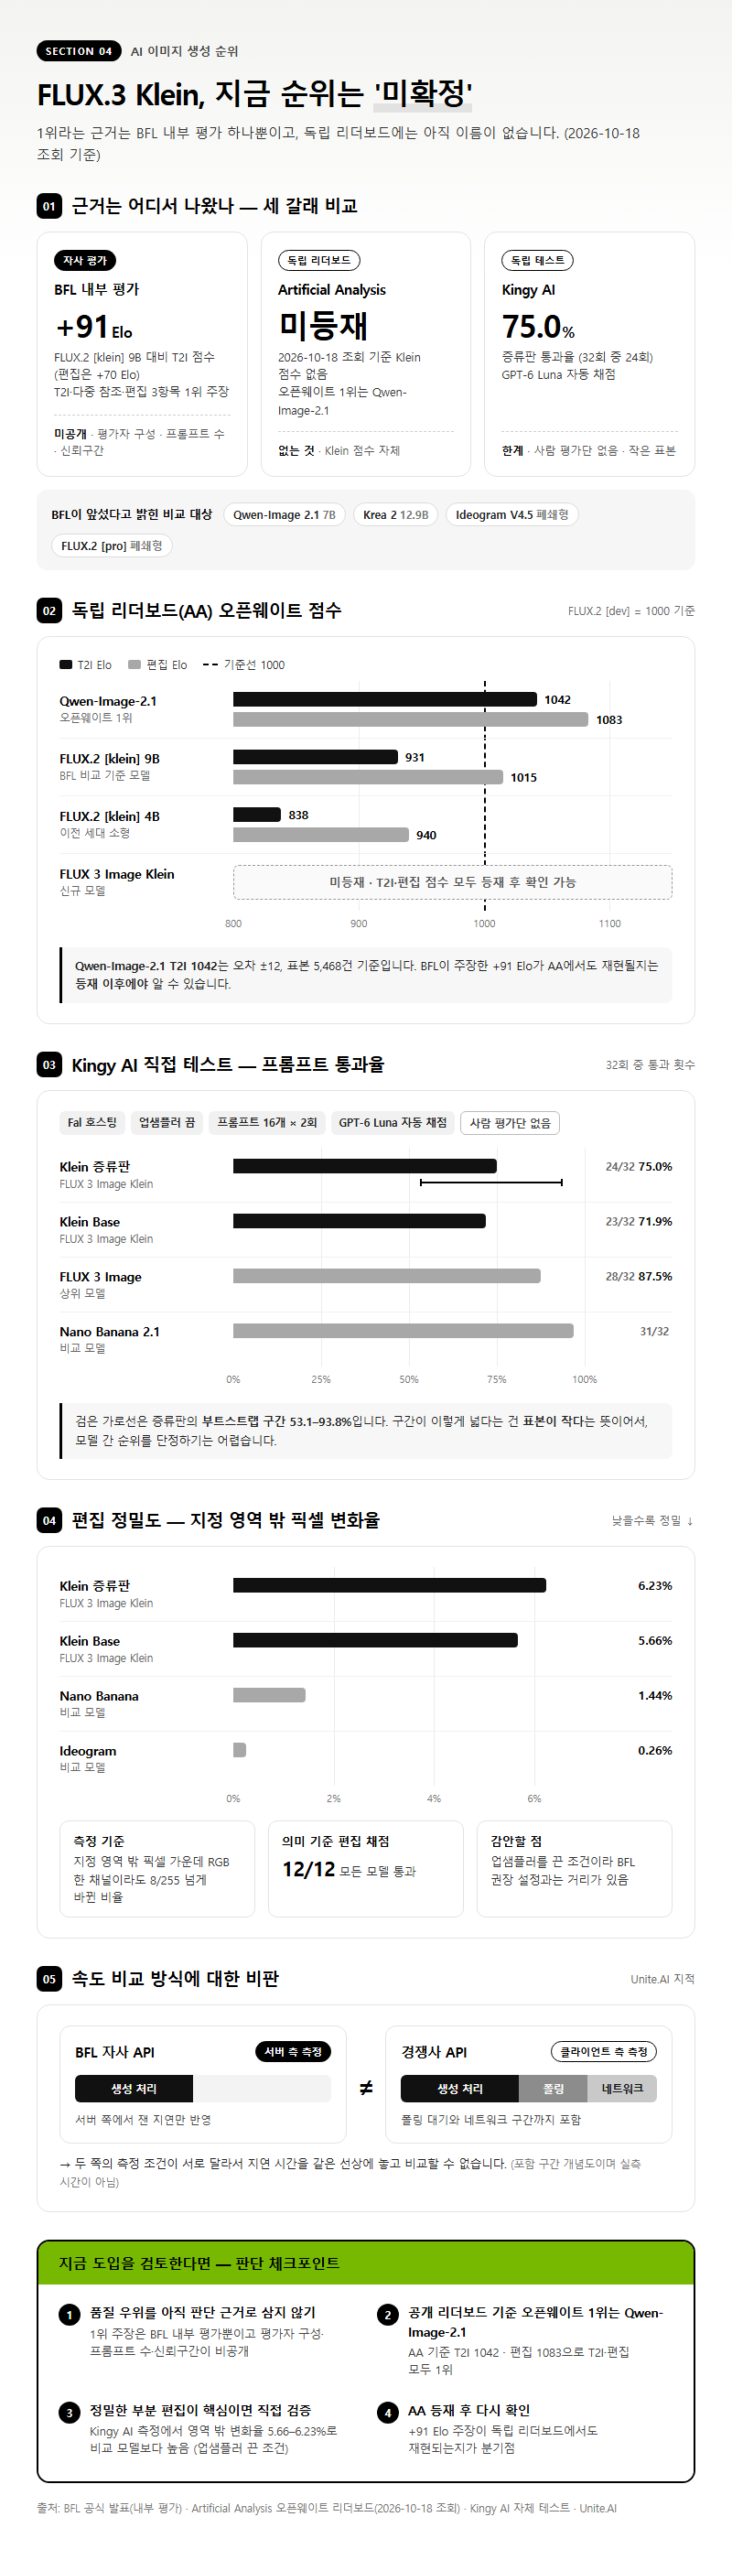
AI 이미지 생성 순위로 보면, Klein이 앞선다는 근거는 아직 BFL 내부 평가 하나뿐입니다. BFL은 텍스트→이미지(T2I), 다중 참조, 편집 세 항목에서 모두 1위라고 밝혔습니다. 기준 모델인 FLUX.2 [klein] 9B보다 T2I는 +91 Elo, 편집은 +70 Elo 높다는 주장입니다. 비교 대상인 Qwen-Image 2.1(7B)·Krea 2(12.9B)는 물론, 폐쇄형인 Ideogram V4.5와 FLUX.2 [pro]보다도 높게 평가했다고 합니다. 그러나 평가자 구성, 프롬프트 수, 신뢰구간은 공개하지 않았습니다.
독립 리더보드인 Artificial Analysis(AA)에는 2026년 10월 18일 조회 기준으로 Klein이 아직 등재되지 않았습니다. AA 오픈웨이트 리더보드(FLUX.2 [dev]=1000 기준)에서 주요 점수만 추렸습니다.
| 모델 | T2I Elo | 편집 Elo |
|---|---|---|
| Qwen-Image-2.1 | 1042(±12, 표본 5,468) | 1083 |
| FLUX.2 [klein] 9B | 931 | 1015 |
| FLUX.2 [klein] 4B | 838 | 940 |
| FLUX 3 Image Klein | 미등재 | 미등재 |
공개 리더보드에서 오픈웨이트 T2I·편집 1위는 여전히 Qwen-Image-2.1입니다. BFL의 +91 Elo 주장이 AA에서도 재현될지는 등재 이후에야 알 수 있습니다. 그 전까지는 품질 우위를 판단의 근거로 삼지 않는 편이 안전합니다.
Kingy AI가 직접 테스트한 결과도 있습니다. 조건은 Fal 호스팅, 업샘플러 끔, 프롬프트 16개를 2회씩, GPT-6 Luna 자동 채점이었고 사람 평가단은 없었습니다. 증류판은 32회 중 24회(75.0%)를 통과했지만, 부트스트랩 구간이 53.1-93.8%로 넓어 표본이 작다는 점을 감안해야 합니다.
| 모델 | 통과 | 통과율 |
|---|---|---|
| FLUX 3 Image Klein 증류판 | 24/32 | 75.0% |
| FLUX 3 Image Klein Base | 23/32 | 71.9% |
| FLUX 3 Image(상위 모델) | 28/32 | 87.5% |
| Nano Banana 2.1 | 31/32 | 별도 표기 없음 |
편집 정밀도에서는 차이가 더 분명했습니다. Kingy AI는 지정 영역 밖 픽셀 가운데 RGB 한 채널이라도 8/255 넘게 바뀐 비율을 쟀습니다. 결과는 Klein 증류판 6.23%, Base 5.66%로, Nano Banana(1.44%)·Ideogram(0.26%)보다 높았습니다. 의미 기준 편집 채점은 모든 모델이 12/12로 통과했습니다. 다만 업샘플러를 끈 조건이어서 BFL 권장 설정과는 거리가 있습니다.
비교 방식 자체도 비판을 받았습니다. Unite.AI에 따르면 BFL은 자사 API 지연을 서버 측에서, 경쟁사는 폴링과 네트워크를 포함한 클라이언트 측에서 재서 측정 조건이 서로 달랐습니다. VentureBeat는 GPT Image 2.5, Nano Banana 2.1, Krea 3가 BFL 비교표에서 빠졌다고 지적했습니다.
5. 무료 AI 이미지 생성으로 써도 되나(라이선스·API 가격·모델 추천)
상업 이용은 출력물까지만 되는 라이선스
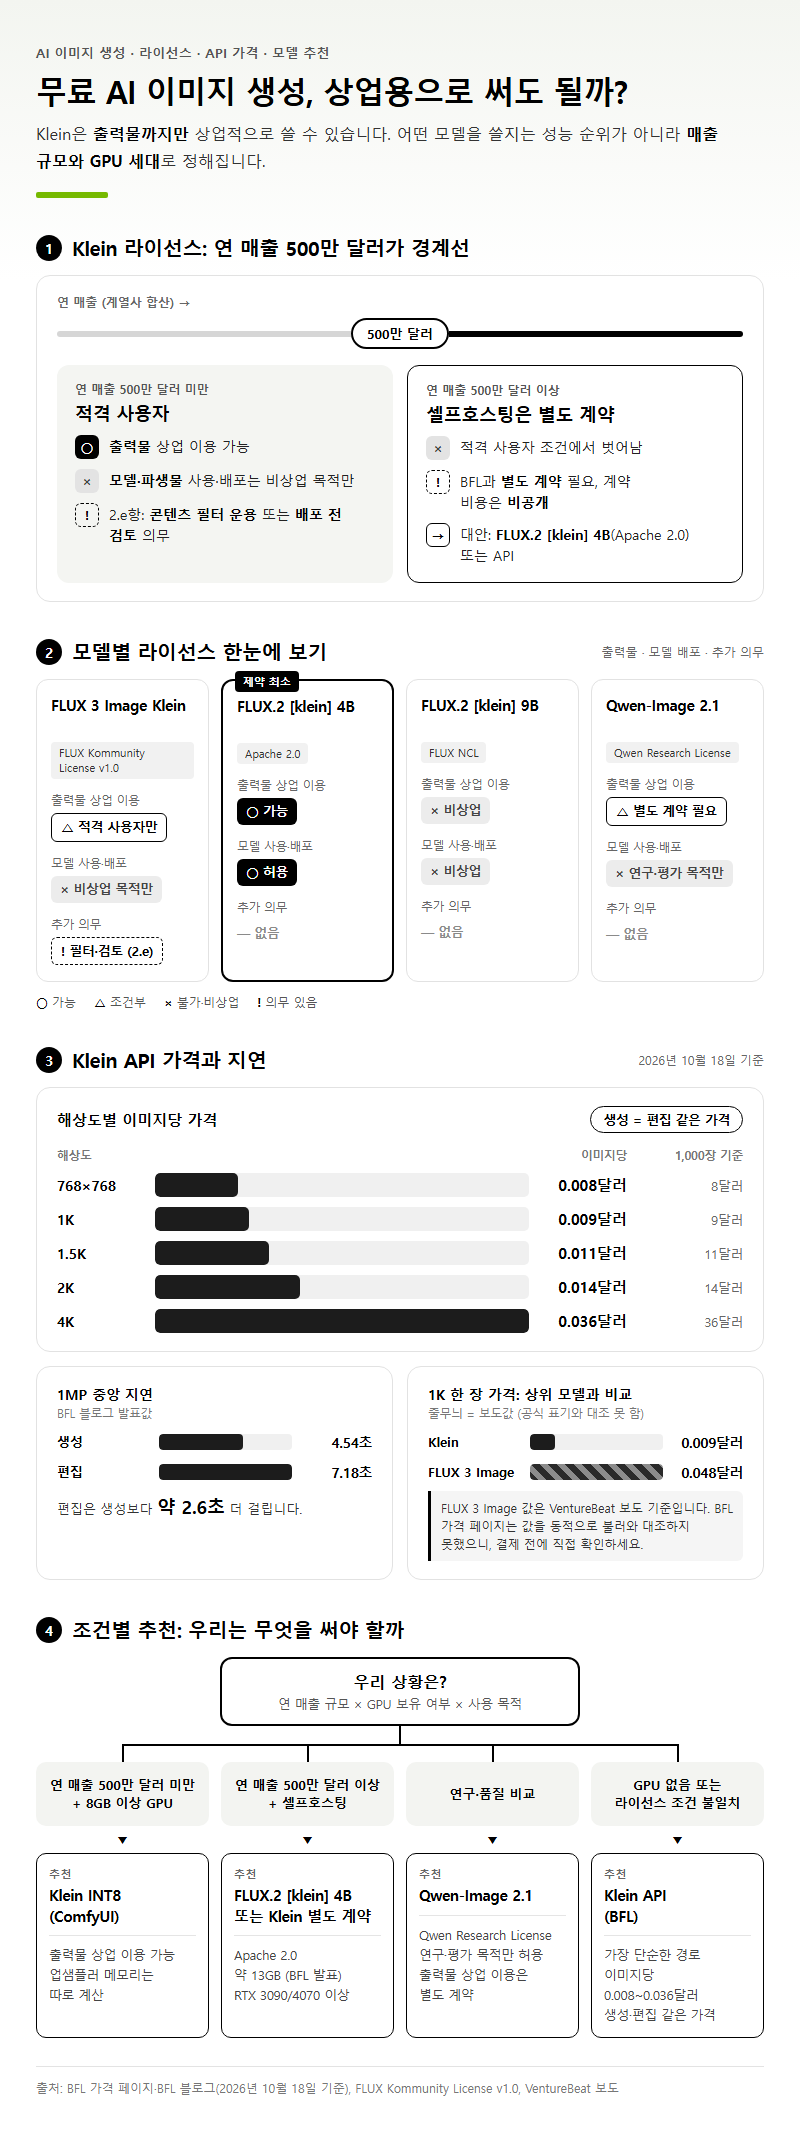
무료 AI 이미지 생성 모델로 Klein을 검토한다면 라이선스부터 확인해야 합니다. Klein은 FLUX Kommunity License v1.0을 따르며, 적격 사용자는 연 매출 500만 달러 미만(계열사 합산)인 경우로 한정됩니다. 적격 사용자는 출력물을 상업적으로 쓸 수 있지만, 모델과 파생물의 사용·배포는 비상업 목적으로만 할 수 있습니다.
| 항목 | FLUX 3 Image Klein | FLUX.2 [klein] 4B | FLUX.2 [klein] 9B | Qwen-Image 2.1 |
|---|---|---|---|---|
| 라이선스 | FLUX Kommunity License v1.0 | Apache 2.0 | FLUX NCL | Qwen Research License |
| 출력물 상업 이용 | 적격 사용자만 가능 | 가능 | 비상업 | 별도 계약 필요 |
| 모델 사용·배포 | 비상업 목적만 | 허용 | 비상업 | 연구·평가 목적만 |
| 추가 의무 | 콘텐츠 필터 운용 또는 배포 전 검토(2.e) | 없음 | 없음 | 없음 |
출력물을 쓸 수 있다고 의무까지 없는 것은 아닙니다. 라이선스 2.e항에 따라 콘텐츠 필터를 운용하거나 배포 전 검토를 해야 합니다. 매출 500만 달러 이상인 기업이 셀프호스팅하려면 별도 계약이 필요한데, BFL은 그 비용을 공개하지 않았습니다.
API 가격과 지연(2026년 10월 18일 기준)
GPU가 없거나 라이선스 조건이 맞지 않으면 API가 가장 단순한 경로입니다. BFL 가격 페이지 기준으로 생성과 편집의 가격이 같습니다.
| 해상도 | 768×768 | 1K | 1.5K | 2K | 4K |
|---|---|---|---|---|---|
| 이미지당 가격 | 0.008달러 | 0.009달러 | 0.011달러 | 0.014달러 | 0.036달러 |
BFL 블로그가 밝힌 1MP 중앙 지연은 생성 4.54초, 편집 7.18초입니다. 상위 모델 FLUX 3 Image의 1K 가격은 VentureBeat 보도 기준 0.048달러입니다. BFL 가격 페이지는 이 값을 동적으로 불러오는 구조라 공식 표기와 대조하지 못했으니, 결제 전에 직접 한 번 더 확인하는 편이 좋습니다.
조건별 AI 이미지 생성 추천
AI 이미지 생성 모델 추천은 성능 순위보다 매출 규모와 GPU 세대에 따라 갈립니다. 앞서 본 근거를 조합하면 이렇게 나뉩니다.
| 상황 | 추천 | 판단 근거 |
|---|---|---|
| 연 매출 500만 달러 미만, 8GB 이상 GPU | Klein INT8(ComfyUI) | 출력물 상업 이용 가능, 업샘플러 메모리는 따로 계산 |
| 연 매출 500만 달러 이상, 셀프호스팅 | FLUX.2 [klein] 4B 또는 Klein 별도 계약 | Apache 2.0, BFL 발표 기준 약 13GB(RTX 3090/4070 이상) |
| 연구·품질 비교 | Qwen-Image 2.1 | AA 오픈웨이트 1위, 생성부 7B, 참조 10장 |
| 속도 우선, 비상업 | FLUX.2 [klein] 9B | 4스텝 증류, 8B Qwen3 텍스트 임베더 |
| GPU 없음 | Klein API | 1K 0.009달러부터 |
Qwen-Image 2.1은 라이선스 문서에 적힌 공개일이 2026년 9월 20일입니다. 독립 근거는 가장 많지만 상업 이용에는 별도 계약이 필요하다는 점에서 Klein과 쓰임새가 다릅니다.
자주 묻는 질문
8GB 그래픽카드로 업샘플러까지 켜고 돌릴 수 있나요? 이 구성의 VRAM과 속도는 BFL도 독립 매체도 공개하지 않았습니다. INT8 파일에 W4A8 업샘플러까지 더하면 17.7GB라, 순차 적재 과정에서 속도가 크게 떨어지는 것은 감안해야 합니다. 업샘플러를 다른 LLM에 맡기거나 장면을 문장으로 길게 직접 묘사하는 쪽이 현실적인 대안입니다.
Apple Silicon이나 AMD GPU에서도 돌아가나요? GitHub README에는 Apple Silicon·AMD·CPU 지원 언급이 없습니다. 공개된 양자화 형식(INT8·FP8·NVFP4)과 측정 환경이 모두 NVIDIA 기준이라, 현재로서는 NVIDIA GPU 전제로 계획하는 편이 안전합니다.
정리
FLUX.3 Klein을 로컬에서 돌릴 때 정밀도는 GPU 세대가 정합니다. RTX 30 이하는 INT8(ComfyUI 전용), Ada·Hopper는 FP8, Blackwell은 NVFP4를 씁니다. 메모리 예산은 5.6B 트랜스포머가 아니라 업샘플러를 포함한 파이프라인 전체로 잡아야 합니다. 8GB 주장은 INT8·ComfyUI 경로의 하한일 뿐이고, 업샘플러까지 켠 8GB 측정값은 아직 공개되지 않았습니다. 품질 우위를 뒷받침하는 근거는 BFL 내부 평가뿐이며, 공개 리더보드 1위는 여전히 Qwen-Image-2.1입니다. 라이선스는 연 매출 500만 달러 미만 사업자의 출력물 상업 이용까지만 허용합니다.
참고 자료
조사 기준일: 2026년 10월 19일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (원문 대조, 2026-10-18 확인)
- BFL 블로그 — FLUX 3 Image Klein: https://bfl.ai/blog/flux-3-image-klein
- GitHub 참조 코드 README: https://github.com/black-forest-labs/flux-3-image-klein
- HF 모델카드(증류판): https://huggingface.co/black-forest-labs/flux-3-image-klein
- HF 라이선스 원문(FLUX Kommunity License v1.0): https://huggingface.co/black-forest-labs/flux-3-image-klein/blob/main/LICENSE.md
- HF ComfyUI 가중치 저장소: https://huggingface.co/black-forest-labs/flux-3-image-klein-comfy
- HF 프롬프트 업샘플러 카드: https://huggingface.co/black-forest-labs/flux-3-image-klein-pup
- BFL API 문서 — Klein: https://docs.bfl.ml/flux_3/flux3_image_klein
- BFL API 가격 페이지: https://docs.bfl.ml/quick_start/pricing
- ComfyUI 공식 문서(통합 사실에 한해 T1): https://docs.comfy.org/tutorials/flux/flux-3-klein
- BFL 블로그 — FLUX.2 [klein]: https://bfl.ai/blog/flux2-klein-towards-interactive-visual-intelligence
- HF Qwen-Image-2.1 모델카드: https://huggingface.co/Qwen/Qwen-Image-2.1
- HF Qwen-Image-2.1 라이선스: https://huggingface.co/Qwen/Qwen-Image-2.1/blob/main/LICENSE
- Artificial Analysis T2I 오픈웨이트 리더보드: https://artificialanalysis.ai/image/leaderboard/text-to-image/open-weights
- Artificial Analysis 편집 오픈웨이트 리더보드: https://artificialanalysis.ai/image/leaderboard/editing/open-weights
- HF Diffusers 블로그(H100 실측): https://huggingface.co/blog/flux-3
- VentureBeat(Carl Franzen, 2026-10-15): https://venturebeat.com/technology/black-forest-labs-opens-flux-3-image-klein-weights-with-free-commercial-use-limited-to-smaller-businesses
- Kingy AI 실측 리뷰: https://kingy.ai/blog/flux-3-image-klein-tested-benchmarks-costs/
- Unite.AI: https://www.unite.ai/new-5-6b-parameter-flux-3-image-klein-debuts-as-open-weights-release/
- Comfy Org 블로그: https://blog.comfy.org/p/flux-3-image-klein-in-comfyui-56b
답글 남기기