

Muse Ember의 토큰 정가는 Claude Haiku 5.5·GPT-6 Luna와 같습니다. 작업당 비용이 3분의 1로 내려가는 조건과 뒤집히는 구간을 캐시 단가·프롬프트 길이·벤치마크 측정 조건으로 비교했습니다.
이 글에는 네이버 브랜드커넥트 제휴 링크가 포함되어 있습니다. 링크를 통해 구매가 이루어지면 작성자가 일정액의 수수료를 지급받습니다. 제품 선택과 구매는 독자의 판단이며, 이 글은 특정 제품의 효과를 보증하지 않습니다.
메타 뮤즈, 무엇을 기준으로 비교해야 할까
Muse Ember는 캐시가 많이 걸리는 반복 에이전트 루프에서 유리합니다. 다만 토큰 정가는 Claude Haiku 5.5·GPT-6 Luna와 같습니다. Muse Ember의 기본 구간 가격은 2026년 11월 11일 기준 100만 토큰당 입력 $0.10, 출력 $0.50입니다. Meta가 강조한 3분의 1 수준 비용은 Artificial Analysis(이하 AA) 지수 과제의 작업당 비용 $0.136 대 $0.411에서 나온 값입니다. 이 글에서는 세 모델을 가격 구간·캐시 단가·벤치마크 측정 조건으로 비교합니다. AA 모델 페이지가 가중치를 비공개로 표기해 로컬 실행은 다루지 않습니다.
메타 뮤즈 뜻부터 짚으면, 한 제품의 이름이 아니라 Meta의 AI 모델 브랜드입니다. TechCrunch 2026년 11월 9일 보도에 따르면 Ember는 Spark, Glimmer, Wonder에 이은 Muse 브랜드 네 번째 모델입니다. Meta는 같은 날 공식 블로그 “Introducing Our Smallest, Most Efficient Model: Muse Ember”에서 역할 분담을 “Muse Wonder plans, Muse Ember handles the volume.”이라는 한 문장으로 요약했습니다. 대상은 도구 호출, 코딩 하위 작업, 라우팅, 문서 처리처럼 반복 실행량이 많은 작업입니다.
발표문의 평가표만으로는 판단이 서지 않아 비교 기준이 따로 필요합니다. Meta 블로그 평가표 10개 행에서 Ember는 7개 단독 우위, 2개 동률, 1개 열세이지만, 행마다 측정 주체와 실행 환경이 다릅니다. Meta 평가 리포트도 내부에서 돌린 경쟁 모델 결과에 “prompts, tools, and runtime may not be optimally tuned for proprietary models.”라는 단서를 달았습니다. 정가가 같은 세 모델의 비용은 캐시 단가, 긴 프롬프트 할증, 토큰 사용량 세 조건에서 갈립니다.
비교 기준 정리
아래 표는 세 모델을 나란히 놓을 때 봐야 할 항목과 단위입니다. 가격은 모두 2026년 11월 11일 각사 공식 문서 기준이며 100만 토큰당 달러입니다.
| 비교 기준 | 단위 | 볼 때 주의할 점 |
|---|---|---|
| 토큰 정가 | 100만 토큰당 달러 | 기본 구간은 세 모델 모두 입력 $0.10, 출력 $0.50으로 같아 변별력이 없음 |
| 캐시 입력 단가 | 100만 토큰당 달러 | Ember $0.004, Luna $0.01. 같은 프롬프트를 반복 전송하는 에이전트 루프에서 비중이 큼 |
| 긴 프롬프트 할증 | 경계 토큰 수, 배수 | 경계가 Haiku 100K, Ember 200K, Luna 272K로 다르고 배수도 다름 |
| 토큰 사용량 | 작업당 달러 | 정가가 같아도 출력 토큰을 적게 쓰면 작업당 비용이 내려감 |
| 벤치마크 측정 조건 | 하네스, 추론 설정 | 같은 행 안에서도 모델마다 실행 환경이 다른 경우가 있음 |
| 지표 정의 | 부분 점수, 완전 통과율 | 같은 벤치마크라도 어느 지표인지에 따라 수치가 크게 달라짐 |
| 배치 할인 | 할인율 | Haiku·Luna는 50%, Ember는 Meta 개발자 모델 페이지에 항목이 없음 |
| 출시 단계·지역 | GA 여부, 제공 지역 | Meta는 GA·프리뷰 구분과 지역 제한을 공개하지 않음 |
작업당 비용이 3분의 1이 되는 구조는 AA 2026년 11월 9일 기사에 나와 있습니다. AA는 자사 에이전트 평가 비용의 대부분이 캐시 입력이며, Ember의 캐시 입력가가 비교 모델보다 60% 싸다고 적었습니다. 같은 측정에서 Ember는 Haiku 5.5 (max) 대비 출력 토큰을 약 3분의 1만 썼습니다. 정가 차이가 아니라 이 두 요인이 겹쳐 나온 결과입니다.
발표문의 비용 수치를 자기 워크로드에 그대로 옮기려면 캐시 적중률과 출력 길이가 AA 과제와 비슷해야 합니다. 프롬프트가 매번 달라져 캐시가 거의 걸리지 않는 작업이라면 세 모델의 비용 차이는 줄어듭니다. 이때는 판단 기준이 할증 경계와 배치 할인 쪽으로 넘어갑니다.
용어 풀이
1. 캐시 입력 — 직전 요청과 겹치는 프롬프트 앞부분을 재사용할 때 적용되는 할인 입력 단가로, 반복 호출이 많은 에이전트의 비용을 좌우합니다.
2. 하네스 — 모델에 도구와 실행 환경을 붙여 과제를 수행하게 하는 틀로, 같은 모델도 하네스가 바뀌면 점수가 달라집니다.
3. 배치 처리 — 실시간 응답 대신 요청을 모아 비동기로 처리하고 단가를 깎아 주는 방식입니다.
옵션·유형별 비교
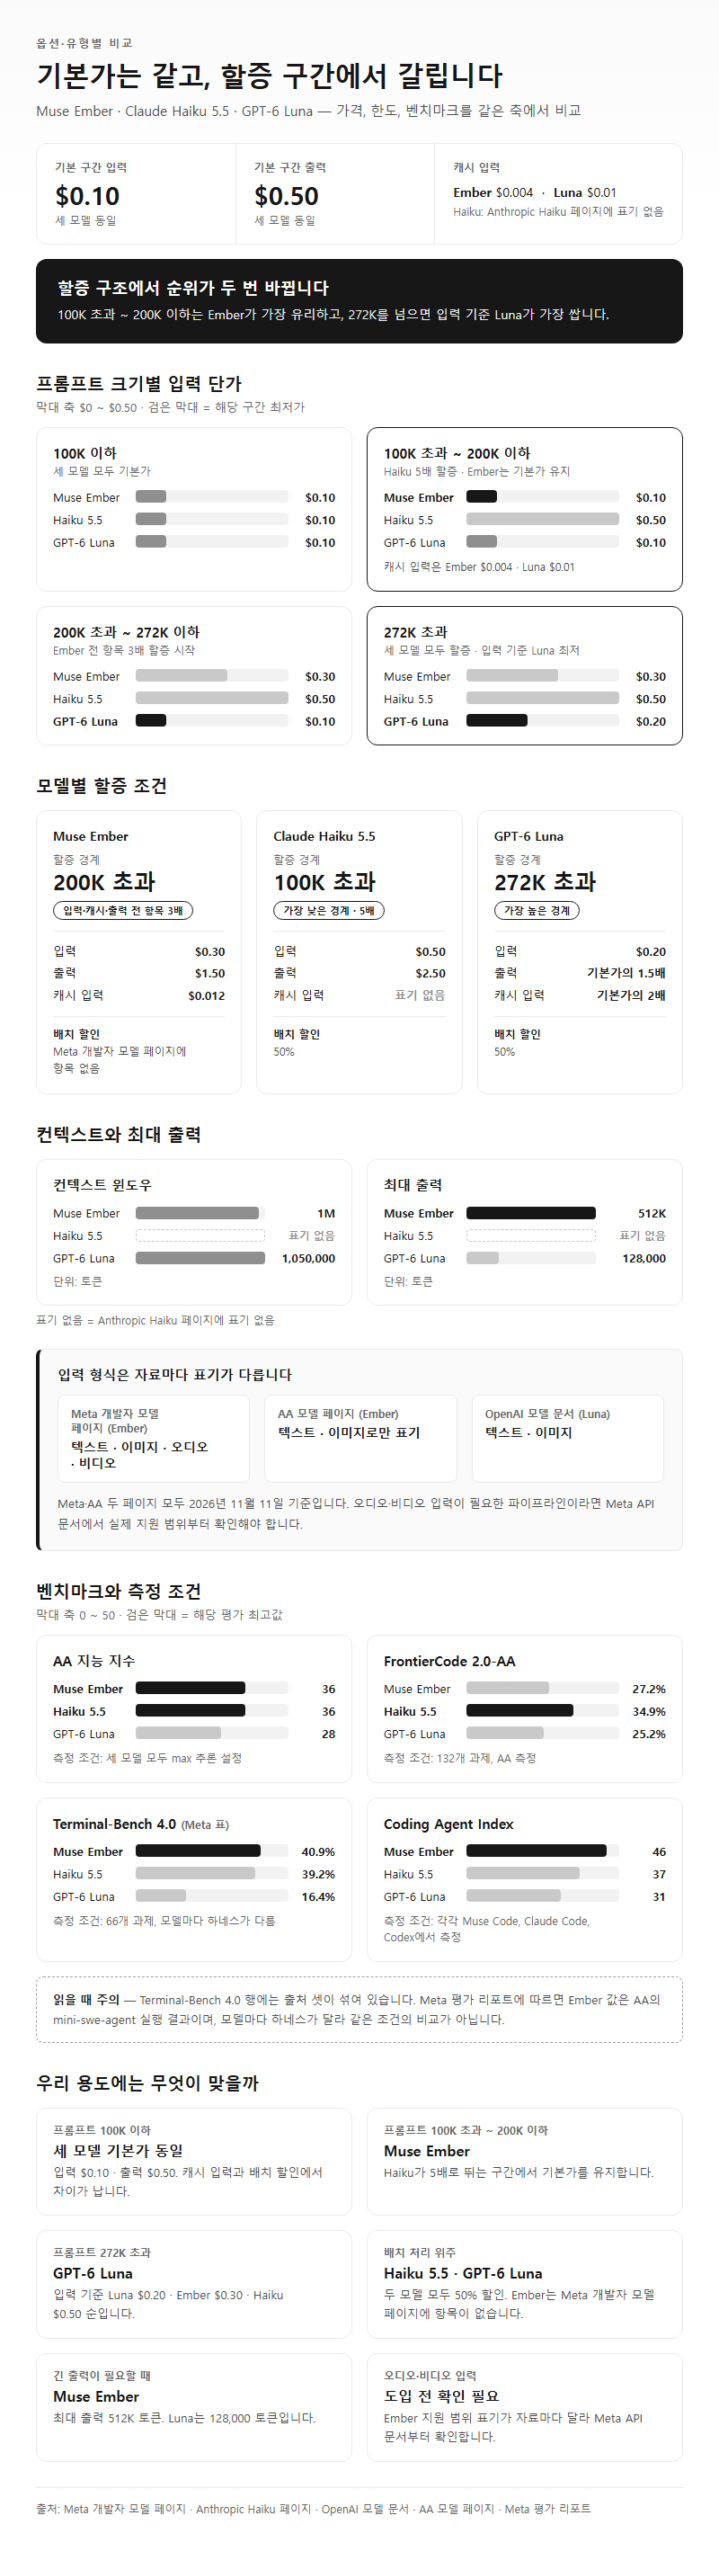
가격과 한도
| 항목 | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| 기본 구간 입력 | $0.10 | $0.10 | $0.10 |
| 기본 구간 출력 | $0.50 | $0.50 | $0.50 |
| 캐시 입력 | $0.004 | Anthropic Haiku 페이지에 표기 없음 | $0.01 |
| 할증 경계 | 200K 초과 | 100K 초과 | 272K 초과 |
| 할증 후 입력 | $0.30 | $0.50 | $0.20 |
| 할증 후 출력 | $1.50 | $2.50 | 기본가의 1.5배 |
| 할증 후 캐시 입력 | $0.012 | Anthropic Haiku 페이지에 표기 없음 | 기본가의 2배 |
| 배치 할인 | Meta 개발자 모델 페이지에 항목 없음 | 50% | 50% |
| 컨텍스트 윈도우 | 1M 토큰 | Anthropic Haiku 페이지에 표기 없음 | 1,050,000 토큰 |
| 최대 출력 | 512K 토큰 | Anthropic Haiku 페이지에 표기 없음 | 128,000 토큰 |
할증 구조에서 순위가 두 번 바뀝니다. 프롬프트가 100K를 넘고 200K 이하인 구간에서는 Haiku가 5배로 뛰는 반면 Ember는 기본가를 유지해 Ember가 가장 유리합니다. 272K를 넘으면 입력 기준 Luna $0.20, Ember $0.30, Haiku $0.50 순으로 Luna가 가장 쌉니다. Ember는 200K를 넘는 순간 입력·캐시·출력 전 항목이 3배가 됩니다.
입력 형식은 자료마다 표기가 다릅니다. Meta 개발자 모델 페이지는 텍스트·이미지·오디오·비디오를 지원한다고 적었지만, AA 모델 페이지는 Ember의 입력을 텍스트·이미지로만 표기합니다(두 페이지 모두 2026년 11월 11일 기준). 오디오·비디오 입력이 필요한 파이프라인이라면 Meta API 문서에서 실제 지원 범위부터 확인해야 합니다. GPT-6 Luna의 입력은 OpenAI 모델 문서 기준 텍스트·이미지입니다.
벤치마크와 측정 조건
| 평가 | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna | 측정 조건 |
|---|---|---|---|---|
| AA 지능 지수 | 36 | 36 | 28 | 세 모델 모두 max 추론 설정 |
| FrontierCode 2.0-AA | 27.2% | 34.9% | 25.2% | 132개 과제, AA 측정 |
| Terminal-Bench 4.0(Meta 표) | 40.9% | 39.2% | 16.4% | 66개 과제, 모델마다 하네스가 다름 |
| Coding Agent Index | 46 | 37 | 31 | 각각 Muse Code, Claude Code, Codex에서 측정 |
Terminal-Bench 4.0 행에는 출처 셋이 섞여 있습니다. Meta 평가 리포트에 따르면 Ember 값은 AA의 mini-swe-agent 실행, Haiku 값은 Anthropic 자체 보고(Claude Code), Luna 값은 리더보드의 Codex 값입니다. AA 기사는 같은 벤치마크에서 Haiku 5.5 (max)를 32.8%로 적었습니다. 이 값을 쓰면 격차는 Meta 표의 1.7점이 아니라 8.1점이 됩니다. 어느 쪽이든 Ember가 앞서지만 격차의 크기는 자료에 따라 달라집니다.
지식 회상과 문서형 업무에서는 Haiku가 앞섭니다. AA 기사 기준 AA-Omniscience 정확도는 Ember 21.1%, Haiku 5.5 (max) 34.7%, Gemini 3.8 Flash (high) 50.5%입니다. Ember는 이 평가에서 질문의 64%에 답변을 보류했고, 환각률은 17.4%로 Haiku의 절반 수준입니다. AA-Briefcase도 Ember 1521 Elo, Haiku 5.5 1574 Elo로 Ember가 뒤처집니다. AA는 Ember의 약점을 지식으로 꼽았고, 에이전트 코딩 성능은 엇갈린다고 평가했습니다.
속도는 AA 모델 페이지(2026년 11월 11일 기준)에 Meta API 측정값이 올라와 있습니다. 출력은 초당 454 토큰, 첫 답변 토큰까지 4.96초, 지수 과제 하나당 소요 시간은 3.1분입니다. 첫 토큰까지 5초 가까이 걸리므로, 사용자가 화면 앞에서 기다리는 대화형 서비스보다 백그라운드 실행 작업에 맞는 수치입니다.
상황별 추천
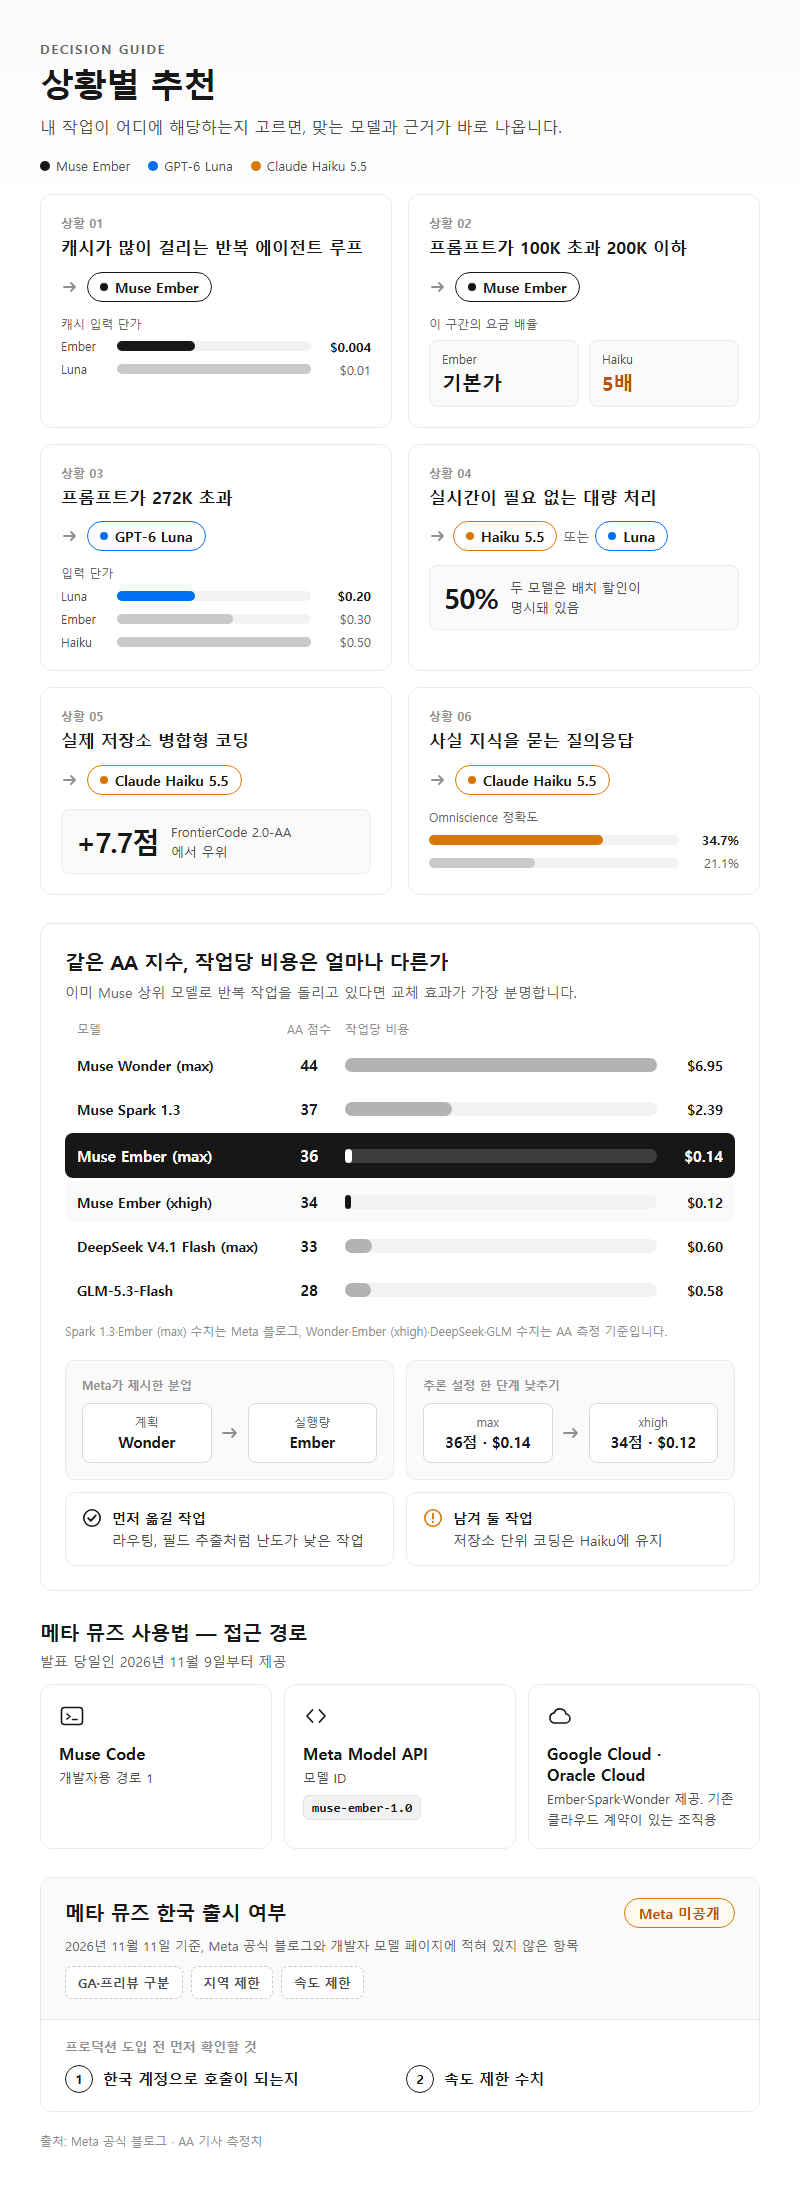
| 상황 | 맞는 선택 | 근거 |
|---|---|---|
| 캐시가 많이 걸리는 반복 에이전트 루프 | Muse Ember | 캐시 입력 $0.004로 Luna $0.01보다 낮음 |
| 프롬프트가 100K 초과 200K 이하 | Muse Ember | Haiku는 이 구간에서 5배, Ember는 기본가 |
| 프롬프트가 272K 초과 | GPT-6 Luna | 입력 $0.20으로 Ember $0.30, Haiku $0.50보다 낮음 |
| 실시간이 필요 없는 대량 처리 | Haiku 5.5 또는 Luna | 두 모델은 배치 50% 할인이 명시돼 있음 |
| 실제 저장소 병합형 코딩 | Claude Haiku 5.5 | FrontierCode 2.0-AA에서 7.7점 우위 |
| 사실 지식을 묻는 질의응답 | Claude Haiku 5.5 | Omniscience 정확도 34.7% 대 21.1% |
이미 Muse 계열 상위 모델로 반복 작업을 돌리고 있다면 교체 효과가 가장 분명합니다. Meta 블로그에 따르면 같은 AA 지수에서 Muse Spark 1.3은 37점에 작업당 $2.39, Ember는 36점에 $0.14입니다. AA 기사는 Muse Wonder (max)를 44점에 $6.95로 측정했습니다. 계획은 Wonder가 세우고 실행량은 Ember가 맡는 분업이 Meta가 제시한 구도입니다. 저가 오픈 계열도 AA 측정에서는 더 비쌌습니다. AA 기사 기준 DeepSeek V4.1 Flash (max)는 33점에 $0.60, GLM-5.3-Flash는 28점에 $0.58입니다.
추론 설정을 한 단계 낮추는 방법도 있습니다. AA는 Ember (xhigh)를 34점에 작업당 $0.12로 측정했습니다. max 설정의 36점, $0.14와 비교해 점수 2점을 내주고 비용을 조금 줄이는 조합입니다. 라우팅이나 필드 추출처럼 난도가 낮은 작업부터 옮기고, 저장소 단위 코딩은 Haiku에 남겨 두는 구성이 벤치마크 결과와 맞습니다.
메타 뮤즈 사용법 — 접근 경로
메타 뮤즈 사용법은 개발자 기준으로 Muse Code와 Meta Model API 두 경로입니다. Meta 공식 블로그는 두 곳에서 발표 당일인 2026년 11월 9일부터 제공된다고 적었고, API 모델 ID는 muse-ember-1.0입니다. Google Cloud와 Oracle Cloud에서도 Muse Ember·Spark·Wonder를 제공한다고 밝혔으므로, 기존 클라우드 계약이 있는 조직은 그쪽 경로를 쓸 수 있습니다.
메타 뮤즈 한국 출시 여부
메타 뮤즈 한국 출시 여부는 Meta가 공개하지 않았습니다. 2026년 11월 11일 기준 Meta 공식 블로그와 개발자 모델 페이지에는 GA·프리뷰 구분, 지역 제한, 속도 제한이 적혀 있지 않습니다. 프로덕션 일정이 걸린 도입이라면 한국 계정으로 호출이 되는지와 속도 제한 수치를 먼저 확인한 뒤 판단하는 순서가 안전합니다.
메타 뮤즈 AI 앱 적용 여부
메타 뮤즈 AI 앱에서 Ember를 쓸 수 있는지도 발표문에는 나오지 않습니다. Meta 블로그 본문은 Meta AI 앱 같은 소비자 제품 적용을 언급하지 않았고, 제공 경로로 든 것은 Muse Code, Meta Model API, 두 클라우드뿐입니다. 현재 공개된 자료 기준으로 Ember는 API로 호출하는 개발자용 모델입니다.
자주 하는 실수
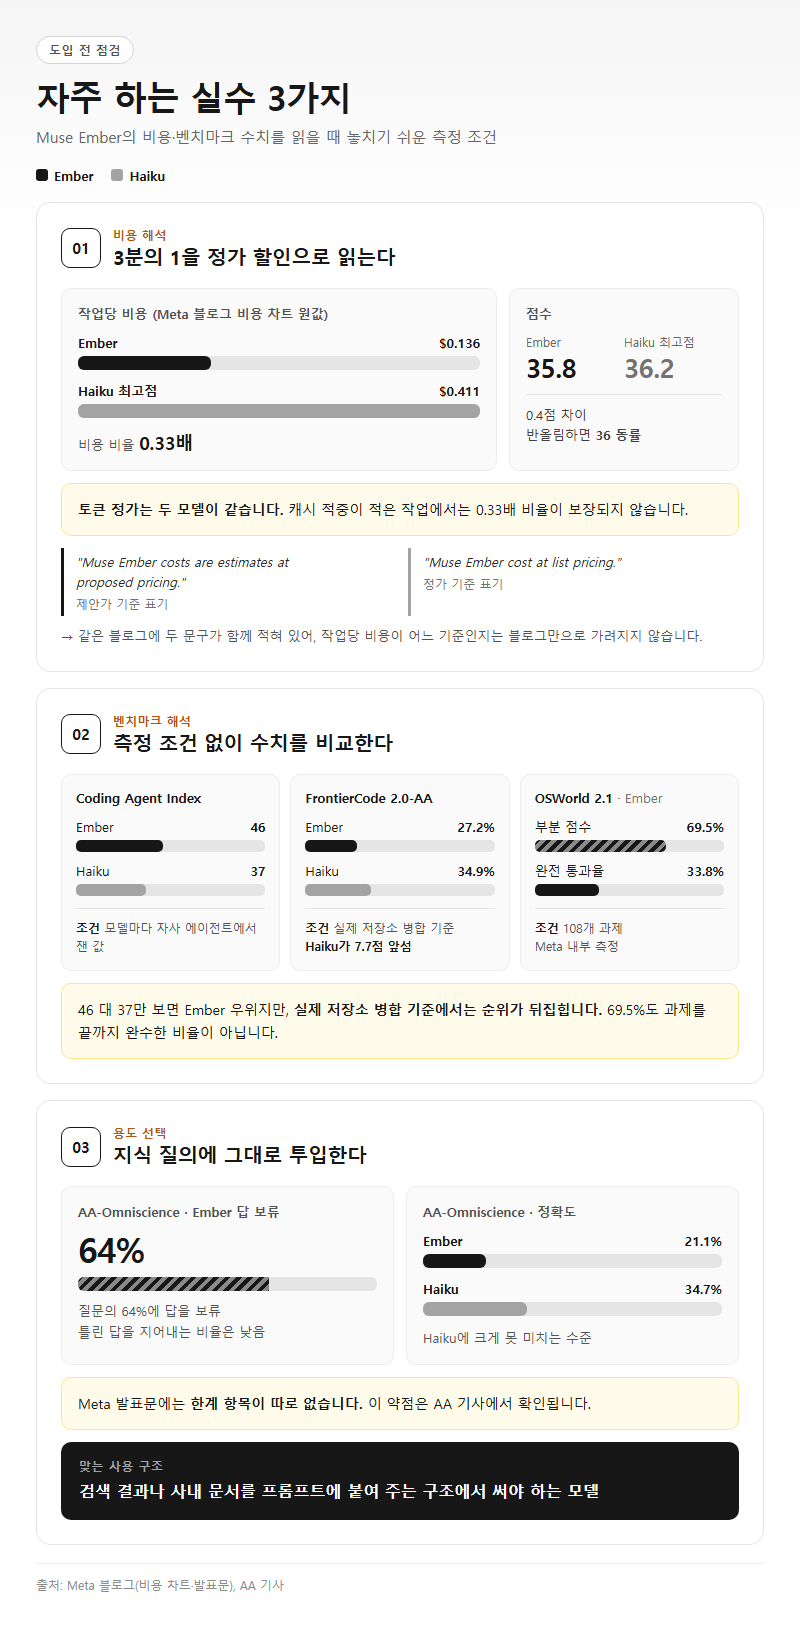
첫째, 3분의 1을 정가 할인으로 읽는 경우입니다. Meta 블로그 비용 차트의 원값은 Ember 35.8점에 작업당 $0.136, Haiku 최고점 36.2점에 $0.411입니다. 점수는 0.4점 차이로 반올림하면 36 동률이고, 비용은 0.33배입니다. 다만 토큰 정가는 두 모델이 같으므로, 캐시 적중이 적은 작업에서는 이 비율이 보장되지 않습니다. 같은 블로그에는 “Muse Ember costs are estimates at proposed pricing.”과 “Muse Ember cost at list pricing.”이 함께 적혀 있습니다. 작업당 비용이 제안가 기준인지 정가 기준인지는 블로그만으로 가려지지 않습니다.
둘째, 벤치마크 수치를 측정 조건 없이 비교하는 경우입니다. Coding Agent Index의 46 대 37은 모델마다 자사 에이전트에서 잰 값입니다. 실제 저장소 병합 기준인 FrontierCode 2.0-AA에서는 27.2% 대 34.9%로 Haiku가 7.7점 앞섭니다. OSWorld 2.1의 69.5%도 부분 점수입니다. 과제를 끝까지 완수한 완전 통과율은 33.8%이며, 108개 과제를 Meta가 내부에서 측정한 값입니다.
셋째, 지식 질의에 그대로 투입하는 경우입니다. Ember는 AA-Omniscience에서 질문의 64%에 답을 보류했습니다. 틀린 답을 지어내는 비율은 낮지만 정확도 21.1%는 Haiku 34.7%에 크게 못 미칩니다. Meta 발표문에는 한계 항목이 따로 없으며, 이 약점은 AA 기사에서 확인됩니다. 검색 결과나 사내 문서를 프롬프트에 붙여 주는 구조에서 써야 하는 모델입니다.
정리
Muse Ember, Claude Haiku 5.5, GPT-6 Luna는 기본 구간 정가가 같으므로 캐시 단가, 프롬프트 길이 구간, 토큰 사용량으로 골라야 합니다. 캐시가 많이 걸리는 반복 루프와 100K 초과 200K 이하 프롬프트는 Ember가 유리합니다. 272K 초과는 Luna, 실제 저장소 코딩과 지식 회상은 Haiku 5.5가 유리합니다. 배치 가격, GA 여부, 한국 제공 범위는 2026년 11월 11일 기준 Meta가 공개하지 않았으므로, 라우팅·추출·도구 호출부터 소규모로 옮기는 것이 현재 자료로 내릴 수 있는 결론입니다.
함께 보면 좋은 제품
- 라이프밀 홀그레인 저당 그래놀라 귀리 시리얼 20g 7봉
- 그릭요거트 토핑을 올린 귀리 그래놀라 시리얼입니다.
위 링크는 제휴 링크이며, 제품 선택은 독자의 판단입니다.
참고 자료
조사 기준일: 2026년 11월 11일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (확인일 2026-11-11)
– Meta 공식 블로그(2회 열람 대조): https://research.meta.ai/blog/muse-ember
– Meta 평가 리포트 PDF(본문 텍스트 직접 추출): https://research.meta.ai/static/muse-ember-evaluation-report
– Meta 개발자 모델 페이지: https://dev.meta.ai/models/muse-ember
– Anthropic Claude Haiku 페이지: https://www.anthropic.com/claude/haiku
– OpenAI GPT-6 Luna 모델 문서: https://developers.openai.com/api/docs/models/gpt-6-luna
– Artificial Analysis 기사(2026-11-09): https://artificialanalysis.ai/articles/meta-s-muse-ember-is-the-cheapest-model-scoring-36-on-the-intelligence-index
– Artificial Analysis 모델 페이지: https://artificialanalysis.ai/models/muse-ember
– TechCrunch(2026-11-09): https://techcrunch.com/2026/11/09/meta-releases-muse-ember-a-new-lightweight-model-for-agent-execution/
– The Decoder(2026-11-09): https://the-decoder.com/meta-launches-muse-ember-a-small-ai-model-built-for-the-repetitive-work-agents-actually-do/
– SiliconANGLE(2026-11-09): https://siliconangle.com/2026/11/09/meta-introduces-muse-ember-to-power-cost-efficient-ai-agents/
답글 남기기