
METR가 2026년 11월 5일 공개한 Anthropic 평가를 바탕으로, AI R&D 가속 1.9배의 의미와 한계를 정리했습니다. 회사 경보선 2배 통과 논란, AI가 스스로 개선하는 단계와 지금 상황의 차이도 함께 설명합니다.
이 글에는 네이버 브랜드커넥트 제휴 링크가 포함되어 있습니다. 링크를 통해 구매가 이루어지면 작성자가 일정액의 수수료를 지급받습니다. 제품 선택과 구매는 독자의 판단이며, 이 글은 특정 제품의 효과를 보증하지 않습니다.
재귀적 자기개선 개요
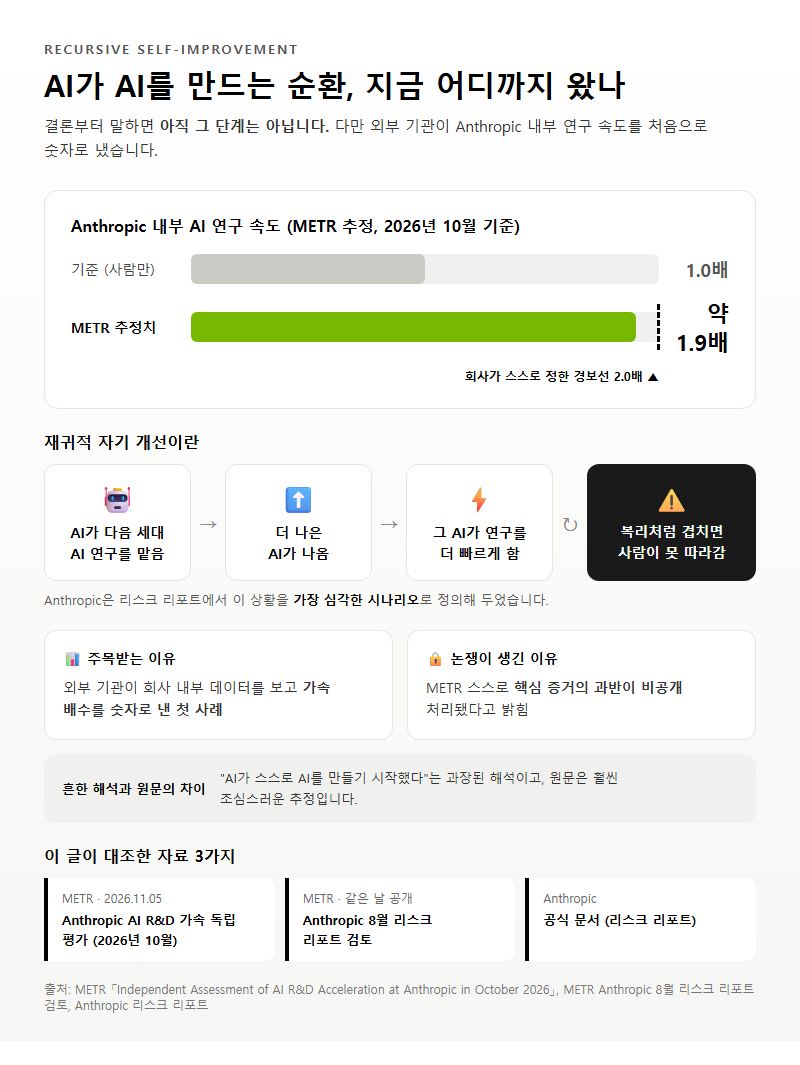
AI가 스스로를 계속 개선해 나가는 단계는 아직 오지 않았습니다. 다만 외부 기관은 Anthropic 내부의 AI 연구 속도가 약 1.9배 빨라졌다고 추정했고, 이는 회사가 스스로 정한 2배 경보선에 가까운 수치입니다. 근거는 독립 평가기관 METR가 2026년 11월 5일 공개한 「Independent Assessment of AI R&D Acceleration at Anthropic in October 2026」입니다. 이 글에서는 이 보고서, 같은 날 METR가 낸 Anthropic 8월 리스크 리포트 검토, Anthropic 공식 문서를 나란히 놓고 숫자가 실제로 무엇을 뜻하는지 정리했습니다.
재귀적 자기 개선은 AI가 다음 세대 AI를 만드는 연구를 맡고, 그렇게 나온 더 나은 AI가 다시 그 연구를 더 빠르게 하는 순환 구조를 가리킵니다. 걱정되는 지점은 이 순환이 복리처럼 겹칠 때입니다. 진보 속도가 사람이 따라갈 수 없을 만큼 빨라질 수 있습니다. Anthropic도 리스크 리포트에서 이런 상황을 가장 심각한 시나리오로 정의해 두었습니다.
이번 평가가 주목받는 이유는 외부 기관이 회사 내부 데이터를 보고 가속 배수를 숫자로 낸 첫 사례이기 때문입니다. 그런데 METR 스스로 핵심 증거의 과반이 비공개 처리됐다고 밝히면서, 이 숫자를 얼마나 믿어야 하느냐는 논쟁도 함께 시작됐습니다. 검색하면 “AI가 스스로 AI를 만들기 시작했다”는 해석이 먼저 나오지만, 원문은 훨씬 조심스럽습니다.
1. METR는 무엇을, 어떻게 쟀나
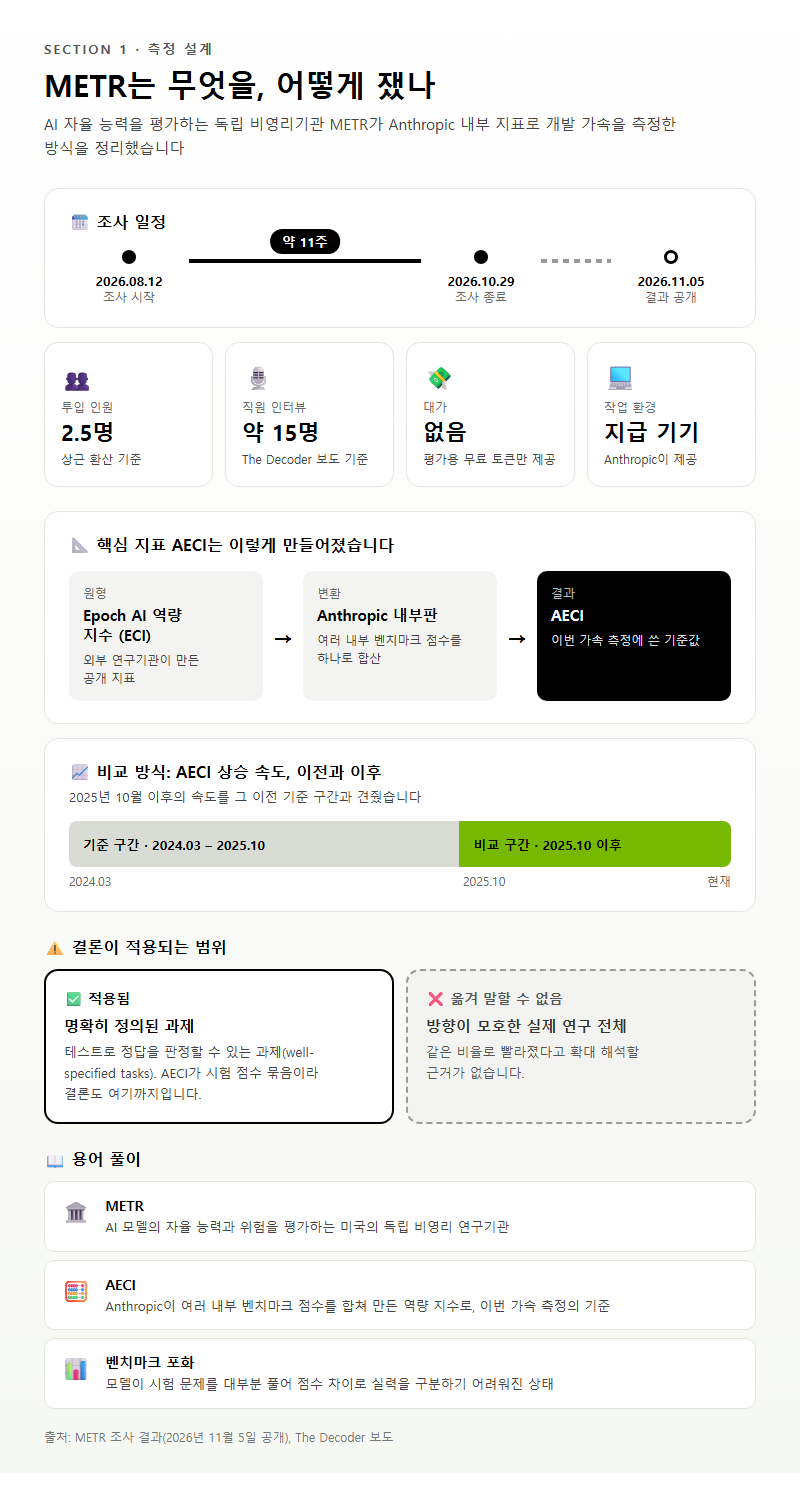
METR의 조사는 2026년 8월 12일부터 10월 29일까지 약 11주 동안 진행됐습니다. 투입 인원은 상근 환산 2.5명이고, 작업은 Anthropic이 지급한 기기로 했습니다. METR는 대가를 받지 않았으며, Anthropic은 평가에 쓸 무료 토큰만 제공했습니다. The Decoder 보도에 따르면 조사 과정에서 Anthropic 직원 약 15명을 인터뷰했습니다.
| 항목 | 내용 |
|---|---|
| 공개일 | 2026년 11월 5일 |
| 조사 기간 | 2026년 8월 12일 – 10월 29일 (약 11주) |
| 투입 인원 | 상근 환산 2.5명 |
| 대가 | 없음 (Anthropic이 무료 토큰 제공) |
| 핵심 지표 | AECI (Anthropic 내부판 역량 지수) |
| 비교 기간 | 2024년 3월 – 2025년 10월 vs 2025년 10월 이후 |
| 결론 범위 | 명확히 정의된 과제(well-specified tasks)에 한정 |
측정의 중심은 AECI라는 내부 지표입니다. 외부 연구기관 Epoch AI의 역량 지수(ECI)를 Anthropic이 내부용으로 바꾼 것으로, 여러 벤치마크 점수를 하나로 합친 값입니다. METR는 2025년 10월 이후의 AECI 상승 속도를 2024년 3월부터 2025년 10월까지의 속도와 비교했습니다.
이 설계에는 분명한 한계가 있습니다. AECI는 시험 점수 묶음이라서, 결론도 테스트로 정답을 판정할 수 있는 명확히 정의된 과제에만 적용됩니다. 방향이 모호한 실제 연구 전체가 같은 비율로 빨라졌다고 옮겨 말할 수는 없습니다.
용어 풀이
1. METR — AI 모델의 자율 능력과 위험을 평가하는 미국의 독립 비영리 연구기관입니다.
2. AECI — Anthropic이 여러 내부 벤치마크 점수를 합쳐 만든 역량 지수로, 이번 가속 측정의 기준입니다.
3. 벤치마크 포화 — 모델이 시험 문제를 대부분 풀어 점수 차이로 실력을 구분하기 어려워진 상태입니다.
2. 1.9배라는 숫자를 읽는 법
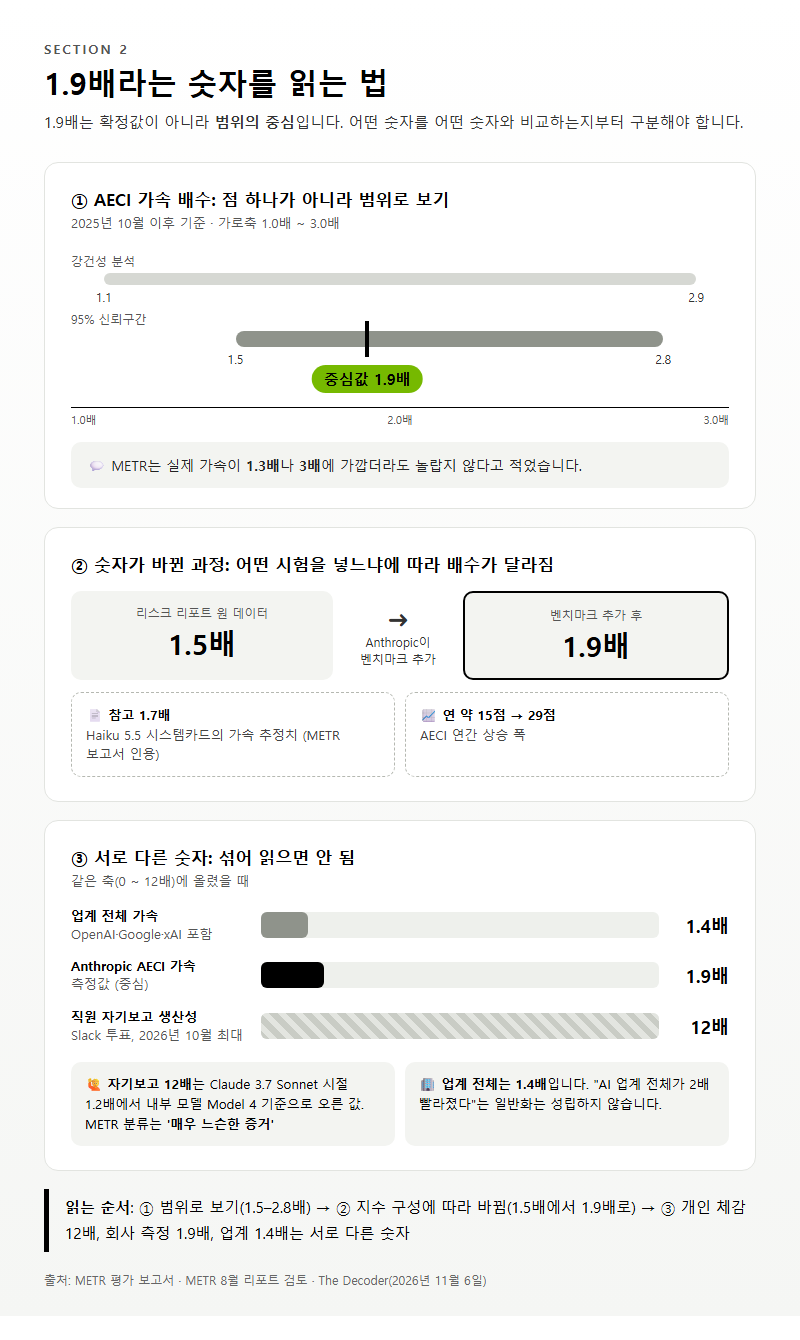
METR가 낸 핵심 수치는 AECI 상승 속도 1.9배이고, 95% 신뢰구간은 1.5–2.8배입니다. METR는 실제 가속이 1.3배나 3배에 가깝더라도 놀랍지 않다고 적었습니다. 분석 방식을 바꿔 본 강건성 분석에서는 1.1–2.9배가 나왔습니다. 그러니 1.9배는 확정값이 아니라 범위의 중심으로 읽어야 합니다.
| 수치 | 무엇을 뜻하나 | 출처 |
|---|---|---|
| 1.9배 (1.5–2.8) | 2025년 10월 이후 AECI 가속, 95% 신뢰구간 | METR 평가 보고서 |
| 1.1–2.9배 | 강건성 분석 범위 | METR 평가 보고서 |
| 1.5배 → 1.9배 | 리포트 원 데이터 vs 벤치마크 추가 후 | METR 8월 리포트 검토 |
| 연 약 15점 → 29점 | AECI 연간 상승 폭 | The Decoder 2026년 11월 6일 |
| 1.4배 | OpenAI·Google·xAI 포함 업계 전체 가속 | The Decoder 2026년 11월 6일 |
| 12배 | 직원 자기보고 생산성 향상 (2026년 10월) | METR 평가 보고서 |
숫자가 바뀐 과정도 볼 만합니다. METR 검토에 따르면 리스크 리포트의 원 데이터로 계산한 AECI 가속은 약 1.5배였는데, Anthropic이 벤치마크를 추가하고 나서 1.9배가 됐습니다. 지수에 어떤 시험을 넣느냐에 따라 배수가 달라진다는 얘기입니다. 참고로 METR 보고서는 Haiku 5.5 시스템카드에 실린 가속 추정치 1.7배도 함께 인용했습니다.
직원 체감과 측정값 사이의 차이도 큽니다. Slack 투표로 모은 직원 자기보고에서는 생산성 향상이 2026년 10월 최대 12배까지 나왔습니다. The Decoder는 이 값이 Claude 3.7 Sonnet 시절 1.2배에서 내부 모델 Model 4 기준 12배로 올랐다고 전했습니다. 하지만 METR는 이를 ‘매우 느슨한 증거’로 분류했습니다. 개인이 느끼는 작업 속도와 회사 전체의 역량 진보 속도는 서로 다른 숫자입니다.
회사와 업계도 나눠 봐야 합니다. The Decoder 보도 기준으로 타사 모델까지 넣은 업계 전체 가속은 1.4배였습니다. “AI 업계 전체가 2배 빨라졌다”는 일반화는 성립하지 않습니다.
3. 가속의 원인은 AI인가, 사람인가
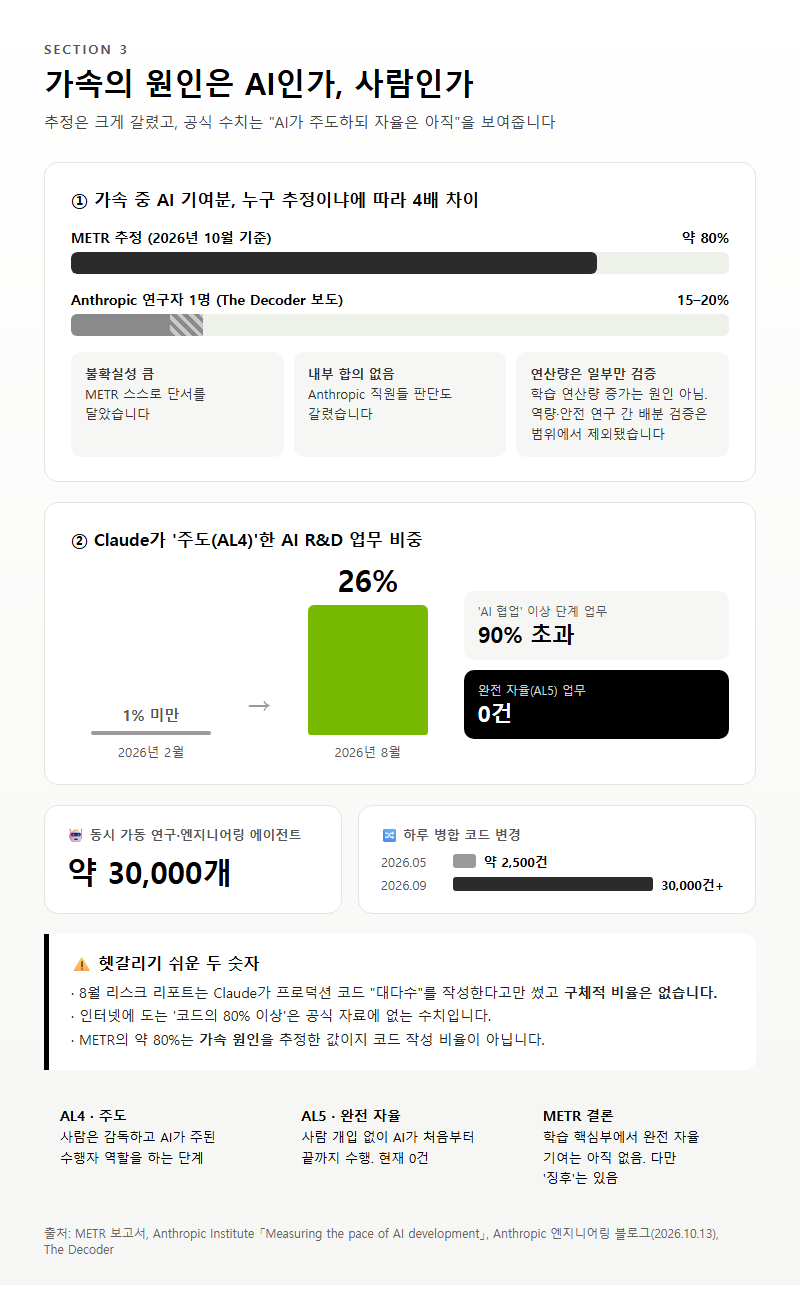
METR는 2026년 10월 시점 가속의 과반, 아마 약 80%가 AI 덕분이라고 추정했습니다. 단서도 달았습니다. 불확실성이 크고, Anthropic 직원들 사이에서도 합의가 없었다는 것입니다. The Decoder 보도에 따르면 Anthropic 연구자 한 명은 AI 기여분을 15–20%로 봤습니다. 같은 현상을 놓고 내부에서도 판단이 크게 갈렸습니다.
연산량 쪽 설명은 일부만 확인됐습니다. METR는 학습 연산량 증가가 가속의 원인이 아니라는 증거를 받았다고 밝혔습니다. 그러나 역량 연구와 안전 연구에 연산을 어떻게 나눴는지 검증하는 작업은 Anthropic이 진행 도중 범위에서 뺐습니다.
AI가 실제로 맡은 일의 비중은 Anthropic 공식 자료에 나옵니다. Anthropic Institute의 「Measuring the pace of AI development」에 따르면 2026년 8월 기준 Claude가 AI R&D 업무의 26%를 ‘주도(AL4)’했습니다. 2026년 2월에는 1% 미만이었습니다. 반면 사람이 전혀 개입하지 않은 완전 자율(AL5) 업무는 0건이었습니다.
| 지표 | 수치 | 출처 |
|---|---|---|
| Claude 주도(AL4) 업무 비중 | 1% 미만(2026년 2월) → 26%(2026년 8월) | Anthropic Institute |
| 완전 자율(AL5) 업무 | 0건 | Anthropic Institute |
| ‘AI 협업’ 이상 단계 업무 | 90% 초과 | Anthropic Institute |
| 동시 가동 연구·엔지니어링 에이전트 | 약 30,000개 | Anthropic Institute |
| 하루 병합 코드 변경 | 약 2,500건(2026년 5월) → 30,000건 이상(2026년 9월) | Anthropic 엔지니어링 블로그 2026년 10월 13일 |
8월 리스크 리포트에는 “Claude now authors a large majority of the code merged into our production codebases.”라는 문장이 있지만 구체적 비율은 없습니다. 인터넷에 도는 ‘코드의 80% 이상’ 같은 수치는 회사 공식 자료에 나오지 않습니다. METR의 약 80%는 가속 원인을 추정한 값이니 코드 비율과 헷갈리면 안 됩니다.
METR는 AI가 학습의 가장 중요한 부분에서 아직 완전히 자율적인 기여를 하지 못한다고 이해한다고 적었습니다. 분야마다 성숙도는 크게 다르지만 ‘징후(signs of life)’는 있다는 표현이 함께 붙었습니다. 보고서 본문에는 재귀적 자기 개선이라는 용어 자체가 등장하지 않습니다.
용어 풀이
1. AL4(주도) — 사람이 감독은 하지만 AI가 업무의 주된 수행자 역할을 한 단계입니다.
2. AL5(완전 자율) — 사람 개입 없이 AI가 처음부터 끝까지 수행한 단계로, 현재 0건입니다.
3. 병합(merge) — 작성된 코드 변경을 실제 서비스용 코드 저장소에 합쳐 넣는 일입니다.
4. 회사가 정한 2배 경보선, 이미 넘었나
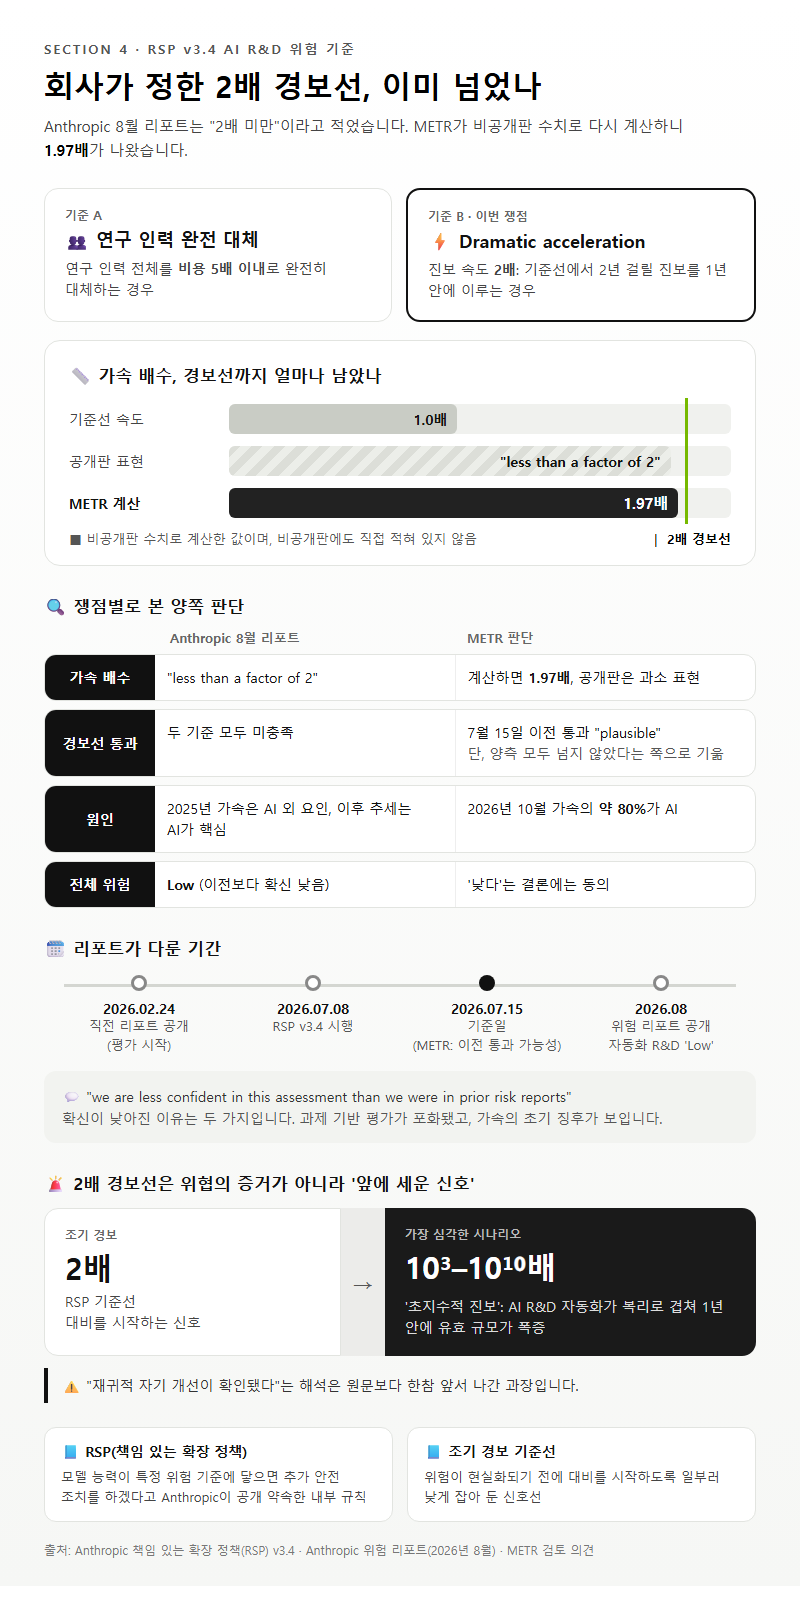
Anthropic의 책임 있는 확장 정책 RSP v3.4(2026년 7월 8일 시행)는 AI R&D 위험 기준을 두 갈래로 둡니다. 하나는 연구 인력 전체를 비용 5배 이내로 완전히 대체하는 경우입니다. 다른 하나는 진보 속도가 2배가 되는 ‘dramatic acceleration’으로, 각주에 “as much progress in one year as one would see in two years at baseline”이라고 적혀 있습니다.
| 쟁점 | Anthropic 8월 리포트 | METR 판단 |
|---|---|---|
| 가속 배수 | “less than a factor of 2” | 비공개판 수치로 계산하면 1.97배, 공개판은 과소 표현 |
| 경보선 통과 | 두 기준 모두 미충족 | 2026년 7월 15일 이전 통과가 “plausible” |
| 원인 | 2025년 가속은 AI 외 요인, 이후 추세는 AI가 핵심 | 2026년 10월 가속의 약 80%가 AI |
| 전체 위험 | Low (단, 이전보다 확신 낮음) | ‘낮다’는 결론에는 동의 |
리포트가 다루는 기간은 직전 리포트 공개일인 2026년 2월 24일부터 기준일 2026년 7월 15일까지입니다. 리포트는 자동화 R&D 위험을 ‘Low’로 평가했지만 “we are less confident in this assessment than we were in prior risk reports”라고도 적었습니다. 그 이유로 과제 기반 평가의 포화와 가속의 초기 징후를 들었습니다.
METR가 문제 삼은 건 표현의 정확성입니다. 비공개판 수치로 계산하면 가속은 1.97배인데, 이 값은 비공개판에도 직접 적혀 있지 않습니다. 공개판의 “2배 미만”이 틀린 말은 아니지만, METR는 이 서술이 가속을 과소 표현했다고 평가했습니다. 또 경보선을 7월 15일 이전에 이미 넘었을 가능성이 “plausible”하다고 보면서도, METR 연구진과 Anthropic 직원 모두 넘지 않았다는 쪽으로 기운다고 덧붙였습니다.
2배 경보선이 어떤 성격인지도 알아둘 필요가 있습니다. 리포트가 가장 심각하게 상정한 시나리오는 AI R&D 자동화가 복리로 겹쳐 1년 안에 유효 규모가 10³–10¹⁰배 커지는 ‘초지수적 진보’입니다. 리포트 설명에 따르면 RSP의 2배 기준선은 이 위협이 현실화됐다는 증거가 아니고, 그 앞에 세워 둔 조기 경보입니다. 따라서 “재귀적 자기 개선이 확인됐다”는 해석은 원문보다 한참 앞서 나간 과장입니다.
용어 풀이
1. RSP(책임 있는 확장 정책) — 모델 능력이 특정 위험 기준에 닿으면 추가 안전 조치를 하겠다고 Anthropic이 공개 약속한 내부 규칙입니다.
2. 조기 경보 기준선 — 위험이 현실화되기 전에 대비를 시작하도록 일부러 낮게 잡아 둔 신호선입니다.
5. 독립 평가의 한계와 자주 나오는 질문
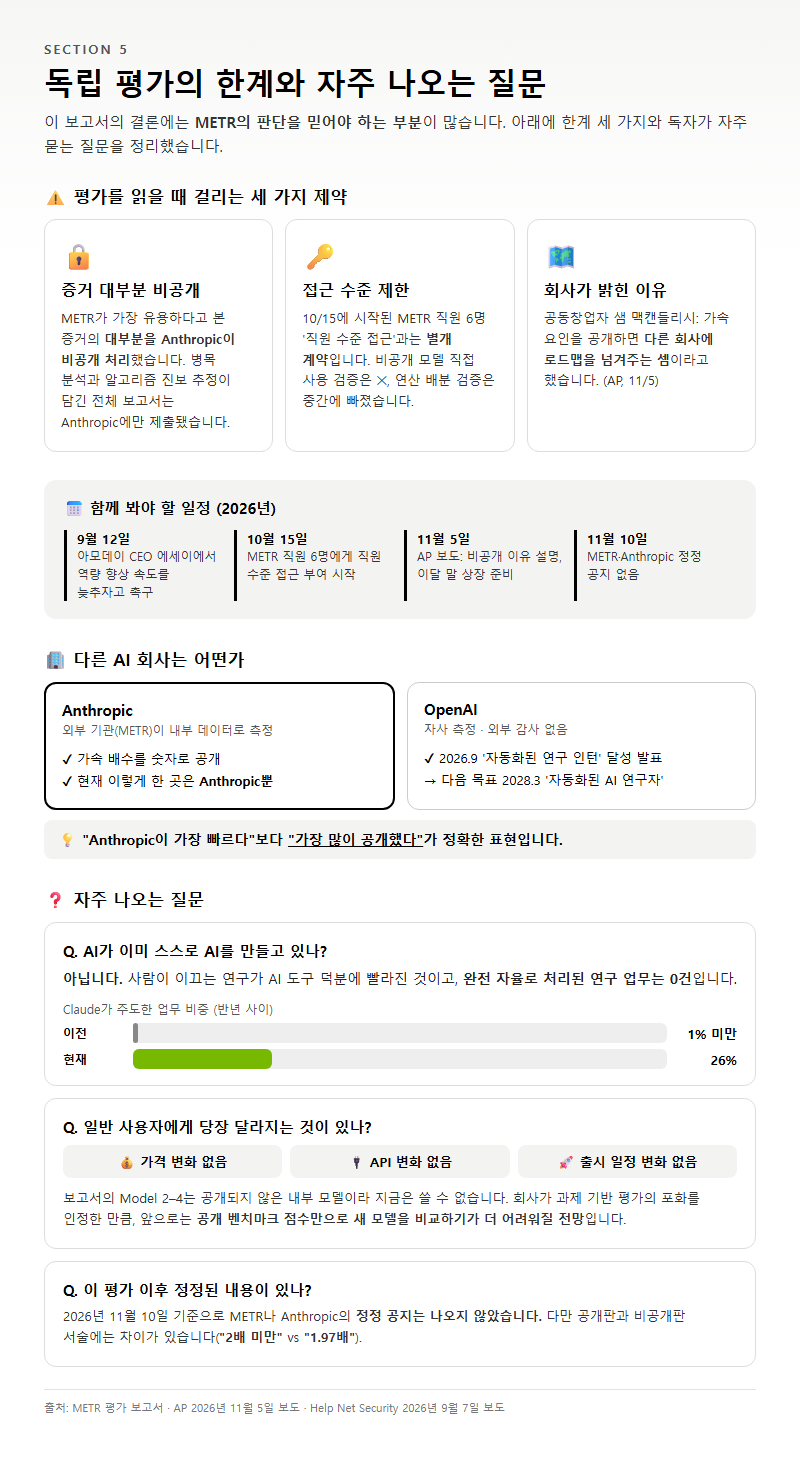
이번 평가를 읽을 때 가장 큰 제약은 비공개 범위입니다. METR는 보고서에 “Anthropic redacted a majority of the evidence we found most informative for these conclusions.”라고 적었습니다. 병목 분석, 알고리즘 진보 추정, 세부 원인 분석이 담긴 전체 보고서는 Anthropic에만 제출됐습니다. 독자는 결론의 상당 부분을 METR의 판단을 믿고 받아들여야 합니다.
접근 수준도 따로 봐야 합니다. Anthropic은 2026년 10월 15일 METR 직원 6명에게 ‘직원 수준 접근(employee-like access)’을 주기 시작했다고 발표했습니다. 그런데 METR는 이번 가속 평가가 그 건과는 별개의 계약이라고 명시했습니다. 비공개 모델을 직접 써 보는 검증은 없었고, 연산 배분 검증은 중간에 빠졌습니다.
비공개 처리 이유는 회사 쪽에서 설명했습니다. AP 2026년 11월 5일 보도에 따르면 Anthropic 공동창업자 샘 맥캔들리시는 X에서 AI가 연구를 빠르게 하고 있지만 정확히 얼마인지는 말하기 어렵다고 했습니다. 무엇이 가속을 이끄는지 공개하면 다른 회사에 로드맵을 넘겨주는 셈이라는 말도 덧붙였습니다. 같은 보도는 다리오 아모데이 CEO가 2026년 9월 12일 에세이에서 역량 향상 속도를 늦추자고 촉구했고, Anthropic이 이달 말 상장을 준비 중이라고 전했습니다.
다른 AI 회사는 어떤가
Help Net Security 2026년 9월 7일 보도에 따르면 OpenAI는 2026년 9월 ‘자동화된 연구 인턴’ 목표를 달성했다고 발표했습니다. 사람 지시를 받아 정의된 연구 과제를 수행하는 수준이고, 다음 목표는 2028년 3월 ‘자동화된 AI 연구자’입니다. 다만 이 수치는 자사 측정이며 외부 감사를 거치지 않았습니다. 외부 기관이 내부 데이터로 가속 배수를 숫자로 낸 곳은 현재 Anthropic뿐입니다. “Anthropic이 가장 빠르다”보다 “가장 많이 공개했다”가 정확한 표현입니다.
AI가 이미 스스로 AI를 만들고 있나
아닙니다. 사람이 이끄는 연구가 AI 도구 덕분에 빨라진 것이고, 완전 자율로 처리된 연구 업무는 0건입니다. 다만 Claude가 주도한 업무 비중이 반년 만에 1% 미만에서 26%로 늘었으니, 변화의 방향은 분명합니다.
일반 사용자에게 당장 달라지는 것이 있나
이번 평가와 함께 바뀐 가격·API·출시 일정은 없습니다. 보고서에 나오는 Model 2–4는 공개되지 않은 내부 모델이라 지금은 쓸 수 없습니다. 다만 회사가 과제 기반 평가의 포화를 인정한 만큼, 앞으로는 공개 벤치마크 점수만으로 새 모델을 비교하기가 더 어려워질 전망입니다.
이 평가 이후 정정된 내용이 있나
2026년 11월 10일 기준으로 METR나 Anthropic의 정정 공지는 나오지 않았습니다. 공개판과 비공개판 서술의 차이(2배 미만 vs 1.97배)를 회사가 추가로 해명하지도 않았습니다.
정리
METR의 2026년 11월 평가로 보면 AI가 스스로를 끝없이 개선하는 단계는 아직 시작되지 않았습니다. 그래도 Anthropic의 AI 연구 속도는 명확히 정의된 과제 기준으로 약 1.9배 빨라졌고, 외부 기관은 회사가 정한 2배 경보선을 이미 넘었을 가능성도 열어 두었습니다. 직원 체감 12배와 업계 전체 1.4배는 서로 다른 숫자라 1.9배와 섞어 읽으면 안 됩니다. 핵심 증거의 과반이 비공개라는 점까지 감안하면, 이번 평가는 확정 판정이라기보다 처음으로 숫자가 붙은 경고로 받아들이는 편이 근거에 맞습니다.
함께 보면 좋은 제품
- 라이프밀 홀그레인 저당 그래놀라 귀리 시리얼 20g 7봉
- 그릭요거트 토핑을 올린 귀리 그래놀라 시리얼입니다.
위 링크는 제휴 링크이며, 제품 선택은 독자의 판단입니다.
참고 자료
조사 기준일: 2026년 11월 10일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (확인일 2026-11-10)
– METR, Independent Assessment of AI R&D Acceleration at Anthropic in October 2026 — https://metr.org/blog/2026-11-05-anthropic-ai-rd-acceleration-assessment/ (교차: https://metr.substack.com/p/2026-11-05-anthropic-ai-rd-acceleration-assessment)
– Anthropic, Risk Report: August 2026 (PDF 텍스트 직접 추출) — https://www.anthropic.com/aug-2026-risk-report
– Anthropic, Responsible Scaling Policy v3.4 — https://www.anthropic.com/responsible-scaling-policy
– Anthropic, An update on independent evaluators (2026-10-15) — https://www.anthropic.com/news/an-update-on-independent-evaluators
– Anthropic Institute, Measuring the pace of AI development — https://www.anthropic.com/institute/measuring-pace-of-ai-development
– Anthropic, Redesigning source control (2026-10-13) — https://www.anthropic.com/research/redesigning-source-control
– METR, Review of the “Risks from automated R&D” section (August 2026) — https://metr.org/blog/2026-11-05-rd-section-anthropic-risk-report-august-2026-review/
– METR, Review of Feb 2026 Risk Report R&D section (2026-05-08) — https://metr.org/blog/2026-05-08-rd-section-anthropic-risk-report-feb-2026-review/
– AP(ClickOrlando 전재), 2026-11-05 — https://www.clickorlando.com/business/2026/11/05/anthropic-is-rapidly-accelerating-ai-development-amid-slowdown-calls-outside-research-group-says/
– The Decoder, 2026-11-06 — https://the-decoder.com/metr-finds-anthropic-may-have-crossed-its-own-ai-acceleration-warning-threshold-back-in-july/
– Help Net Security, 2026-09-07 — https://www.helpnetsecurity.com/2026/09/07/openai-research-automation-intern/
– OpenAI, Research acceleration: The view inside OpenAI — https://openai.com/index/research-acceleration-view-inside-openai/ (403)
– Sam McCandlish X 게시물 — https://x.com/Sam_McCandlish/status/2118422266669371519 (402)
답글 남기기