

DGX Spark는 메모리 대역폭이 273GB/s라서 토큰 생성 속도가 RTX 5090의 약 4분의 1입니다. 64GB·128GB 가격, 모델별 실측 속도, Mac Studio와의 비교를 바탕으로 구매 기준을 정리했습니다.
이 글에는 네이버 브랜드커넥트 제휴 링크가 포함되어 있습니다. 링크를 통해 구매가 이루어지면 작성자가 일정액의 수수료를 지급받습니다. 제품 선택과 구매는 독자의 판단이며, 이 글은 특정 제품의 효과를 보증하지 않습니다.
로컬 LLM 핵심만 먼저 정리하면
DGX Spark를 사면 CUDA 개발 환경과 큰 모델을 올릴 메모리 용량이 생깁니다. 답변이 빨리 나오는 건 이 기기의 강점이 아닙니다. 메모리는 최대 128GB까지 넉넉합니다. 하지만 대역폭이 273 GB/s에 그칩니다. LMSYS가 2025년 10월 gpt-oss-20b로 잰 토큰 생성 속도는 RTX 5090의 약 4분의 1이었습니다.
그래서 이 기기는 “얼마나 큰 모델이 들어가는가”로 고르면 안 됩니다. 먼저 따질 것은 어떤 모델을 어느 정도 맥락 길이로 돌릴 것인가입니다. CUDA·TensorRT-LLM·SGLang을 그대로 쓰는 프로토타이핑, 700억(70B) 파라미터 이하 모델의 파인튜닝, 여러 대를 묶는 클러스터 실험이 목적이라면 맞는 기기입니다. 20~30B급 모델로 빠르게 대화하려는 거라면 더 싸고 빠른 대안이 있을 수 있습니다. 이 글은 NVIDIA 공식 사양, 2026년 10월 출시된 64GB 모델의 가격, llama.cpp·LMSYS 벤치마크, Mac Studio·RTX 5090과의 비교를 나란히 놓고 정리했습니다. 운영 서버용 GPU 선택은 다루지 않습니다.
Q1. 로컬 LLM 사양, DGX Spark에서는 무엇을 먼저 봐야 하나요?
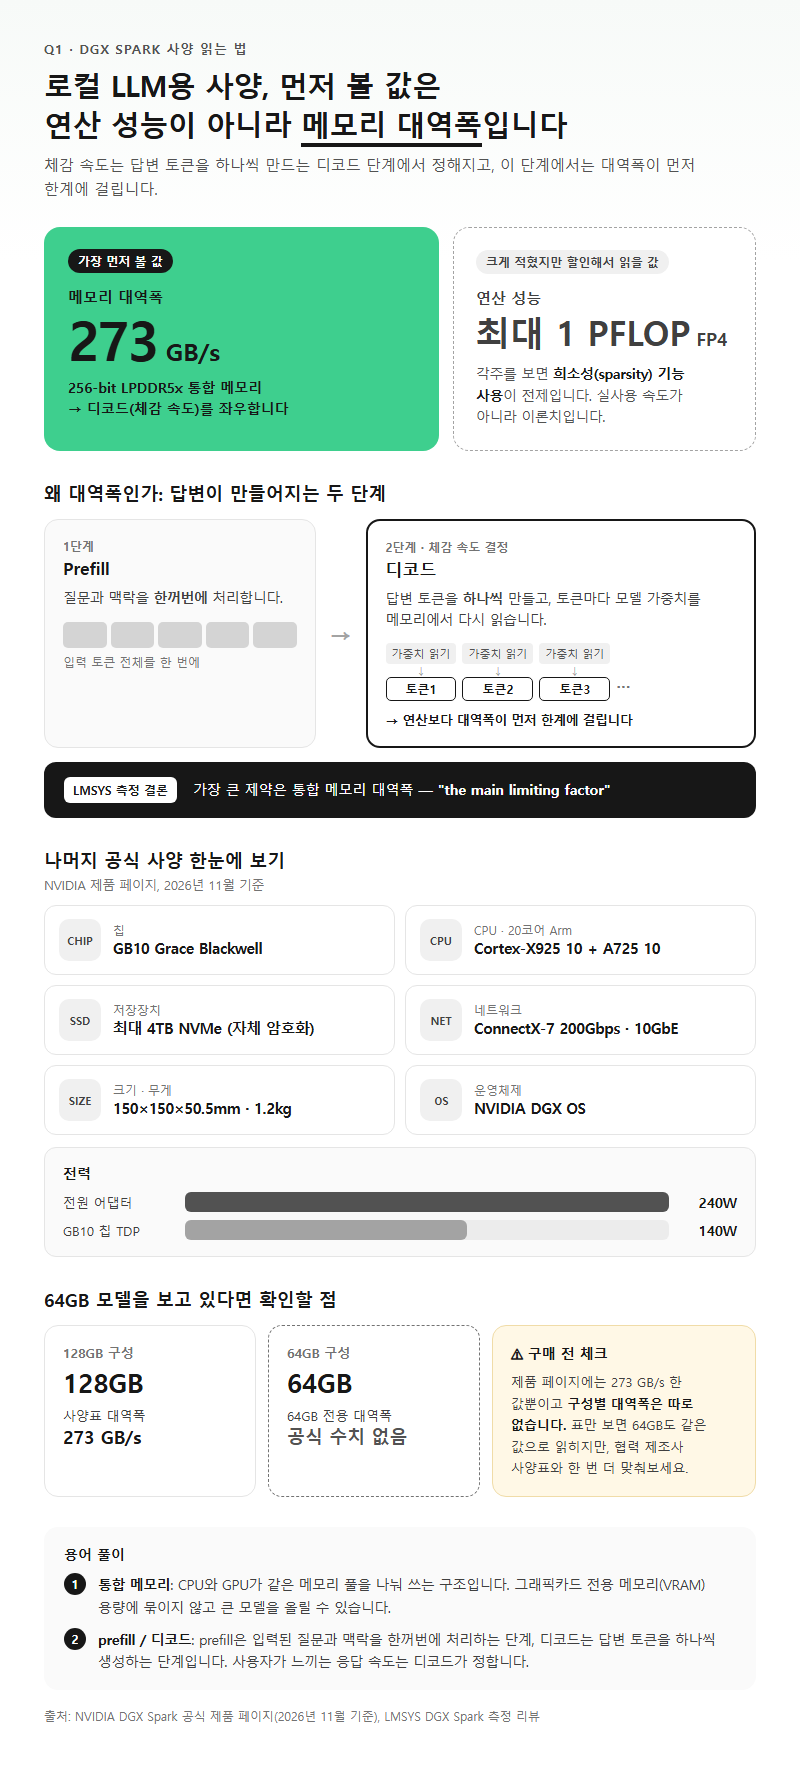
DGX Spark 사양에서 가장 먼저 볼 값은 연산 성능이 아니라 메모리 대역폭 273 GB/s입니다. 제품 페이지에 크게 적힌 “Up to 1 PFLOP FP4″는 각주를 보면 희소성(sparsity) 기능을 쓴다는 전제가 붙은 이론치입니다. 체감 속도는 토큰을 하나씩 만들어내는 디코드 단계에서 정해집니다. 이 단계에서는 토큰 하나를 만들 때마다 메모리에서 모델 가중치를 읽어와야 하므로 연산보다 대역폭이 먼저 발목을 잡습니다. LMSYS도 측정을 마친 뒤 통합 메모리 대역폭을 가장 큰 제약으로 꼽았습니다. 원문 표현은 “the main limiting factor”입니다.
| 항목 | 공식 사양 (NVIDIA 제품 페이지, 2026년 11월 기준) |
|---|---|
| 칩 | GB10 Grace Blackwell |
| CPU | 20코어 Arm (Cortex-X925 10개 + Cortex-A725 10개) |
| 메모리 | 64GB 또는 128GB LPDDR5x 통합 메모리 |
| 메모리 버스·대역폭 | 256-bit, 273 GB/s |
| 연산 성능 | 최대 1 PFLOP FP4 (희소성 전제) |
| 저장장치 | 최대 4TB NVMe (자체 암호화) |
| 네트워크 | ConnectX-7 200Gbps, 10GbE |
| 전력 | 전원 어댑터 240W, GB10 칩 TDP 140W |
| 크기·무게 | 150×150×50.5mm, 1.2kg |
| 운영체제 | NVIDIA DGX OS |
64GB 모델을 생각하고 있다면 짚어둘 점이 하나 있습니다. 제품 페이지 사양표에는 대역폭이 273 GB/s 한 값뿐이고 구성별 대역폭은 따로 나와 있지 않습니다. 표만 보면 64GB도 같은 값으로 읽힙니다. 하지만 NVIDIA가 64GB 전용 수치를 밝힌 적은 없으니, 구매 전에 협력 제조사 사양표와 한 번 더 맞춰보는 편이 안전합니다.
용어 풀이
1. 통합 메모리 — CPU와 GPU가 같은 메모리 풀을 나눠 쓰는 구조로, 그래픽카드 전용 메모리(VRAM) 용량 한계 없이 큰 모델을 올릴 수 있게 해줍니다.
2. prefill / 디코드 — prefill은 입력된 질문과 맥락을 한꺼번에 처리하는 단계이고, 디코드는 답변 토큰을 하나씩 생성하는 단계로 사용자가 느끼는 응답 속도를 결정합니다.
Q2. DGX Spark 64GB와 128GB, 로컬 LLM 가격 대비 어느 쪽이 맞나요?

가격만 놓고 보면 64GB 모델은 저렴한 입문형이 아닙니다. NVIDIA는 2026년 10월 2일 64GB 모델을 발표했고, 10월 23일부터 Acer·ASUS·Dell·Gigabyte·HP·MSI 같은 협력 제조사에서만 팔고 있습니다. 시작가는 $4,999입니다. 2025년 128GB 모델 출시가가 $3,999였으니, 메모리는 절반인데 값은 $1,000 더 비쌉니다. heise도 2026년 10월 3일 보도에서 64GB 모델이 출시 시점에 128GB 모델보다 비쌌다고 지적했습니다.
| 구분 | 가격 | 기준 시점 | 비고 |
|---|---|---|---|
| 128GB 2025년 출시가 (Founders Edition) | $3,999 | 2025년 출시 당시 | NVIDIA 직판 |
| Founders Edition 권장가 인상 | $4,699 | 2026년 2월 25일 공지 | 17.5% 인상, 하드웨어 변경 없음 |
| 64GB 협력 제조사 모델 | $4,999부터 | 2026년 10월 발표·판매 | 협력 제조사 전용 |
2026년 2월 인상 공지에서 NVIDIA가 든 이유는 “industry wide memory supply constraints”입니다. 같은 공지에는 협력 제조사(OEM)의 GB10 기기는 이번 가격 조정 대상이 아니라고 적혀 있습니다. 128GB 모델의 현재 판매가는 매체마다 보도한 값이 다릅니다. 결제 직전에 NVIDIA 마켓플레이스와 협력 제조사 판매처 가격을 직접 비교해 보세요.
용량을 고를 때는 NVIDIA가 공개한 모델 크기 상한에서 출발하면 됩니다.
| 구성 | 실행 가능한 모델 크기 상한 (NVIDIA 공식) |
|---|---|
| 64GB 1대 | 1,000억(100B) 파라미터 |
| 128GB 1대 | 2,000억(200B) 파라미터 |
| 128GB 2대 | 4,000억(400B) 파라미터 |
| 4대 클러스터 | 7,000억(700B) 파라미터 |
| 파인튜닝 | 700억(70B) 파라미터까지 |
판단 기준은 이렇습니다. 돌릴 모델이 20~30B급이고 긴 맥락을 자주 쓰지 않는다면 64GB로 충분합니다. 100B 이상 MoE 모델을 올리거나 70B 파인튜닝을 하려면 128GB가 사실상 출발선입니다. NVIDIA는 자체 시험(Qwen 3.8 27B)에서 64GB 2대 클러스터가 1대보다 최대 1.7배 빨랐다고 밝혔습니다. 다만 2대 값과 128GB 1대 값은 나란히 놓고 따져봐야 합니다.
Q3. 로컬 LLM 모델별로 DGX Spark 실제 속도는 어느 정도인가요?
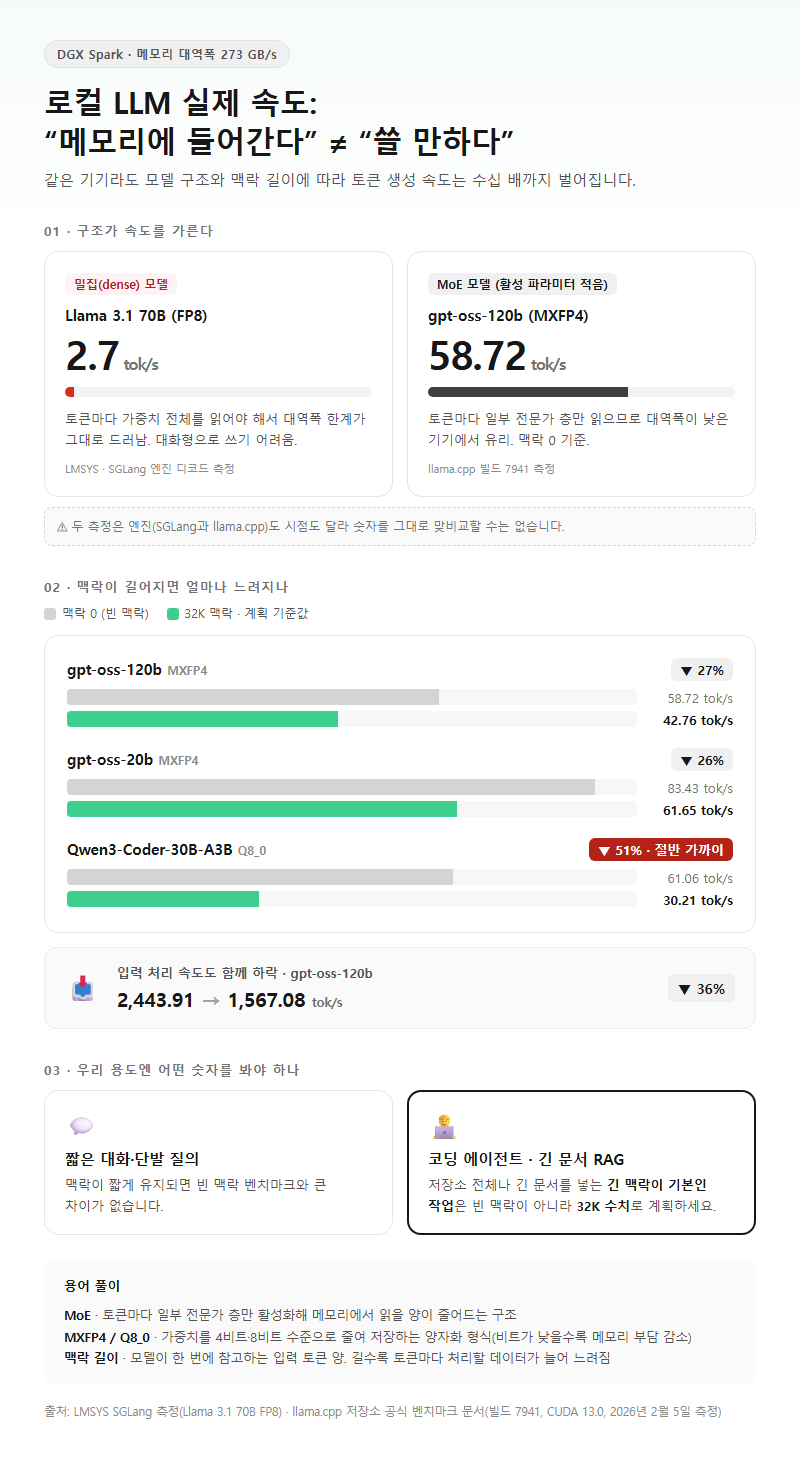
“모델이 메모리에 들어간다”와 “쓸 만한 속도로 돈다”는 별개입니다. 가장 극적인 예는 LMSYS가 SGLang으로 잰 Llama 3.1 70B(FP8)입니다. 디코드 속도가 2.7 tok/s에 그쳤습니다. 메모리에 들어가기는 해도 대화형으로 쓰기는 어렵습니다. 밀집(dense) 모델은 토큰 하나를 만들 때마다 가중치 전체를 읽어야 하므로 273 GB/s 대역폭의 한계가 그대로 드러납니다.
활성 파라미터가 적은 MoE 모델은 사정이 다릅니다. llama.cpp 저장소의 공식 벤치마크 문서(빌드 7941, CUDA 13.0, 2026년 2월 5일 측정)를 보면 gpt-oss-120b는 맥락이 비어 있을 때 토큰 생성 속도가 58.72 tok/s였습니다. 다만 두 측정은 엔진(SGLang과 llama.cpp)도 시점도 달라서 숫자를 그대로 맞비교할 수는 없습니다.
| 모델 (llama.cpp 빌드 7941) | 토큰 생성, 맥락 0 | 토큰 생성, 32K 맥락 |
|---|---|---|
| gpt-oss-120b (MXFP4) | 58.72 tok/s | 42.76 tok/s |
| gpt-oss-20b (MXFP4) | 83.43 tok/s | 61.65 tok/s |
| Qwen3-Coder-30B-A3B (Q8_0) | 61.06 tok/s | 30.21 tok/s |
구매 판단에서 이 표의 핵심은 맥락 길이에 따른 변화입니다. 32K 맥락에서 gpt-oss-120b의 토큰 생성은 27% 떨어졌고, Qwen3-Coder-30B-A3B는 51%, 절반 가까이 줄었습니다. 입력 처리 속도도 gpt-oss-120b 기준 2,443.91에서 1,567.08 tok/s로 내려갔습니다. 코드 저장소 전체를 맥락에 넣는 코딩 에이전트나 긴 문서를 다루는 RAG처럼 긴 맥락이 기본인 작업이라면, 빈 맥락 벤치마크가 아니라 32K 수치로 계획을 세우는 편이 맞습니다.
용어 풀이
1. MoE — 전체 파라미터 가운데 토큰마다 일부 전문가 층만 활성화하는 구조로, 메모리에서 읽어야 하는 양이 줄어 대역폭이 낮은 기기에서 유리합니다.
2. MXFP4 / Q8_0 — 모델 가중치를 4비트·8비트 수준으로 줄여 저장하는 양자화 형식으로, 비트 수가 낮을수록 메모리를 덜 쓰고 읽기 부담도 줄어듭니다.
3. 맥락(컨텍스트) 길이 — 모델이 한 번에 참고하는 입력 토큰의 양으로, 길어질수록 매 토큰 생성 때 처리할 데이터가 늘어 속도가 떨어집니다.
Q4. 로컬 LLM 미니PC로 DGX Spark 대신 Mac Studio나 RTX 5090을 고르는 게 나은 경우는?
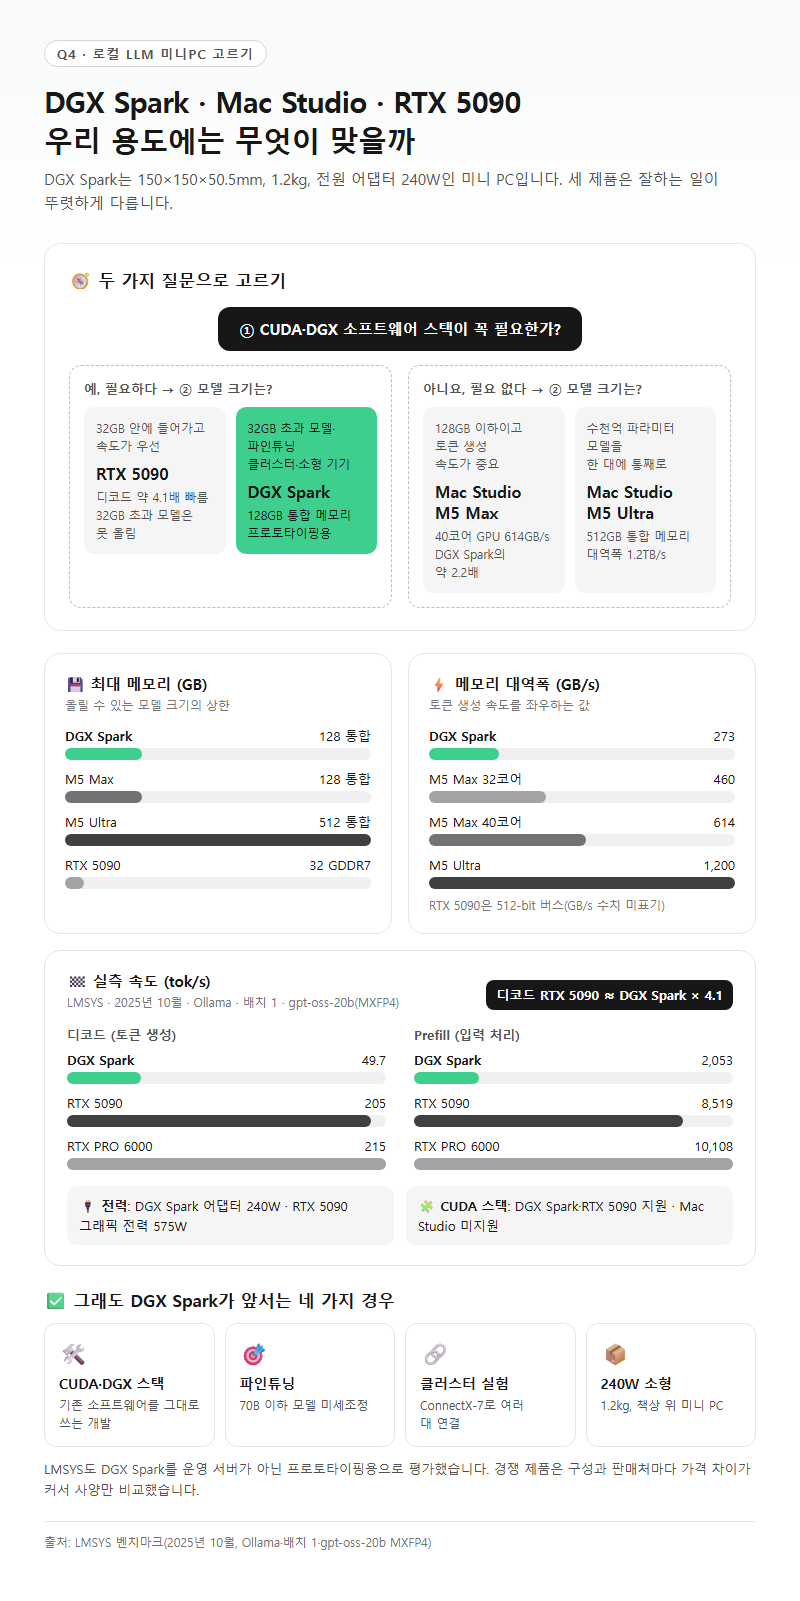
DGX Spark는 150×150×50.5mm, 1.2kg에 전원 어댑터 240W인 미니 PC 폼팩터입니다. 책상 위에 둘 AI 기기를 찾는다면 Mac Studio, 그리고 RTX 5090을 단 데스크톱이 비교 대상입니다. 세 제품은 강점이 뚜렷하게 갈립니다.
| 항목 | DGX Spark | Mac Studio M5 Max | Mac Studio M5 Ultra | RTX 5090 |
|---|---|---|---|---|
| 최대 메모리 | 128GB 통합 | 128GB 통합 | 512GB 통합 | 32GB GDDR7 |
| 메모리 대역폭 | 273 GB/s | 460 GB/s (32코어 GPU), 614 GB/s (40코어 GPU) | 1.2TB/s | 512-bit 버스 |
| 전력 | 어댑터 240W | — | — | 그래픽 전력 575W |
| CUDA 스택 | 지원 | 미지원 | 미지원 | 지원 |
LMSYS가 2025년 10월 Ollama, 배치 1, gpt-oss-20b(MXFP4) 조건으로 잰 결과를 보겠습니다. DGX Spark는 prefill 2,053 tok/s, 디코드 49.7 tok/s였습니다. 같은 조건에서 RTX 5090은 8,519 / 205 tok/s, RTX PRO 6000은 10,108 / 215 tok/s였습니다. 디코드만 보면 RTX 5090이 약 4.1배 빠릅니다. 모델이 32GB 안에 들어간다면 속도에서는 RTX 5090이 확실히 앞섭니다. 대신 32GB를 넘는 모델은 아예 올리지 못합니다.
Mac Studio M5 Max(40코어 GPU)는 대역폭이 DGX Spark의 약 2.2배입니다. CUDA가 필요 없고 토큰 생성 속도가 중요하다면 이쪽이 낫습니다. 수천억 파라미터 모델을 한 대에 통째로 올려야 한다면 512GB·1.2TB/s의 M5 Ultra를 보면 됩니다. 경쟁 제품들은 구성과 판매처에 따라 가격 차이가 커서 위 표에는 사양만 넣었습니다.
DGX Spark가 앞서는 경우는 네 가지입니다. CUDA·DGX 소프트웨어 스택을 그대로 쓰는 개발, 70B 이하 모델의 파인튜닝, ConnectX-7을 쓰는 다중 기기 클러스터 실험, 그리고 240W 소형 폼팩터입니다. LMSYS도 이 기기를 운영 서버가 아닌 프로토타이핑용으로 평가했습니다.
Q5. 로컬 LLM 구축 전, 벤치마크와 클러스터 수치에서 주의할 점은?
DGX Spark 관련 수치는 측정 조건에 따라 크게 달라집니다. 그러니 수치를 볼 때는 엔진·버전·맥락 길이·배치 크기부터 확인해야 합니다. 2026년 10월 27일 NVIDIA 개발자 블로그에 실린 MoE 최적화 결과가 좋은 예입니다. Ling-3.0-flash(전체 1,240억·활성 51억 파라미터)를 SGLang, 배치 1로 측정했더니 합성 부하(입력 32K, 출력 2K)에서는 디코드가 36.09에서 102.88 tok/s로 +185.1% 올랐습니다. 그런데 실제 문제 세트인 GSM8K 1,319문항에서는 37.81에서 53.89 tok/s로 +42.5%에 그쳤습니다. NVIDIA도 같은 글에서 합성 부하의 향상폭을 다른 작업에 그대로 적용할 수 없다고 밝혔습니다.
| 확인 항목 | 흔히 보이는 수치 | 실제로 따질 조건 |
|---|---|---|
| 소프트웨어 최적화 효과 | 합성 부하 +185.1% | 실제 문제 세트 +42.5% |
| CES 2026 성능 향상 발표 | 배수 형태로 홍보 | The Register 보도에 따르면 주로 prefill 개선 |
| 클러스터 대수 | 제품 페이지 최대 4대 | 2026년 10월 21일 블로그는 수동 구성 시 8대 |
| 엔진별 차이 | 같은 gpt-oss-20b | Ollama 49.7 tok/s(2025년 10월), llama.cpp 83.43 tok/s(2026년 2월) |
CES 2026 발표는 2026년 1월 5일 The Register가 보도했습니다. 기사는 개선이 주로 prefill 쪽에 몰려 있고 토큰 생성은 여전히 대역폭에 묶여 있다고 해설했고, 기자는 독립 검증을 하지 못했다고 밝혔습니다. 2026년 10월 21일 배포된 소프트웨어 업데이트는 리눅스 커널을 6.17에서 7.0으로 올렸고, 64GB·128GB를 한 소프트웨어로 지원합니다. 디스플레이를 연결하지 않으면 화면용으로 떼어두는 메모리가 최소 512MB까지 줄어듭니다. 다만 이 공지에 성능 수치는 없습니다.
클러스터 대수는 NVIDIA 자료끼리도 맞지 않습니다. 제품 페이지 안내는 최대 4대입니다. 2~3대는 QSFP 케이블로 직접 연결하고, 4대부터는 200GbE 외부 스위치가 필요합니다. 그런데 2026년 10월 21일 블로그(GTC 베를린)에는 “supports clusters of up to eight units in manual configuration”이라고 적혀 있습니다. 5대 이상을 계획한다면 수동 구성 조건과 스위치 비용까지 미리 챙겨두세요.
정리
DGX Spark의 성격은 273 GB/s 대역폭이 정합니다. 큰 모델을 올리는 데는 강하지만 토큰 생성 속도는 RTX 5090의 약 4분의 1이고, 32K 맥락에서는 모델에 따라 27~51% 더 느려집니다. 64GB 모델은 2026년 10월 기준 $4,999부터 시작해 2025년 128GB 출시가보다 비쌉니다. 돈을 아끼려고 고를 용량이 아니라 돌릴 모델이 30B급 이하로 정해진 경우에 맞는 선택입니다. CUDA 개발 환경, 70B 이하 파인튜닝, 클러스터 실험이 목적이면 DGX Spark를, 32GB 안의 모델을 빠르게 돌리는 게 목적이면 RTX 5090을, CUDA 없이 높은 대역폭이 필요하면 Mac Studio를 기준으로 비교하시면 됩니다.
함께 보면 좋은 제품
- 라이프밀 홀그레인 저당 그래놀라 귀리 시리얼 20g 7봉
- 그릭요거트 토핑을 올린 귀리 그래놀라 시리얼입니다.
위 링크는 제휴 링크이며, 제품 선택은 독자의 판단입니다.
참고 자료
조사 기준일: 2026년 11월 13일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (확인일 2026-11-13)
– https://www.nvidia.com/en-us/products/workstations/dgx-spark/
– https://blogs.nvidia.com/blog/local-ai-dgx-spark-64gb-sync/
– https://blogs.nvidia.com/blog/local-ai-gtc-rtx-dgx-spark-station-sync/
– https://forums.developer.nvidia.com/t/2-23-2026-price-change-announcement/361713
– https://forums.developer.nvidia.com/t/dgx-spark-software-updates-october-2026-release/386341
– https://developer.nvidia.com/blog/3-ways-to-boost-moe-inference-on-nvidia-dgx-spark/
– https://www.apple.com/mac-studio/specs/
– https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
– https://www.lmsys.org/blog/2025-10-13-nvidia-dgx-spark
– https://raw.githubusercontent.com/ggml-org/llama.cpp/master/benches/dgx-spark/dgx-spark.md
– https://www.theregister.com/2026/01/05/nvidia_dgx_spark_speed/
– https://www.heise.de/en/news/Nvidia-s-DGX-Spark-becomes-more-expensive-despite-halved-RAM-11475128.html
– https://www.tomshardware.com/desktops/mini-pcs/nvidia-dgx-spark-gets-18-percent-price-increase-as-memory-shortages-bite-founders-edition-now-usd4-699-up-from-usd3-999 (제목만 확인)
답글 남기기