
아사나 브라우저 에이전트의 76배 비용 절감은 모델을 바꾼 효과가 아닙니다. 기준선이 하한값이고, 절감의 대부분은 캐시와 히스토리 예산을 고친 데서 나왔습니다. 32쪽 원문 보고서로 숫자를 하나씩 나눠 봤습니다.
AI 에이전트 비용 핵심만 먼저 정리하면
아사나 브라우저 에이전트의 “76배 절감”은 모델 하나를 바꿔서 생긴 결과가 아닙니다. 다른 모델(Model B)의 개발 기준선 회당 비용 $36.21 이상을, 최적화를 마친 에이전트를 GPT-6.1 Sol에서 돌린 회당 비용 $0.47로 나눈 값입니다(Asana 보고서 2026년 9월 30일 공개, 가격은 9월 29일 기준). 여기서 GPT-6.1 Sol 덕분이라고 할 만한 몫은 약 2.6배입니다. 나머지는 에이전트가 같은 내용을 반복해서 다시 읽지 않도록 작업 방식을 고치면서 줄었습니다.
이 글은 Asana가 2026년 9월 30일자로 공개한 32쪽 기술 보고서 「How Asana used Codex to optimize browser agent costs and runtime」를 기준으로 썼습니다. 76배가 어떻게 계산됐는지, 보도마다 숫자가 왜 다른지, 우리 업무에 그대로 옮겨도 되는지를 차례로 짚습니다. 다른 회사 브라우저 에이전트 제품과의 비교는 공개된 자료가 없어 다루지 않습니다.
Q1. 아사나 76배 비용 절감은 정확히 무엇과 무엇을 비교한 숫자인가요?
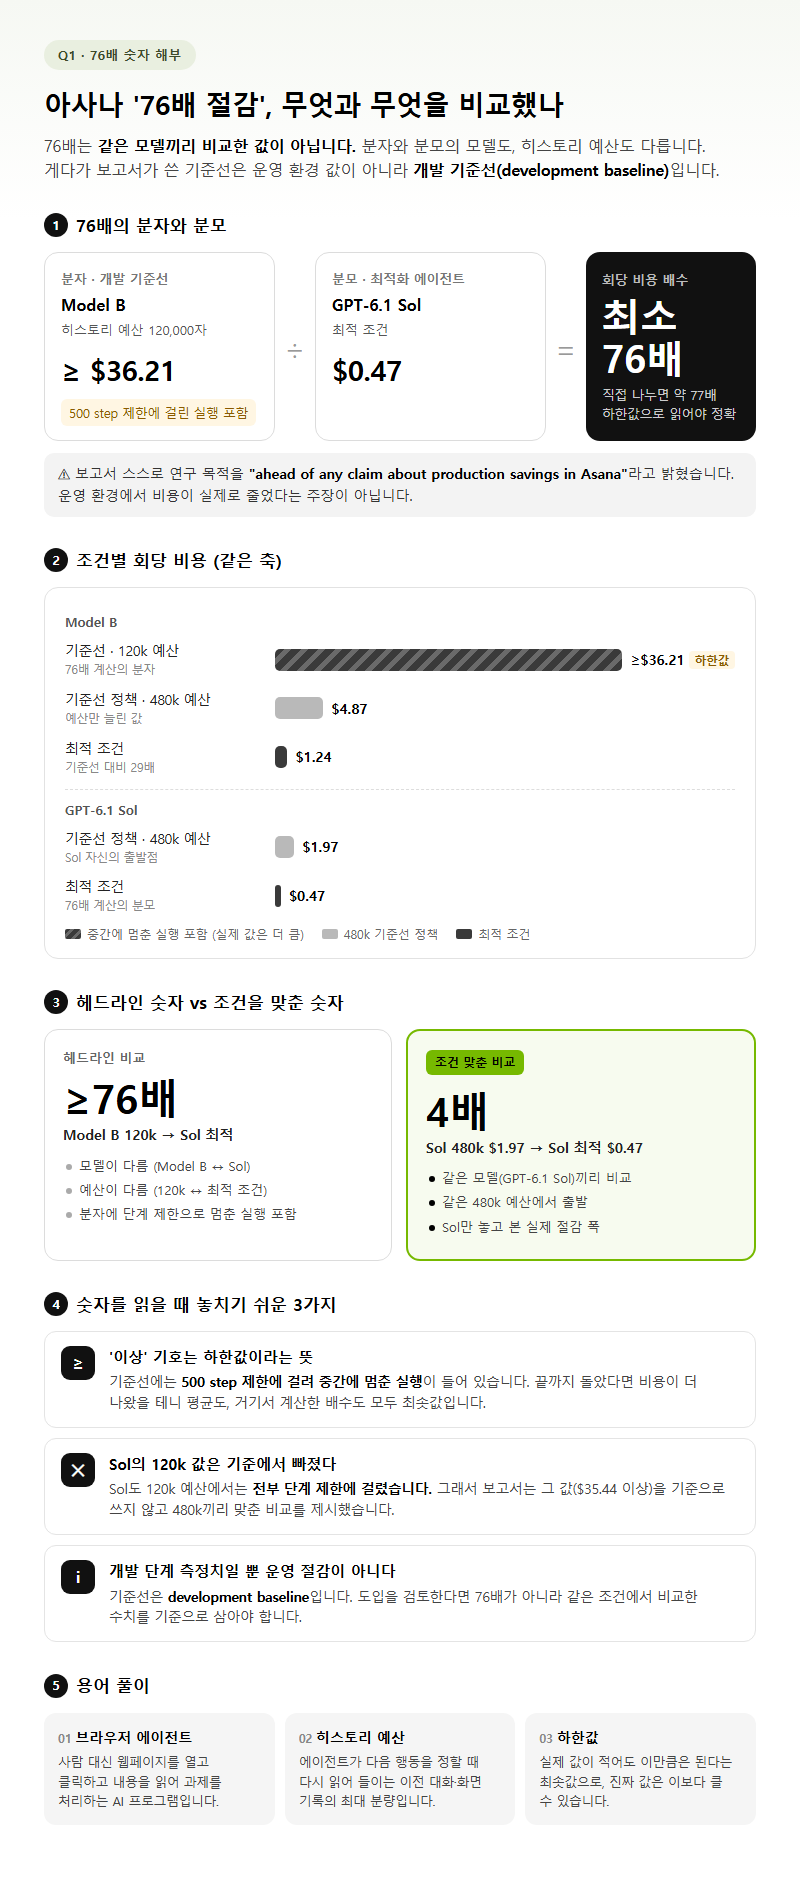
76배는 같은 모델끼리 비교한 값이 아닙니다. 분자는 Model B를 개발 기준선 설정(히스토리 예산 120,000자)으로 돌렸을 때의 회당 비용이고, 분모는 최적화한 에이전트를 GPT-6.1 Sol에서 돌린 회당 비용입니다. 보고서는 이 기준선을 “development baseline”이라 부르고, 연구 목적도 “ahead of any claim about production savings in Asana”라고 적었습니다. 운영 환경에서 실제로 비용이 줄었다고 주장하는 연구가 아니라는 뜻입니다.
| 비교 항목 | 회당 비용 | 비고 |
|---|---|---|
| Model B 기준선(120k 예산) | ≥$36.21 | 단계 제한에 걸린 실행 포함 |
| Model B 기준선 정책(480k 예산) | $4.87 | 예산만 늘린 값 |
| Model B 최적 조건 | $1.24 | 기준선 대비 29배 |
| GPT-6.1 Sol 기준선 정책(480k) | $1.97 | Sol 자신의 출발점 |
| GPT-6.1 Sol 최적 조건 | $0.47 | 76배 계산의 분모 |
기준선 숫자 앞에 붙은 ‘이상(≥)’을 놓치면 안 됩니다. 기준선에는 500 step 제한에 걸려 중간에 멈춘 실행이 들어 있습니다. 끝까지 돌았다면 비용이 더 나왔을 테니, 기준선 평균도 거기서 계산한 배수도 모두 하한값입니다. 76배는 ‘최소 76배’로 읽어야 정확합니다. 실제로 나눠 보면 약 77배가 나옵니다.
GPT-6.1 Sol만 놓고 보면 그림이 달라집니다. Sol도 120k 예산에서는 전부 단계 제한에 걸려서 보고서는 그 값($35.44 이상)을 기준으로 쓰지 않았습니다. 대신 480k 예산끼리 조건을 맞춘 비교를 제시하는데, 이때 Sol의 절감 폭은 $1.97에서 $0.47로 4배입니다.
용어 풀이
1. 브라우저 에이전트 — 사람 대신 웹페이지를 열고 클릭하고 내용을 읽어 과제를 처리하는 AI 프로그램입니다.
2. 히스토리 예산 — 에이전트가 다음 행동을 정할 때 다시 읽어 들이는 이전 대화·화면 기록의 최대 분량입니다.
3. 하한값 — 실제 값이 적어도 이만큼은 된다는 최솟값으로, 진짜 값은 이보다 클 수 있습니다.
Q2. 비용 절감의 대부분은 모델 교체가 아니라 어디서 나왔나요?
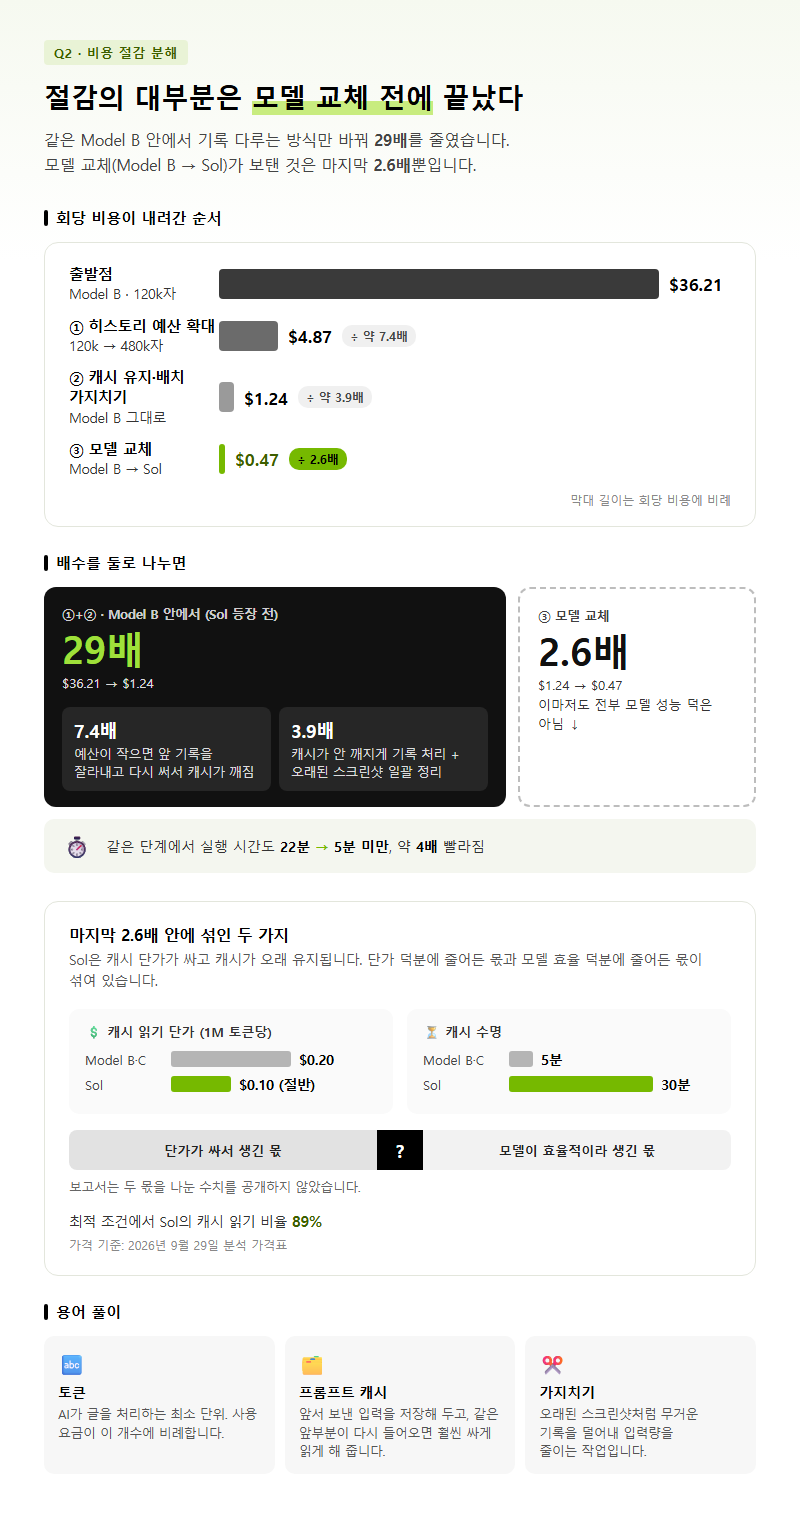
절감 폭을 단계별로 나누면 모델 교체는 마지막 2.6배뿐입니다. 같은 Model B에서 히스토리 예산을 120k자에서 480k자로 늘리기만 해도 회당 비용이 $36.21에서 $4.87로 약 7.4배 내려갑니다. 예산이 작으면 에이전트가 앞 기록을 계속 잘라내고 다시 고쳐 씁니다. 그럴 때마다 저장해 둔 캐시가 깨져 같은 내용을 비싼 값에 다시 읽게 됩니다.
| 단계 | 변화 | 배수 |
|---|---|---|
| ① 히스토리 예산 확대 | $36.21 → $4.87 | 약 7.4배 |
| ② 캐시 유지·배치 가지치기 | $4.87 → $1.24 | 약 3.9배 |
| ①+② 합계(Model B 안에서) | $36.21 → $1.24 | 29배 |
| ③ 모델 교체(Model B → Sol) | $1.24 → $0.47 | 2.6배 |
두 번째 단계에서는 캐시가 깨지지 않게 기록을 다루는 방식을 바꾸고, 오래된 스크린샷을 한꺼번에 정리하는 배치 가지치기를 넣었습니다. 여기서 다시 약 3.9배가 줄어 Model B 혼자 29배를 달성했습니다. 실행 시간도 22분에서 5분 미만으로, 4배 빨라졌습니다. GPT-6.1 Sol은 이 단계까지 등장하지 않습니다.
마지막 2.6배도 전부 모델 성능 덕분이라고 보기는 어렵습니다. 2026년 9월 29일 기준 분석 가격표에서 Sol의 캐시 읽기 단가는 1M 토큰당 $0.10으로, Model B·C의 $0.20의 절반입니다. 캐시 수명도 Sol은 30분, Model B·C는 5분으로 달랐습니다. 단가가 싸서 생긴 몫과 모델이 일을 효율적으로 해서 생긴 몫이 섞여 있지만, 보고서는 둘을 나눈 수치를 공개하지 않았습니다. 최적 조건에서 Sol의 캐시 읽기 비율은 89%였습니다.
용어 풀이
1. 토큰 — AI가 글을 처리하는 최소 단위로, 사용 요금이 이 개수에 비례해 매겨집니다.
2. 프롬프트 캐시 — 앞서 보낸 입력을 저장해 두었다가 똑같은 앞부분이 다시 들어오면 훨씬 싼 값에 읽게 해 주는 기능입니다.
3. 가지치기 — 에이전트 기록에서 오래된 스크린샷 같은 무거운 항목을 덜어내 입력량을 줄이는 작업입니다.
Q3. 어떤 기사는 76%, 어떤 기사는 76배라고 하는데 왜 숫자가 다른가요?
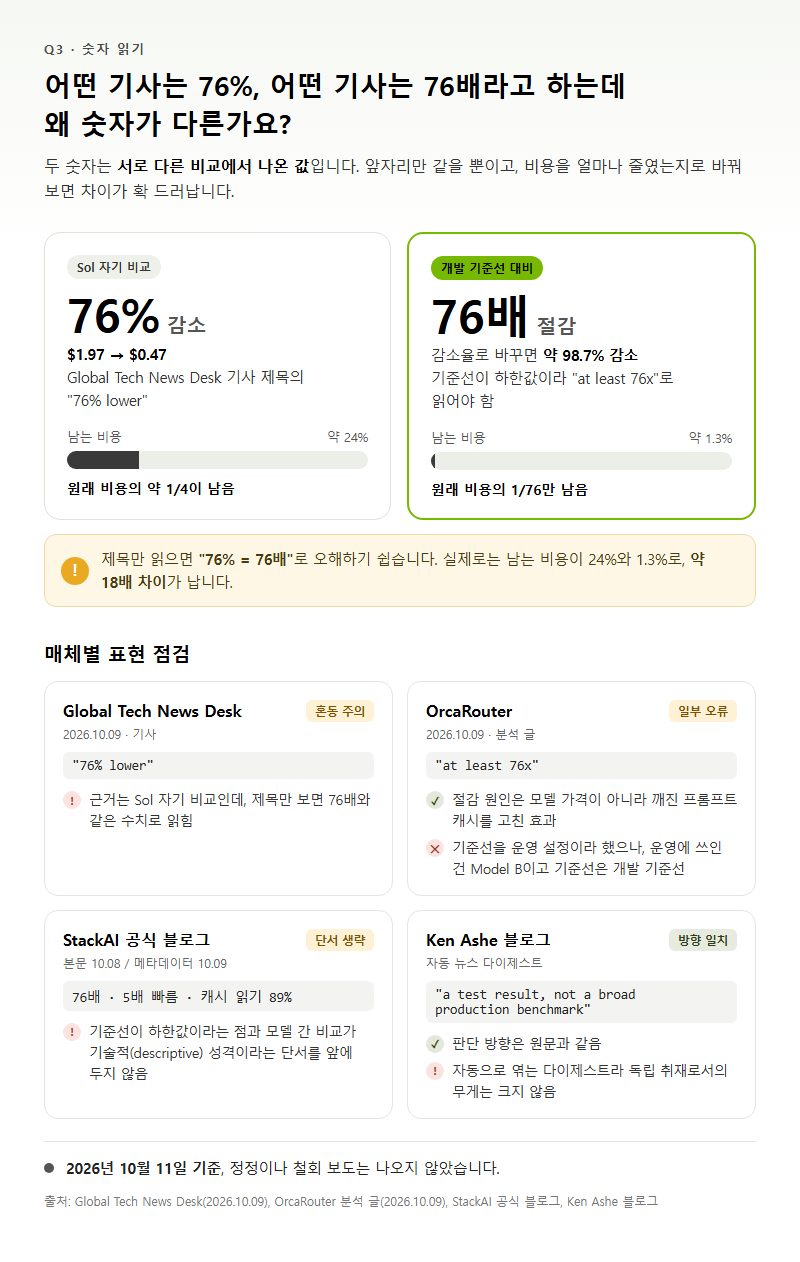
두 숫자는 서로 다른 비교에서 나온 값인데, 공교롭게 앞자리가 같아 헷갈리기 쉽습니다. Global Tech News Desk는 2026년 10월 9일 기사 제목에 “76% lower”를 썼습니다. 본문 근거는 Sol 자기 비교, 즉 $1.97에서 $0.47로 약 76% 줄었다는 내용입니다. 76배를 감소율로 바꾸면 약 98.7% 감소이니 전혀 다른 숫자입니다. 제목만 읽은 독자는 둘을 같은 것으로 오해하기 쉽습니다.
표현 차이는 다른 곳에도 있습니다. OrcaRouter는 2026년 10월 9일 분석 글에서 76배를 “at least 76x”로 읽어야 하고, 절감은 모델 가격이 아니라 깨진 프롬프트 캐시를 고친 효과라고 평가했습니다. 정확한 지적입니다. 다만 같은 글이 기준선을 운영 설정(production setup)이라고 한 대목은 원문과 맞지 않습니다. 보고서에서 운영에 쓰였다고 한 것은 Model B라는 모델 자체이고, 비교 기준선은 어디까지나 개발 기준선입니다.
발표 주체의 요약도 따로 읽어야 합니다. StackAI 공식 블로그는 76배, 5배 빠른 속도, 캐시 읽기 89%를 앞세웠습니다. 기준선이 하한값이라는 점과 모델 간 비교가 기술적(descriptive) 성격이라는 단서는 앞에 두지 않았습니다. 게시일도 본문 표기(10월 8일)와 메타데이터(10월 9일)가 서로 다릅니다.
Ken Ashe 블로그는 이 결과를 “a test result, not a broad production benchmark”로 규정했습니다. 판단 방향은 원문과 일치하지만, 이 사이트는 자동으로 엮는 뉴스 다이제스트라 독립 취재로서의 무게는 크지 않습니다. 2026년 10월 11일 기준으로 정정이나 철회 보도는 나오지 않았습니다.
Q4. 우리 회사 업무에도 GPT-6.1 Sol을 쓰면 비용이 이만큼 줄어들까요?
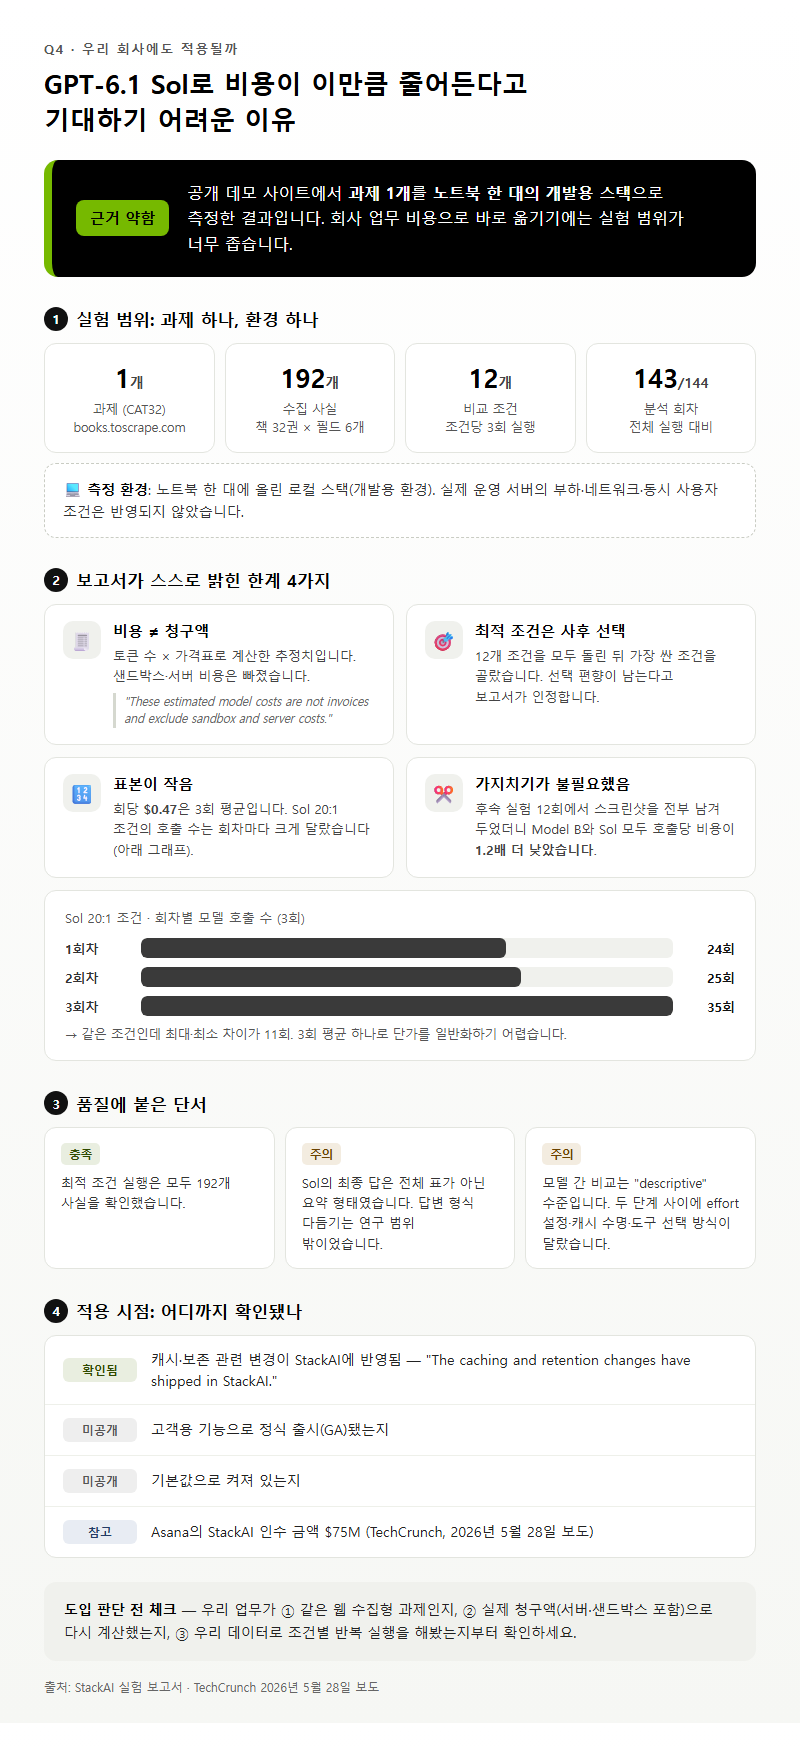
그렇게 기대할 근거는 약합니다. 실험 범위가 매우 좁습니다. 과제는 공개 데모 쇼핑몰인 books.toscrape.com에서 책 32권 × 6개 필드, 총 192개 사실을 모으는 CAT32 하나뿐입니다. 측정도 노트북 한 대에 올린 로컬 스택, 즉 개발용 환경에서 했습니다. 조건당 3회씩 모두 144회를 실행해 143회를 분석했습니다.
보고서가 스스로 밝힌 한계도 여럿입니다.
- 비용은 청구액이 아닙니다. 원문은 “These estimated model costs are not invoices and exclude sandbox and server costs.”라고 적었습니다. 토큰 수에 가격표를 곱한 추정치라는 뜻입니다.
- 최적 조건은 사후에 고른 값입니다. 12개 조건을 모두 돌린 뒤 가장 싼 조건을 골랐으니 선택 편향이 남는다고 보고서가 인정합니다.
- 표본이 작습니다. 회당 $0.47은 3회 평균이고, Sol의 20:1 조건 3회는 호출 수가 24·25·35회로 들쭉날쭉했습니다.
- 가지치기가 이 과제에서는 필요 없었습니다. 후속 실험 12회에서 스크린샷을 전부 남겨 두었을 때 Model B와 Sol 모두 호출당 비용이 1.2배 더 낮았습니다.
품질에도 단서가 붙습니다. 최적 조건 실행은 모두 192개 사실을 확인했습니다. 그런데 Sol의 최종 답은 전체 표가 아닌 요약 형태였고, 답변 형식을 다듬는 일은 연구 범위 밖이었습니다. 모델 간 비교도 보고서 스스로 “descriptive”하다고 규정합니다. 두 실험 단계 사이에 effort 설정, 캐시 수명, 도구 선택 방식이 달랐던 탓입니다.
적용 시점과 관련해 보고서에는 “The caching and retention changes have shipped in StackAI.”라는 문장이 있습니다. 캐시 관련 변경이 StackAI에 반영됐다는 뜻입니다. 고객이 쓰는 기능으로 정식 출시(GA)됐는지, 기본값으로 켜져 있는지는 회사가 밝히지 않았습니다. 참고로 Asana의 StackAI 인수 금액 $75M은 TechCrunch 2026년 5월 28일 보도에 나온 값입니다.
Q5. 그렇다면 이 보고서에서 실제로 참고할 만한 교훈은 무엇인가요?
가장 쓸모 있는 결론은 이것입니다. 에이전트 비용은 모델 단가보다 작업 방식이 좌우합니다. 같은 Model B에서도 설정만 바꿔 29배가 줄었습니다. 에이전트를 운영 중이라면 모델을 갈아타기 전에 호출마다 캐시 읽기 비율부터 재 보세요. 최적 조건의 캐시 읽기 비율은 Model A 94%, Model B 88%, Model C 73%, Sol 89%였습니다.
다음은 히스토리 예산을 모델에 맞춰야 한다는 점입니다. 120k 예산에서 Model C는 18회 중 0회, Sol은 18회 중 3회만 답을 냈습니다. 최신 모델이라도 예산이 작으면 과제를 끝내지 못합니다. 반대로 480k 예산은 이 과제에서 사실상 제한이 없는 것과 같았습니다. 그래도 상한을 아예 없애면 안 됩니다. 보고서도 실행당 500 step, 출력 16,384토큰, 비용 $75 상한을 두었습니다.
단가가 싼 모델이 과제 비용까지 싼 것도 아닙니다. Model A는 입력 단가가 1M 토큰당 $1.00으로 가장 낮았지만, 정답 가격 합계(£1,164.91)를 35회 중 2회만 맞혔습니다. 최적 조건 회당 비용은 Sol $0.47, Model C $0.66, Model A $0.84, Model B $1.24 순이었습니다. 속도만 보면 Model C가 3.5분으로 Sol(4.0분)보다 빨랐습니다.
GPT-6.1 Sol 도입을 검토한다면 가격 구조도 함께 봐야 합니다. 2026년 10월 11일 기준 OpenAI 공식 가격표의 gpt-6.1-sol 표준 단가는 1M 토큰당 입력 $2.00, 캐시 입력 $0.10, 캐시 쓰기 $2.50, 출력 $10.00입니다. 272K 토큰 이하 구간 기준이며, 272K를 넘으면 입력 $4.00·출력 $15.00으로 오릅니다. 급하지 않은 작업이라면 Batch·Flex 등급(입력 $1.00, 캐시 입력 $0.05)으로 더 낮출 여지가 있지만, 이 연구는 표준 등급에서만 측정했습니다. Model A·B·C의 실명과 제공사는 공개되지 않았으므로, 다른 회사 모델과의 순위는 이 보고서로 판단할 수 없습니다.
정리
아사나 브라우저 에이전트의 76배는 다른 모델의 개발 기준선과 Sol 최적 조건을 견준 하한값입니다. GPT-6.1 Sol 자체의 절감 폭은 같은 조건에서 4배, Model B 최적 조건 대비 2.6배입니다. 절감의 대부분은 히스토리 예산과 프롬프트 캐시를 바로잡은 데서 나왔습니다. 공개 데모 사이트의 과제 하나를 조건마다 3회씩 돌린 추정 비용이라는 한계도 함께 읽어야 합니다. 숫자를 그대로 옮기기보다 캐시 읽기 비율과 예산 설정부터 점검하는 쪽이 이 보고서를 실무에 제대로 쓰는 방법입니다.
참고 자료
조사 기준일: 2026년 10월 11일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료
– Asana 기술 보고서 PDF: https://assets.asana.biz/asset/fb86cc8e-6611-4404-b7c6-172692a724bb/How-Asana-used-Codex-to-optimize-browser-agent-costs-and-runtime.pdf (2026-10-11 확인, 전문 텍스트를 추출해 대조)
– OpenAI API Pricing: https://developers.openai.com/api/docs/pricing (2026-10-11 확인)
– (열람 실패, 403) OpenAI 사례 페이지: https://openai.com/index/asana-browser-agent/
– (열람 실패, 403) OpenAI GPT-6.1 Sol 발표: https://openai.com/index/introducing-gpt-6-1-sol/
– StackAI 블로그: https://www.stackai.com/blog/how-stackai-by-asana-used-astra-codex-and-command-to-reduce-browser-agent-costs (2026-10-11 확인)
– OrcaRouter: https://www.orcarouter.ai/blog/gpt-6-1-sol-browser-agent-76x (2026-10-11 확인)
– Global Tech News Desk: https://www.globaltechnewsdesk.com/2026/10/asana-reports-76-lower-estimated-gpt-61.html (2026-10-11 확인)
– Ken Ashe: https://kenashe.ai/blog/2026-10-09-asanas-browser-agent-test-points-to-the-real-ai-cost-story (2026-10-11 확인)
– TechCrunch: https://techcrunch.com/2026/05/28/asana-acquires-no-code-agent-builder-stack-ai/ (2026-10-11 확인)
답글 남기기