
Ai2가 2026년 10월 2일 공개한 AstaBrief 8B는 8단계 딥리서치 파이프라인의 작성 단계를 한 번의 호출로 줄였습니다. 속도, 벤치마크, 공개 구성, 직접 붙여야 하는 부분을 근거와 함께 정리했습니다.
허깅페이스 핵심만 먼저 정리하면
AstaBrief 8B는 검색을 이미 갖춘 팀이 보고서 작성 단계만 싸고 빠르게 바꿀 때 고를 만한 모델입니다. 검색 범위를 넓히거나 전체 품질을 최대로 끌어올리는 게 목적이라면 아직 이 모델을 고를 이유가 약합니다. Ai2(Allen Institute for AI)는 2026년 10월 2일 AstaBrief 8B와 학습 데이터를 함께 공개했습니다. Asta 제품 안에서 잰 보고서 1건당 생성 시간은 51.1초 대 178.5초로 약 3.5배 차이가 납니다.
이 속도 차이는 같은 검색 결과를 넣었을 때 작성 단계에서 생긴 것이고, 검색 단계는 그대로입니다. 품질은 자체 테스트셋(ScholarQA-CS2)에서 Claude 기반 파이프라인과 비슷했지만 DeepScholarBench에서는 6.75점 뒤졌습니다. 이 글에서는 원래 파이프라인과 AstaBrief의 구조 차이, 벤치마크, 공개 구성과 실행 조건, 학습 방식, 경쟁 모델과 나눠 쓰는 기준을 차례로 다룹니다. 한국어 질의나 컴퓨터과학(CS) 외 분야의 성능은 공개된 평가가 없어 제외했습니다.
Q1. AstaBrief 8B는 딥리서치 보고서를 어떤 구조로 만드나요?
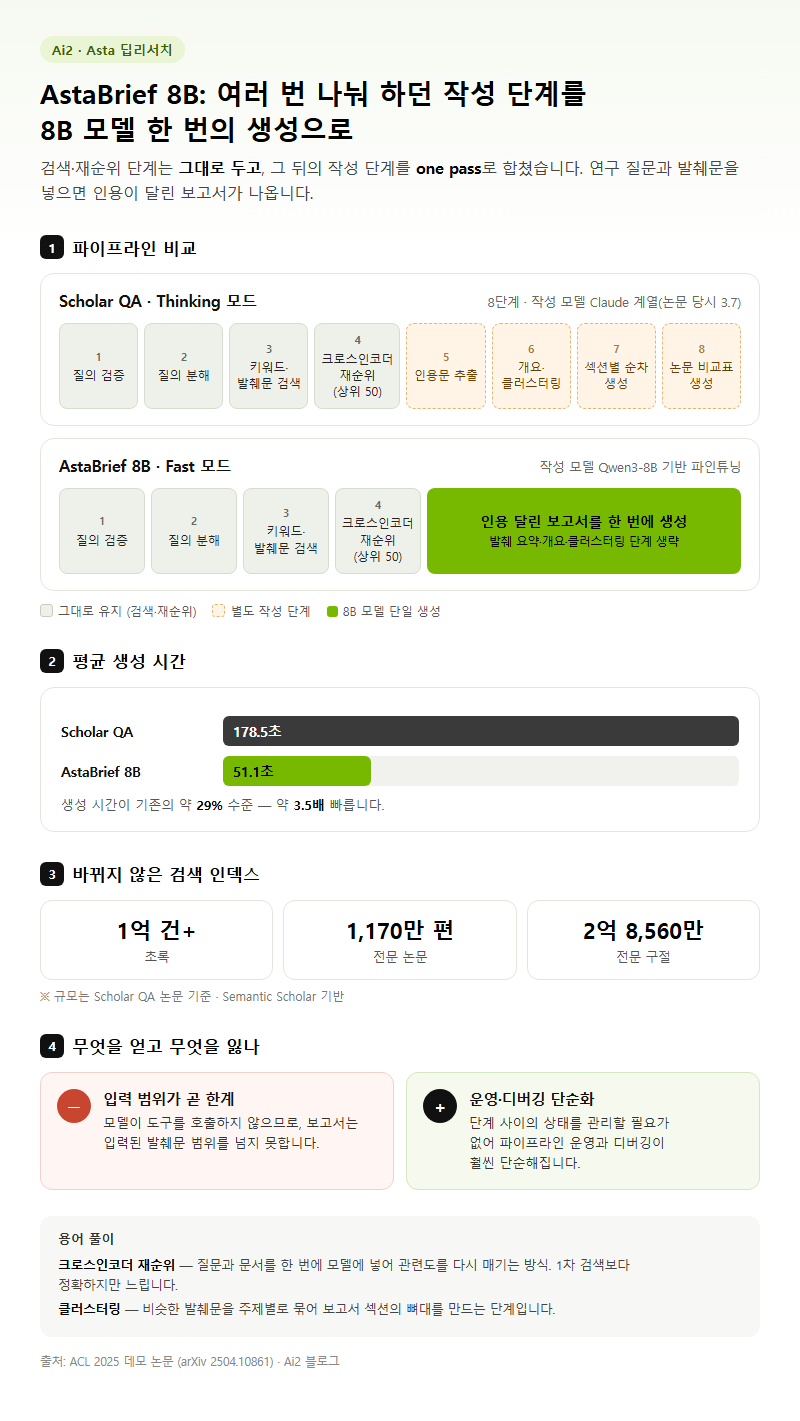
여러 번 나눠 하던 작성 호출을 8B 모델 한 번으로 바꾼 것이 핵심입니다. ACL 2025 데모 논문(arXiv 2504.10861)에 따르면 Ai2의 원래 Scholar QA 파이프라인은 8단계로 돌아갑니다. 질의를 검증하고 분해한 뒤 Semantic Scholar에서 키워드와 발췌문으로 검색하고, 크로스인코더로 상위 50개 발췌문의 순위를 다시 매깁니다. 그다음 인용문 추출, 개요 작성과 클러스터링, 섹션별 순차 생성, 논문 비교표 생성이 이어집니다.
| 구분 | Scholar QA (Thinking 모드) | AstaBrief 8B (Fast 모드) |
|---|---|---|
| 검색·재순위 | 그대로 유지 | 그대로 유지 |
| 발췌 요약 | 별도 단계 | 생략 |
| 개요·클러스터링 | 별도 단계 | 생략 |
| 섹션 작성 | 섹션별로 순서대로 생성 | 인용이 달린 보고서를 한 번에 생성 |
| 작성 모델 | Claude 계열 (논문 당시 Claude 3.7) | Qwen3-8B 기반 파인튜닝 |
| 평균 생성 시간 | 178.5초 | 51.1초 |
AstaBrief에는 연구 질문과 미리 검색해 둔 논문 발췌문이 들어가고, 인용이 달린 보고서가 나옵니다. 이 과정을 one pass, 즉 한 번의 생성으로 끝냅니다. Ai2 블로그에 따르면 검색 단계는 손대지 않고 그 뒤 단계만 바꿨습니다. 검색 인덱스는 초록 1억 건 이상, 전문 1,170만 편(2억 8,560만 개 구절)이며 이 규모는 Scholar QA 논문 기준입니다.
대가도 분명합니다. 모델이 도구를 호출하지 않으니 보고서는 입력된 발췌문 범위를 넘지 못합니다. 그 대신 단계 사이의 상태를 관리할 필요가 없어 운영과 디버깅이 훨씬 단순해집니다.
용어 풀이
1. 크로스인코더 재순위 — 질문과 문서를 한 번에 모델에 넣어 관련도를 다시 매기는 방식으로, 1차 검색보다 정확하지만 느립니다.
2. 클러스터링 — 비슷한 발췌문을 주제별로 묶어 보고서 섹션의 뼈대를 만드는 단계입니다.
Q2. 3.5배 빠르다는데 품질은 Claude 파이프라인과 비교해 어떤가요?
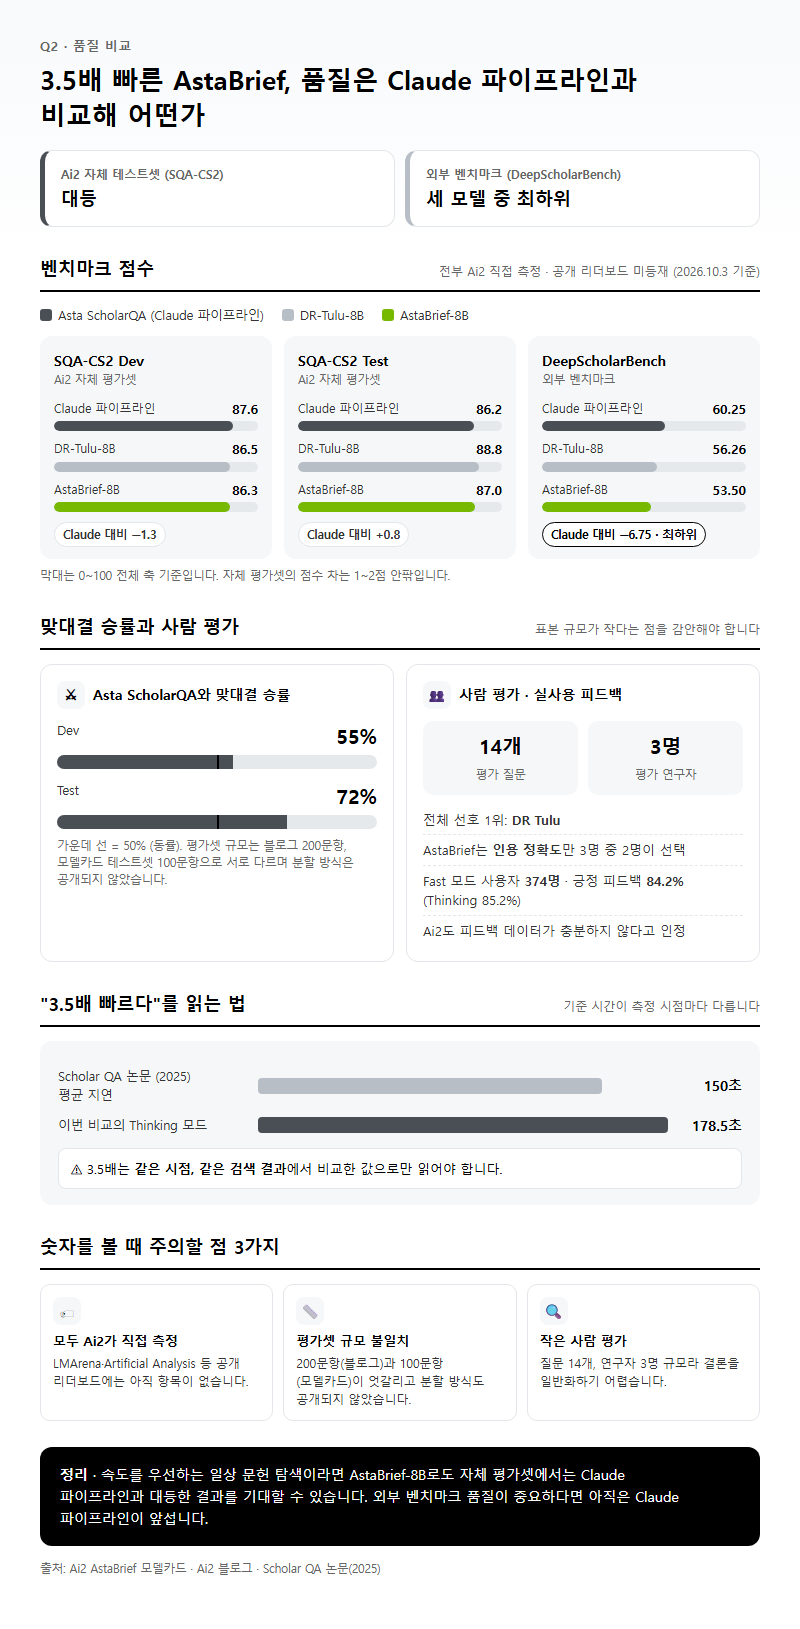
자체 테스트셋에서는 대등하고, 외부 벤치마크에서는 뒤집니다. 아래 표는 Ai2 모델카드에 실린 비교로, 전부 Ai2가 직접 측정한 값입니다. 2026년 10월 3일 기준 LMArena나 Artificial Analysis 같은 공개 리더보드에는 AstaBrief 항목이 없습니다.
| 모델 | SQA-CS2 Dev | SQA-CS2 Test | DeepScholarBench |
|---|---|---|---|
| Asta ScholarQA (Claude 파이프라인) | 87.6 | 86.2 | 60.25 |
| DR-Tulu-8B | 86.5 | 88.8 | 56.26 |
| AstaBrief-8B | 86.3 | 87.0 | 53.50 |
Asta ScholarQA와 맞붙인 승률은 Dev 55%, Test 72%인데, DeepScholarBench에서는 세 모델 가운데 가장 낮습니다. 평가셋 규모도 문서마다 다릅니다. Ai2 블로그는 SQABench-CS2를 200문항, 모델카드는 테스트셋을 100문항으로 적었습니다. Dev와 Test가 100문항씩일 수도 있지만 Ai2는 분할 방식을 밝히지 않았습니다.
사람 평가는 질문 14개, 연구자 3명 규모였습니다. 전체 선호 1위는 DR Tulu였고, AstaBrief는 인용 정확도 항목에서만 3명 중 2명의 선택을 받았습니다. 실사용 지표도 결론이 같습니다. Fast 모드를 써본 사용자는 374명, 긍정 피드백 비율은 84.2%(Fast)와 85.2%(Thinking)로 거의 차이가 없었습니다. Ai2 스스로도 이 피드백 데이터가 충분하지 않다고 인정했습니다.
속도 비교에도 단서가 하나 붙습니다. 2025년 Scholar QA 논문은 평균 지연을 2.5분(약 150초)으로 적었는데, 이번 비교의 Thinking 모드는 178.5초입니다. 측정 시점에 따라 기준 시간이 달라지므로, 3.5배는 같은 시점·같은 검색 결과에서 비교한 값으로만 읽어야 합니다.
Q3. 허깅페이스 AI 모델로 받으면 바로 돌릴 수 있나요?
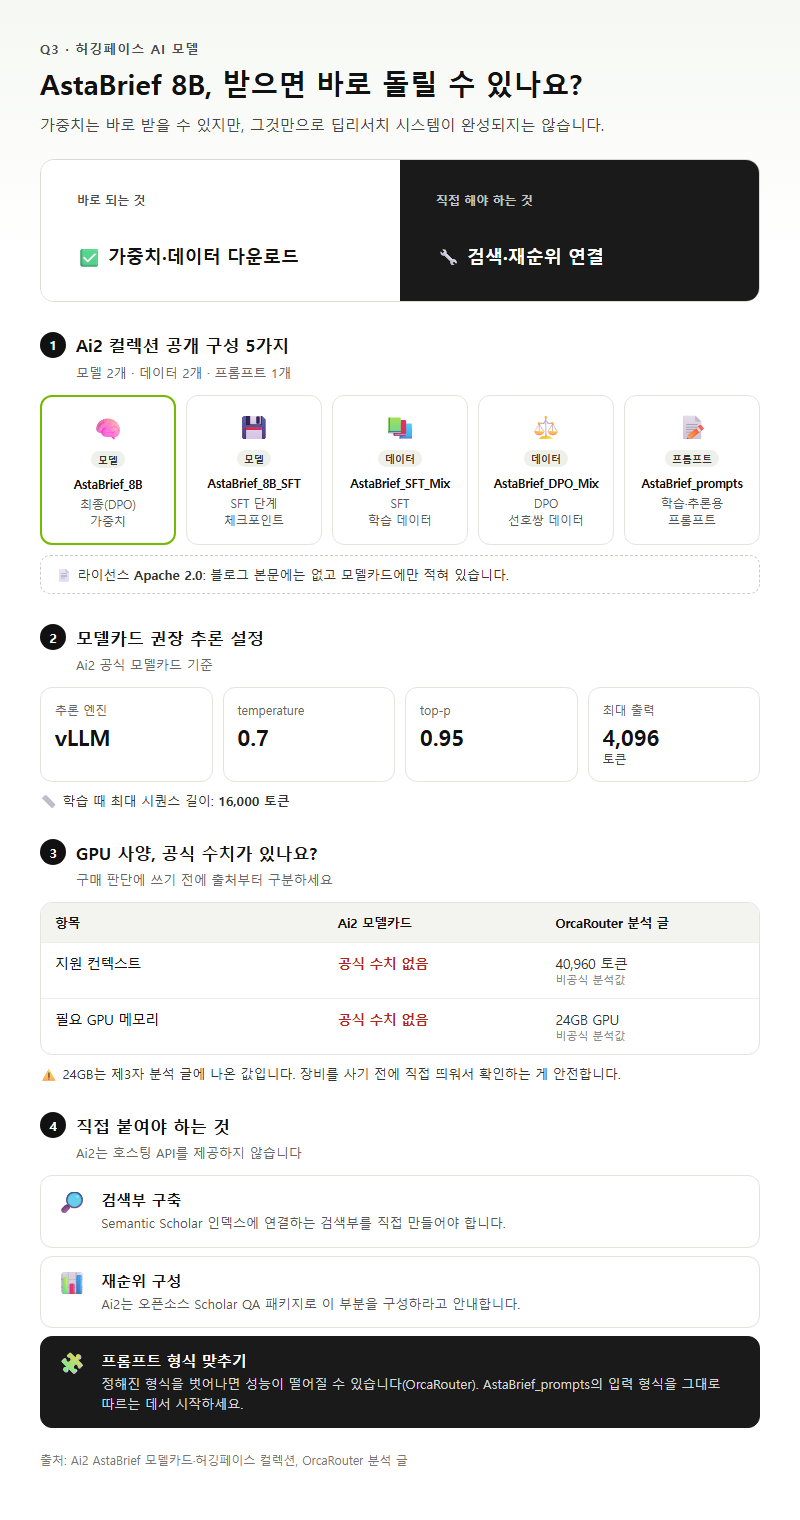
가중치는 바로 받을 수 있습니다. 그렇다고 딥리서치 시스템이 완성되는 건 아닙니다. Ai2 컬렉션에 공개된 구성은 다섯 가지이고, 라이선스는 Apache 2.0입니다. 라이선스는 블로그 본문에는 없고 모델카드에만 적혀 있습니다.
| 공개 항목 | 내용 |
|---|---|
| AstaBrief_8B | 최종(DPO) 모델 가중치 |
| AstaBrief_8B_SFT | SFT 단계 체크포인트 |
| AstaBrief_SFT_Mix | SFT 학습 데이터 |
| AstaBrief_DPO_Mix | DPO 선호쌍 데이터 |
| AstaBrief_prompts | 학습·추론용 프롬프트 |
모델카드가 권장하는 추론 설정은 vLLM, temperature 0.7, top-p 0.95, 최대 출력 4,096 토큰이고, 학습 때 최대 시퀀스 길이는 16,000 토큰이었습니다. OrcaRouter 분석 글은 지원 컨텍스트를 40,960 토큰, 구동 메모리를 24GB GPU로 적었지만 Ai2 모델카드에는 두 수치 모두 없습니다. 필요 GPU 메모리 역시 Ai2의 공식 수치가 없습니다.
직접 붙여야 하는 건 검색과 재순위입니다. Ai2가 호스팅 API를 제공하지 않으니 Semantic Scholar 인덱스에 연결하는 검색부를 직접 만들어야 하고, Ai2는 오픈소스 Scholar QA 패키지로 이 부분을 구성하라고 안내합니다. OrcaRouter는 정해진 프롬프트 형식을 벗어나면 성능이 떨어질 수 있다고 짚었습니다. AstaBrief_prompts의 입력 형식을 그대로 맞추는 데서 시작하는 게 맞습니다.
Q4. SFT와 DPO는 어떻게 했고, 단계마다 무엇이 달라졌나요?
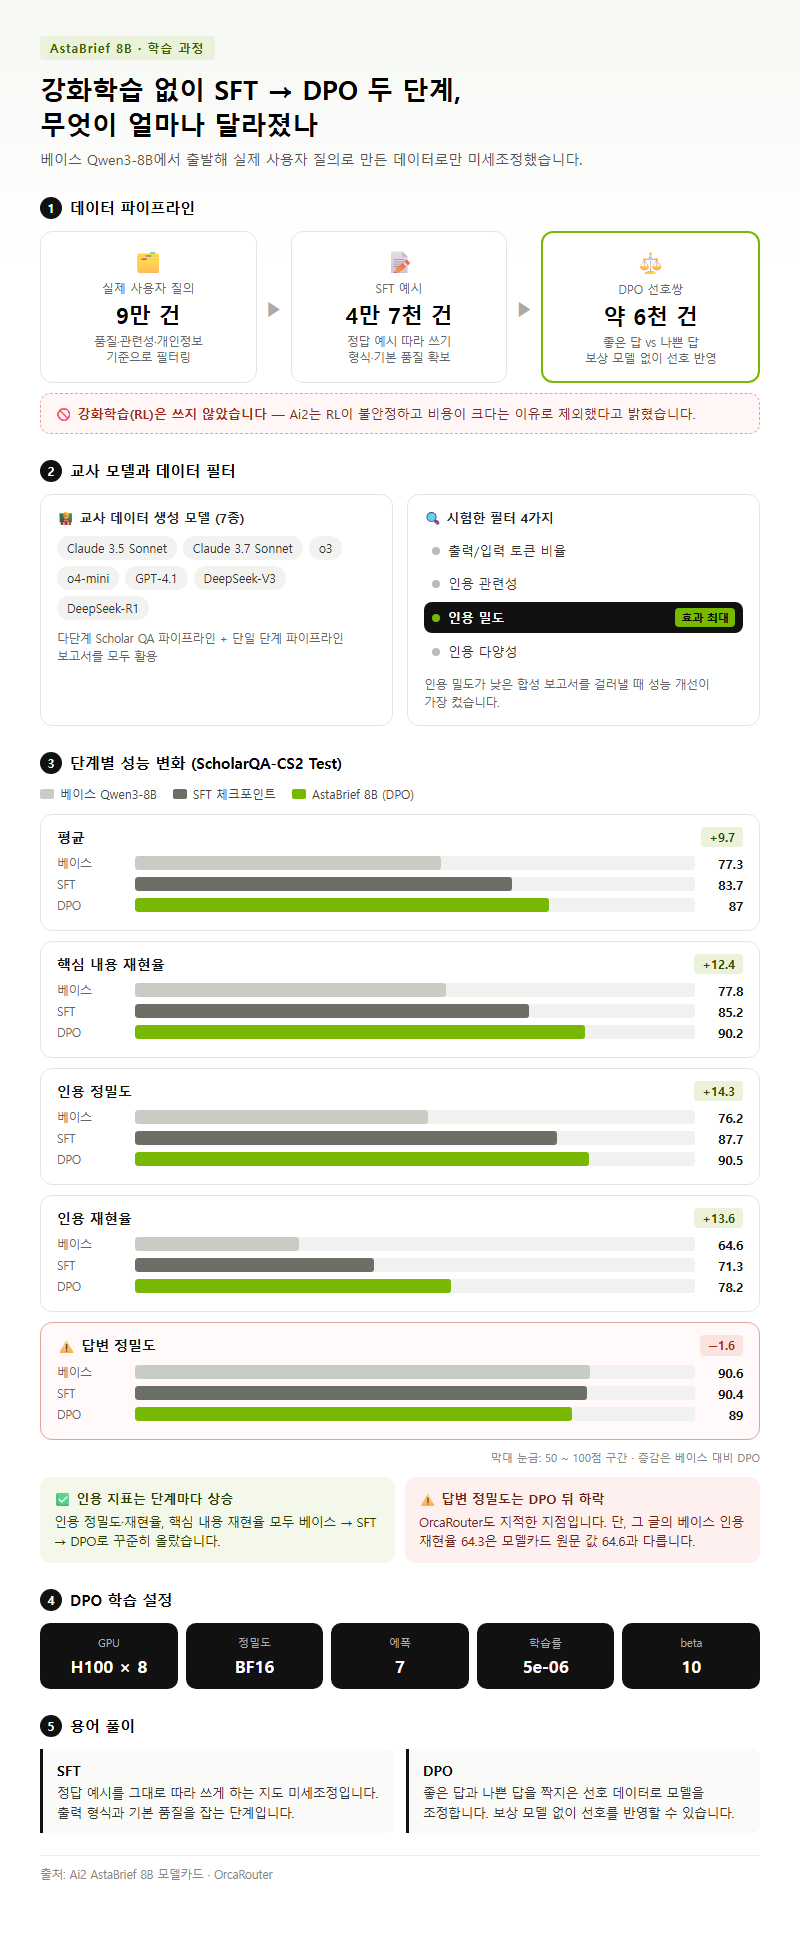
학습은 강화학습 없이 SFT와 DPO 두 단계로만 진행했습니다. Ai2는 RL이 불안정하고 비싸서 쓰지 않았다고 밝혔습니다. 품질, 관련성, 개인정보 기준으로 거른 실제 사용자 질의 9만 건에서 SFT 예시 4만 7천 건과 DPO 선호쌍 약 6천 건을 만들었습니다.
교사 데이터 생성에는 Claude 3.5 Sonnet, Claude 3.7 Sonnet, o3, o4-mini, GPT-4.1, DeepSeek-V3, DeepSeek-R1이 쓰였고, 다단계 Scholar QA 파이프라인과 단일 단계 파이프라인의 보고서를 모두 활용했습니다. Ai2가 시험한 데이터 필터는 네 가지(출력/입력 토큰 비율, 인용 관련성, 인용 밀도, 인용 다양성)입니다. 그중 인용 밀도가 낮은 합성 보고서를 거를 때 효과가 가장 컸다고 합니다.
| 지표 (ScholarQA-CS2 Test) | 베이스 Qwen3-8B | SFT 체크포인트 | AstaBrief 8B (DPO) |
|---|---|---|---|
| 평균 | 77.3 | 83.7 | 87 |
| 핵심 내용 재현율 | 77.8 | 85.2 | 90.2 |
| 답변 정밀도 | 90.6 | 90.4 | 89 |
| 인용 정밀도 | 76.2 | 87.7 | 90.5 |
| 인용 재현율 | 64.6 | 71.3 | 78.2 |
인용 관련 지표는 단계마다 꾸준히 올랐습니다. 반면 답변 정밀도는 DPO 이후 오히려 내려갔고, OrcaRouter도 이 지점을 지적했습니다. 다만 그 글은 베이스 모델의 인용 재현율을 64.3으로 옮겨 적었는데, 모델카드 원문 값은 64.6입니다. DPO는 H100 8장, BF16 환경에서 7에폭, 학습률 5e-06, beta 10으로 돌렸습니다.
용어 풀이
1. SFT — 정답 예시를 그대로 따라 쓰게 하는 지도 미세조정으로, 출력 형식과 기본 품질을 잡는 단계입니다.
2. DPO — 좋은 답과 나쁜 답을 짝지은 선호 데이터로 모델을 조정하는 방식으로, 보상 모델 없이 선호를 반영할 수 있습니다.
Q5. DR Tulu, Thinking 모드와 비교하면 언제 무엇을 써야 하나요?
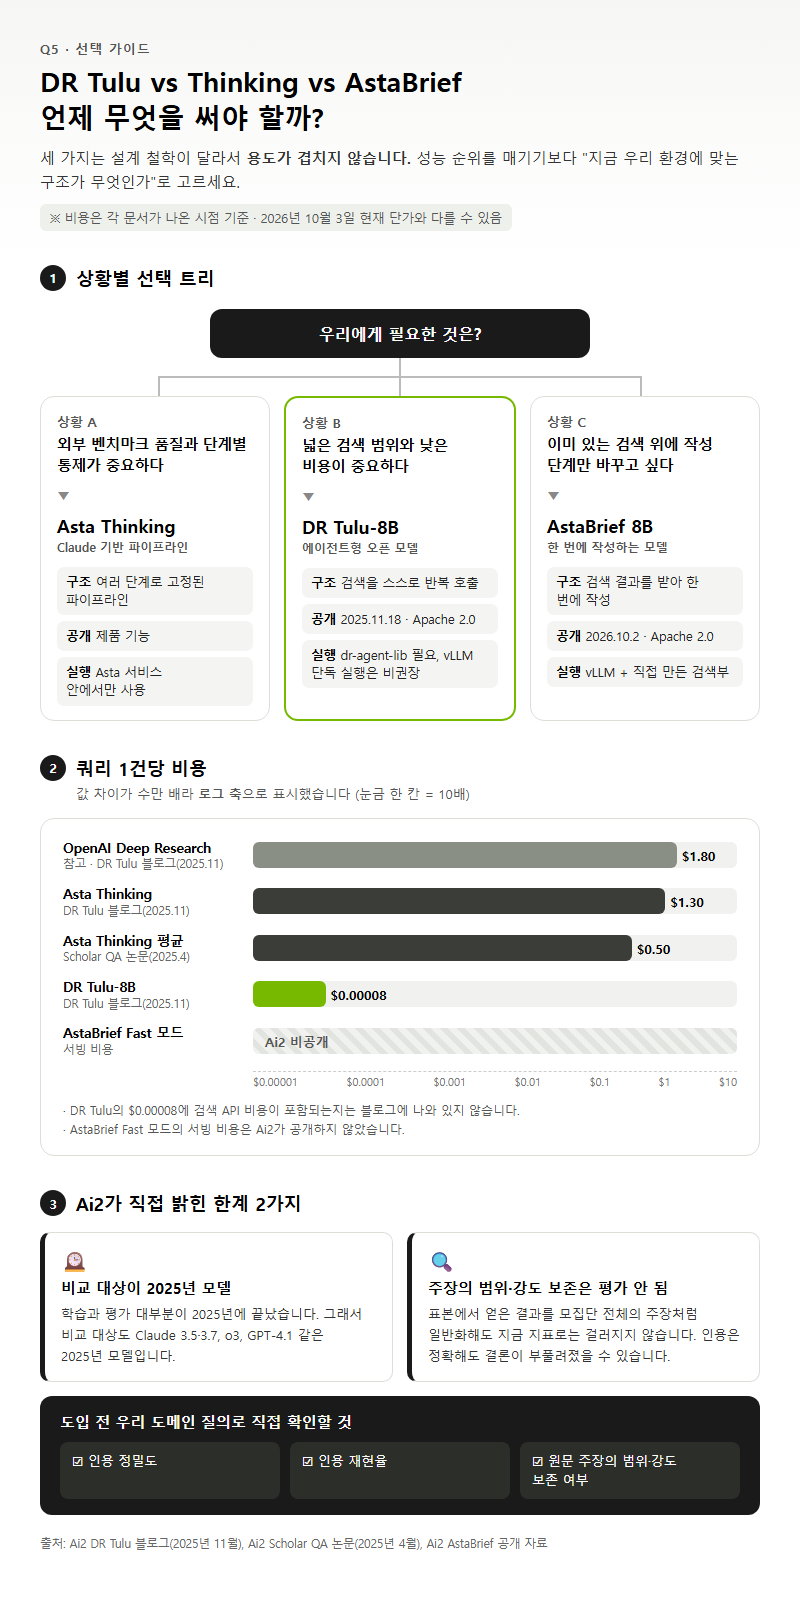
세 선택지는 설계 철학이 달라 용도가 겹치지 않습니다. 아래 비용은 각 문서가 나온 시점의 값이라 2026년 10월 3일 현재 단가와 다를 수 있습니다.
| 기준 | Asta Thinking (Claude 파이프라인) | DR Tulu-8B | AstaBrief 8B |
|---|---|---|---|
| 구조 | 다단계 고정 파이프라인 | 검색을 스스로 반복 호출하는 에이전트형 | 검색 결과를 받아 한 번에 작성 |
| 공개 | 제품 기능 | 2025년 11월 18일, Apache 2.0 | 2026년 10월 2일, Apache 2.0 |
| 쿼리당 비용 | 약 $1.30 (2025년 11월 DR Tulu 블로그), 평균 $0.50 (2025년 4월 Scholar QA 논문) | 약 $0.00008 (2025년 11월 DR Tulu 블로그) | Ai2 비공개 |
| 실행 조건 | Asta 서비스 안에서 사용 | dr-agent-lib 필요, vLLM 단독 실행 비권장 | vLLM + 직접 만든 검색부 |
| 유리한 상황 | 외부 벤치마크 품질, 단계별 통제 | 넓은 검색 범위, 전체 선호도 | 기존 검색 위에 작성 단계만 교체 |
DR Tulu의 $0.00008은 DR Tulu 블로그에 나온 값이고, 같은 글에서 OpenAI Deep Research는 약 $1.80입니다. 이 값에 검색 API 비용이 포함되는지는 블로그에 나와 있지 않습니다. AstaBrief Fast 모드의 서빙 비용은 Ai2가 공개하지 않았습니다.
한계는 두 가지이고, 둘 다 Ai2가 직접 밝혔습니다. 첫째, 학습과 평가 대부분이 2025년에 끝나 비교 대상이 Claude 3.5·3.7, o3, GPT-4.1 같은 2025년 모델입니다. 둘째, 원문 주장의 범위와 강도를 보존하는지는 평가하지 못했습니다. 표본에서 얻은 결과를 모집단 전체의 주장처럼 일반화해도 지금 지표로는 걸러지지 않습니다. 인용이 정확한데 결론은 부풀려졌을 수 있다는 뜻입니다. 도입 전에는 자기 도메인 질의로 인용 정밀도·재현율과 주장 보존 여부를 직접 확인해야 합니다.
정리
AstaBrief 8B는 발췌 요약, 클러스터링, 섹션별 생성으로 나뉘던 작성 단계를 8B 모델 한 번 호출로 줄였습니다. 같은 검색 결과를 넣었을 때 51.1초로 약 3.5배 빨라졌고, 자체 테스트셋에서는 Claude 파이프라인과 비슷한 점수를 냈습니다. 그러나 DeepScholarBench 점수, 사람 평가 전체 선호, 사용자 만족도에서는 앞서지 못했습니다. 수치도 모두 Ai2가 2025년 모델과 비교해 직접 잰 값입니다. 검색과 재순위를 이미 운영하면서 작성 비용을 낮추려는 팀에 가장 잘 맞습니다. 도입을 검토한다면 검색부를 직접 붙여야 하고 정해진 프롬프트 형식을 지켜야 한다는 조건부터 따져보세요.
참고 자료
조사 기준일: 2026년 10월 03일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (모두 2026-10-03 확인)
– Ai2 블로그 “Open-sourcing AstaBrief”: https://allenai.org/blog/astabrief
– HF 모델카드: https://huggingface.co/allenai/AstaBrief_8B (원문 README: /raw/main/README.md)
– HF 컬렉션: https://huggingface.co/collections/allenai/astabrief
– Ai2 Scholar QA 논문: https://arxiv.org/html/2504.10861v1
– DR Tulu 블로그: https://allenai.org/blog/dr-tulu
– DR Tulu 모델카드: https://huggingface.co/rl-research/DR-Tulu-8B
– Unite.AI: https://www.unite.ai/ai2-open-sources-astabrief-8b-for-fast-scientific-report-generation/
– RuntimeWire: https://runtimewire.com/article/ai2-astabrief-open-science-report-model
– OrcaRouter: https://www.orcarouter.ai/blog/astabrief-8b-release
답글 남기기