
Claude Haiku 5.5는 100K 토큰 이하 입력 $0.10·출력 $0.50(2026년 10월 기준)이지만 경계를 넘으면 5배입니다. Sonnet 5.5와 역할 분담, effort 설정, 4.5에서 옮길 때 깨지는 코드, GPT-6 Luna 비교를 담았습니다.
클로드 하이쿠 핵심만 먼저 정리하면
Claude Haiku 5.5는 단독 주력 모델로 쓸 때보다 상위 모델이 계획하고 Haiku가 하위 작업을 맡는 구조에서 제값을 합니다. 2026년 10월 19일 기준 Claude Haiku 5.5의 API 단가는 프롬프트 100K 토큰 이하에서 1M 토큰당 입력 $0.10, 출력 $0.50으로, Haiku 4.5($1/$5)보다 90% 낮습니다. 다만 요청 하나의 입력이 100K를 넘으면 입력·출력 단가가 모두 5배로 오릅니다. 새 토크나이저는 같은 텍스트를 약 30% 더 많은 토큰으로 셉니다. 그래서 기존에 쓰던 프롬프트가 그대로 이 경계에 걸리기도 합니다.
성능 수치도 조건을 따져 봐야 합니다. 시스템카드의 헤드라인 점수는 전부 max effort 기준인데 API 기본값은 medium입니다. 이 기본 설정에서 첫 토큰이 나오기까지 Artificial Analysis 측정으로 11.21초가 걸립니다. 이 글은 가격 구조, Sonnet 5.5·Opus 5.5와 역할을 나누는 법, effort 설정, Haiku 4.5에서 옮길 때 깨지는 코드, GPT-6 Luna·Gemini Flash와 고르는 기준을 차례로 다룹니다. 한국어 개별 성능처럼 회사가 수치를 공개하지 않은 항목은 공개된 범위까지만 씁니다.
Q1. Claude Haiku 5.5 API 가격, 100K 토큰을 넘으면 왜 5배가 되나요?
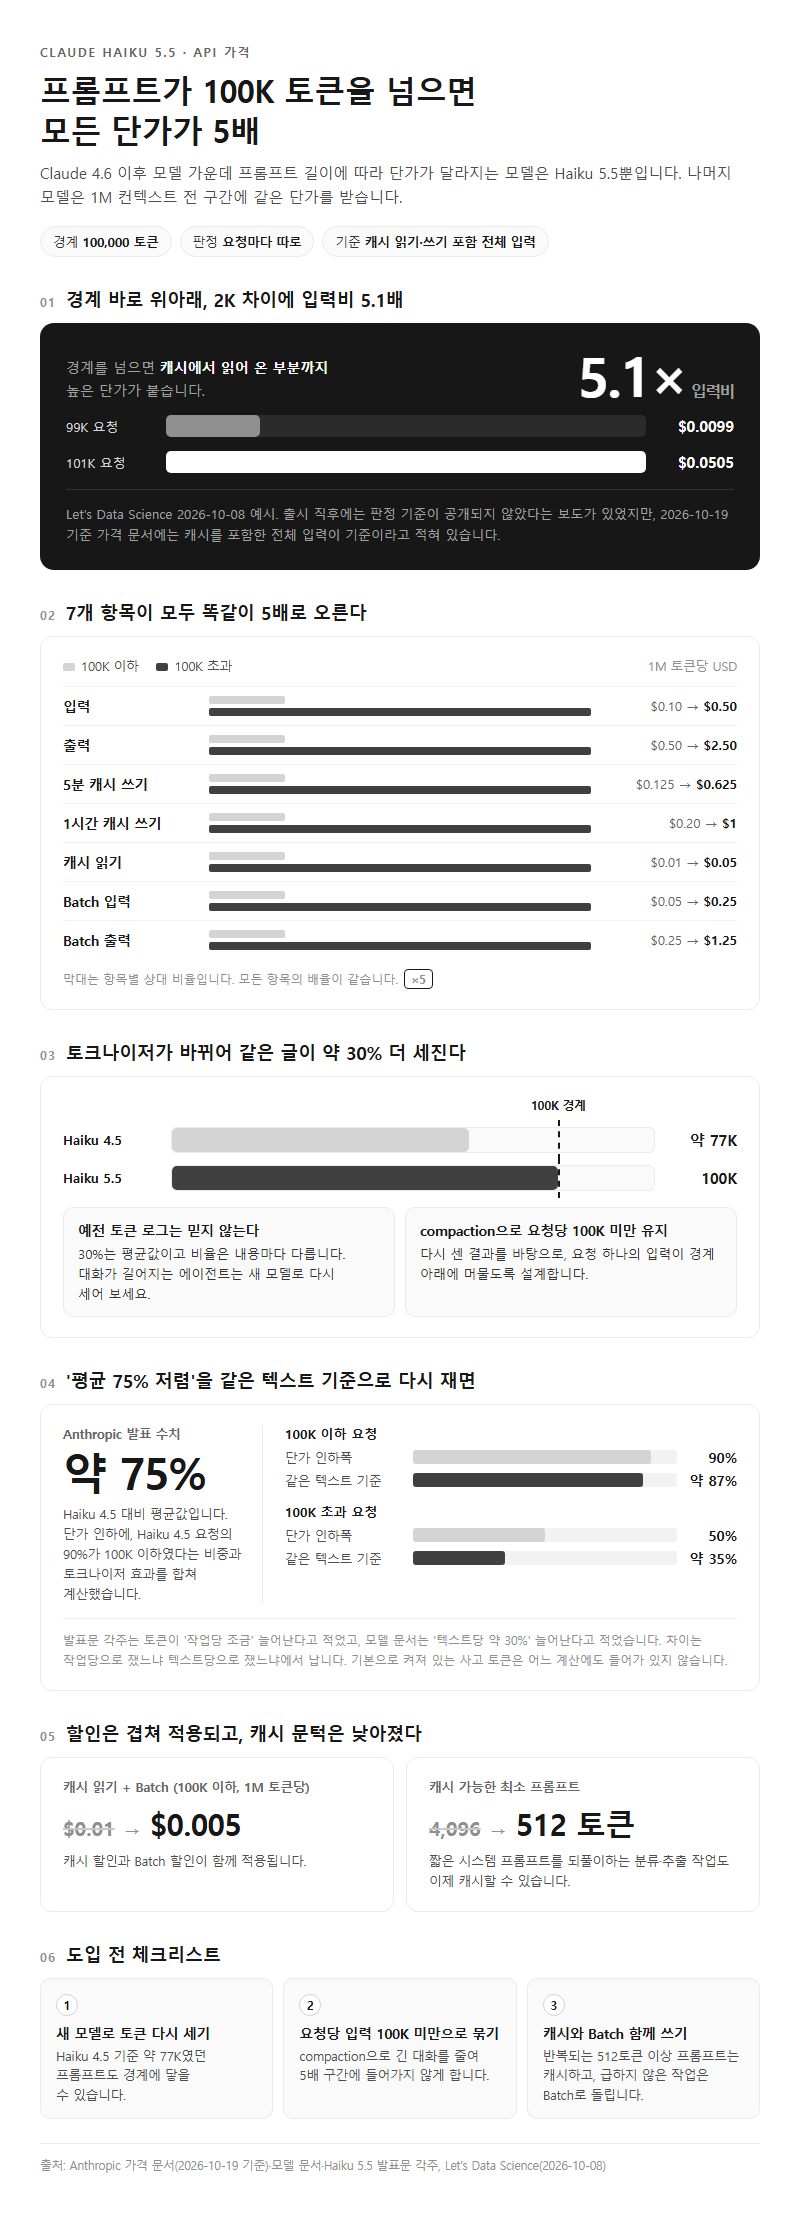
Claude 4.6 이후 모델 가운데 프롬프트 길이에 따라 단가가 달라지는 모델은 Haiku 5.5뿐입니다. 나머지는 1M 컨텍스트 전 구간에 같은 단가를 매깁니다. 경계는 100,000 토큰이고 요청마다 따로 판정하는데, 캐시 읽기·쓰기를 포함한 전체 입력 토큰이 기준입니다. 경계를 넘으면 캐시에서 읽어 온 부분까지 높은 단가가 붙습니다.
| 항목 (1M 토큰당) | 100K 이하 | 100K 초과 |
|---|---|---|
| 입력 | $0.10 | $0.50 |
| 출력 | $0.50 | $2.50 |
| 5분 캐시 쓰기 | $0.125 | $0.625 |
| 1시간 캐시 쓰기 | $0.20 | $1 |
| 캐시 읽기 | $0.01 | $0.05 |
| Batch 입력 | $0.05 | $0.25 |
| Batch 출력 | $0.25 | $1.25 |
경계 바로 위아래의 차이는 생각보다 큽니다. Let’s Data Science가 2026년 10월 8일 제시한 예시에서 99K 요청의 입력비는 $0.0099, 101K 요청은 $0.0505로 약 5.1배 차이가 납니다. 출시 직후 VentureBeat와 Let’s Data Science는 판정 기준이 공개되지 않았다고 보도했지만, 2026년 10월 19일 현재 가격 문서에는 캐시를 포함한 전체 입력이 기준이라고 명시돼 있습니다.
더 조심할 것은 토크나이저입니다. 모델 문서에 따르면 새 토크나이저는 같은 텍스트를 Haiku 4.5보다 약 30% 많은 토큰으로 세고, 이 비율은 내용에 따라 다릅니다. 30%를 그대로 적용하면 Haiku 4.5에서 약 77K였던 프롬프트가 100K에 닿습니다. 대화가 길어지는 에이전트라면 예전 토큰 로그를 믿지 말고 새 모델로 다시 세어 봐야 합니다. 그다음 compaction으로 요청당 입력을 100K 아래에 묶어 두도록 설계합니다.
Anthropic이 내세운 ‘Haiku 4.5보다 평균 약 75% 저렴’이라는 수치도 산식을 알고 봐야 합니다. 발표문 각주에 따르면 이 값은 세 가지를 합친 결과입니다. 100K 이하 요청은 단가를 90%, 초과 요청은 50% 내렸고, Haiku 4.5 요청의 90%가 100K 이하였으며, 여기에 토크나이저 효과를 반영했습니다. 같은 텍스트 기준으로 다시 계산하면 인하폭은 100K 이하 약 87%, 초과 약 35%로 줄어듭니다. 각주는 작업당 토큰이 조금 늘어난다고 적었고, 모델 문서는 텍스트당 약 30% 늘어난다고 적었습니다. 재는 기준이 작업당이냐 텍스트당이냐에서 갈린 차이입니다. 기본으로 켜져 있는 사고 토큰은 이 계산에서 빠져 있습니다.
할인은 겹칩니다. 캐시 할인이 Batch 할인과 함께 적용되므로, 100K 이하 요청을 Batch로 돌리면 캐시 읽기 단가가 1M 토큰당 $0.005까지 내려갑니다. 캐시할 수 있는 최소 프롬프트도 4,096토큰에서 512토큰으로 줄어, 짧은 시스템 프롬프트를 되풀이하는 분류·추출 작업도 캐시 대상에 들어갑니다.
용어 풀이
1. compaction — 길어진 대화 기록을 요약해 다음 요청의 입력 길이를 줄이는 처리로, 100K 경계를 지키는 주된 수단입니다.
2. Batch — 결과를 바로 받지 않는 대신 단가를 50% 깎아 주는 비동기 일괄 처리 방식입니다.
Q2. Haiku 5.5와 Sonnet 5.5·Opus 차이, 어떤 작업을 나눠 맡기나요?
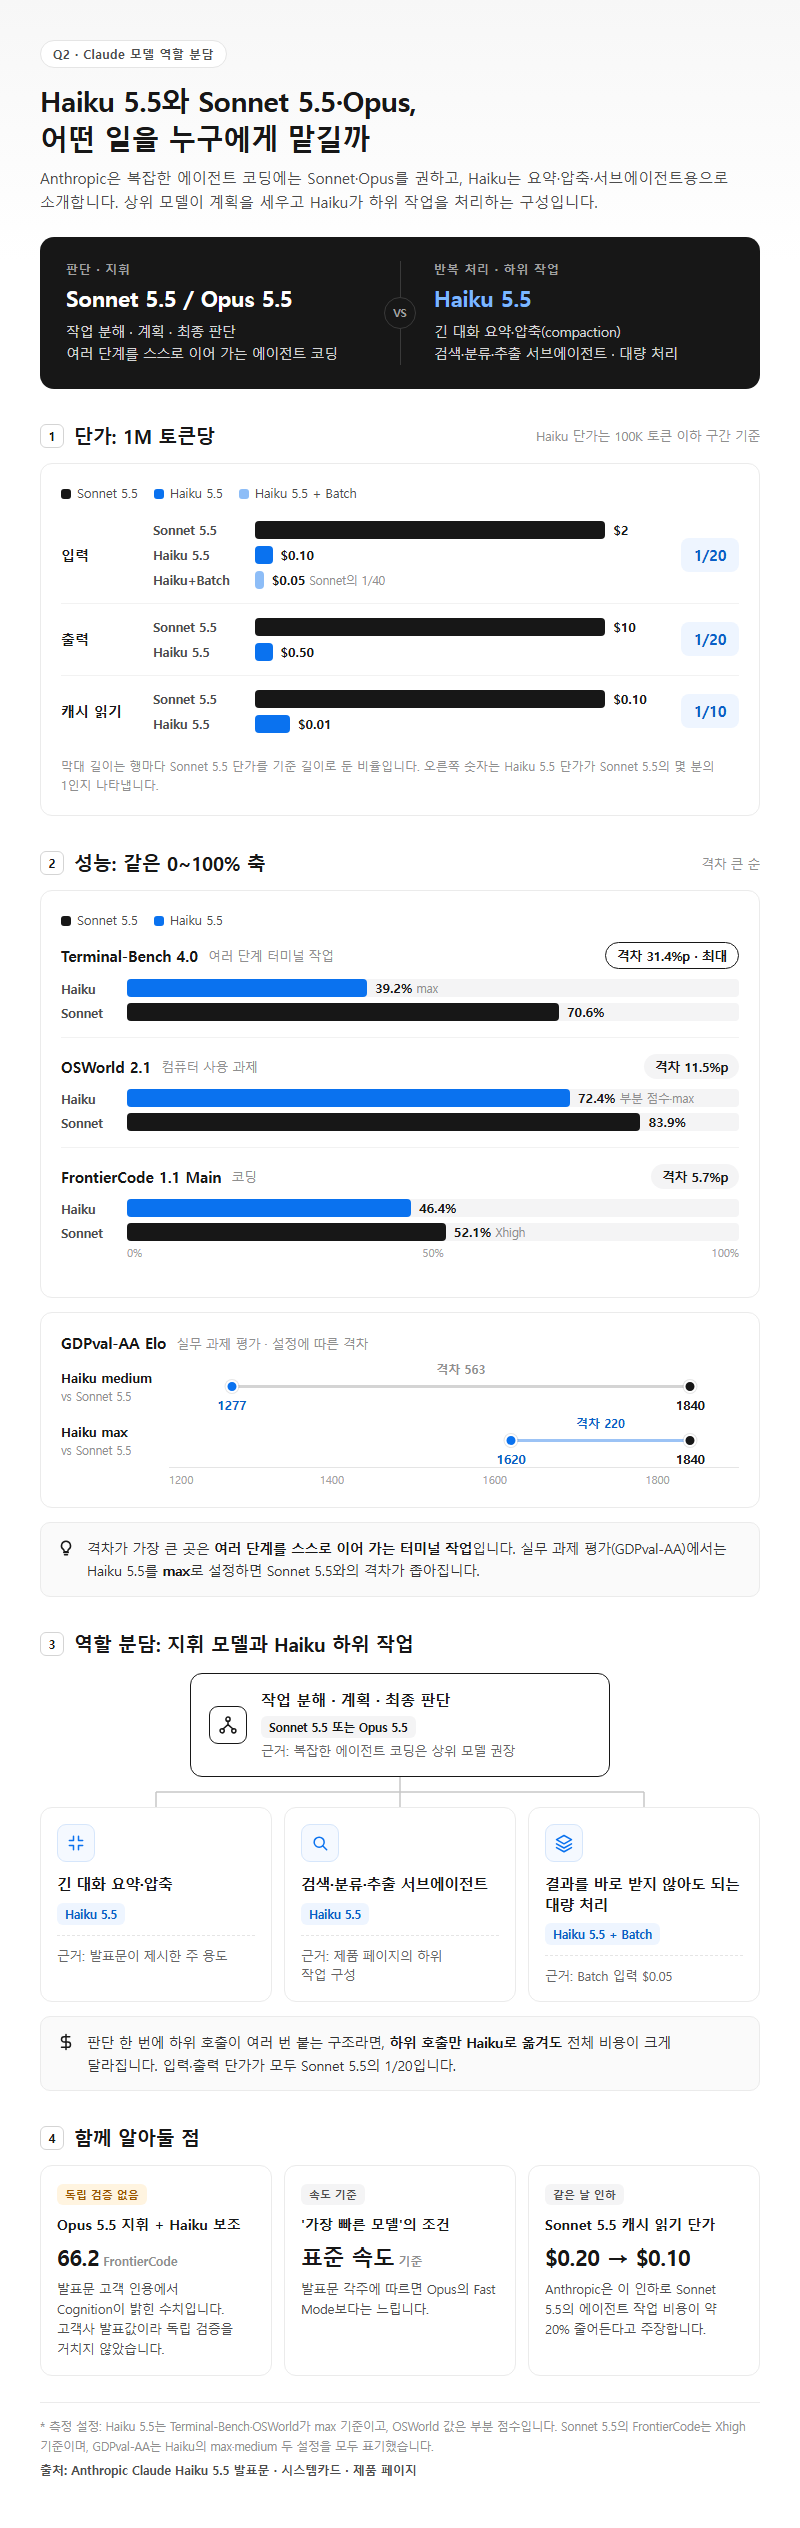
클로드 하이쿠와 소넷의 차이를 한 줄로 줄이면 Sonnet 5.5는 판단, Haiku 5.5는 반복 처리를 맡습니다. Anthropic도 복잡한 에이전트 코딩에는 Sonnet·Opus를 권하고, Haiku는 요약·압축(compaction)·서브에이전트용으로 소개했습니다. 제품 페이지에도 상위 모델이 계획을 세우고 Haiku가 하위 작업을 처리하는 구성이 나와 있습니다.
| 비교 항목 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|
| 입력 / 출력 (1M 토큰당) | $0.10 / $0.50 (100K 이하) | $2 / $10 |
| 캐시 읽기 | $0.01 | $0.10 |
| Terminal-Bench 4.0 | 39.2% (max) | 70.6% |
| OSWorld 2.1 | 72.4% (부분 점수, max) | 83.9% |
| GDPval-AA Elo | 1620 (max) / 1277 (medium) | 1840 |
| FrontierCode 1.1 Main | 46.4% | 52.1% (Xhigh) |
표의 수치는 발표문과 시스템카드에서 가져왔습니다. 차이가 가장 큰 항목은 여러 단계를 스스로 이어 가는 터미널 작업입니다. 실무 과제 평가인 GDPval-AA에서는 Haiku 5.5를 max로 설정하면 Sonnet 5.5와의 격차가 좁아집니다. 두 모델의 단가 차이가 크기 때문에, 판단 한 번에 하위 호출이 여러 번 붙는 구조라면 하위 호출만 Haiku로 옮겨도 전체 비용이 크게 달라집니다.
| 역할 | 맡길 모델 | 근거 |
|---|---|---|
| 작업 분해·계획·최종 판단 | Sonnet 5.5 또는 Opus 5.5 | 복잡한 에이전트 코딩은 상위 모델 권장 |
| 긴 대화 요약·압축 | Haiku 5.5 | 발표문이 제시한 주 용도 |
| 검색·분류·추출 서브에이전트 | Haiku 5.5 | 제품 페이지의 하위 작업 구성 |
| 결과를 바로 받지 않아도 되는 대량 처리 | Haiku 5.5 + Batch | Batch 입력 $0.05 |
클로드 하이쿠와 오푸스의 차이도 같은 틀로 보면 됩니다. Opus를 Haiku보다 좋은 대체재로 보기보다, Haiku를 부리는 지휘자로 두는 구성이 실제로 쓰이고 있습니다. Anthropic 발표문에 실린 고객 인용에서 Cognition은 Opus 5.5가 지휘하고 Haiku를 보조로 붙인 구성으로 FrontierCode 66.2를 기록했다고 밝혔습니다. 다만 이 값은 고객사가 발표한 수치로 독립 검증을 거치지 않았습니다. Anthropic이 Haiku 5.5를 자사에서 가장 빠른 모델로 소개한 것도 표준 속도 기준이며, 발표문 각주에는 Opus의 Fast Mode보다는 느리다고 적혀 있습니다.
지휘 모델 쪽 비용도 같은 날 바뀌었습니다. Sonnet 5.5의 캐시 읽기 단가가 $0.20에서 $0.10으로 내려갔고, Anthropic은 그 덕분에 Sonnet 5.5의 에이전트 작업 비용이 약 20% 줄어든다고 주장합니다. 긴 맥락을 캐시해 두고 계속 참조하는 지휘 모델과 짧은 하위 호출을 처리하는 Haiku 5.5를 함께 쓰면 양쪽 모두 캐시 단가 인하의 혜택을 봅니다.
Q3. 기본값 medium effort에서도 벤치마크 점수만큼 성능이 나오나요?
기본값 그대로 쓰면 발표된 점수보다 낮게 나옵니다. 시스템카드의 헤드라인 점수는 전부 max effort에서 5회 평균을 낸 값인데, API 기본값은 medium입니다. 시스템카드에 함께 실린 medium 수치로 보면 GDPval-AA는 1620에서 1277로 343점, AA-Briefcase는 1578에서 1372로 206점 떨어집니다. 발표문은 GDPval-AA 1620으로 GPT-6 Luna(1437)를 앞섰다고 했지만, medium 기준 1277은 Luna보다 낮습니다. Luna 점수가 어떤 effort 조건에서 나왔는지는 공개되지 않았습니다.
| effort | AA 지능 지수 | 과제당 비용 | 첫 토큰까지(TTFT) |
|---|---|---|---|
| max | 43 | $0.21 | 287.20초 |
| medium (기본) | 34 | $0.05 | 11.21초 |
| low | 29 | $0.02 | 7.75초 |
Artificial Analysis(2026년 10월 19일 확인) 기준 xhigh는 41, high는 38입니다. max를 고르면 medium보다 과제당 비용이 4.2배, 생성 토큰이 8.1배, TTFT가 25.6배 늘어납니다. 생성 토큰은 지수 평가 1회 기준 440M 대 54M이고, 전체 모델 중앙값은 96M입니다. 서브에이전트 기본값을 max로 두면 비용과 지연 모두 손해이니 작업마다 effort를 따로 지정하는 편이 맞습니다. 분류·추출처럼 답의 범위가 좁은 호출은 low부터, 요약 품질이 중요한 호출은 medium부터 시험해 보면 됩니다.
‘가장 빠른 모델’이라는 소개는 글자를 생성하는 속도를 가리킵니다. 출력 속도는 max 234 t/s, medium 183 t/s로 빠릅니다. 반면 기본 medium의 TTFT 11.21초는 같은 가격대 중앙값 1.71초의 6배가 넘습니다. 입력 1만 토큰짜리 기본 워크로드로 잰 값입니다. 제품 페이지는 실시간 상담·음성 에이전트에도 맞는다고 소개하지만, low로 내려도 TTFT는 7.75초입니다. high 이하에서는 사고를 끌 수 있는데, 이 상태는 Artificial Analysis도 Vals.ai도 측정하지 않았습니다. 실시간 용도라면 사고를 끈 설정에서 지연 시간을 직접 재 보고 판단해야 합니다.
공식 수치와 독립 측정이 엇갈리는 항목도 있습니다.
| 벤치마크 | 시스템카드·발표문 | Vals.ai 독립 측정 | 읽는 법 |
|---|---|---|---|
| Terminal-Bench 4.0 | 39.2% (max, 10회) | 36.36% ±2.31 | 오차 범위 근처로 대체로 일치 |
| Terminal-Bench-Science | 20.6% | 10.00% ±3.61 | 약 2배 차이, 원인은 밝혀지지 않음 |
| SWE-bench Multimodal | 30.7% | 43.96% ±2.27 | 독립 측정이 더 높음, 하네스 차이로 추정 |
OSWorld 2.1의 72.4%도 그대로 받아들이면 곤란합니다. 이 값은 부분 점수(partial credit)이고, 오프라인 subset 82개 과제에서 모든 체크포인트를 통과한 비율은 37.1%입니다. 컴퓨터 조작 에이전트를 Haiku 5.5 혼자 맡길 계획이라면 기대치를 72.4%가 아니라 37.1%에 맞추는 편이 현실적입니다. Vals Index 종합 점수는 54.44%±1.41로 49개 모델 가운데 18위였습니다(effort max 조건, 2026년 10월 8일 갱신).
용어 풀이
1. effort — 모델이 답하기 전에 얼마나 깊이 생각할지 정하는 설정으로, Haiku 계열에서는 5.5가 처음 지원하며 low·medium·high·xhigh·max 5단계입니다.
2. 적응형 사고(adaptive thinking) — 요청에 따라 생각할지, 얼마나 생각할지를 모델이 스스로 정하는 방식으로, Haiku 5.5에서는 기본으로 켜져 있습니다.
3. TTFT — 요청을 보낸 뒤 첫 토큰이 도착하기까지 걸리는 시간으로, 사용자가 느끼는 대기 시간을 좌우합니다.
Q4. 클로드 하이쿠 5.5 쓰는 법, Haiku 4.5 코드에서 무엇을 바꿔야 하나요?
클로드 하이쿠 5.5는 앱으로도, API로도 쓸 수 있습니다. Claude.ai 웹·iOS·Android에서는 Free·Pro·Max·Team·Enterprise 모든 요금제에서 이 모델을 고를 수 있고, Claude Code에서도 쓸 수 있습니다. API는 2026년 10월 7일 출시와 함께 Claude Platform·AWS·Google Cloud·Microsoft Azure에서 바로 열렸고, 프리뷰나 대기자 명단 단계를 거치지 않았습니다. 모델 ID는 claude-haiku-5-5입니다. 같은 날 Max 5x에는 월 $100, Max 20x에는 $200, Team에는 최대 $500의 API 크레딧을 준다는 발표도 나왔습니다.
| 항목 | Haiku 4.5 | Haiku 5.5 |
|---|---|---|
| 컨텍스트 | 200K | 1M |
| 최대 출력 | 64K | 128K (Batch 베타 헤더 사용 시 300K) |
| 최소 캐시 길이 | 4,096토큰 | 512토큰 |
| effort 설정 | 없음 | low부터 max까지 5단계, 기본 medium |
코드를 옮길 때 가장 먼저 걸리는 것은 400 오류로 바로 실패하는 파라미터입니다. Haiku 4.5용 코드에서 모델 ID만 바꿔 돌리면 아래 항목이 들어간 요청은 거부됩니다.
temperature·top_p·top_k같은 샘플링 파라미터는 지워야 합니다.- 응답 첫머리를 미리 채워 형식을 강제하던 assistant 프리필은 쓸 수 없습니다.
budget_tokens로 지정하던 수동 사고는 effort 설정으로 바꿔야 합니다.computer_20250124도구 버전으로 호출하면 실패합니다.
요청이 통과한 뒤에도 손볼 곳이 남습니다. 적응형 사고가 기본으로 켜져 있어 응답의 첫 블록이 thinking일 수 있습니다. content[0]을 텍스트로 가정하지 말고 블록의 type을 보고 골라내야 합니다. stop_reason이 refusal로 오는 경우에도 대비가 필요합니다. 서버 쪽에서 대신 처리해 주는 폴백이 없으므로, 재시도할지 상위 모델로 넘길지는 애플리케이션이 직접 정합니다.
거절 문제는 회귀 테스트로 미리 확인해 두는 것이 안전합니다. Haiku 5.5 시스템카드는 자동 행동 감사에서 테스트한 모델 중 과잉 거절이 가장 많았다고 직접 밝혔습니다. Vals.ai가 측정한 거부율은 0.22%(effort max 조건)로 낮았지만, 보안·의료처럼 허용 범위가 애매한 도메인이라면 기존 모델에서 문제없이 처리되던 샘플을 따로 돌려 보는 편이 좋습니다.
클라우드마다 지원 범위도 다릅니다. Bedrock에서는 structured outputs를 지원하지 않고, 브라우저 사용 도구는 Claude API와 Google Cloud에서만 쓸 수 있습니다. 지식 컷오프는 2026년 6월입니다. 서둘러 옮길 이유는 크지 않습니다. Haiku 4.5는 2026년 10월 19일 현재 Active 상태이고 폐기 공지도 없습니다. 모델 문서에는 Haiku 5.5를 2027년 10월 7일 이전에는 은퇴시키지 않는다고 적혀 있고, 2026년 10월 15일 릴리스 노트까지 Haiku 5.5의 가격·사양이 바뀐 적도 없습니다. 일부 트래픽부터 나눠 옮기며 비교할 시간은 충분합니다.
Q5. GPT-6 Luna·Gemini Flash가 Haiku 5.5보다 나은 경우는 언제인가요?
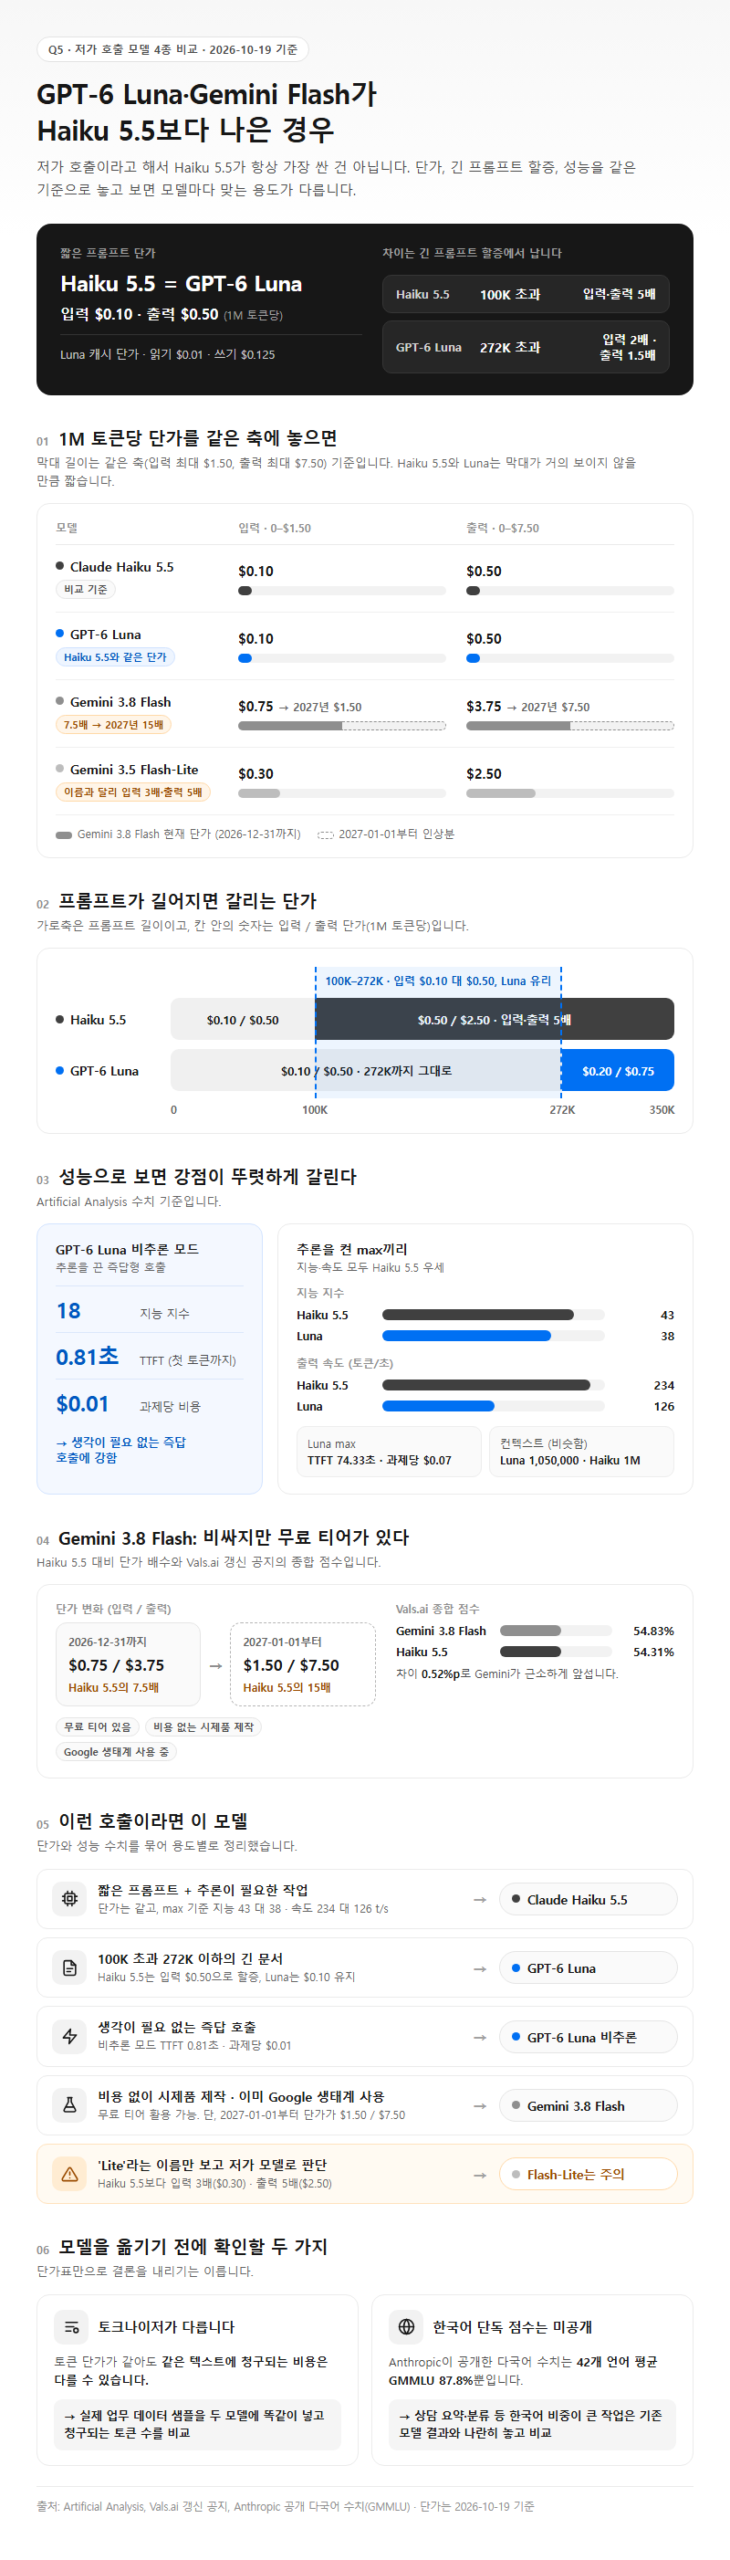
저가 호출이라고 해서 항상 Haiku 5.5가 가장 싼 것은 아닙니다. 2026년 10월 19일 기준 GPT-6 Luna는 입력 $0.10, 캐시 읽기 $0.01, 캐시 쓰기 $0.125, 출력 $0.50으로 짧은 프롬프트에서는 Haiku 5.5와 단가가 같습니다. 차이는 긴 프롬프트에 붙는 할증에서 갈립니다. Luna는 272K를 넘어야 입력 2배·출력 1.5배($0.20/$0.75)가 붙지만, Haiku 5.5는 100K만 넘어도 5배가 됩니다.
| 모델 | 입력 / 출력 (1M 토큰당) | 비고 |
|---|---|---|
| Claude Haiku 5.5 | $0.10 / $0.50 | 100K 초과 시 $0.50 / $2.50 |
| GPT-6 Luna | $0.10 / $0.50 | 272K 초과 시 $0.20 / $0.75 |
| Gemini 3.8 Flash | $0.75 / $3.75 (2026-12-31까지) | 2027-01-01부터 $1.50 / $7.50, 무료 티어 있음 |
| Gemini 3.5 Flash-Lite | $0.30 / $2.50 | 이름과 달리 Haiku 5.5보다 입력 3배, 출력 5배 비쌈 |
100K 초과 272K 이하의 긴 문서라면 입력 단가는 Luna가 유리합니다. Artificial Analysis 수치로 보면 두 모델의 강점이 더 뚜렷하게 갈립니다. Luna의 비추론 모드는 지능 지수 18, TTFT 0.81초, 과제당 $0.01로 생각이 필요 없는 즉답 호출에 강합니다. 추론을 켠 max끼리 비교하면 Haiku 5.5가 지능 지수 43 대 38, 출력 속도 234 대 126 t/s로 앞섭니다. Luna max의 TTFT는 74.33초, 과제당 비용은 $0.07입니다. 컨텍스트는 Luna가 1,050,000토큰, Haiku 5.5가 1M으로 비슷합니다.
단가표만으로 결론을 내리기는 이릅니다. 두 회사는 토크나이저가 달라 토큰 단가가 같아도 텍스트당 비용은 다를 수 있습니다. 실제 업무 데이터 샘플을 두 모델에 똑같이 넣고 청구되는 토큰 수를 비교하는 것이 가장 정확합니다.
Gemini 3.8 Flash는 2026년 12월 31일까지 $0.75/$3.75이고, 2027년 1월 1일부터 $1.50/$7.50입니다. Haiku 5.5 단가의 7.5배이고, 2027년부터는 15배로 벌어집니다. Vals.ai 갱신 공지의 종합 점수는 Gemini 3.8 Flash 54.83%, Haiku 5.5 54.31%로 Gemini가 근소하게 앞섰습니다. 무료 티어가 있으니 비용 없이 시제품을 만들 때나 이미 Google 생태계를 쓰고 있을 때 고를 만합니다.
한국어 서비스라면 확인할 것이 하나 더 있습니다. Anthropic이 공개한 다국어 수치는 42개 언어 평균인 GMMLU 87.8%뿐이고, 한국어만 따로 잰 점수는 공개되지 않았습니다. 상담 요약이나 분류처럼 한국어 비중이 큰 하위 작업을 Haiku 5.5로 옮긴다면, 기존 모델의 결과와 나란히 놓고 비교하는 검수 단계를 두는 편이 안전합니다.
정리
Claude Haiku 5.5의 100K 이하 입력 $0.10, 출력 $0.50(2026년 10월 19일 기준)이라는 단가는 상위 모델이 계획하고 Haiku가 요약·압축·서브에이전트를 맡는 구조에서 제대로 살아납니다. 도입 전에 먼저 처리할 일은 세 가지입니다. 새 토크나이저로 프롬프트를 다시 세어 요청당 입력을 100K 아래로 묶고, 작업마다 effort를 지정하고, 샘플링 파라미터·프리필·budget_tokens를 코드에서 걷어냅니다. 100K를 넘는 긴 문서나 즉답이 필요한 비추론 호출에는 GPT-6 Luna가, 여러 단계를 스스로 이어 가는 에이전트 코딩에는 Sonnet 5.5가 더 잘 맞습니다.
참고 자료
조사 기준일: 2026년 10월 19일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (모두 2026-10-19 원문 대조)
- Anthropic, Introducing Claude Haiku 5.5: https://www.anthropic.com/news/claude-haiku-5-5
- Anthropic, Claude Haiku 제품 페이지: https://www.anthropic.com/claude/haiku
- Claude Haiku 5.5 System Card (PDF, 144쪽): https://www-cdn.anthropic.com/e1080d6bf5ae2018ea3c2f414064be03232f5be5/Claude%20Haiku%205.5%20System%20Card.pdf
- Claude 가격 문서: https://platform.claude.com/docs/en/about-claude/pricing
- Haiku 5.5 모델 문서: https://platform.claude.com/docs/en/models/haiku-5-5/overview
- What’s new in Claude Haiku 5.5: https://platform.claude.com/docs/en/models/haiku-5-5/whats-new-haiku-5-5
- Models overview: https://platform.claude.com/docs/en/models/overview
- 릴리스 노트: https://platform.claude.com/docs/en/release-notes/overview
- Model deprecations: https://platform.claude.com/docs/en/about-claude/model-deprecations
- OpenAI API 가격: https://developers.openai.com/api/docs/pricing
- OpenAI GPT-6 Luna 모델 문서: https://developers.openai.com/api/docs/models/gpt-6-luna
- Google Gemini API 가격: https://ai.google.dev/gemini-api/docs/pricing
- Artificial Analysis, Haiku 5.5 (Max): https://artificialanalysis.ai/models/claude-haiku-5-5
- Artificial Analysis, Haiku 5.5 (Medium): https://artificialanalysis.ai/models/claude-haiku-5-5-medium
- Artificial Analysis, Haiku 5.5 릴리스 비교: https://artificialanalysis.ai/models/releases/claude-haiku-5-5
- Artificial Analysis, Haiku 5.5 vs GPT-6 Luna: https://artificialanalysis.ai/models/releases/comparisons/claude-haiku-5-5-vs-gpt-6-luna
- Artificial Analysis, GPT-6 Luna: https://artificialanalysis.ai/models/gpt-6-luna
- Artificial Analysis, GPT-6 Luna (Non-reasoning): https://artificialanalysis.ai/models/gpt-6-luna-non-reasoning
- Vals.ai, Claude Haiku 5.5: https://www.vals.ai/models/anthropic_claude-haiku-5-5
답글 남기기