
Gemini 3.8 Flash TTS와 Flash-Lite TTS로 한국어 음성을 합성하는 방법을 정리했습니다. 언어 자동 감지 구조, 연출 태그, 출력 형식, 2026년과 2027년 가격, 음성 복제 조건을 공식 문서 기준으로 비교합니다.
Gemini3.8TTS 시작 전 확인할 것
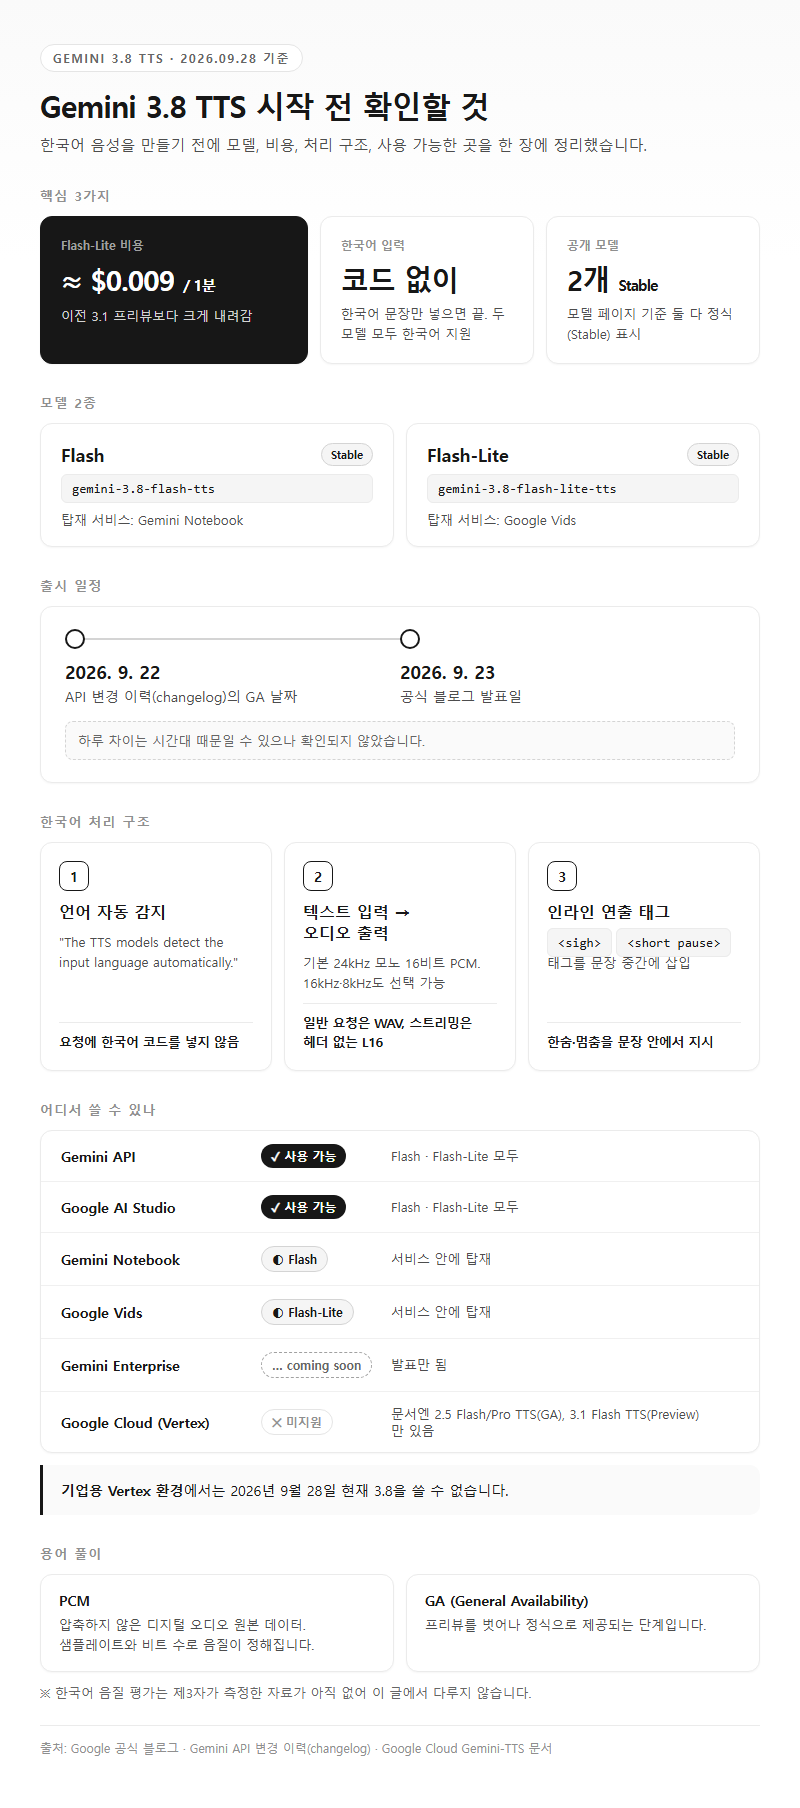
Gemini 3.8 Flash TTS로 한국어 음성을 만들 때는 언어 코드 없이 한국어 문장만 넣으면 됩니다. Gemini 3.8 TTS 계열 두 모델 모두 지원 언어 표에 한국어가 체크돼 있습니다. 비용은 2026년 9월 28일 기준 Flash-Lite가 1분에 약 $0.009로, 이전 3.1 프리뷰보다 크게 내려갔습니다. 이 글은 Gemini API와 Google AI Studio에서 한국어 음성을 만드는 절차, 한국어 처리 구조, 비용, 제약을 다룹니다. 한국어 음질 평가는 뺐습니다. 제3자가 측정한 자료가 아직 없어서입니다.
공개된 모델은 두 개입니다. gemini-3.8-flash-tts(Flash)와 gemini-3.8-flash-lite-tts(Flash-Lite)이며, 모델 페이지에는 둘 다 Stable로 표시돼 있습니다. 공식 블로그 발표일은 2026년 9월 23일인데, API 변경 이력(changelog)에는 GA가 9월 22일로 적혀 있습니다. 하루 차이는 시간대 때문일 수 있지만 확인하지 못했습니다.
한국어 처리 구조는 세 가지입니다.
| 구조 | 내용 | 실무 의미 |
|---|---|---|
| ① 언어 자동 감지 | 문서 원문: “The TTS models detect the input language automatically.” | 요청에 한국어 코드를 넣지 않음 |
| ② 텍스트 입력, 오디오 출력 | 기본 24kHz 모노 16비트 PCM, 16kHz·8kHz 선택 가능 | 일반 요청은 WAV, 스트리밍은 헤더 없는 L16 |
| ③ 인라인 연출 태그 | <sigh>, <short pause> 같은 태그를 문장 중간에 삽입 |
한숨이나 멈춤을 문장 안에서 지시 |
쓸 수 있는 곳부터 확인해야 합니다. 지금은 Gemini API와 Google AI Studio에서 쓸 수 있고, Gemini Notebook에는 Flash가, Google Vids에는 Flash-Lite가 들어가 있습니다. Gemini Enterprise는 “coming soon”으로 발표만 됐습니다. Google Cloud의 Gemini-TTS 문서에는 2026년 9월 28일 현재 3.8 모델이 없고, 2.5 Flash/Pro TTS(GA)와 3.1 Flash TTS(Preview)만 있습니다. 기업용 Vertex 환경에서는 아직 3.8을 쓸 수 없다는 뜻입니다.
용어 풀이
1. PCM — 압축하지 않은 디지털 오디오 원본 데이터로, 샘플레이트와 비트 수로 음질이 정해집니다.
2.
3. GA(General Availability) — 프리뷰를 벗어나 정식으로 제공되는 단계를 말합니다.
준비물·필요 서류
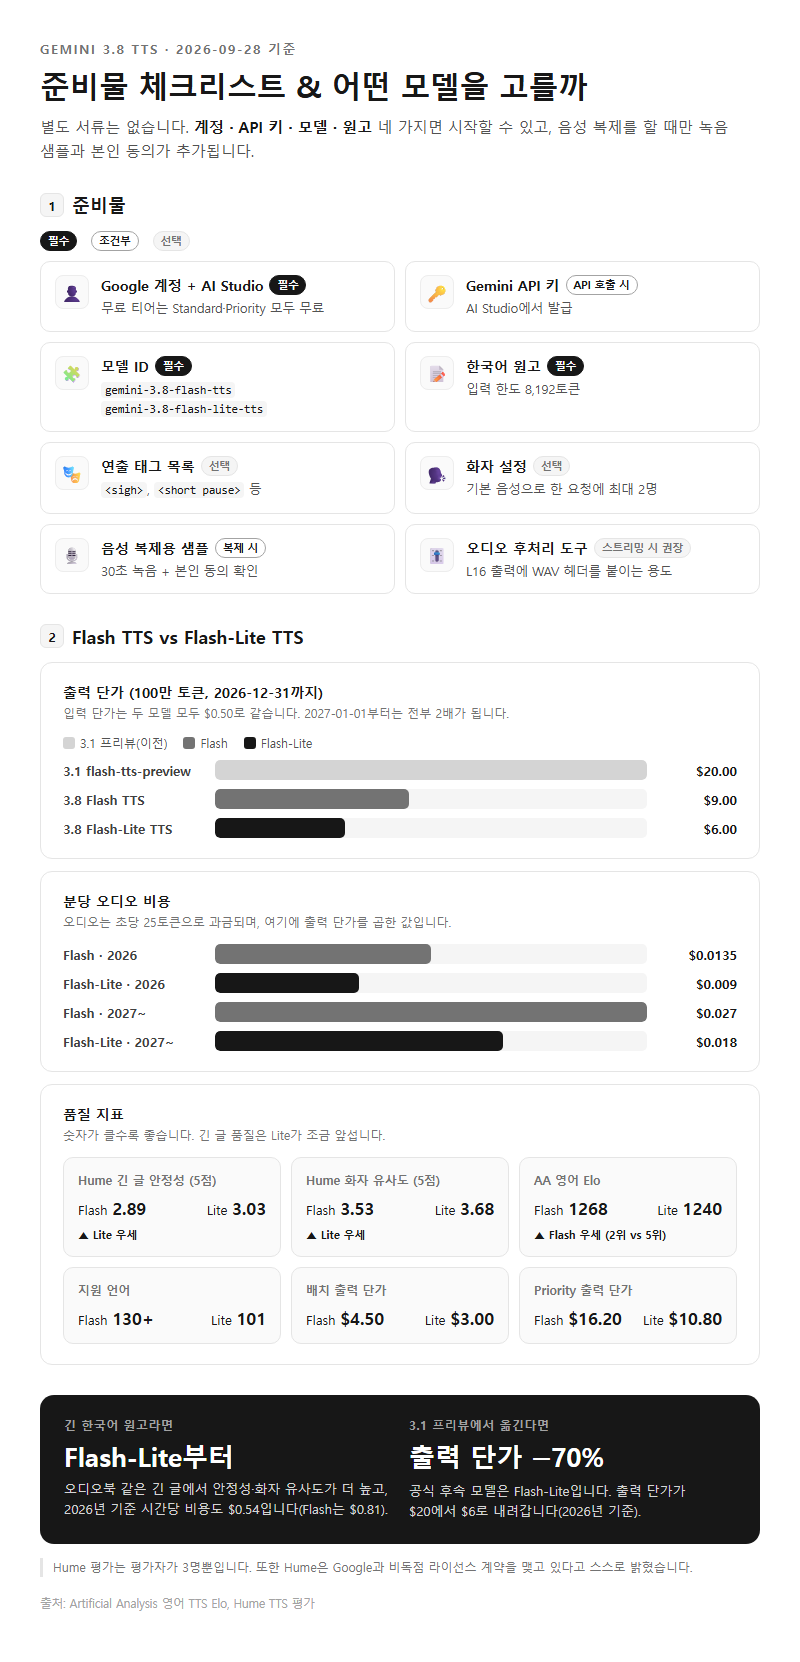
별도 서류는 없습니다. 계정, API 키, 모델 선택, 원고 텍스트면 되고, 음성 복제를 할 때만 녹음 샘플과 본인 동의 절차가 추가됩니다.
| 준비물 | 필수 여부 | 세부 조건(2026-09-28 기준) |
|---|---|---|
| Google 계정 + AI Studio 접근 | 필수 | 무료 티어는 Standard·Priority 모두 무료 |
| Gemini API 키 | API 호출 시 필수 | AI Studio에서 발급 |
| 모델 ID | 필수 | gemini-3.8-flash-tts 또는 gemini-3.8-flash-lite-tts |
| 한국어 원고 | 필수 | 입력 한도 8,192토큰 |
| 연출 태그 목록 | 선택 | <sigh>, <short pause> 등 |
| 화자 설정 | 선택 | 기본 음성으로 한 요청에 최대 2명 |
| 음성 복제용 샘플 | 복제 시 필수 | 30초 녹음 + 본인 동의 확인 |
| 오디오 후처리 도구 | 스트리밍 시 권장 | L16에 WAV 헤더를 붙이는 용도 |
두 모델을 비교하면 아래와 같습니다.
| 항목 | Flash TTS | Flash-Lite TTS |
|---|---|---|
| 지원 언어 | 130개 이상 | 101개 |
| 입력/출력 단가(100만 토큰, ~2026-12-31) | $0.50 / $9.00 | $0.50 / $6.00 |
| 입력/출력 단가(2027-01-01~) | $1.00 / $18.00 | $1.00 / $12.00 |
| 분당 비용(2026 / 2027) | $0.0135 / $0.027 | $0.009 / $0.018 |
| 시간당 비용(2026) | $0.81 | $0.54 |
| 배치 출력 단가(~2026-12-31) | $4.50 | $3.00 |
| Priority 출력 단가(~2026-12-31) | $16.20 | $10.80 |
| AA 영어 Elo | 1268(2위) | 1240(5위) |
| Hume 긴 글 안정성(5점) | 2.89 | 3.03 |
| Hume 화자 유사도(5점) | 3.53 | 3.68 |
오디오는 초당 25토큰으로 과금됩니다. 분당 비용은 이 단위에 출력 단가를 곱해 계산했습니다. Hume 평가에서는 긴 글 안정성과 화자 유사도 모두 오히려 Lite가 조금 높습니다. 오디오북처럼 긴 한국어 원고라면 Lite부터 들어보는 게 합리적입니다. 다만 Hume 평가의 평가자는 3명뿐이고, Hume은 Google과 비독점 라이선스 계약을 맺고 있다고 스스로 밝혔습니다.
기존에 gemini-3.1-flash-tts-preview를 쓰고 있었다면 공식 후속 모델은 Flash-Lite입니다. 3.1 프리뷰의 출력 단가가 $20이라, Lite로 옮기면 2026년 기준 출력 단가가 70% 내려갑니다.
단계별 진행 순서
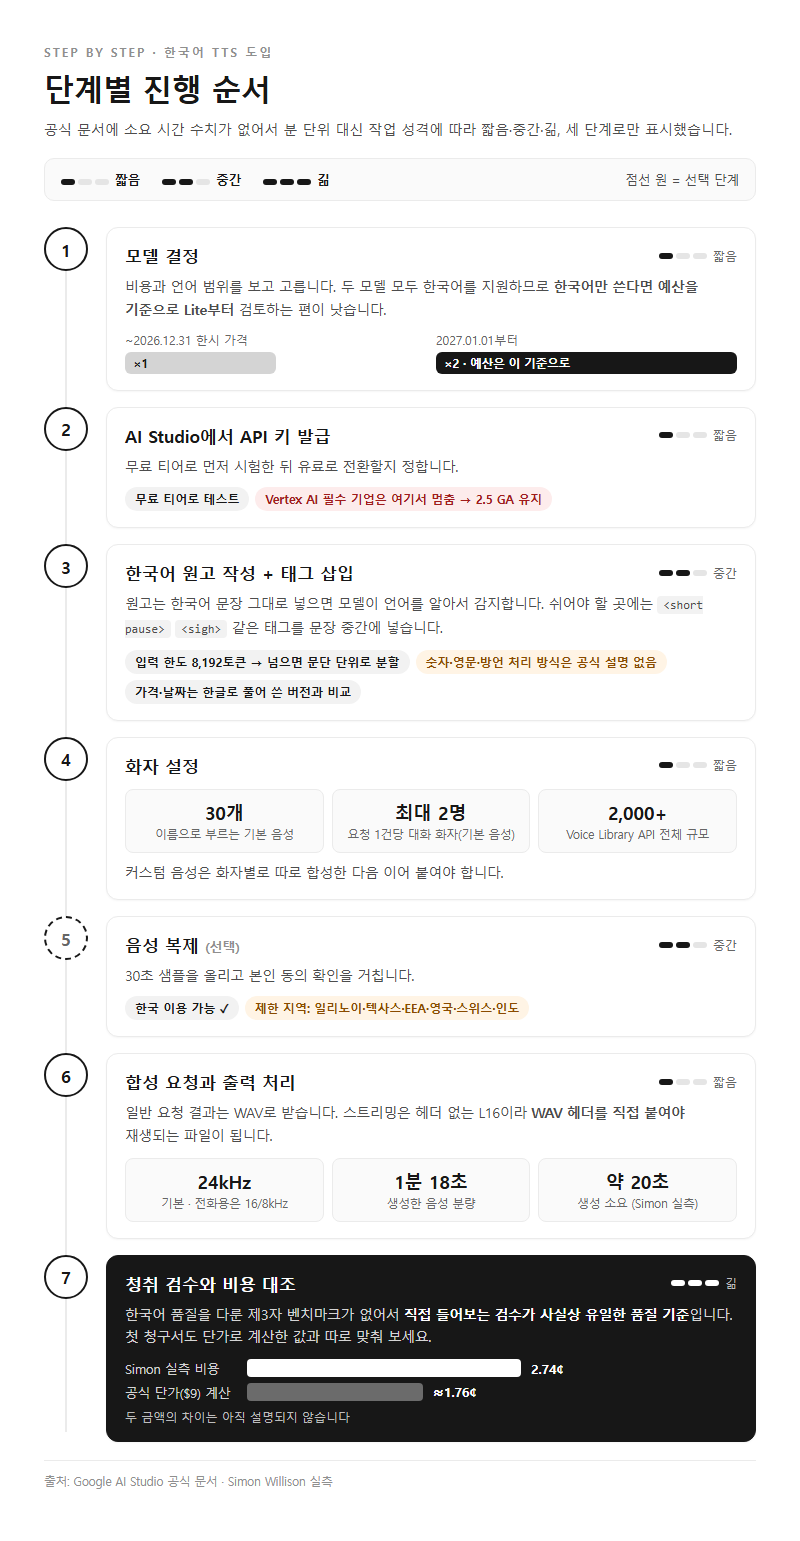
소요 시간은 작업 성격에 따라 짧음·중간·긺으로 표시했습니다. 공식 문서에 소요 시간 수치가 없어 분 단위로는 적지 않았습니다.
1단계: 모델 결정 (소요: 짧음)
기준은 비용과 언어 범위입니다. 한국어만 다룬다면 두 모델 모두 지원하니 예산 기준으로 Lite를 먼저 고르는 편이 낫습니다. 현재 가격은 2026년 12월 31일까지만 적용되는 한시 가격이라는 점에 주의하세요. 2027년 1월 1일부터는 두 모델 모두 두 배가 되므로, 예산은 처음부터 두 배 가격으로 잡아두어야 안전합니다.
2단계: AI Studio에서 API 키 발급 (소요: 짧음)
AI Studio에 로그인해 키를 만듭니다. 무료 티어로 먼저 시험해보고 유료 전환 여부를 정하면 됩니다. 기업 계약 때문에 Vertex AI를 써야 한다면 여기서 멈춰야 합니다. Cloud 문서에 3.8이 올라올 때까지는 2.5 GA 모델을 유지해야 합니다.
3단계: 한국어 원고 작성과 태그 삽입 (소요: 중간)
원고는 한국어 문장 그대로 넣습니다. 언어는 모델이 알아서 감지합니다. 멈춤이나 한숨이 필요한 자리에는 <short pause>, <sigh> 같은 태그를 문장 중간에 끼워 넣습니다. 입력 8,192토큰 한도를 넘으면 문단 단위로 나눠 요청합니다. 숫자·영문이 섞인 문장을 어떻게 읽는지, 방언은 어떻게 처리하는지 공식 설명이 없어 직접 확인해야 합니다. 가격이나 날짜처럼 읽는 방식이 갈릴 만한 숫자는 미리 한글로 풀어 써서 두 결과를 비교해보면 됩니다.
4단계: 화자 설정 (소요: 짧음)
이름으로 바로 부를 수 있는 기본 음성은 30개이고, 한 요청에서 기본 음성 기준 최대 2명까지 대화를 연출할 수 있습니다. 발표에서 말한 “2,000+ voices”는 Voice Library API로 조회하는 라이브러리 규모입니다. 커스텀 음성은 화자별로 따로 합성해 이어 붙여야 합니다.
5단계: 음성 복제(선택) (소요: 중간)
30초 샘플을 올리고 본인 동의 확인을 거칩니다. 한국은 AI Studio 음성 복제 제한 지역(일리노이, 텍사스, EEA, 영국, 스위스, 인도)에 들어 있지 않습니다.
6단계: 합성 요청과 출력 처리 (소요: 짧음)
일반 요청은 WAV로 받습니다. 스트리밍은 헤더 없는 L16이라 WAV 헤더를 직접 붙여야 재생 파일이 됩니다. 기본값은 24kHz이고, 전화 음성처럼 대역이 좁은 용도라면 16kHz나 8kHz로 낮춥니다. 속도는 Simon Willison의 실측이 참고가 됩니다. 1분 18초 분량을 약 20초 만에 생성했습니다.
7단계: 청취 검수와 비용 대조 (소요: 긺)
한국어 품질은 제3자 벤치마크가 없어서 직접 들어보는 검수가 사실상 유일한 품질 기준입니다. 청구 금액도 확인하세요. Simon의 실측 비용은 2.74센트였는데, 공식 단가($9 기준)로 계산하면 약 1.76센트라 차이가 설명되지 않습니다. 첫 청구서는 단가 계산값과 따로 대조해보는 게 좋습니다.
자주 놓치는 부분
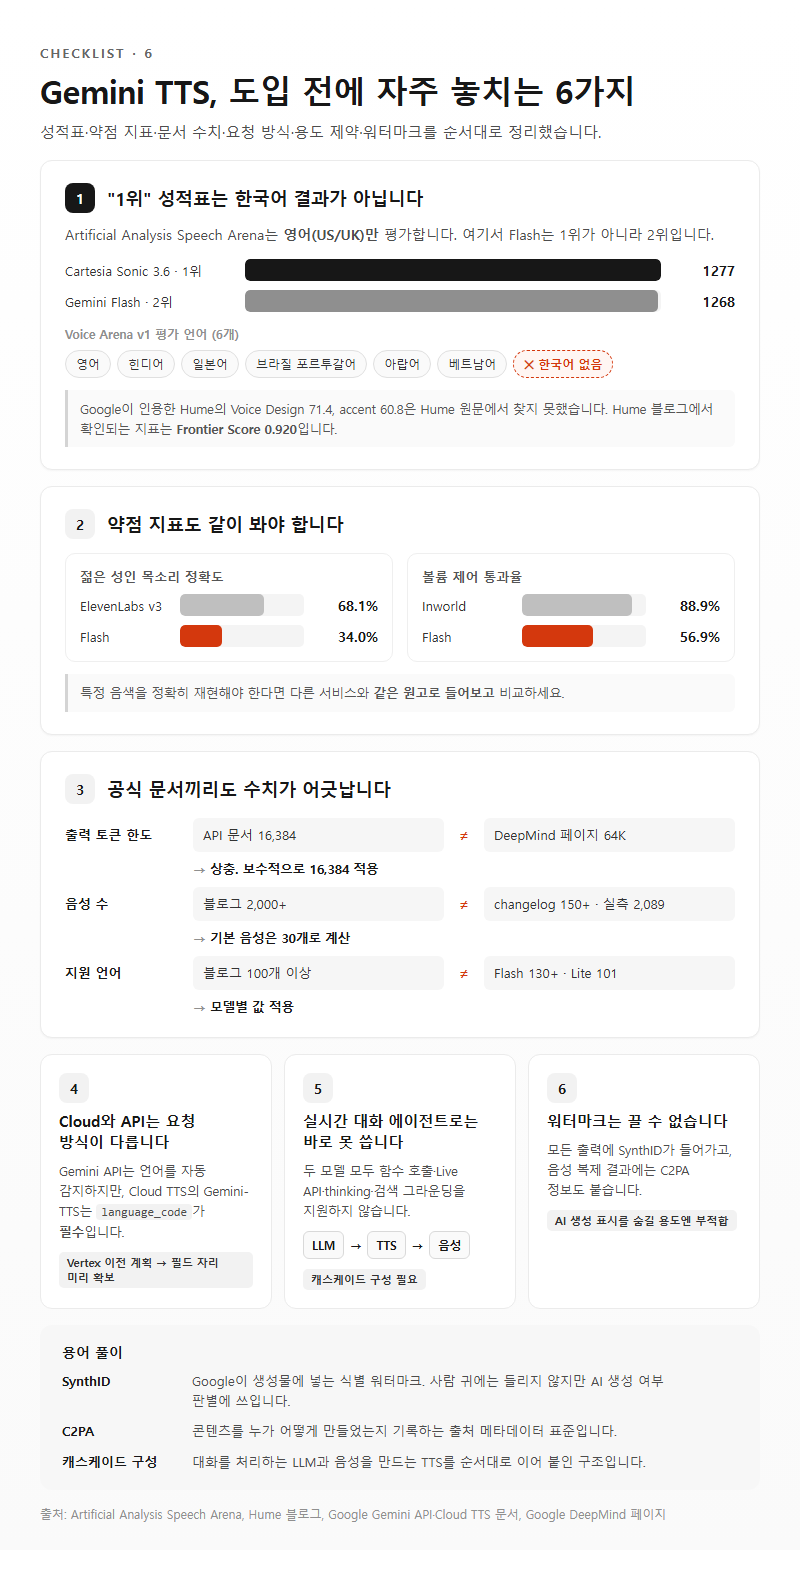
첫째, “1위” 성적표는 한국어 결과가 아닙니다. Artificial Analysis Speech Arena는 영어(US/UK)만 평가합니다. 여기서 Flash는 1268점으로 2위이고, 1위는 Cartesia Sonic 3.6(1277)입니다. Voice Arena v1이 다루는 언어는 영어·힌디어·일본어·브라질 포르투갈어·아랍어·베트남어 6개뿐이고 한국어는 없습니다. Google이 인용한 Hume의 Voice Design 71.4, accent 60.8은 Hume 원문에서 찾지 못했습니다. Hume 블로그에서 확인되는 지표는 Frontier Score 0.920입니다.
둘째, 약점 지표도 같이 봐야 합니다. 같은 Hume 평가에서 젊은 성인 목소리 정확도는 Flash가 34.0%로 ElevenLabs v3(68.1%)의 절반 수준이었습니다. 볼륨 제어 통과율도 56.9%로 Inworld(88.9%)보다 낮았습니다. 특정 음색을 정확히 재현해야 한다면 다른 서비스와 같은 원고로 들어보고 비교하세요.
셋째, 공식 문서끼리도 수치가 어긋납니다.
| 항목 | 값 A | 값 B | 판단 |
|---|---|---|---|
| 출력 토큰 한도 | API 문서 16,384 | DeepMind 페이지 64K | 상충, 보수적으로 16,384 적용 |
| 음성 수 | 블로그 2,000+ | changelog 150+, 실측 2,089 | 기본 음성은 30개로 계산 |
| 지원 언어 | 블로그 100개 이상 | Flash 130+, Lite 101 | 모델별 값 적용 |
넷째, Cloud와 API는 요청 방식이 다릅니다. Gemini API는 언어를 자동으로 감지하지만, Cloud TTS의 Gemini-TTS는 language_code를 반드시 넣어야 합니다. 나중에 Vertex로 옮길 계획이라면 이 필드를 넣을 자리를 미리 비워두세요.
다섯째, 실시간 대화 에이전트로는 바로 못 씁니다. 두 모델 모두 함수 호출, Live API, thinking, 검색 그라운딩을 지원하지 않습니다. 음성 비서를 만들려면 별도 LLM 뒤에 TTS를 붙이는 캐스케이드 구성이 필요합니다.
여섯째, 워터마크는 끌 수 없습니다. 모든 출력에 SynthID가 들어가고, 음성 복제 결과에는 C2PA 정보도 붙습니다. AI 생성 표시를 숨겨야 하는 용도라면 맞지 않습니다.
용어 풀이
1. SynthID — Google이 생성물에 넣는 식별 워터마크로, 사람 귀에는 들리지 않지만 AI 생성 여부를 판별하는 데 쓰입니다.
2. C2PA — 콘텐츠를 누가 어떻게 만들었는지 기록하는 출처 메타데이터 표준입니다.
3. 캐스케이드 구성 — 대화를 처리하는 LLM과 음성을 만드는 TTS를 순서대로 이어 붙인 구조입니다.
체크리스트 정리
- [ ] 모델 ID 확정:
gemini-3.8-flash-lite-tts(비용 우선) 또는gemini-3.8-flash-tts(130개 이상 언어) - [ ] 예산을 2027년 가격으로 산정: Lite 기준 분당 $0.018, Flash 기준 분당 $0.027
- [ ] 원고 분할: 요청 하나당 입력 8,192토큰 이하, 출력은 16,384토큰 기준으로 설계
- [ ] 화자 구성 확인: 기본 음성은 한 요청에 최대 2명, 커스텀 음성은 화자별로 따로 합성
- [ ] 음성 복제 조건 확인: 30초 샘플, 본인 동의, 저장 음성 1년·무상태 키 7일 TTL
- [ ] 출력 형식 처리: 스트리밍 L16에 WAV 헤더 추가, 용도에 맞게 샘플레이트 선택
- [ ] 한국어 청취 검수: 숫자·영문 혼용 문장을 포함해 직접 듣고 확인(제3자 한국어 벤치마크 없음)
2026년 9월 28일 기준으로 한국어 음성을 싸고 빠르게 만들고 싶다면 Gemini 3.8 Flash-Lite TTS가 가장 무난한 출발점입니다. 다만 한국어 음질은 아직 누구도 수치로 증명하지 않았습니다. 도입 여부는 같은 원고로 직접 들어보고 정하는 게 가장 확실합니다.
참고 자료
조사 기준일: 2026년 09월 28일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (모두 2026-09-28 확인)
– https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-text-to-speech/
– https://ai.google.dev/gemini-api/docs/models/gemini-3.8-flash-tts
– https://ai.google.dev/gemini-api/docs/models/gemini-3.8-flash-lite-tts
– https://ai.google.dev/gemini-api/docs/speech-generation
– https://ai.google.dev/gemini-api/docs/pricing
– https://ai.google.dev/gemini-api/docs/changelog
– https://docs.cloud.google.com/text-to-speech/docs/gemini-tts
– https://deepmind.google/models/gemini-audio/speech-generation/
– https://elevenlabs.io/pricing/api
Tier 2 (모두 2026-09-28 확인)
– https://artificialanalysis.ai/text-to-speech/leaderboard
– https://www.hume.ai/blog/newly-released-google-s-gemini-3-8-flash-tts-tops-hume-s-real-world-voiceeq-leaderboard
– https://voicearena.com/tts-methodology
– https://simonwillison.net/2026/Sep/23/gemini-tts-playground/
– https://siliconangle.com/2026/09/23/google-launches-two-benchmark-topping-speech-generation-models/
– https://www.digitalapplied.com/blog/gemini-3-8-flash-tts-voice-cloning-price-doubles-january (가격 교차 확인용)
답글 남기기