
로컬 LLM·이미지 생성용 그래픽카드는 TOPS보다 VRAM과 메모리 대역폭으로 고릅니다. RTX 5090·PRO 5000·PRO 6000·DGX Spark를 실측 수치로 비교해 VRAM 구간별 선택 기준을 정리했습니다.
그래픽카드 추천 시작 전 확인할 것
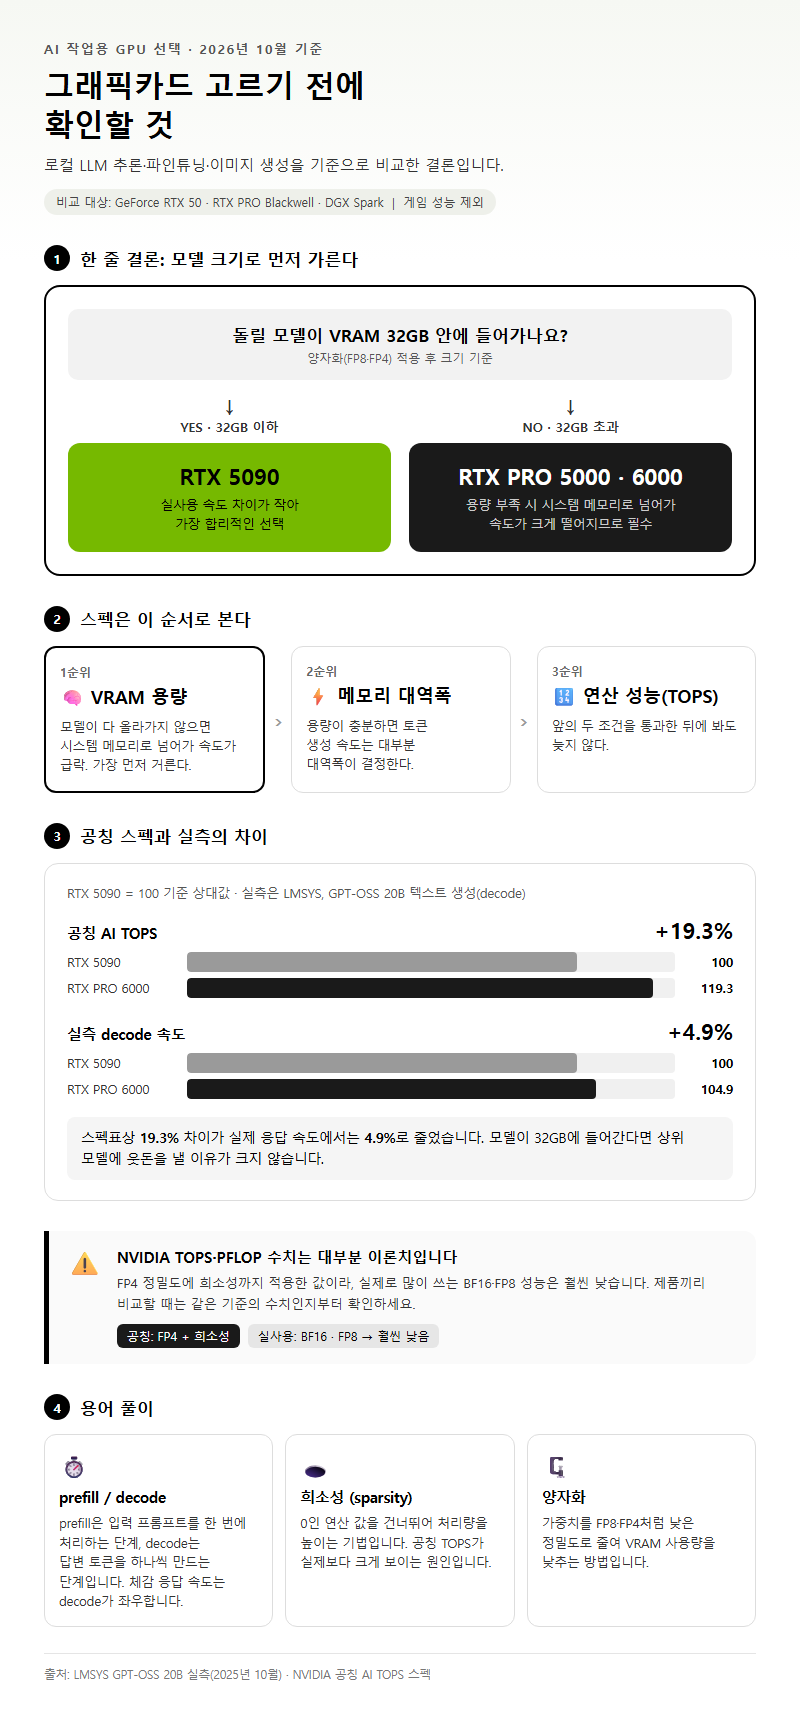
AI 작업용 그래픽카드는 모델이 32GB 안에 들어가면 RTX 5090, 넘으면 RTX PRO 5000·PRO 6000으로 고르는 것이 2026년 10월 현재 가장 합리적인 기준입니다. 근거는 실측입니다. 공칭 AI TOPS로는 RTX PRO 6000이 RTX 5090보다 19.3% 높지만, LMSYS가 2025년 10월 GPT-OSS 20B로 측정한 텍스트 생성(decode) 속도 차이는 4.9%에 그쳤습니다. 이 글은 로컬 LLM 추론·파인튜닝·이미지 생성을 기준으로 NVIDIA GeForce RTX 50 시리즈, RTX PRO Blackwell, DGX Spark를 비교했고, 게임 성능은 다루지 않습니다.
선택 순서는 VRAM 용량 → 메모리 대역폭 → 연산 성능(TOPS) 입니다. 모델이 VRAM에 다 올라가지 않으면 시스템 메모리로 넘어가면서 속도가 크게 떨어집니다. 그래서 용량을 가장 먼저 거릅니다. 용량이 충분하면 토큰 생성 속도는 대부분 메모리 대역폭이 결정하고, TOPS는 그다음에 봐도 늦지 않습니다.
미리 알아둘 전제가 하나 더 있습니다. NVIDIA가 내세우는 TOPS·PFLOP 수치는 대부분 FP4 정밀도에 희소성을 적용한 이론치입니다. 실제로 많이 쓰는 BF16·FP8 연산 성능은 이보다 훨씬 낮게 나옵니다. 제품끼리 비교할 때는 같은 기준의 수치인지부터 확인하는 게 먼저입니다.
용어 풀이
1. prefill / decode — prefill은 입력 프롬프트를 한 번에 처리하는 단계이고, decode는 답변 토큰을 하나씩 생성하는 단계로 체감 응답 속도를 좌우합니다.
2. 희소성(sparsity) — 연산 값 중 0인 부분을 건너뛰어 처리량을 높이는 기법으로, 공칭 TOPS를 실제 작업보다 크게 보이게 만드는 요인입니다.
3. 양자화 — 모델 가중치를 FP8·FP4처럼 낮은 정밀도로 줄여 VRAM 사용량을 낮추는 방법입니다.
준비물·필요 서류
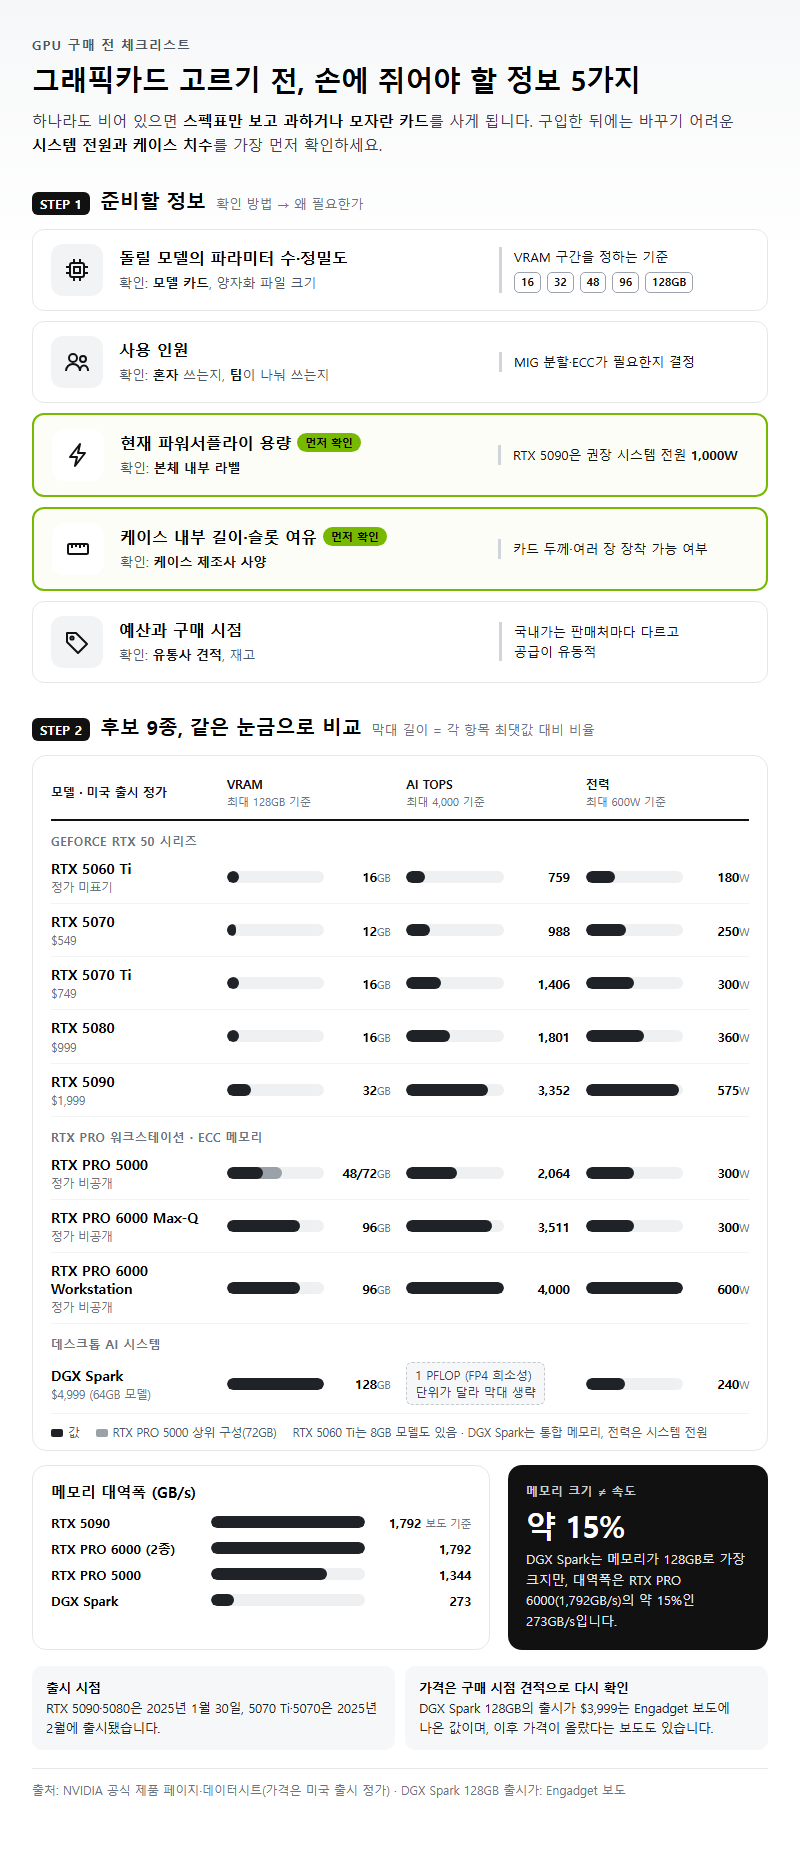
그래픽카드를 고르기 전에 손에 쥐고 있어야 할 정보는 다섯 가지입니다. 이 중 하나라도 비어 있으면 스펙표만 보고 과하거나 모자란 카드를 사게 됩니다. 시스템 전원과 케이스 치수는 사고 나서 바꾸기 어려우니 특히 먼저 확인합니다.
| 준비할 정보 | 확인 방법 | 왜 필요한가 |
|---|---|---|
| 돌릴 모델의 파라미터 수와 정밀도 | 모델 카드, 양자화 파일 크기 | VRAM 구간(16·32·48·96·128GB)을 정하는 기준 |
| 사용 인원 | 혼자 쓰는지, 팀이 나눠 쓰는지 | MIG 분할·ECC가 필요한지 결정 |
| 현재 파워서플라이 용량 | 본체 내부 라벨 | RTX 5090은 권장 시스템 전원 1,000W |
| 케이스 내부 길이·슬롯 여유 | 케이스 제조사 사양 | 카드 두께·여러 장 장착 가능 여부 |
| 예산과 구매 시점 | 유통사 견적, 재고 | 국내가는 판매처마다 다르고 공급이 유동적 |
후보 제품의 핵심 스펙은 아래와 같습니다. 출처는 NVIDIA 공식 제품 페이지·데이터시트이며, 가격은 미국 출시 정가 기준입니다.
| 모델 | VRAM | 메모리 대역폭 | AI TOPS | 전력 | 미국 출시 정가 |
|---|---|---|---|---|---|
| RTX 5060 Ti | 16GB / 8GB | — | 759 | 180W | — |
| RTX 5070 | 12GB | — | 988 | 250W | $549 |
| RTX 5070 Ti | 16GB | — | 1,406 | 300W | $749 |
| RTX 5080 | 16GB | — | 1,801 | 360W | $999 |
| RTX 5090 | 32GB | 1,792GB/s(보도 기준) | 3,352 | 575W | $1,999 |
| RTX PRO 5000 | 48GB / 72GB ECC | 1,344GB/s | 2,064 | 300W | — |
| RTX PRO 6000 Max-Q | 96GB ECC | 1,792GB/s | 3,511 | 300W | — |
| RTX PRO 6000 Workstation | 96GB ECC | 1,792GB/s | 4,000 | 600W | — |
| DGX Spark | 128GB 통합 메모리 | 273GB/s | 1 PFLOP(FP4 희소성) | 전원 240W | 64GB 모델 $4,999 |
표의 “—”는 이 글에서 비교 기준으로 쓰지 않았거나 회사가 정가를 공개하지 않은 항목입니다. RTX 5090·5080은 2025년 1월 30일 출시됐고, 5070 Ti·5070은 2025년 2월에 나왔습니다. RTX PRO 시리즈와 DGX Spark 128GB 모델은 NVIDIA 제품 페이지에 가격이 없습니다. DGX Spark 128GB의 출시가 $3,999는 Engadget 보도에 나온 값인데, 그 뒤 가격이 올랐다는 보도도 있으니 구매 시점 견적으로 다시 확인해야 합니다.
단계별 진행 순서
1단계: 돌릴 모델 크기와 정밀도부터 확정하기
- 소요시간: 한두 시간(모델 카드와 양자화 파일 크기 확인)
- 주의점: 추론만 할지, 파인튜닝까지 할지에 따라 필요한 메모리가 달라집니다.
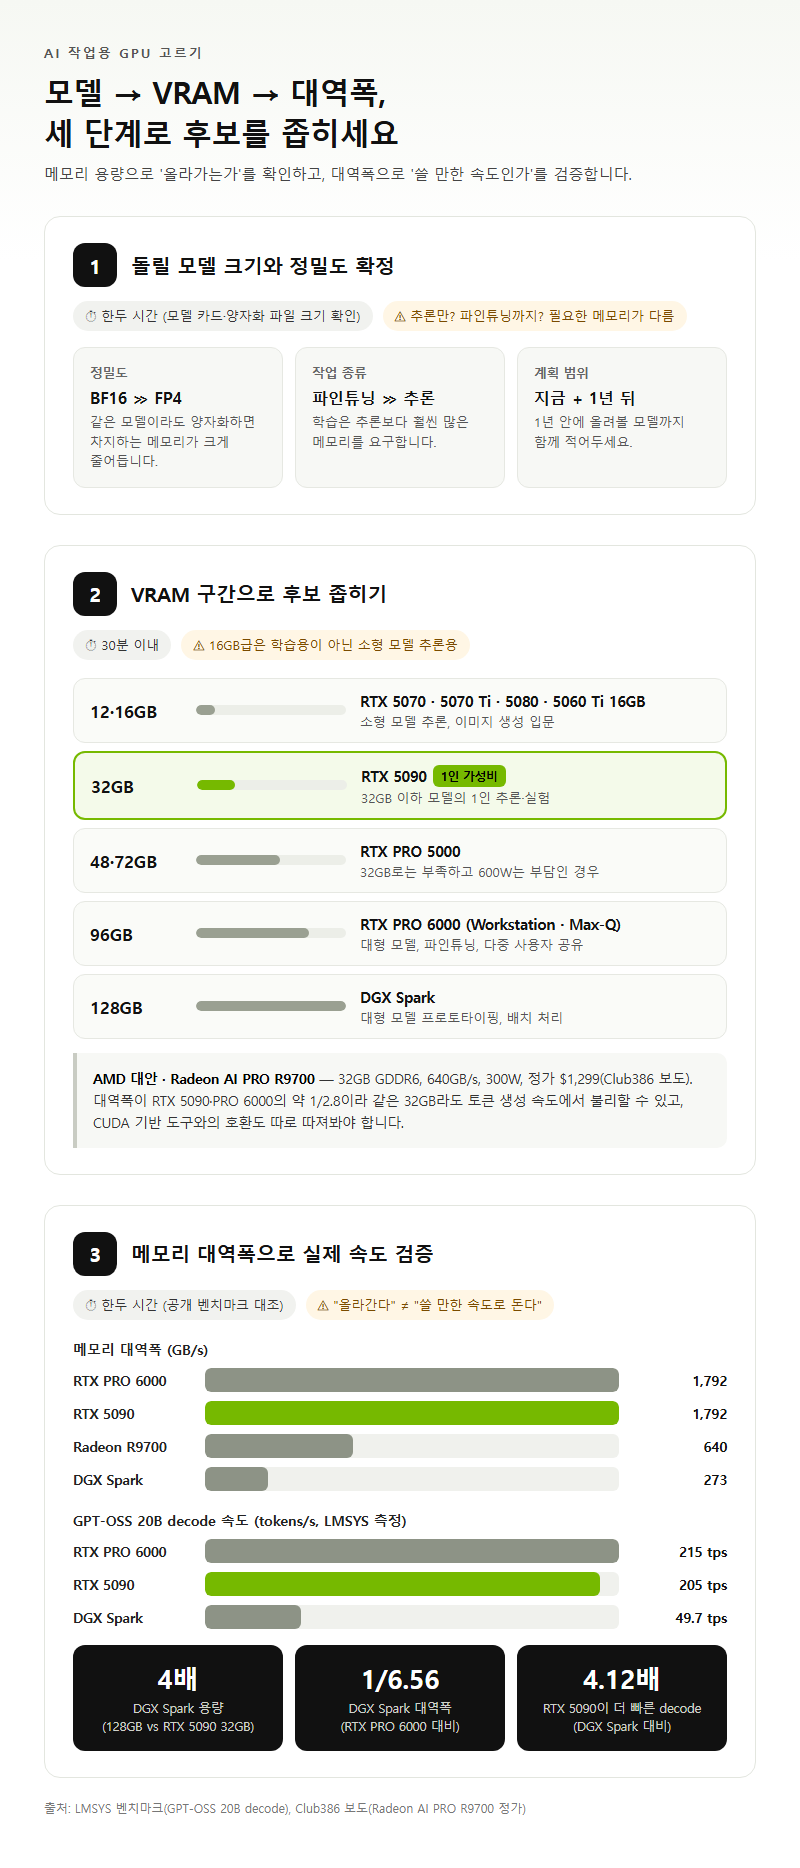
가장 먼저 “어떤 모델을, 어떤 정밀도로 돌릴 것인가”를 정합니다. 이 결정이 곧 VRAM 구간을 정하는 일입니다. 같은 모델이라도 BF16으로 올릴 때와 FP4로 양자화할 때 차지하는 메모리가 크게 다르고, 파인튜닝은 추론보다 훨씬 많은 메모리를 요구합니다. 지금 쓰는 모델뿐 아니라 1년 안에 올려볼 모델까지 함께 적어두는 편이 안전합니다.
2단계: VRAM 구간으로 후보 좁히기
- 소요시간: 30분 이내
- 주의점: 16GB급은 학습용이 아니라 소형 모델 추론용으로 보는 게 맞습니다.
가성비로 따지면 AI 작업용 그래픽카드는 다섯 구간으로 나뉩니다. 32GB 안에 들어가는 모델을 혼자 쓴다면 RTX 5090이 속도 대비 가격에서 가장 유리합니다. LMSYS 측정에서 RTX 5090의 decode 속도는 205 tps로, 정가가 훨씬 높은 RTX PRO 6000(215 tps)과 큰 차이가 없었습니다.
| VRAM 구간 | 후보 | 적합한 작업 |
|---|---|---|
| 12·16GB | RTX 5070·5070 Ti·5080·5060 Ti 16GB | 소형 모델 추론, 이미지 생성 입문 |
| 32GB | RTX 5090 | 32GB 이하 모델의 1인 추론·실험 |
| 48·72GB | RTX PRO 5000 | 32GB로는 부족하고 600W는 부담인 경우 |
| 96GB | RTX PRO 6000(Workstation·Max-Q) | 대형 모델, 파인튜닝, 다중 사용자 공유 |
| 128GB | DGX Spark | 대형 모델 프로토타이핑, 배치 처리 |
AMD 쪽 대안으로는 Radeon AI PRO R9700이 있습니다. 업계 보도 기준으로 32GB GDDR6, 640GB/s, 300W이고, Club386 보도에 나온 정가는 $1,299입니다. 다만 대역폭이 RTX 5090·PRO 6000의 약 1/2.8 수준이라 같은 32GB라도 토큰 생성 속도에서 불리할 수 있습니다. CUDA 기반 도구와의 호환도 따로 따져봐야 합니다.
3단계: 메모리 대역폭으로 실제 속도 검증하기
- 소요시간: 한두 시간(공개 벤치마크 대조)
- 주의점: “모델이 올라간다”와 “쓸 만한 속도로 돈다”는 별개입니다.
용량을 정했으면 대역폭으로 체감 속도를 가늠합니다. DGX Spark는 128GB로 RTX 5090의 4배 용량이지만, 대역폭은 273GB/s로 RTX PRO 6000(1,792GB/s)의 1/6.56에 불과합니다. 실측에서도 이 차이가 그대로 드러납니다. LMSYS의 GPT-OSS 20B 테스트에서 decode 속도는 RTX 5090이 205 tps, DGX Spark가 49.7 tps로 5090이 4.12배 빨랐습니다.
모델이 커지면 차이는 더 두드러집니다. DGX Spark에서 Llama 3.1 70B를 FP8로 돌렸을 때 decode는 초당 2.7 토큰으로 측정됐고, LMSYS는 LPDDR5x 메모리 대역폭을 주된 병목으로 지목했습니다. NVIDIA는 DGX Spark 1대로 최대 200B 파라미터 모델을 구동할 수 있다고 밝힙니다. 돌아가기는 하지만, 실시간 대화용으로 쓰기엔 속도가 따라오지 못한다는 뜻입니다.
4단계: 전력·케이스·슬롯 호환 확인하기
- 소요시간: 30분 이내(본체 사양 확인)
- 주의점: RTX 5090은 NVIDIA 공식 자료 안에서도 두께 표기가 엇갈립니다.
RTX 5090은 TGP가 575W이고 권장 시스템 전원이 1,000W입니다. 크기는 304×137mm인데, NVIDIA 스펙 표에는 2슬롯으로, 설치 안내에는 3슬롯(61mm)으로 적혀 있습니다. 파트너사 제품은 이보다 더 두꺼운 경우가 많습니다. 케이스 호환은 구매할 실물 모델의 치수로 확인합니다.
RTX PRO 6000 Workstation Edition은 600W 듀얼 슬롯 카드로, Develop3D는 냉각 구조상 여러 장을 꽂기 어렵다고 평가했습니다. 여러 장을 쓸 계획이라면 300W짜리 Max-Q를 봅니다. Max-Q의 AI TOPS는 3,511로 Workstation Edition의 87.8% 수준이고, Develop3D도 성능이 약 12% 낮을 것으로 추정했습니다. 전력을 절반으로 줄이는 대가치고는 손실이 작은 편입니다.
5단계: 혼자 쓸지, 나눠 쓸지 정하기
- 소요시간: 팀 내 협의 시간
- 주의점: MIG 분할은 GeForce에서는 지원되지 않습니다.
여러 사람이 GPU 한 장을 나눠 써야 한다면 RTX PRO 계열로 가야 합니다. RTX PRO 6000은 MIG로 최대 4×24GB, 2×48GB, 1×96GB로 나눌 수 있고, RTX PRO 5000은 최대 2개로 분할됩니다. 두 제품 모두 ECC 메모리를 써서 장시간 학습이나 결과 재현성이 중요한 작업에도 잘 맞습니다.
용어 풀이
1. MIG(Multi-Instance GPU) — GPU 한 장을 독립된 여러 개의 GPU처럼 나눠 각 사용자에게 할당하는 기능입니다.
2. ECC 메모리 — 메모리에서 생기는 비트 오류를 스스로 검출·정정해 장시간 작업의 안정성을 높이는 메모리입니다.
6단계: 가격·재고·신제품 일정 확인하기
- 소요시간: 하루 이틀(복수 유통사 견적 비교)
- 주의점: 국내 유통가는 회사가 정가를 공개하지 않아 판매처마다 다릅니다.
마지막은 견적과 재고입니다. RTX 5090은 일부 매체가 생산 중단설을 보도했지만, 원 출처가 유출자 게시물이고 NVIDIA의 공식 발표는 없습니다(2026년 10월 기준). 견적을 받기 전에 유통사 재고부터 확인해 두는 것이 좋습니다.
신제품 일정도 판단에 영향을 줍니다. NVIDIA는 2026년 10월 2일 DGX Spark 64GB 모델을 발표했고, $4,999부터 2026년 10월 23일 Acer·ASUS·Dell·Gigabyte·HP·MSI 6개사에서 판매합니다. 회사는 1대로 최대 100B, 2대를 연결하면 200B 파라미터 모델을 다룰 수 있다고 밝혔습니다. 2026년 10월 7일에는 통합 메모리 최대 128GB의 RTX Spark를 발표했으며, 노트북은 2026년 10월 16일, 소형 데스크톱은 2026년 11월에 판매가 시작됩니다. RTX Spark는 아직 공개된 실측 벤치마크가 없습니다. 구매 판단은 실측 리뷰가 나온 뒤로 미루는 편이 안전합니다.
자주 놓치는 부분
공칭 TOPS를 그대로 비교하는 실수
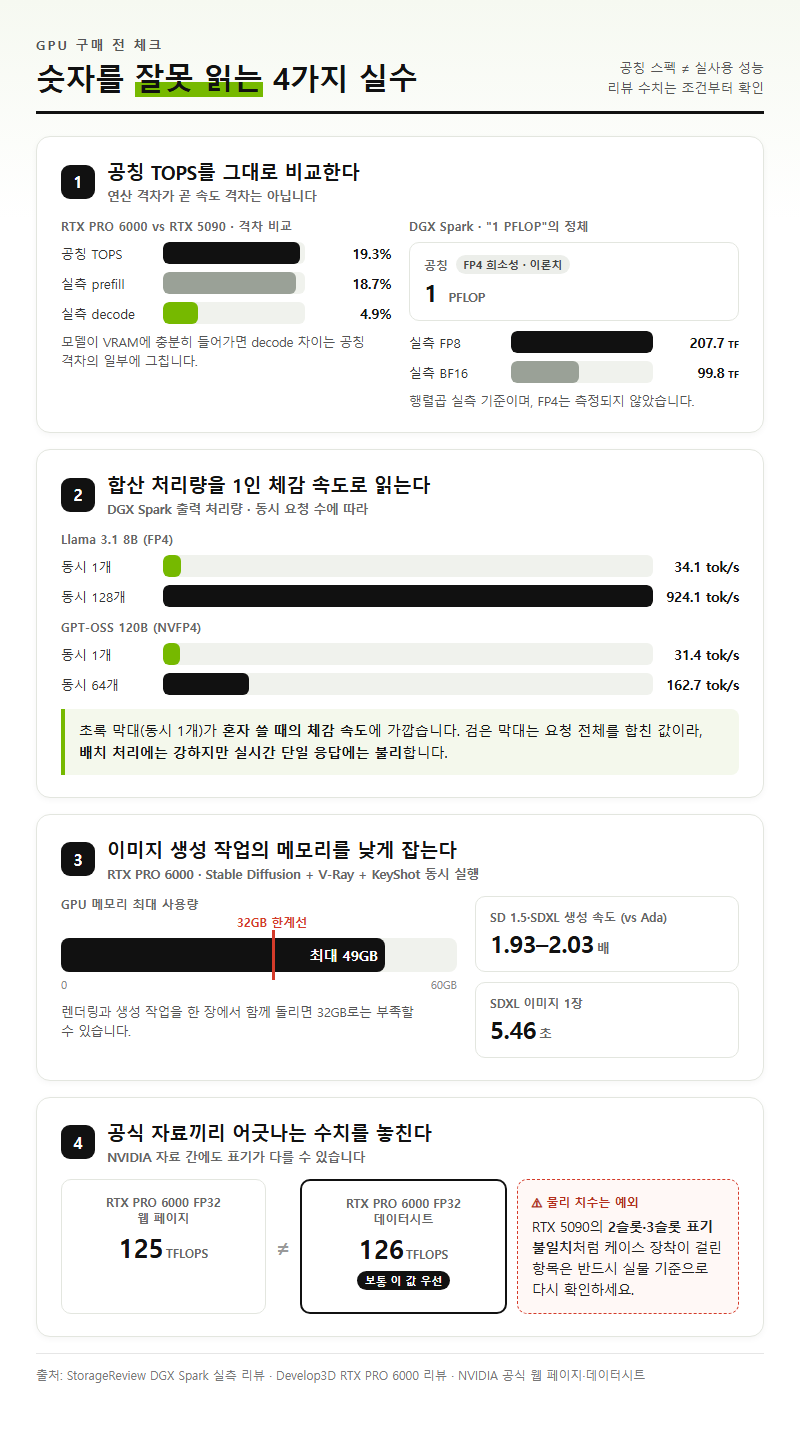
가장 흔한 실수는 TOPS 숫자를 그대로 성능 순위로 읽는 것입니다. DGX Spark의 1 PFLOP은 FP4 희소성 기준 이론치이고, StorageReview가 직접 측정한 행렬곱 성능은 BF16 99.8 TFLOPS, FP8 207.7 TFLOPS였습니다. FP4는 측정하지 않았습니다. RTX PRO 6000과 RTX 5090도 공칭 TOPS 차이는 19.3%지만, 실측 prefill 차이는 18.7%, decode 차이는 4.9%였습니다. 모델이 VRAM에 충분히 들어가는 상황이라면 연산 격차만큼 속도 차이가 나지 않습니다.
합산 처리량과 1인 체감 속도를 혼동하는 실수
DGX Spark 리뷰에서 큰 숫자가 보이면 동시 요청 수부터 봅니다. StorageReview 측정에서 Llama 3.1 8B(FP4)의 출력 처리량은 동시 요청 1개일 때 34.1 tok/s, 동시 128개일 때 924.1 tok/s였습니다. 뒤의 값은 요청 전체를 합친 처리량입니다. 혼자 쓰는 사람이 체감하는 속도는 앞의 값에 가깝습니다. GPT-OSS 120B(NVFP4)도 동시 1개 31.4 tok/s, 동시 64개 162.7 tok/s로 같은 구조입니다. 배치 처리에는 강하지만 실시간 단일 응답에는 불리합니다.
이미지 생성 작업의 메모리를 낮게 잡는 실수
이미지 생성은 LLM보다 메모리를 덜 쓴다고 여기기 쉽지만, 여러 작업을 동시에 돌리면 사정이 달라집니다. Develop3D가 RTX PRO 6000에서 Stable Diffusion·V-Ray·KeyShot을 동시에 실행했을 때 GPU 메모리를 최대 49GB 썼습니다. 같은 리뷰에서 RTX PRO 6000의 SD 1.5·SDXL 생성 속도는 이전 세대 Ada 대비 1.93배에서 2.03배였고, SDXL 이미지 1장에 5.46초가 걸렸습니다. 렌더링과 생성 작업을 한 장에서 함께 돌린다면 32GB로는 부족할 수 있습니다.
공식 자료끼리 어긋나는 수치를 놓치는 실수
NVIDIA 공식 자료끼리도 수치가 엇갈리는 경우가 있습니다. RTX PRO 6000의 FP32 성능은 웹 페이지에 125 TFLOPS, 데이터시트에 126 TFLOPS로 적혀 있습니다. 이럴 때는 보통 데이터시트 값을 우선합니다. 다만 RTX 5090의 2슬롯·3슬롯 표기 불일치처럼 물리 치수가 걸린 항목은 반드시 실물 기준으로 다시 확인해야 합니다.
체크리스트 정리
구매 직전에 아래 일곱 가지만 점검하면 큰 실수는 피할 수 있습니다.
- 모델 크기와 정밀도를 정했고, 그 모델이 후보 카드의 VRAM 안에 들어가는지 확인했다.
- 32GB 이하라면 RTX 5090, 초과라면 RTX PRO 5000(48·72GB)이나 PRO 6000(96GB)으로 VRAM 구간을 먼저 골랐다.
- 실시간 응답이 중요하다면 대역폭을 확인했고, DGX Spark의 273GB/s가 단일 응답 속도에 불리하다는 점을 감안했다.
- RTX 5090이라면 1,000W 전원과 실물 두께에 맞는 케이스 공간을 확보했다.
- 여러 장을 꽂을 계획이라면 600W Workstation Edition 대신 300W Max-Q를 검토했다.
- 팀이 함께 쓴다면 MIG·ECC를 지원하는 RTX PRO 계열로 후보를 좁혔다.
- 국내 견적과 재고를 2곳 이상 유통사에서 받았고, RTX Spark처럼 실측이 없는 신제품은 리뷰가 나올 때까지 판단을 미뤘다.
참고 자료
– NVIDIA GeForce RTX 5090 제품 페이지: https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
– NVIDIA GeForce 50 시리즈 비교: https://www.nvidia.com/en-us/geforce/graphics-cards/compare/
– NVIDIA 뉴스룸, RTX 50 시리즈 발표: https://nvidianews.nvidia.com/news/nvidia-blackwell-geforce-rtx-50-series-opens-new-world-of-ai-computer-graphics
– NVIDIA RTX PRO 6000 Workstation Edition 데이터시트: https://www.nvidia.com/content/dam/en-zz/Solutions/data-center/rtx-pro-6000-blackwell-workstation-edition/workstation-blackwell-rtx-pro-6000-workstation-edition-nvidia-us-3519208-web.pdf
– NVIDIA RTX PRO 6000 Max-Q 데이터시트: https://www.nvidia.com/content/dam/en-zz/Solutions/products/workstations/professional-desktop-gpus/rtx-pro-6000-max-q/workstation-datasheet-blackwell-rtx-pro-6000-max-q-nvidia-us-5349650-web.pdf
– NVIDIA RTX PRO 5000 제품 페이지: https://www.nvidia.com/en-us/products/workstations/professional-desktop-gpus/rtx-pro-5000/
– NVIDIA DGX Spark 하드웨어 문서: https://docs.nvidia.com/dgx/dgx-spark/hardware.html
– NVIDIA 블로그, DGX Spark 64GB 발표: https://blogs.nvidia.com/blog/local-ai-dgx-spark-64gb-sync/
– NVIDIA 블로그, RTX Spark 발표: https://blogs.nvidia.com/blog/local-ai-rtx-spark-microsoft-windows-event/
– LMSYS, DGX Spark 벤치마크(2025-10-13): https://www.lmsys.org/blog/2025-10-13-nvidia-dgx-spark
– StorageReview, DGX Spark 리뷰: https://storagereview.com/review/nvidia-dgx-spark-review-the-ai-appliance-bringing-datacenter-capabilities-to-desktops
– Develop3D, RTX PRO Blackwell 리뷰: https://develop3d.com/reviews/review-nvidia-rtx-pro-blackwell-gpus/
– AMD Radeon AI PRO R9700 사양(보도 인용)
– DGX Spark 128GB 출시가, Engadget(보도 인용)
참고 자료
조사 기준일: 2026년 10월 15일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (확인일 2026-10-15)
– https://www.nvidia.com/en-us/geforce/graphics-cards/50-series/rtx-5090/
– https://www.nvidia.com/en-us/geforce/graphics-cards/compare/
– https://nvidianews.nvidia.com/news/nvidia-blackwell-geforce-rtx-50-series-opens-new-world-of-ai-computer-graphics
– https://www.nvidia.com/en-us/products/workstations/professional-desktop-gpus/rtx-pro-6000/
– https://www.nvidia.com/content/dam/en-zz/Solutions/data-center/rtx-pro-6000-blackwell-workstation-edition/workstation-blackwell-rtx-pro-6000-workstation-edition-nvidia-us-3519208-web.pdf
– https://www.nvidia.com/content/dam/en-zz/Solutions/products/workstations/professional-desktop-gpus/rtx-pro-6000-max-q/workstation-datasheet-blackwell-rtx-pro-6000-max-q-nvidia-us-5349650-web.pdf
– https://www.nvidia.com/en-us/products/workstations/professional-desktop-gpus/rtx-pro-5000/
– https://docs.nvidia.com/dgx/dgx-spark/hardware.html
– https://www.nvidia.com/en-us/products/workstations/dgx-spark/
– https://blogs.nvidia.com/blog/local-ai-dgx-spark-64gb-sync/
– https://blogs.nvidia.com/blog/local-ai-rtx-spark-microsoft-windows-event/
– https://investor.nvidia.com/news/press-release-details/2025/NVIDIA-DGX-Spark-Arrives-for-Worlds-AI-Developers/
– https://www.lmsys.org/blog/2025-10-13-nvidia-dgx-spark
– https://storagereview.com/review/nvidia-dgx-spark-review-the-ai-appliance-bringing-datacenter-capabilities-to-desktops
– https://develop3d.com/reviews/review-nvidia-rtx-pro-blackwell-gpus/
– https://www.amd.com/en/products/graphics/workstations/radeon-ai-pro/ai-9000-series/amd-radeon-ai-pro-r9700.html (시간 초과)
– https://www.phoronix.com/review/nvidia-rtx-pro-blackwell/3 (403)
– https://www.tomshardware.com/pc-components/gpus/nvidia-geforce-rtx-5090-review/7 (본문 잘림)
답글 남기기