
Meta가 2026년 9월 2일 공개한 Muse Spark 1.3의 변화를 초보자 눈높이로 정리했습니다. 도구 호출 20% 감소, 21배 저렴한 요금제의 조건, 발표 점수와 실측치의 간극까지 확인된 자료만 짚습니다.
뮤즈 스파크 1.3 개요
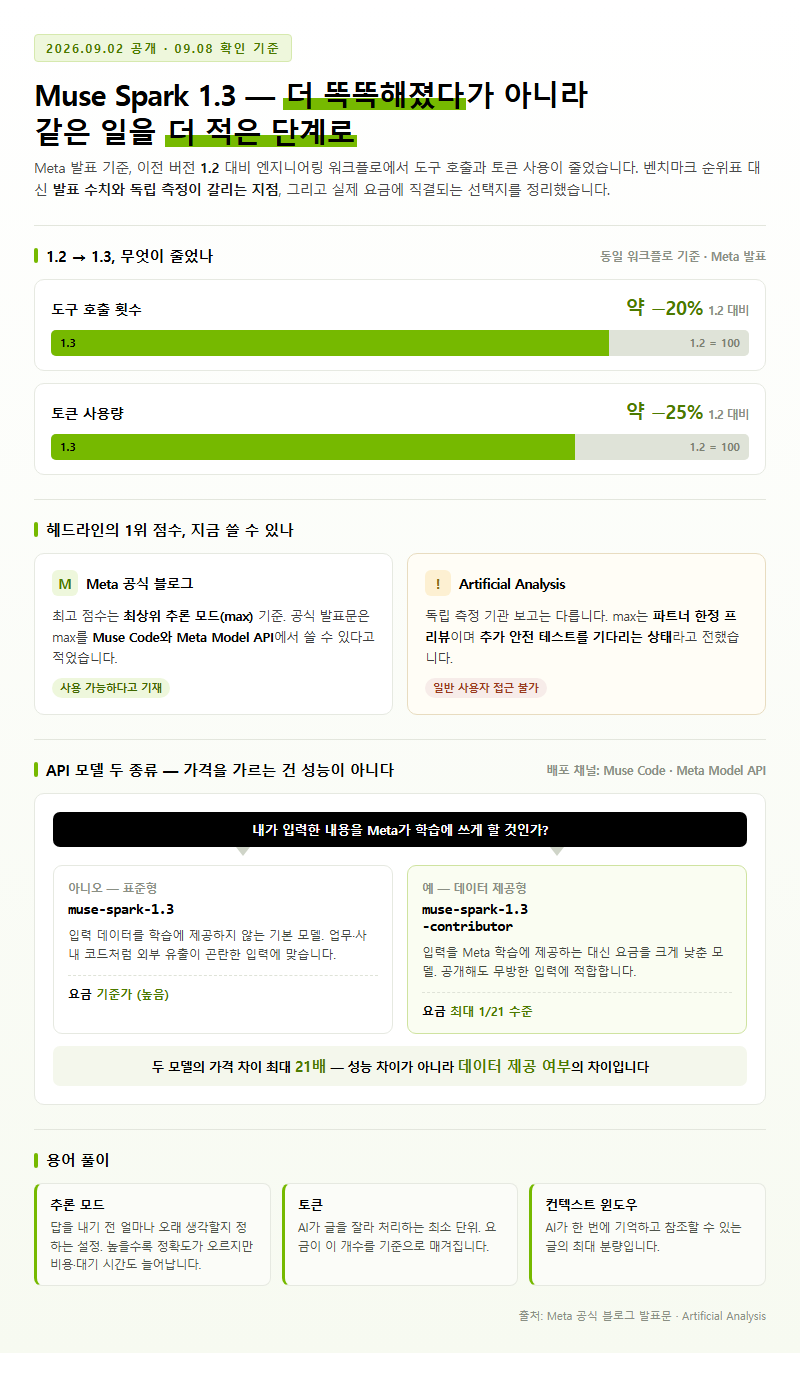
이번 업데이트의 핵심은 “더 똑똑해졌다”가 아니라 “같은 일을 더 적은 단계로 끝낸다”입니다. Meta가 2026년 9월 2일 공개한 Muse Spark 1.3은 이전 버전인 1.2와 비교해 엔지니어링 워크플로에서 도구 호출이 약 20%, 토큰 사용이 약 25% 줄었다고 밝혔습니다. 이 글은 벤치마크 순위표를 나열하는 대신, 발표 내용과 독립 측정 기관의 수치가 어디서 갈리는지, 일반 사용자가 실제로 체감할 변화가 무엇인지를 2026년 9월 8일 확인 기준으로 정리했습니다.
먼저 짚을 점이 있습니다. Meta 공식 블로그가 내세운 최고 점수는 일반 사용자가 지금 쓸 수 없는 최상위 추론 모드(max) 기준입니다. 공식 발표문은 max 추론 모드를 Muse Code와 Meta Model API에서 쓸 수 있다고 적었으나, 독립 측정 기관 Artificial Analysis는 max가 파트너 한정 프리뷰이며 추가 안전 테스트를 기다리는 상태라고 보고했습니다. 뉴스 헤드라인의 1위 숫자를 그대로 체감하기는 어렵다는 뜻입니다.
배포 채널은 두 곳입니다. Muse Code와 Meta Model API에서 즉시 쓸 수 있고, API 모델은 표준형 muse-spark-1.3과 데이터 제공형 muse-spark-1.3-contributor 두 종류로 나뉩니다. 이 둘의 가격 차이가 최대 21배까지 벌어지는데, 그 이유가 성능이 아니라 내가 입력한 내용을 Meta가 학습에 쓰느냐 여부입니다. 이번 버전에서 가장 실용적인 정보이기도 합니다.
용어 풀이
1. 추론 모드(reasoning mode) — AI가 답을 내기 전 얼마나 오래 생각할지 정하는 설정으로, 높을수록 정확도가 오르지만 비용과 대기 시간도 함께 늘어납니다.
2. 토큰(token) — AI가 글을 잘라 처리하는 최소 단위로, 요금이 이 개수 기준으로 매겨집니다.
3. 컨텍스트 윈도우(context window) — AI가 한 번에 기억하고 참조할 수 있는 글의 최대 분량입니다.
1. 1.2에서 실제로 달라진 것: 효율과 태도
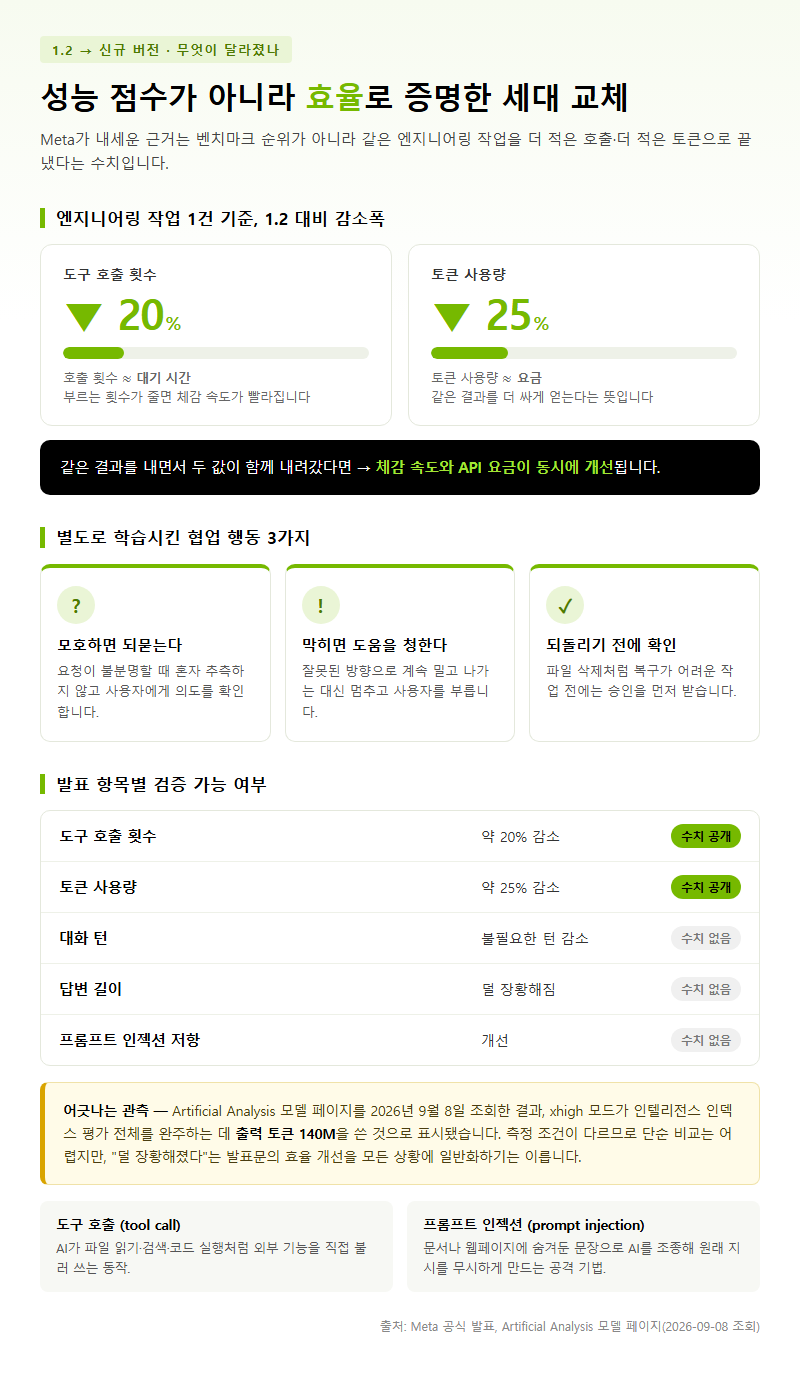
Meta가 직접 든 개선 근거는 성능 점수가 아니라 효율 수치였습니다. 1.2와 같은 엔지니어링 작업을 시킬 때 도구 호출이 약 20%, 토큰이 약 25% 줄었다는 것입니다. 이 두 숫자가 왜 중요한지 풀어 보면, AI에게 작업을 맡길 때 비용은 대체로 토큰 사용량에 비례하고 대기 시간은 도구를 몇 번 부르느냐에 비례합니다. 같은 결과를 내면서 두 값이 함께 내려갔다면 체감 속도와 요금이 동시에 개선된다는 뜻입니다.
행동 방식의 변화도 함께 발표됐습니다. 불필요한 대화 턴이 줄었고, 답변이 덜 장황해졌으며, 코딩 스타일이 정돈됐다는 설명입니다. 여기에 협업 행동을 별도로 학습시켰다고 밝혔는데, 구체적으로는 모호한 요청에는 되묻고, 막히면 사용자에게 도움을 청하고, 되돌리기 어려운 작업 전에는 확인을 받는 세 가지입니다. AI가 혼자 판단해 파일을 지우거나 잘못된 방향으로 밀고 나가는 사고를 줄이려는 설계로 읽힙니다.
안전 측면에서는 적대적 견고성과 프롬프트 인젝션 저항이 개선됐다고 밝혔습니다. 다만 이 항목은 개선 폭을 나타내는 수치가 공개되지 않아, 얼마나 나아졌는지는 확인할 수 없습니다.
| 항목 | 1.2 대비 변화 | 출처 등급 |
|---|---|---|
| 도구 호출 횟수 | 약 20% 감소 | Meta 공식 발표 |
| 토큰 사용량 | 약 25% 감소 | Meta 공식 발표 |
| 대화 턴 | 불필요한 턴 감소 (수치 없음) | Meta 공식 발표 |
| 답변 길이 | 덜 장황해짐 (수치 없음) | Meta 공식 발표 |
| 프롬프트 인젝션 저항 | 개선 (수치 없음) | Meta 공식 발표 |
한편 “덜 장황해졌다”는 주장과 어긋나는 관측도 있습니다. Artificial Analysis 모델 페이지를 2026년 9월 8일 조회해 보니, xhigh 모드가 인텔리전스 인덱스 평가 전체를 완주하는 데 출력 토큰 140M을 썼다고 표시됐습니다. 조건이 다른 측정이라 단순 비교는 어렵지만, 발표문의 효율 개선을 모든 상황에 일반화하기는 이릅니다.
용어 풀이
1. 도구 호출(tool call) — AI가 파일 읽기·검색·코드 실행처럼 외부 기능을 직접 불러 쓰는 동작입니다.
2. 프롬프트 인젝션(prompt injection) — 문서나 웹페이지에 숨겨둔 문장으로 AI를 조종해 원래 지시를 무시하게 만드는 공격 기법입니다.
2. 발표 점수와 실측치가 갈리는 지점
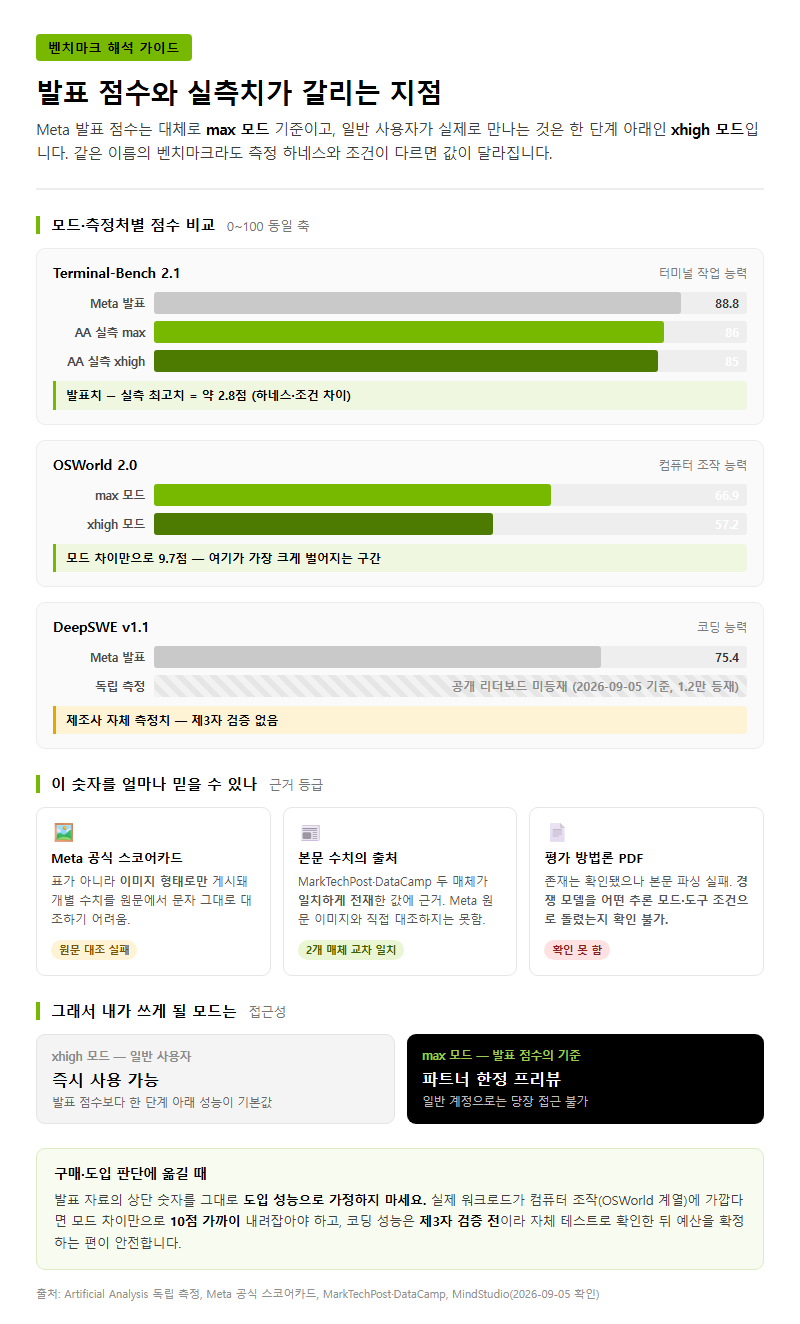
초보 사용자가 가장 오해하기 쉬운 부분이 벤치마크입니다. 결론부터 말하면 Meta 발표 점수는 대체로 max 모드 기준이고, 일반 사용자가 만나는 것은 한 단계 아래인 xhigh 모드입니다. 두 모드의 차이가 작지 않습니다. 컴퓨터 조작 능력을 재는 OSWorld 2.0에서 max는 66.9인데 xhigh는 57.2로, 약 10점 가까이 벌어집니다.
터미널 작업 능력을 보는 Terminal-Bench 2.1도 마찬가지입니다. Meta 스코어카드는 88.8을 제시했지만, Artificial Analysis 실측은 xhigh 85, max 86이었습니다. 같은 이름의 벤치마크라도 측정 하네스와 조건에 따라 값이 달라집니다.
| 지표 | Meta 발표 | 독립 측정(AA) |
|---|---|---|
| Terminal-Bench 2.1 | 88.8 | xhigh 85 / max 86 |
| OSWorld 2.0 | max 66.9 | xhigh 57.2 (모드 차이) |
| DeepSWE v1.1 | 75.4 | 공개 리더보드 미등재(2026-09-05 기준) |
| max 모드 접근성 | 즉시 사용 가능 | 파트너 한정 프리뷰 |
코딩 능력의 대표 근거로 제시된 DeepSWE v1.1 75.4점은 따로 주의해야 합니다. MindStudio가 2026년 9월 5일 확인한 바로는 공개 리더보드에 1.3이 아직 올라 있지 않고 1.2만 등재된 상태였습니다. 이 점수는 현재로서는 제조사 자체 측정치이며, 제3자 검증을 거치지 않았습니다.
Meta 공식 블로그의 스코어카드는 표가 아니라 이미지 형태로만 실려 있어, 개별 수치를 원문에서 문자 그대로 대조하기 어렵습니다. 이 글의 벤치마크 값들은 MarkTechPost와 DataCamp 두 매체가 일치하게 전재한 내용에 근거하며, Meta 원문 이미지와 직접 대조하지는 못했습니다(확인 필요). 함께 공개된 평가 방법론 PDF도 존재 자체는 확인됐으나 본문 파싱에 실패해, 어떤 추론 모드와 도구 조건으로 경쟁 모델을 돌렸는지는 확인하지 못했습니다.
3. 좋아진 것과 나빠진 것이 함께 있다
버전 업그레이드를 “전 항목 개선”으로 읽으면 오판하기 쉽습니다. Muse Spark 1.3은 두 개 지표에서 오히려 1.2보다 낮은 점수를 받았습니다. 긴 문서를 읽고 추론하는 AA-LCR은 83%에서 79%로, 폭넓은 지식 정확도를 재는 AA-Omniscience는 45%에서 42%로 내려갔습니다.
다만 뒤쪽 하락은 해석이 필요합니다. Artificial Analysis는 정확도 하락의 원인을 “모르면 답하지 않는” 기권율 상승으로 설명했습니다. 아는 척하고 틀리게 답하는 것보다 모른다고 말하는 편이 실무에서는 안전한 경우가 많으므로, 이 수치만으로 모델이 퇴보했다고 단정하기는 어렵습니다. 반면 AA-LCR 하락은 긴 문서를 다루는 작업에 직접 영향을 주니, 해당 용도라면 자체 자료로 재측정해 보는 편이 낫습니다.
종합 점수 흐름은 이렇습니다. Artificial Analysis 인텔리전스 인덱스에서 1.2는 8월 기준 57이었고, 1.3 발표 직후 xhigh 61, max 62로 올랐습니다. 이 61점은 GPT-5.6 Sol (max), Grok 4.6 (high), Claude Opus 5 (high)와 동점 수준이며, 인덱스는 에이전트·코딩·과학 추론·지식 신뢰도 등 9~10개 평가를 합성한 값입니다.
| 지표 | 1.2 | 1.3 | 방향 |
|---|---|---|---|
| AA 인텔리전스 인덱스 | 57(8월) | xhigh 61 / max 62 | 상승 |
| AA-LCR (롱컨텍스트 추론) | 83% | 79% | 하락 |
| AA-Omniscience 정확도 | 45% | 42%(xhigh) | 하락 |
한 가지 더 밝혀둘 것이 있습니다. 2026년 9월 8일 Artificial Analysis 라이브 모델 페이지를 직접 조회했을 때는 max 48, xhigh 45로 표시돼 발표 직후의 61/62와 어긋났습니다. 페이지에 Terminal-Bench v4.0이 언급된 것으로 보아 인덱스 산출 방식이 개정됐을 가능성이 높지만, 원인은 확인하지 못했습니다. 벤치마크 점수는 측정 버전에 따라 이렇게 흔들립니다. 절대값보다 비교 조건이 같은지를 먼저 봐야 합니다.
4. 21배 싼 요금제, 싼 이유가 따로 있다
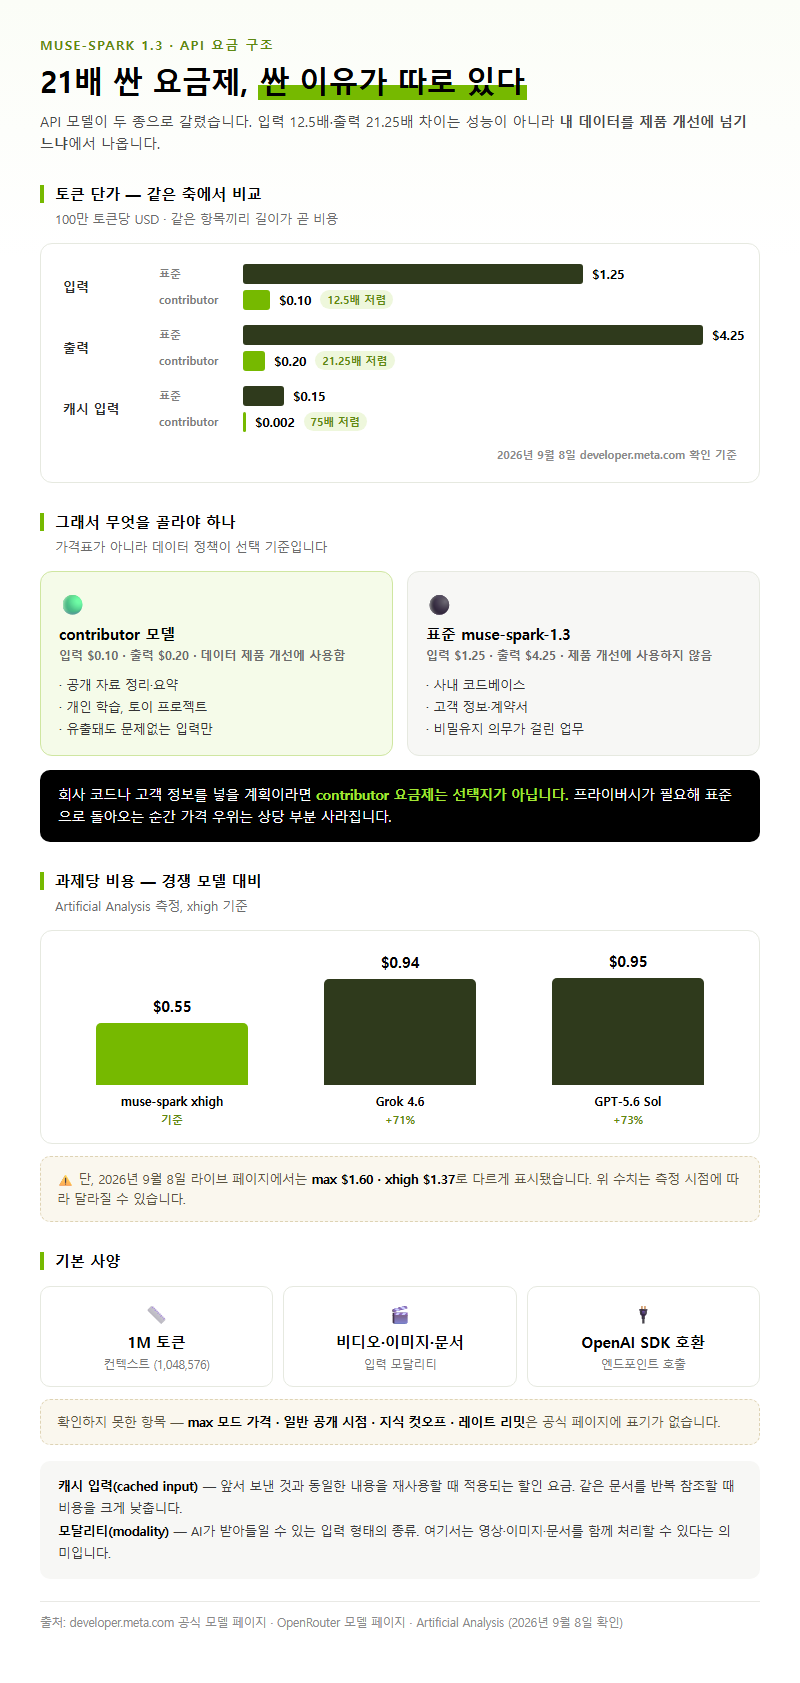
이번 발표에서 실무적으로 가장 눈에 띄는 변화는 요금 구조입니다. API 모델이 두 종으로 나뉘었고, 가격 차이가 입력 12.5배, 출력 21.25배에 달합니다. 2026년 9월 8일 developer.meta.com 확인 기준 가격은 다음과 같습니다.
| 구분 | 표준 muse-spark-1.3 |
muse-spark-1.3-contributor |
|---|---|---|
| 입력 | $1.25 / 100만 토큰 | $0.10 / 100만 토큰 |
| 캐시 입력 | $0.15 / 100만 토큰 | $0.002 / 100만 토큰 |
| 출력 | $4.25 / 100만 토큰 | $0.20 / 100만 토큰 |
| 데이터 이용 | 제품 개선에 사용하지 않음 | 제품 개선에 사용함 |
값이 싼 이유는 성능 차이가 아닙니다. contributor 모델은 입력한 프롬프트와 출력 결과가 Meta 제품 개선에 쓰인다고 공식 모델 페이지가 명시합니다. OpenRouter 모델 페이지도 같은 취지의 고지를 싣고 있습니다. 개인이 공개 자료를 정리하거나 학습용으로 쓰는 용도라면 합리적인 선택이지만, 회사 코드나 고객 정보를 넣을 계획이라면 이 요금제는 피해야 합니다. 프라이버시가 필요해 표준 모델로 돌아오면 입력 $1.25, 출력 $4.25가 적용되므로 가격 우위는 상당 부분 사라집니다.
비용 효율은 과제 단위로 보면 더 분명합니다. Artificial Analysis 측정에서 xhigh는 과제당 $0.55로, GPT-5.6 Sol의 $0.95, Grok 4.6의 $0.94와 비교하면 70% 이상 저렴합니다. 다만 이 값 역시 2026년 9월 8일 라이브 페이지 조회 시에는 max $1.60, xhigh $1.37로 다르게 표시됐습니다.
기본 사양도 정리해 둡니다. 컨텍스트 길이는 1M 토큰(정확히는 1,048,576)이고, 입력 모달리티는 비디오·이미지·문서를 지원하며, 엔드포인트는 OpenAI SDK 호환 클라이언트로 호출합니다. 반면 max 모드의 가격과 일반 공개 시점, 지식 컷오프, 레이트 리밋은 공식 페이지에 표기가 없어 확인하지 못했습니다.
용어 풀이
1. 캐시 입력(cached input) — 앞서 보낸 것과 동일한 내용을 재사용할 때 적용되는 할인 요금으로, 같은 문서를 반복 참조할 때 비용을 크게 낮춥니다.
2. 모달리티(modality) — AI가 받아들일 수 있는 입력 형태의 종류로, 여기서는 영상·이미지·문서를 함께 처리할 수 있다는 의미입니다.
5. 자주 묻는 질문과 남은 미확인 항목
Q. 지금 바로 갈아탈 만한가요?
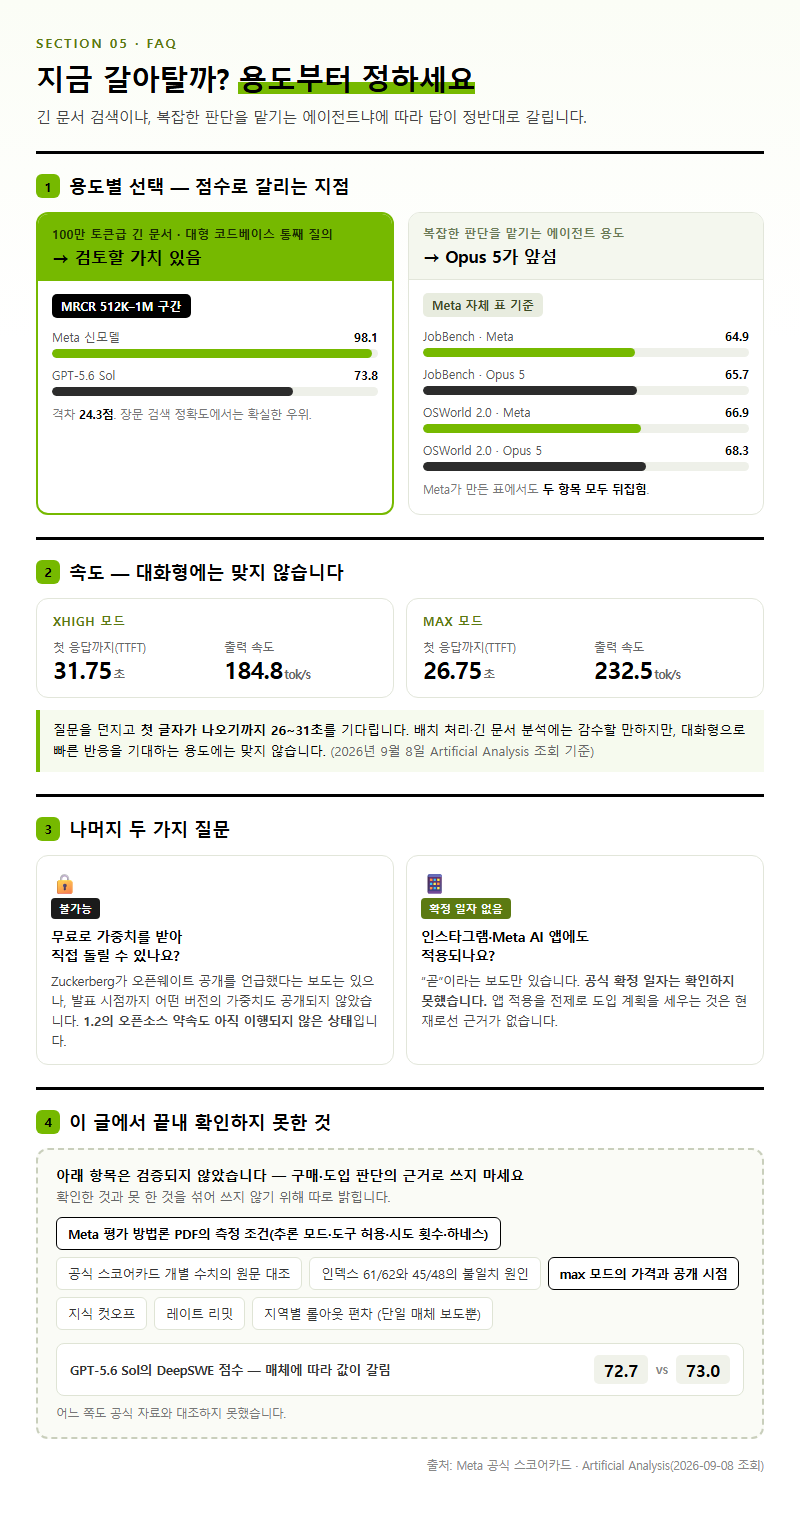
용도에 따라 갈립니다. 100만 토큰급의 긴 문서나 대형 코드베이스를 통째로 질의하는 작업이라면 검토할 가치가 있습니다. Meta 스코어카드 기준 MRCR 512K-1M 구간에서 98.1점으로, GPT-5.6 Sol의 73.8과 격차가 큽니다. 반대로 복잡한 판단을 맡기는 에이전트 용도라면 Meta 자체 표에서도 JobBench 64.9 대 Claude Opus 5의 65.7, OSWorld 2.0 66.9 대 68.3으로 Opus 5가 앞섭니다.
Q. 속도는 빨라졌나요?
속도는 강점으로 보기 어렵습니다. 2026년 9월 8일 Artificial Analysis 조회 기준 첫 응답까지 걸리는 시간(TTFT)이 xhigh 31.75초, max 26.75초로 표시됐고, 출력 속도는 각각 초당 184.8토큰, 232.5토큰이었습니다. 대화형으로 빠른 반응을 기대하는 용도에는 맞지 않습니다.
Q. 무료로 가중치를 받아 직접 돌릴 수 있나요?
불가능합니다. Zuckerberg가 오픈웨이트 공개를 언급했다는 보도가 있으나, 발표 시점까지 어떤 버전의 가중치도 공개되지 않았고 1.2의 오픈소스 약속도 이행되지 않은 상태입니다.
Q. 인스타그램이나 Meta AI 앱에도 적용되나요?
“곧”이라는 보도만 있고 공식 확정 일자는 확인하지 못했습니다.
이 글을 쓰면서 끝내 확인하지 못한 항목을 따로 밝힙니다. Meta 평가 방법론 PDF의 측정 조건(추론 모드·도구 허용·시도 횟수·하네스), 공식 스코어카드 개별 수치의 원문 대조, 인덱스 61/62와 45/48의 불일치 원인, max 모드의 가격과 공개 시점, 지식 컷오프와 레이트 리밋이 여기 해당합니다. GPT-5.6 Sol의 DeepSWE 점수도 매체에 따라 72.7과 73.0으로 값이 갈려, 어느 쪽도 공식 자료와 대조하지 못했습니다. 지역별 롤아웃 편차 주장 역시 단일 매체 보도뿐이라 확인이 필요합니다.
정리
Muse Spark 1.3의 실질적 변화는 성능 도약보다 효율 개선입니다. 도구 호출 약 20%, 토큰 약 25% 감소가 Meta가 직접 제시한 근거이며, 모호한 요청에 되묻고 위험한 작업 전에 확인하는 협업 행동이 추가됐습니다. 다만 발표된 최고 점수는 일반 사용자가 쓸 수 없는 max 모드 기준이고, AA-LCR과 Omniscience 두 지표는 오히려 하락했습니다. contributor 요금제의 21배 가격 차이는 입력 데이터가 Meta 학습에 쓰이는 대가이므로, 업무 자료를 다룬다면 표준 모델을 선택해야 합니다. 벤치마크 숫자를 받아들일 때는 어느 모드, 어느 측정 버전인지를 먼저 확인하는 습관이 이번 사례에서 특히 중요합니다.
참고 자료
조사 기준일: 2026년 09월 08일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1
– research.meta.ai — Introducing Muse Spark 1.3 (2026-09-02): https://research.meta.ai/blog/introducing-muse-spark-1-3 — 확인 2026-09-08
– developer.meta.com — Muse Spark 1.3 모델 페이지(가격·변종·컨텍스트·데이터 이용): https://developer.meta.com/ai/models/muse-spark/ — 확인 2026-09-08
– OpenRouter — muse-spark-1.3-contributor(가격·컨텍스트·데이터 이용 고지): https://openrouter.ai/meta/muse-spark-1.3-contributor — 확인 2026-09-08
– research.meta.ai — Muse Spark 1.3 Multimodal Evaluation Methodology (PDF, 존재만 확인·본문 미파싱): https://research.meta.ai/static/muse-spark-1-3-multimodal-evaluation-methodology — 확인 2026-09-08
Tier 2
– Artificial Analysis — “Muse Spark 1.3: Meta reaches the frontier”: https://artificialanalysis.ai/articles/muse-spark-1-3 — 확인 2026-09-08
– Artificial Analysis — 모델 페이지 max / xhigh: https://artificialanalysis.ai/models/muse-spark-1-3 , https://artificialanalysis.ai/models/muse-spark-1-3-xhigh — 조회 2026-09-08
– the-decoder (2026-09-03): https://the-decoder.com/meta-closes-in-on-the-top-with-muse-spark-1-3-and-undercuts-rivals-on-price/ — 확인 2026-09-08
– implicator.ai (2026-09-02): https://www.implicator.ai/meta-muse-spark-1-3-cost-per-task/ — 확인 2026-09-08
– MarkTechPost (2026-09-03): https://www.marktechpost.com/2026/09/03/meta-ai-released-muse-spark-1-3-an-agentic-coding-model-that-uses-20-fewer-tool-calls-and-25-fewer-tokens-than-muse-spark-1-2/ — 확인 2026-09-08
– DataCamp (2026-09-03): https://www.datacamp.com/blog/muse-spark-1-3 — 확인 2026-09-08
– MindStudio (2026-09-05, DeepSWE 리더보드 미등재): https://www.mindstudio.ai/blog/meta-muse-spark-1-3-benchmark-confusion — 확인 2026-09-08
– The Register (2026-09-02, 오픈웨이트): https://www.theregister.com/ai-and-ml/2026/09/02/zucks-muse-to-spark-joy-with-open-weights-release-soon/5294093 — 확인 2026-09-08
– Axios (2026-09-02) HTTP 403 — 대조 못 함
– Bloomberg (2026-09-02) 유료 — 대조 못 함
답글 남기기