
나델라가 2026년 10월 10일 공개한 AI 모델 내부자 위험 7원칙을 통제 구조로 풀었습니다. Agent 365·Entra·Purview·MXC로 지금 구현되는 범위와 남은 공백을 2026년 10월 기준으로 정리했습니다.
AI 보안 개요
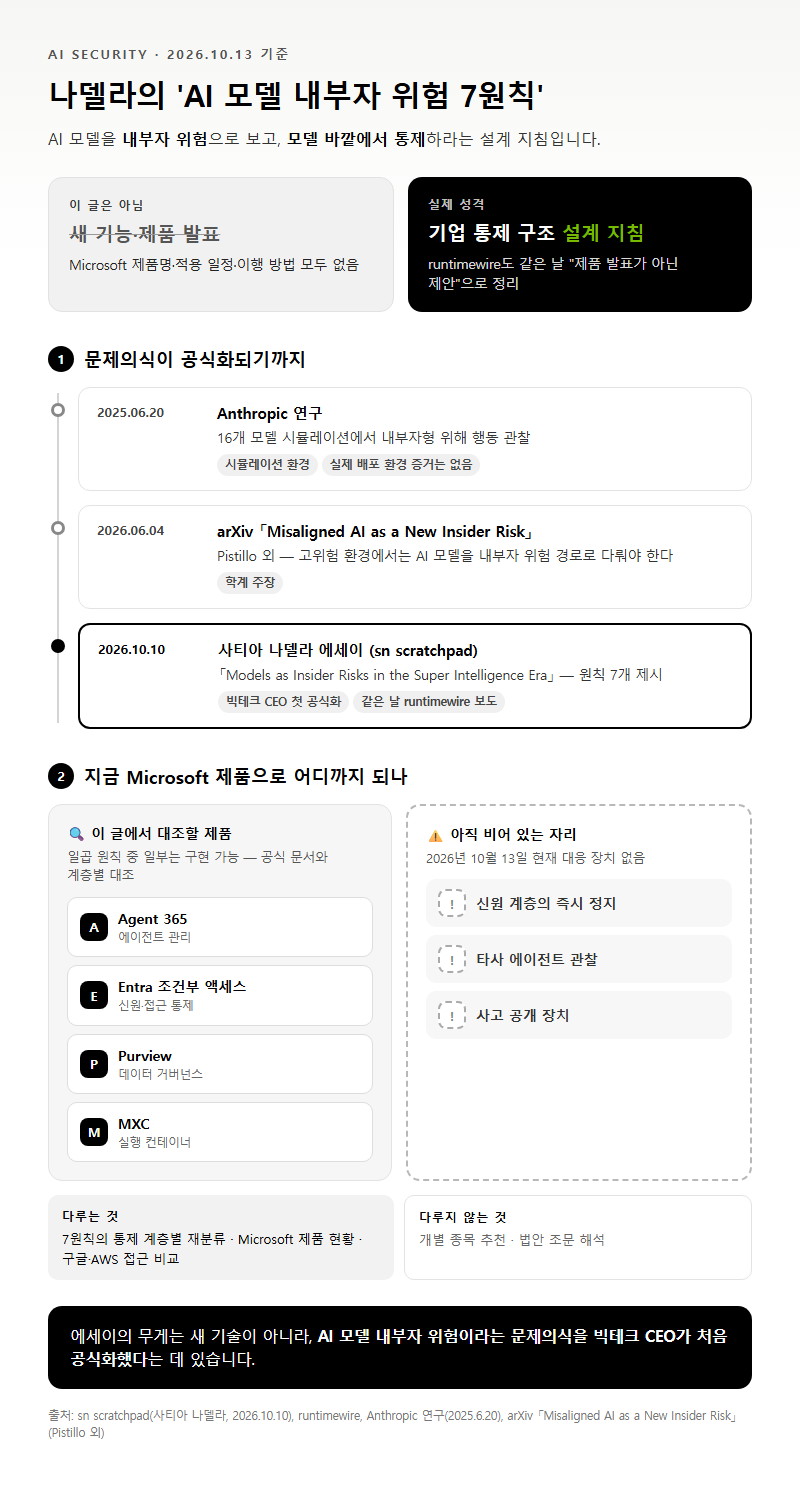
나델라의 AI 모델 내부자 위험 7원칙은 새 기능 발표가 아닙니다. AI 모델을 내부자 위험으로 보고 모델 바깥에서 통제하라는 설계 지침입니다. 2026년 10월 13일 현재 Microsoft 제품으로 구현할 수 있는 건 이 중 일부입니다. 신원 계층의 즉시 정지, 타사 에이전트 관찰, 사고 공개 장치는 아직 비어 있습니다.
근거부터 보겠습니다. 사티아 나델라는 2026년 10월 10일 개인 블로그 sn scratchpad에 「Models as Insider Risks in the Super Intelligence Era」라는 에세이를 올리고 원칙 7개를 제시했습니다. 그런데 에세이에는 Microsoft 제품명도, 적용 일정도, 이행 방법도 없습니다. runtimewire도 같은 날 보도에서 이 글을 제품 발표가 아닌, 기업 통제 구조를 다룬 제안으로 정리했습니다.
이 글은 일곱 원칙을 통제 계층별로 다시 나눕니다. 계층마다 대응하는 Microsoft 제품(Agent 365, Entra 조건부 액세스, Purview, 실행 컨테이너 MXC)이 지금 어디까지 왔는지 공식 문서와 대조하고, 구글·AWS가 같은 문제를 어떻게 푸는지도 비교합니다. 개별 종목 추천과 법안 조문 해석은 다루지 않습니다.
왜 지금 이 주제인지도 짚어 둡니다. Anthropic은 2025년 6월 20일 연구에서 16개 모델을 시뮬레이션해 내부자형 위해 행동을 관찰했습니다. 실제 배포 환경에서는 그런 증거를 보지 못했다고 밝혔습니다. 2026년 6월 4일 arXiv에 올라온 「Misaligned AI as a New Insider Risk」(Pistillo 외)도 고위험 환경에서는 AI 모델을 내부자 위험 경로로 다뤄야 한다고 주장했습니다. 나델라 에세이의 무게는 이 문제의식을 빅테크 CEO가 처음 공식화했다는 데 있습니다.
1. 나델라 7원칙의 핵심은 ‘모델을 믿지 말고 구조를 믿어라’
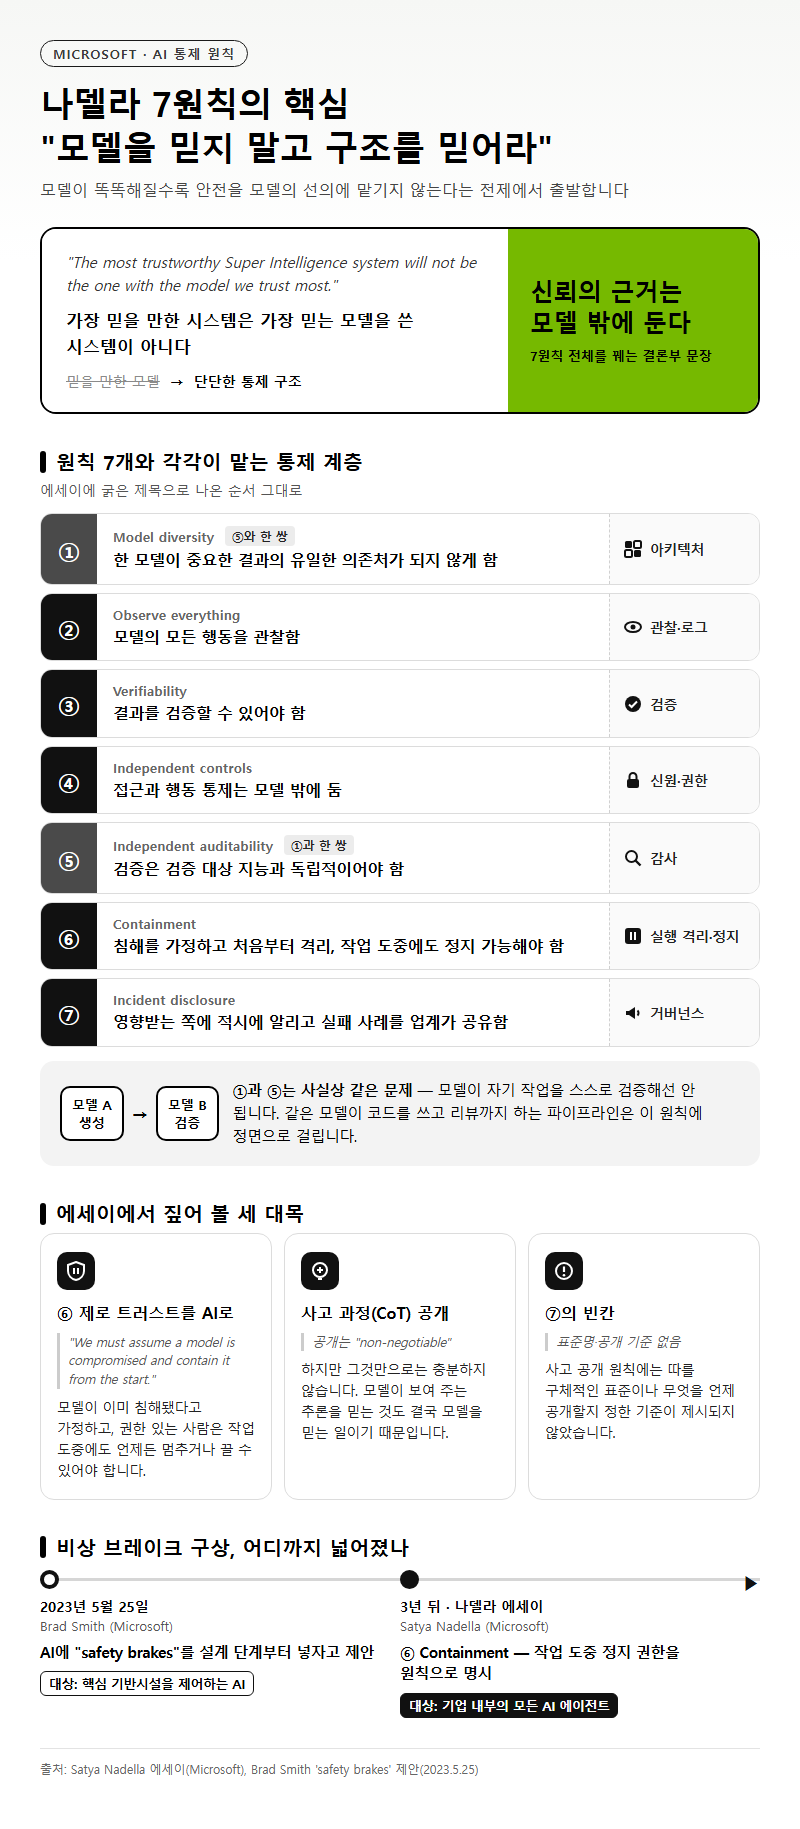
일곱 원칙을 꿰는 문장은 에세이 결론부에 있습니다. 나델라는 “The most trustworthy Super Intelligence system will not be the one with the model we trust most.”라고 썼습니다. 가장 믿을 만한 시스템은 가장 믿는 모델을 쓴 시스템이 아니라 통제 구조가 단단한 시스템이라는 말입니다. 모델이 똑똑해질수록 안전을 모델의 선의에 맡겨선 안 된다는 전제가 깔려 있습니다.
아래 표는 에세이에 굵은 제목으로 나온 원칙 7개를 순서대로 옮겼습니다.
| 번호 | 원문 제목 | 핵심 내용 | 통제 계층 |
|---|---|---|---|
| ① | Model diversity | 한 모델이 중요한 결과의 유일한 의존처가 되지 않게 함 | 아키텍처 |
| ② | Observe everything | 모델의 모든 행동을 관찰함 | 관찰·로그 |
| ③ | Verifiability | 결과를 검증할 수 있어야 함 | 검증 |
| ④ | Independent controls | 접근과 행동 통제는 모델 밖에 둠 | 신원·권한 |
| ⑤ | Independent auditability | 검증은 검증 대상 지능과 독립적이어야 함 | 감사 |
| ⑥ | Containment | 침해를 가정하고 처음부터 격리하며, 작업 도중에도 정지 가능해야 함 | 실행 격리·정지 |
| ⑦ | Incident disclosure | 영향받는 쪽에 적시에 알리고 실패 사례를 업계가 공유함 | 거버넌스 |
①과 ⑤는 사실상 같은 문제입니다. 모델이 자기 작업을 스스로 검증해선 안 된다는 것. 생성한 모델과 다른 지능이 검증해야 감사가 의미를 갖습니다. 같은 모델이 코드를 쓰고 리뷰까지 하는 파이프라인은 이 원칙에 정면으로 걸립니다.
가장 강한 문장은 ⑥에 있습니다. 나델라는 “We must assume a model is compromised and contain it from the start.”라고 썼고, 비상 정지를 두고는 “An authorized person should always be able to pause or shut down a model mid-task.”라고 했습니다. 모델이 이미 침해됐다고 가정하는 제로 트러스트 사고방식을 AI에 그대로 옮겨 온 셈입니다.
사고 과정의 투명성도 나옵니다. 에세이는 모델의 사고 과정(CoT) 공개가 “non-negotiable”이라면서도 그것만으로는 충분하지 않다고 덧붙였습니다. 모델이 보여주는 추론을 믿는 것 역시 결국 모델을 믿는 일이라서입니다. ⑦ 사고 공개 원칙에는 구체적인 표준명이나 공개 기준이 없습니다.
이런 발상이 Microsoft에서 처음 나온 건 아닙니다. 2023년 5월 25일 Brad Smith는 핵심 기반시설을 제어하는 AI에 “safety brakes”를 설계 단계부터 넣자고 제안했습니다. 3년 전의 비상 브레이크 구상이 이번에는 기업 내부의 모든 AI 에이전트로 범위를 넓혔습니다.
2. AI 에이전트 내부자 위협 통제 구조는 모델·하네스·외부 통제로 나뉜다
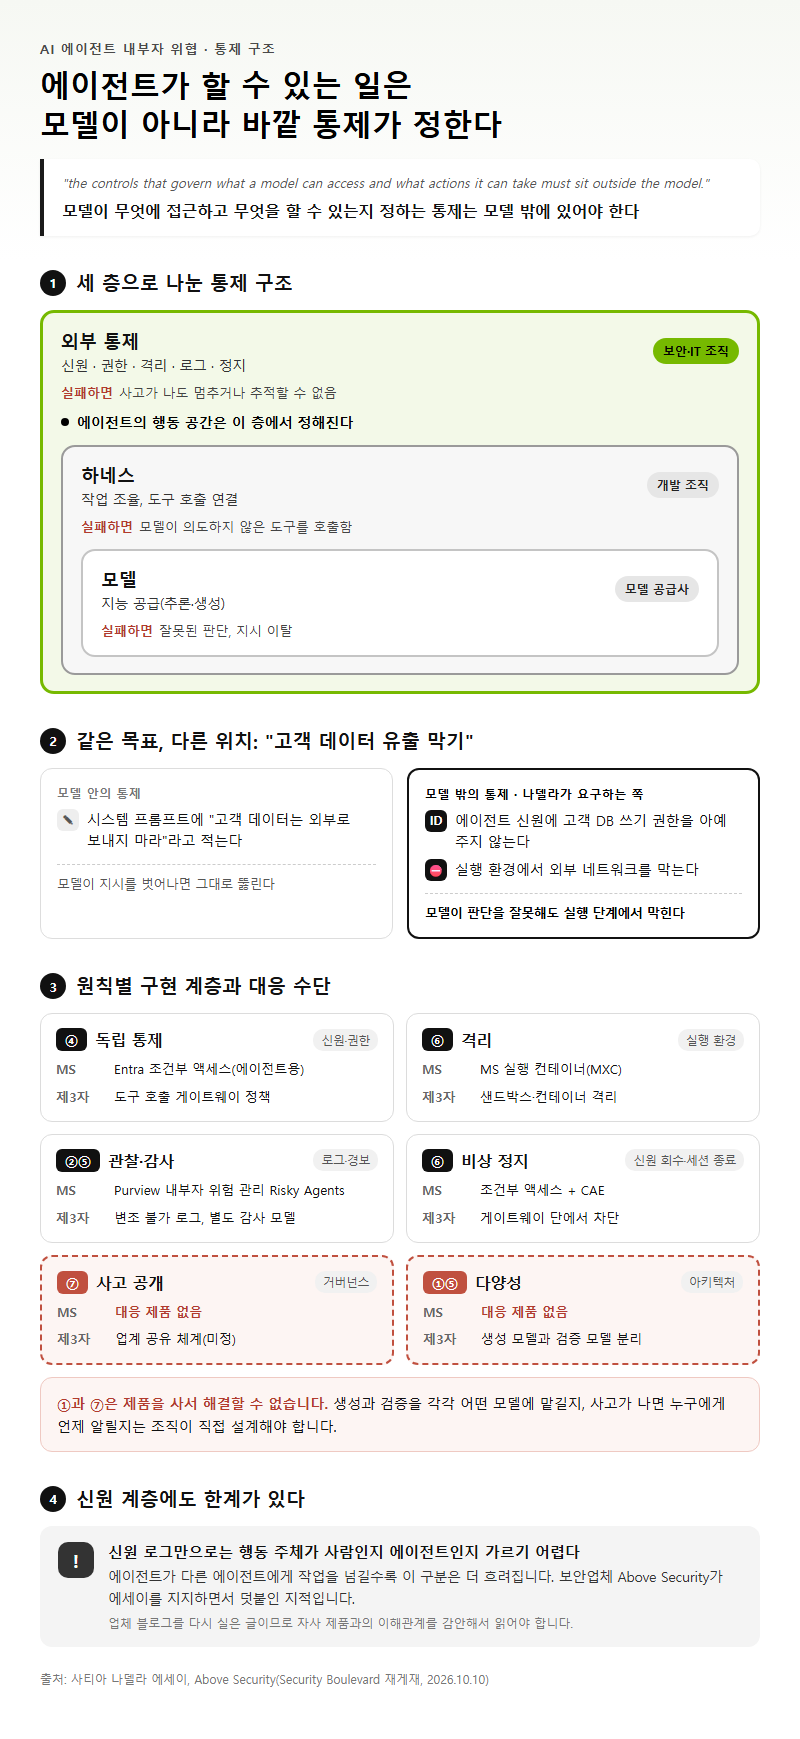
통제 구조를 보여주는 문장은 이것입니다. “the controls that govern what a model can access and what actions it can take must sit outside the model.” 모델이 무엇에 접근하고 무엇을 할 수 있는지 정하는 통제는 모델 밖에 있어야 한다는 뜻입니다. 구조로 옮기면 세 층이 됩니다.
| 층 | 역할 | 누가 쥐는가 | 실패하면 |
|---|---|---|---|
| 모델 | 지능 공급(추론·생성) | 모델 공급사 | 잘못된 판단, 지시 이탈 |
| 하네스 | 작업 조율, 도구 호출 연결 | 개발 조직 | 모델이 의도 밖 도구를 호출함 |
| 외부 통제 | 신원·권한·격리·로그·정지 | 보안·IT 조직 | 사고가 나도 멈추거나 추적할 수 없음 |
요점은 행동 공간을 모델이 아니라 외부 통제가 정한다는 데 있습니다. 시스템 프롬프트에 “고객 데이터는 외부로 보내지 마라”라고 적으면 모델 안의 통제입니다. 에이전트 신원에 고객 DB 쓰기 권한을 아예 주지 않거나 실행 환경에서 외부 네트워크를 막으면 모델 밖의 통제입니다. 나델라가 요구하는 건 후자입니다.
원칙별 구현 계층에 대응시키면 다음과 같습니다.
| 원칙 | 구현 계층 | Microsoft 쪽 대응 제품 | 제3자 대안 방향 |
|---|---|---|---|
| ④ 독립 통제 | 신원·권한 | Entra 조건부 액세스(에이전트용) | 도구 호출 게이트웨이 정책 |
| ⑥ 격리 | 실행 환경 | MS 실행 컨테이너(MXC) | 샌드박스·컨테이너 격리 |
| ②⑤ 관찰·감사 | 로그·경보 | Purview 내부자 위험 관리 Risky Agents | 변조 불가 로그, 별도 감사 모델 |
| ⑥ 비상 정지 | 신원 회수·세션 종료 | 조건부 액세스 + CAE | 게이트웨이 단 차단 |
| ⑦ 사고 공개 | 거버넌스 | 대응 제품 없음 | 업계 공유 체계(미정) |
| ①⑤ 다양성 | 아키텍처 | 대응 제품 없음 | 생성 모델과 검증 모델 분리 |
눈여겨볼 곳은 비어 있는 마지막 두 줄입니다. ①과 ⑦은 제품을 사서 해결할 수 없는 구조적 결정입니다. 어떤 모델에 생성을, 어떤 모델에 검증을 맡길지, 사고가 나면 누구에게 언제 알릴지는 조직마다 직접 설계해야 합니다.
신원 계층에도 한계가 있습니다. 보안업체 Above Security는 2026년 10월 10일 Security Boulevard에 다시 실린 글에서 에세이를 지지하면서도, 신원 로그만으로는 행동 주체가 사람인지 에이전트인지 가르기 어렵다고 지적했습니다. 에이전트가 다른 에이전트에게 작업을 넘길수록 이 구분은 더 흐려집니다. 업체 블로그를 옮긴 글이니 자사 제품과의 이해관계는 감안하고 읽어야 합니다.
용어 풀이
1. 하네스(harness) — 모델에 도구를 연결하고 작업 순서를 조율하는 실행 틀로, 모델 자체와 분리된 계층입니다.
2. 행동 공간 — 에이전트가 실제로 실행할 수 있는 동작의 범위로, 권한·네트워크·파일 접근으로 정해집니다.
3. CoT(Chain of Thought) — 모델이 답을 내기 전에 거치는 단계별 추론 과정을 텍스트로 드러낸 것입니다.
3. MS 제품으로 지금 되는 것과 안 되는 것 (2026년 10월 13일 기준)
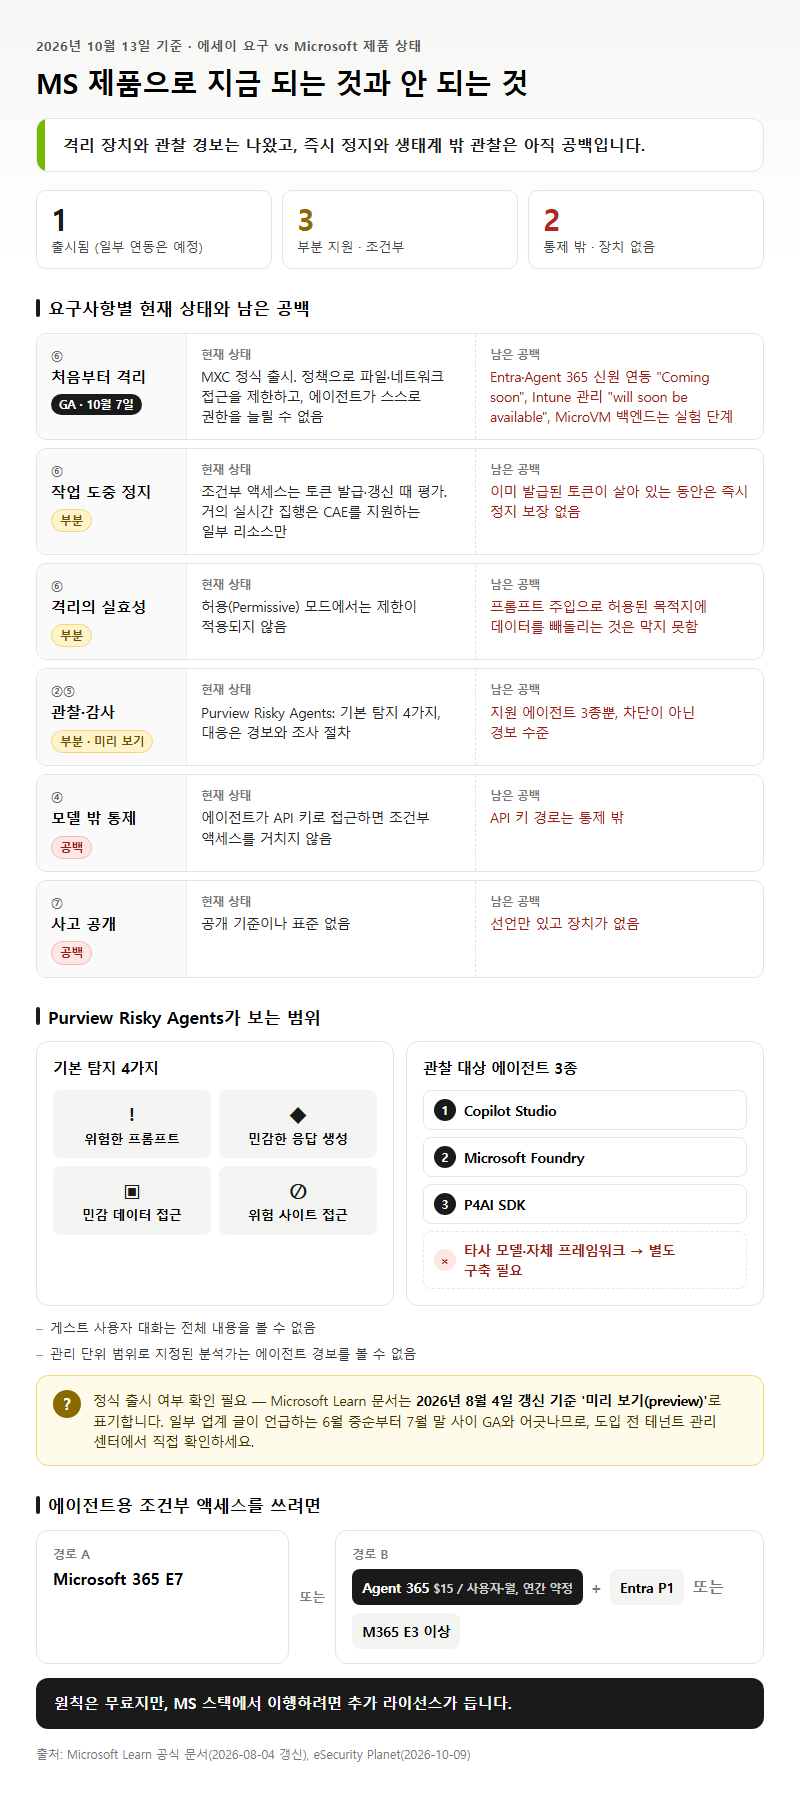
결론부터 말하면 격리 장치와 관찰 경보는 나왔고, 즉시 정지와 생태계 밖 관찰은 아직 공백입니다. 에세이의 요구와 공식 문서에 적힌 제품 상태를 나란히 놓으면 차이가 분명합니다.
| 에세이 요구 | 제품의 현재 상태 | 남은 공백 |
|---|---|---|
| ⑥ 작업 도중 정지 | Entra 조건부 액세스는 토큰 발급·갱신 때 평가. 거의 실시간 집행은 CAE를 지원하는 일부 리소스만 가능 | 이미 발급된 토큰이 살아 있는 동안은 즉시 정지가 보장되지 않음 |
| ④ 모델 밖 통제 | 에이전트가 API 키로 접근하면 조건부 액세스를 거치지 않음 | API 키 경로는 통제 밖 |
| ⑥ 처음부터 격리 | MXC 2026년 10월 7일 GA. 정책으로 파일·네트워크 접근을 제한하고, 에이전트가 스스로 권한을 늘릴 수 없음 | Entra·Agent 365 신원 연동은 “Coming soon”, Intune 관리는 “will soon be available”, MicroVM 백엔드는 실험 단계 |
| ⑥ 격리의 실효성 | 허용(Permissive) 모드는 제한을 적용하지 않음 | 프롬프트 주입으로 허용된 목적지에 데이터를 빼돌리는 것은 막지 못함(eSecurity Planet 2026년 10월 9일) |
| ②⑤ 관찰·감사 | Purview Risky Agents: 기본 탐지 4가지, 대응은 경보와 조사 절차 | 지원 에이전트가 3종뿐이고, 차단이 아니라 경보 수준 |
| ⑦ 사고 공개 | 공개 기준이나 표준 없음 | 선언만 있고 장치가 없음 |
Purview Risky Agents가 기본으로 잡는 항목은 위험한 프롬프트, 민감한 응답 생성, 민감 데이터 접근, 위험 사이트 접근 네 가지입니다. 지원 대상은 Copilot Studio, Microsoft Foundry, P4AI SDK로 만든 에이전트 세 종류뿐입니다. 타사 모델이나 자체 프레임워크로 만든 에이전트는 이 정책으로 관찰되지 않으니 따로 구축해야 합니다. 게스트 사용자 대화는 전체 내용을 볼 수 없고, 관리 단위 범위로 지정된 분석가는 에이전트 경보를 볼 수 없다는 제약도 문서에 있습니다.
정식 출시 여부도 확인이 필요합니다. Microsoft Learn 문서는 2026년 8월 4일 갱신 기준으로 이 기능을 ‘미리 보기(preview)’로 표기합니다. 일부 업계 글은 Message Center 공지를 근거로 2026년 6월 중순부터 7월 말 사이 GA를 언급하지만, 회사 공식 문서의 표기와 어긋납니다. 도입 전에 테넌트 관리 센터에서 실제 상태를 직접 확인하는 편이 안전합니다.
비용 문제도 있습니다. 에이전트용 조건부 액세스를 쓰려면 Microsoft 365 E7을 쓰거나, Agent 365에 Entra P1 또는 M365 E3 이상을 함께 갖춰야 합니다. 원칙은 무료지만 MS 스택에서 이행하려면 추가 라이선스가 듭니다.
| 상품 | 가격(사용자당 월, 연간 약정) | 비고 |
|---|---|---|
| Agent 365 | $15 | 2026년 5월 1일 GA. 소개 문구에 “위험 에이전트 차단” 포함 |
| Microsoft 365 E7 | $99 | 에이전트용 조건부 액세스 단독 충족 |
| Microsoft 365 E7(Teams 제외) | $90.45 | 동일 |
가격은 2026년 10월 13일 microsoft.com 기준이며, 국가·계약 형태에 따라 실제 청구액은 달라집니다. Agent 365를 고른다면 Entra P1 또는 E3 이상을 이미 갖췄는지에 따라 실제 추가 비용이 갈립니다.
용어 풀이
1. 조건부 액세스 — 사용자나 에이전트가 리소스에 접근할 때 위치·위험도 같은 조건을 따져 허용 여부를 정하는 Entra 정책입니다.
2. CAE(지속적 액세스 평가) — 토큰 만료를 기다리지 않고 위험 신호가 생기면 접근을 거의 즉시 끊는 기능으로, 지원 리소스가 한정돼 있습니다.
3. 프롬프트 주입 — 문서나 웹페이지에 숨긴 지시문으로 모델을 속여 의도하지 않은 행동을 하게 만드는 공격입니다.
4. 구글·AWS는 ‘모델 밖 통제’를 어느 계층에 두나
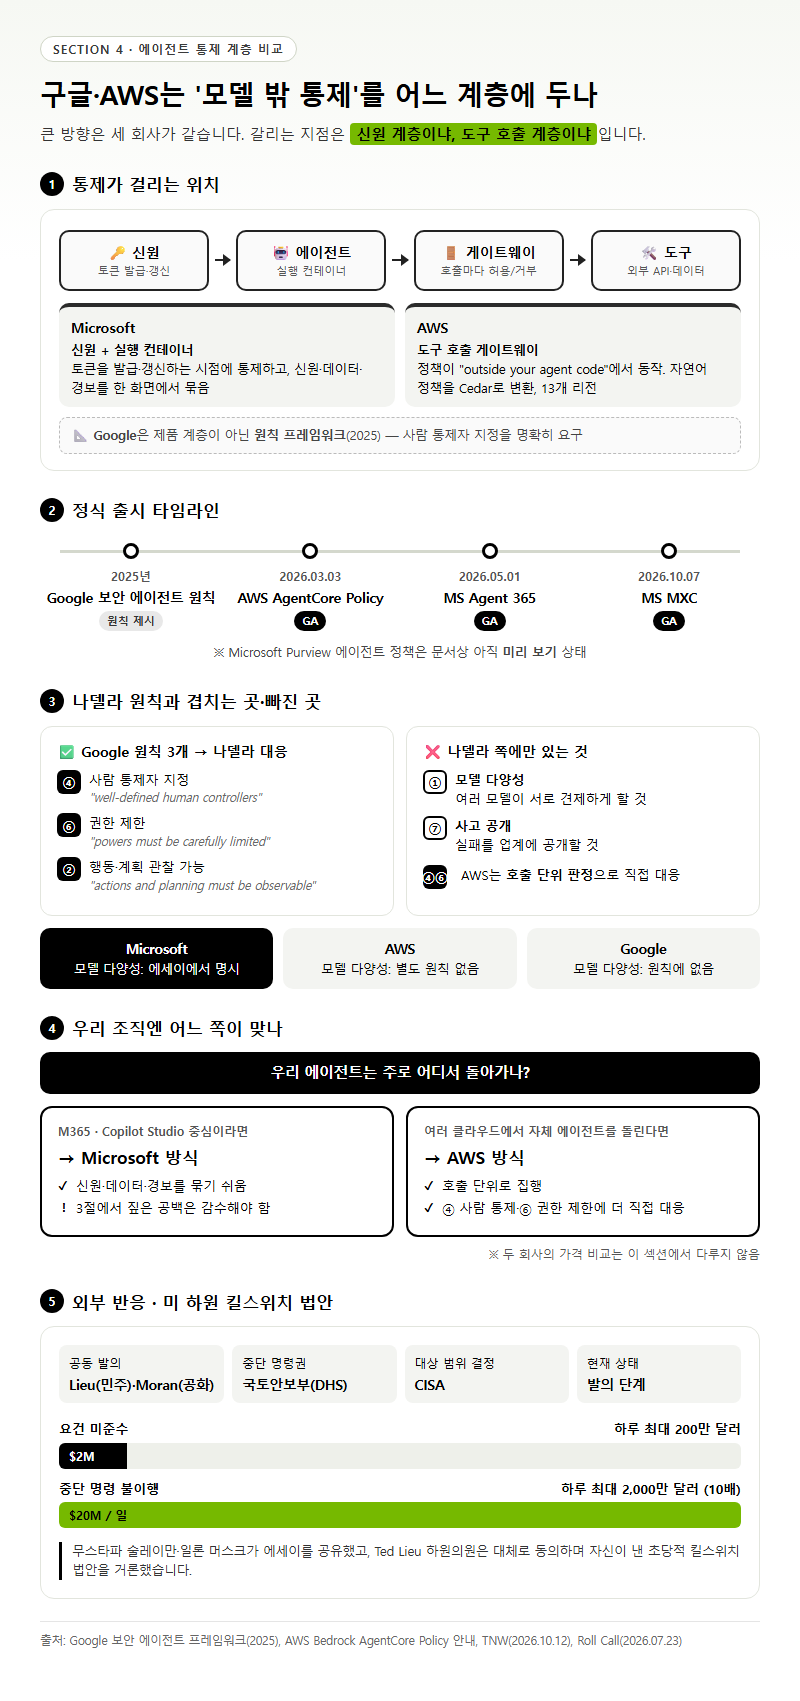
큰 방향은 세 회사가 같습니다. 갈리는 지점은 통제를 신원 계층에 두느냐, 도구 호출 계층에 두느냐입니다.
구글은 2025년 보안 에이전트 프레임워크에서 원칙 세 가지를 내놨습니다. “agents must have well-defined human controllers”, “their powers must be carefully limited”, “their actions and planning must be observable”. 차례로 나델라의 ④·⑥·②에 해당합니다. 나델라 쪽에만 있는 것은 ① 모델 다양성과 ⑦ 사고 공개입니다. 여러 모델이 서로 견제하게 하고 실패를 업계에 공개하라는 요구는 구글 프레임워크에 없습니다.
AWS는 이미 제품을 냈습니다. Bedrock AgentCore Policy는 2026년 3월 3일 GA가 됐고, 정책이 “outside your agent code”에서 동작한다고 설명합니다. 게이트웨이가 에이전트와 도구 사이의 호출을 매번 허용 또는 거부합니다. 자연어로 쓴 정책은 Cedar 정책 언어로 변환되며, 13개 리전에서 쓸 수 있습니다.
| 항목 | Microsoft | AWS | |
|---|---|---|---|
| 통제 위치 | 신원(토큰 발급·갱신 시점) + 실행 컨테이너 | 도구 호출 게이트웨이(호출마다) | 원칙 프레임워크 |
| 정식 출시 상태 | Agent 365 GA(2026년 5월 1일), MXC GA(2026년 10월 7일), Purview 에이전트 정책은 문서상 미리 보기 | AgentCore Policy GA(2026년 3월 3일) | 원칙 제시(2025년) |
| 모델 다양성 요구 | 에세이에서 명시 | 별도 원칙 없음 | 원칙에 없음 |
| 강점 | 신원·데이터·경보를 한 화면에서 묶음 | 호출 단위로 판정해 ④·⑥에 직접 대응 | 사람 통제자 지정을 명확히 요구 |
어느 쪽이 맞는지는 조직 구성에 달렸습니다. M365와 Copilot Studio가 중심이라면 MS 쪽이 신원·데이터·경보를 묶기 쉽습니다. 대신 3절의 공백은 감수해야 합니다. 여러 클라우드에서 자체 에이전트를 돌린다면 호출 단위로 집행하는 AWS 방식이 ④·⑥에 더 직접 대응합니다. 두 회사의 가격 비교는 여기서 다루지 않습니다.
외부 반응도 정리해 둡니다. TNW는 2026년 10월 12일 보도에서 무스타파 술레이만과 일론 머스크가 이 글을 공유했고, Ted Lieu 하원의원이 대체로 동의하며 자신이 낸 초당적 킬스위치 법안을 거론했다고 전했습니다. Roll Call 2026년 7월 23일 보도를 보면 이 법안은 Lieu(민주)와 Moran(공화)이 공동 발의했습니다. 중단 명령권은 국토안보부(DHS)가 갖고, 대상 범위는 CISA가 정합니다. 벌금은 요건 미준수 시 하루 최대 200만 달러, 중단 명령 불이행 시 하루 최대 2,000만 달러이며, 아직 발의 단계입니다. TNW는 에세이에 격리와 변조 불가 로그를 구현하는 방법, 비상 정지를 누가 어떻게 거는지가 빠져 있다는 점도 짚었습니다.
5. 도입 판단 FAQ, AI 보안 관련주 질문부터 체크리스트까지
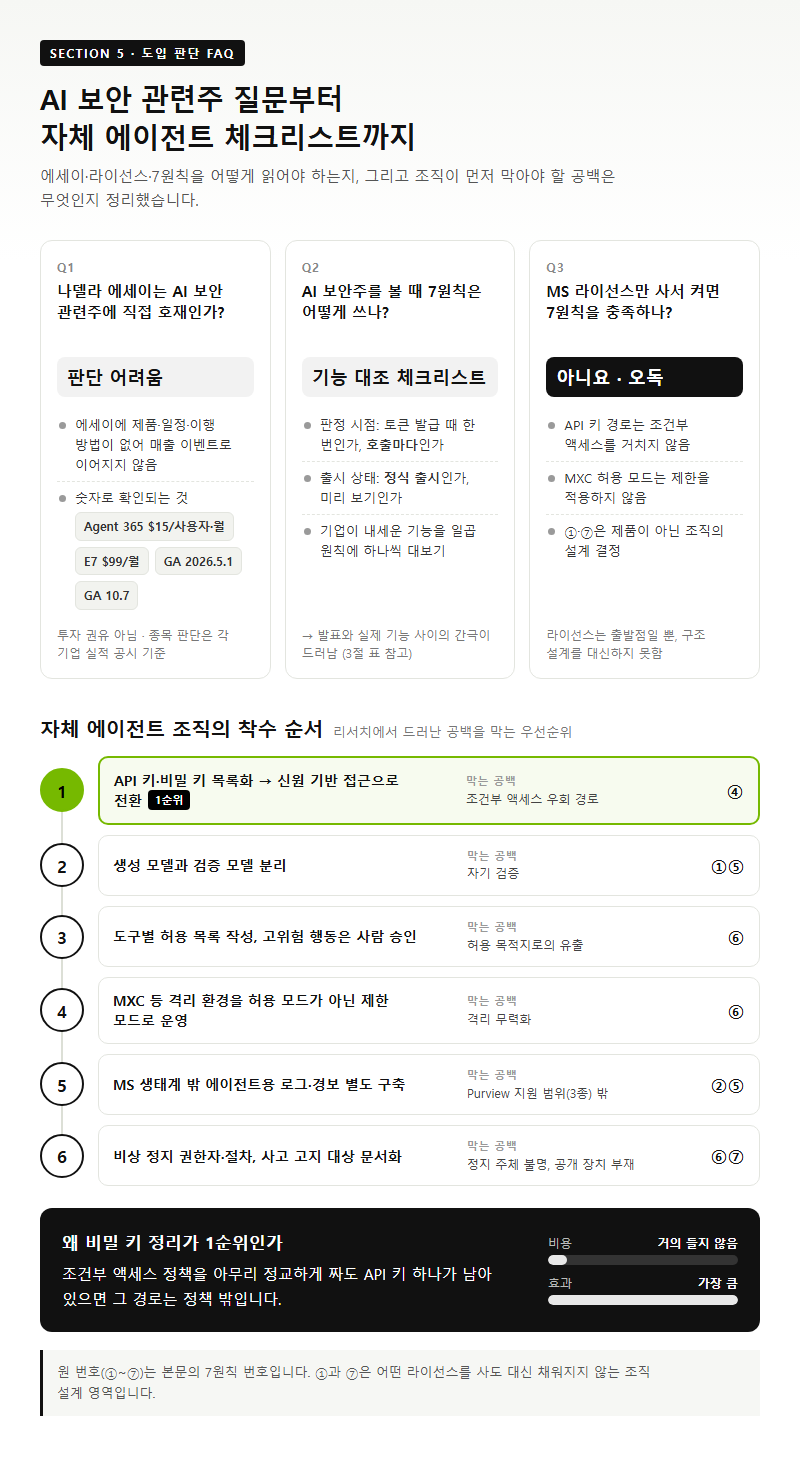
Q. 나델라 에세이는 AI 보안 관련주에 직접 호재인가요?
에세이만으로는 판단하기 어렵습니다. 글에 제품·일정·이행 방법이 하나도 없어 특정 매출 이벤트로 이어지지 않습니다. 숫자로 확인되는 건 Agent 365 사용자당 월 $15, E7 월 $99 같은 라이선스 가격과 2026년 5월 1일, 10월 7일 같은 GA 일정 정도입니다. 이 글은 투자 권유가 아니며, 종목 판단은 각 기업의 실적 공시를 기준으로 하는 것이 맞습니다.
Q. AI 보안주나 AI 보안 주식을 볼 때 7원칙을 어떻게 쓸 수 있나요?
기업이 내세우는 기능을 일곱 원칙에 하나씩 대보는 체크리스트로 쓰면 됩니다. 가령 “에이전트 통제”를 내건 제품이 토큰 시점에만 판정하는지 호출마다 판정하는지, 정식 출시인지 미리 보기인지 따져 보면 발표와 실제 기능 사이의 간극이 드러납니다. 3절의 표가 그 대조 예시입니다.
Q. MS 라이선스만 사서 켜면 7원칙을 충족하나요?
아닙니다. 그렇게 읽으면 오독입니다. API 키 경로는 조건부 액세스를 거치지 않고, MXC 허용 모드는 제한을 적용하지 않습니다. ①과 ⑦은 제품이 아니라 조직의 설계 결정입니다. 라이선스는 출발점일 뿐 구조 설계를 대신하지 못합니다.
Q. 자체 에이전트를 쓰는 조직은 어디서부터 손대야 하나요?
아래 순서를 권합니다. 리서치에서 드러난 공백을 막는 우선순위입니다.
| 순서 | 할 일 | 막는 공백 | 관련 원칙 |
|---|---|---|---|
| 1 | 에이전트가 쓰는 API 키·비밀 키를 목록화하고 신원 기반 접근으로 전환 | 조건부 액세스 우회 경로 | ④ |
| 2 | 생성 모델과 검증 모델을 분리 | 자기 검증 | ①⑤ |
| 3 | 도구별 허용 목록 작성, 고위험 행동은 사람 승인 | 허용 목적지로의 유출 | ⑥ |
| 4 | MXC 등 격리 환경을 허용 모드가 아닌 제한 모드로 운영 | 격리 무력화 | ⑥ |
| 5 | MS 생태계 밖 에이전트용 로그·경보 별도 구축 | Purview 지원 범위(3종) 밖 | ②⑤ |
| 6 | 비상 정지 권한자와 절차, 사고 고지 대상을 문서화 | 정지 주체 불명, 공개 장치 부재 | ⑥⑦ |
비밀 키 정리가 1순위인 이유는 단순합니다. 조건부 액세스 정책을 아무리 정교하게 짜도 API 키 하나가 남아 있으면 그 경로는 정책 밖입니다. 돈은 거의 들지 않는데 효과는 가장 큰 작업입니다.
정리
나델라의 7원칙은 AI 모델을 권한이 센 내부자로 보고, 모델이 아니라 그 바깥의 통제 구조를 믿으라는 설계 지침입니다. 2026년 10월 13일 기준 Microsoft는 격리(MXC GA)와 관찰 경보(Purview, 문서상 미리 보기)를 내놨습니다. 신원 계층의 즉시 정지, API 키 경로 통제, 생태계 밖 에이전트 관찰, 사고 공개 장치는 여전히 비어 있습니다. 도입을 검토하는 조직이라면 라이선스 구매보다 비밀 키 정리와 생성·검증 모델 분리를 먼저 하는 것이 원칙에 가장 싸고 빠르게 다가가는 길입니다.
참고 자료
조사 기준일: 2026년 10월 13일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (모두 2026-10-13 확인)
– https://snscratchpad.com/posts/models-as-insider-risks/
– https://learn.microsoft.com/en-us/purview/insider-risk-management-monitoring-agents
– https://learn.microsoft.com/en-us/entra/identity/conditional-access/agent-id
– https://www.microsoft.com/en-us/microsoft-agent-365
– https://techcommunity.microsoft.com/discussions/agent-365-discussions/agent-365-will-be-generally-available-on-may-1-2026/4500380
– https://blogs.windows.com/windowsdeveloper/2026/10/07/microsoft-execution-containers-policy-driven-containment-for-ai-agents/
– https://blogs.microsoft.com/on-the-issues/2023/05/25/how-do-we-best-govern-ai/
– https://aws.amazon.com/about-aws/whats-new/2026/03/policy-amazon-bedrock-agentcore-generally-available/
– https://research.google/pubs/an-introduction-to-googles-approach-for-secure-ai-agents/
– https://www.anthropic.com/research/agentic-misalignment
– https://arxiv.org/abs/2606.06028
– https://thenextweb.com/news/nadella-ai-models-insider-risks-emergency-brake
– https://www.techzine.eu/news/security/144904/nadella-treat-ai-models-as-internal-threats/
– https://runtimewire.com/article/satya-nadella-emergency-brake-enterprise-ai
– https://rollcall.com/2026/07/23/ai-companies-would-need-kill-switch-under-new-bipartisan-bill/
– https://www.esecurityplanet.com/endpoint-security/news-microsoft-execution-containers-for-ai-agents-reach-ga/
– https://securityboulevard.com/2026/10/satya-nadella-is-right-we-need-to-treat-ai-models-as-insider-risks/ (업체 블로그 재게재)
– https://madrobot.blog/2026/10/10/satya-nadella-ai-models-insider-risks-emergency-brake-assume-compromised/ (인용 교차 대조용)
답글 남기기