
OpenAI·Google·Microsoft·Anthropic이 지지한 robots.txt AI 학습 거부 토큰 __usage_ai-training의 문법, 회사별 적용 시점, 와일드카드 함정, GPTBot·Google-Extended 설정과 함께 쓰는 법을 2026년 11월 기준으로 정리했습니다.
이 글에는 네이버 브랜드커넥트 제휴 링크가 포함되어 있습니다. 링크를 통해 구매가 이루어지면 작성자가 일정액의 수수료를 지급받습니다. 제품 선택과 구매는 독자의 판단이며, 이 글은 특정 제품의 효과를 보증하지 않습니다.
오픈AI 개요
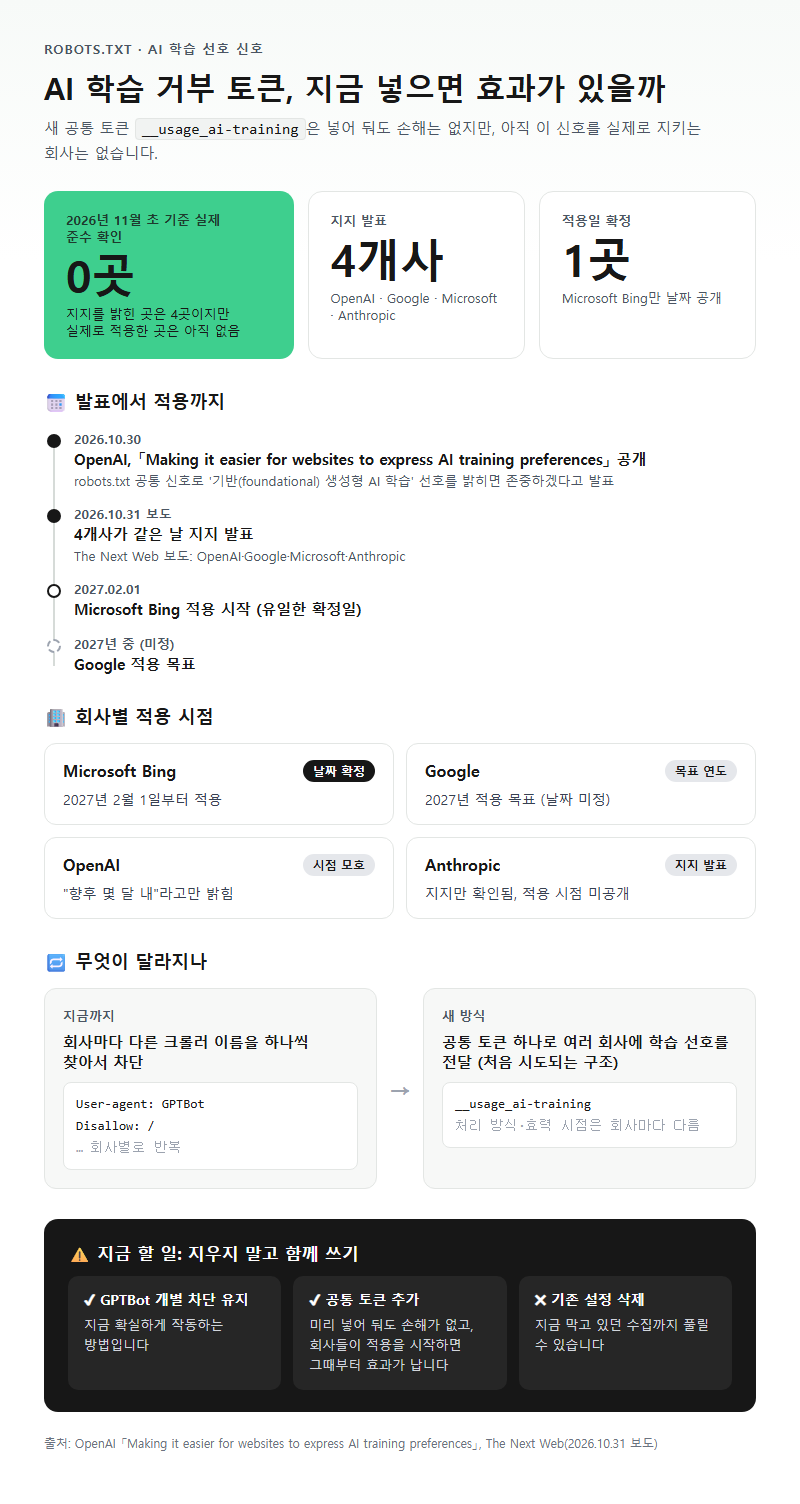
robots.txt에 AI 학습 거부 토큰을 지금 넣어 둬도 손해는 없습니다. 다만 2026년 11월 초 기준으로 이 신호를 실제로 지키는 회사는 확인되지 않습니다. 적용 시작일을 정한 곳은 Microsoft Bing(2027년 2월 1일) 하나뿐입니다. Google은 2027년을 목표로 잡았고, OpenAI는 “향후 몇 달 내”라고만 밝혔습니다. 이 글에서는 새 토큰 __usage_ai-training의 문법과 회사별 처리 방식을 살피고, 지금 확실하게 작동하는 GPTBot 개별 차단과 이 토큰을 어떻게 함께 쓸지 정리합니다. 법적 효력 해석이나 이미 수집된 데이터를 삭제하는 절차는 다루지 않습니다.
발단은 OpenAI가 공개한 「Making it easier for websites to express AI training preferences」입니다. OpenAI는 이 글에서 웹사이트가 robots.txt에 넣는 공통 신호 하나로 ‘기반(foundational) 생성형 AI 학습’ 선호를 밝히면 이를 존중하겠다고 했습니다. The Next Web 2026년 10월 31일 보도에 따르면 같은 날 OpenAI·Google·Microsoft·Anthropic 네 회사가 지지를 발표했습니다. 이 보도들은 OpenAI 발표일을 2026년 10월 30일로 전합니다.
그동안 사이트 운영자는 회사마다 다른 크롤러 이름을 하나씩 찾아 막아야 했습니다. 공통 토큰 하나로 여러 회사에 학습 선호를 전달하는 구조는 이번이 처음입니다. 하지만 그 신호가 무엇을 막고 무엇을 못 막는지, 언제부터 효력이 생기는지는 회사마다 크게 다릅니다. 이 차이를 모른 채 기존 설정을 지우면, 지금 확실하게 막고 있던 수집까지 풀릴 수 있습니다.
1. 새 토큰의 정체와 robots.txt 문법
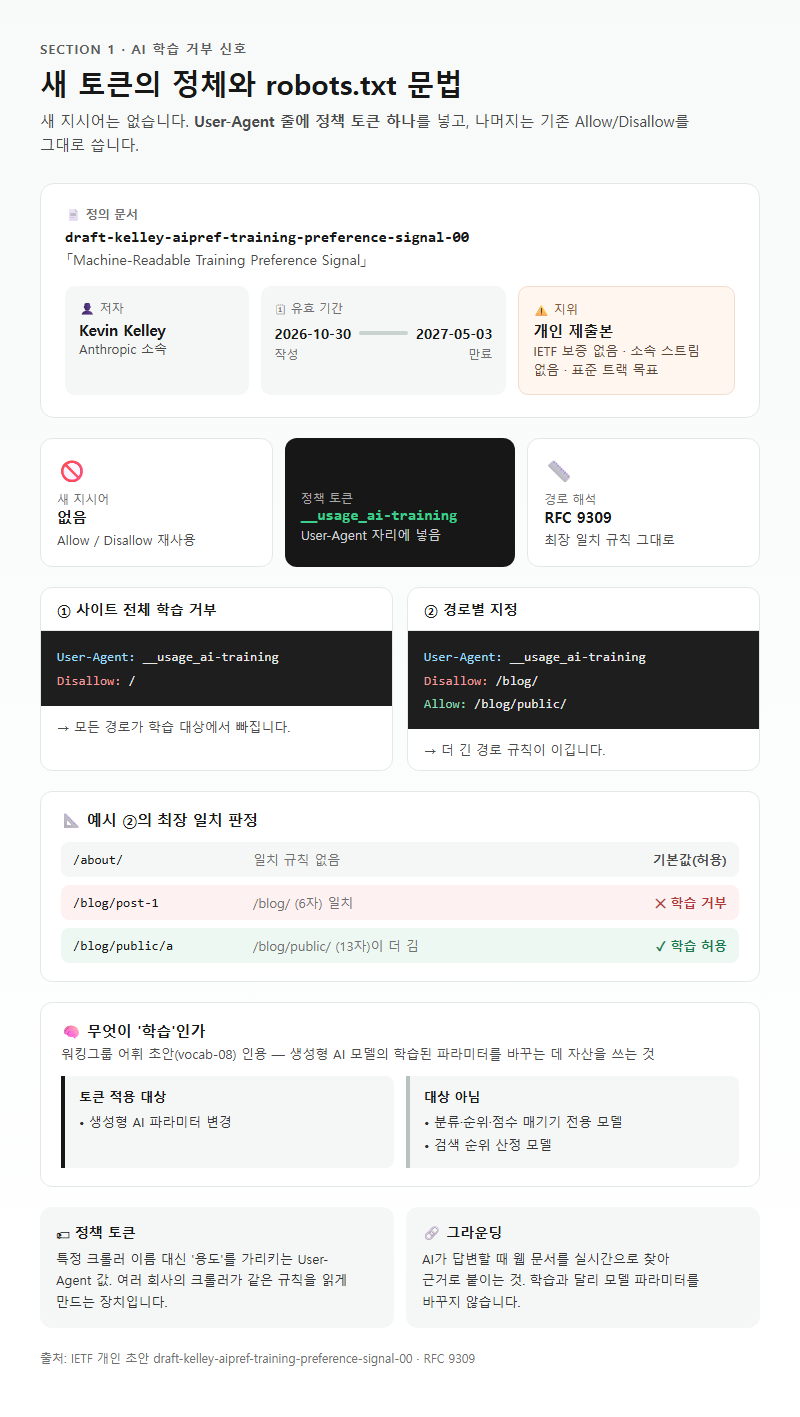
이 신호를 정의한 문서는 IETF 개인 초안 draft-kelley-aipref-training-preference-signal-00이고, 제목은 「Machine-Readable Training Preference Signal」입니다. 저자는 Anthropic 소속 Kevin Kelley, 작성일은 2026년 10월 30일, 만료일은 2027년 5월 3일입니다. 표준 트랙을 목표로 하지만 소속 스트림이 없는 개인 제출본입니다. IETF가 보증하지 않았고 표준 절차상 공식 지위도 없다고 초안에 직접 적혀 있습니다.
| 항목 | 내용 |
|---|---|
| 문서명 | draft-kelley-aipref-training-preference-signal-00 |
| 저자 | Kevin Kelley(Anthropic) |
| 작성일 / 만료일 | 2026-10-30 / 2027-05-03 |
| 지위 | 개인 제출본(IETF 보증 없음) |
| 새 지시어 | 없음 — 기존 Allow/Disallow 재사용 |
| 정책 토큰 | __usage_ai-training |
| 경로 해석 | RFC 9309 최장 일치 규칙 그대로 적용 |
문법은 단순합니다. 새 지시어 없이 User-Agent 줄에 정책 토큰을 넣는 방식입니다. 사이트 전체에서 학습을 거부하려면 User-Agent: __usage_ai-training 아래에 Disallow: /를 쓰면 됩니다. 경로별 지정도 됩니다. Disallow: /blog/와 Allow: /blog/public/을 함께 두면 최장 일치 규칙에 따라 /blog/public/ 아래만 학습 허용으로 해석됩니다.
학습의 정의도 초안에 있습니다. 워킹그룹 어휘 초안(vocab-08)을 인용해, 생성형 AI 모델의 학습된 파라미터를 바꾸는 데 자산을 쓰는 것을 학습으로 봅니다. 분류·순위·점수 매기기에만 쓰는 모델은 빠집니다. 검색 순위 산정에 쓰이는 모델이 이 토큰의 대상이 아닌 이유입니다.
용어 풀이
1. 정책 토큰 — 특정 크롤러 이름 대신 ‘용도’를 가리키는 User-Agent 값으로, 여러 회사의 크롤러가 같은 규칙을 읽도록 만든 장치입니다.
2. 그라운딩 — AI가 답변을 만들 때 웹 문서를 실시간으로 찾아 근거로 붙이는 것으로, 학습과 달리 모델 파라미터를 바꾸지 않습니다.
2. 흔한 오해 — User-Agent: * 전면 차단은 거부로 통하지 않는다
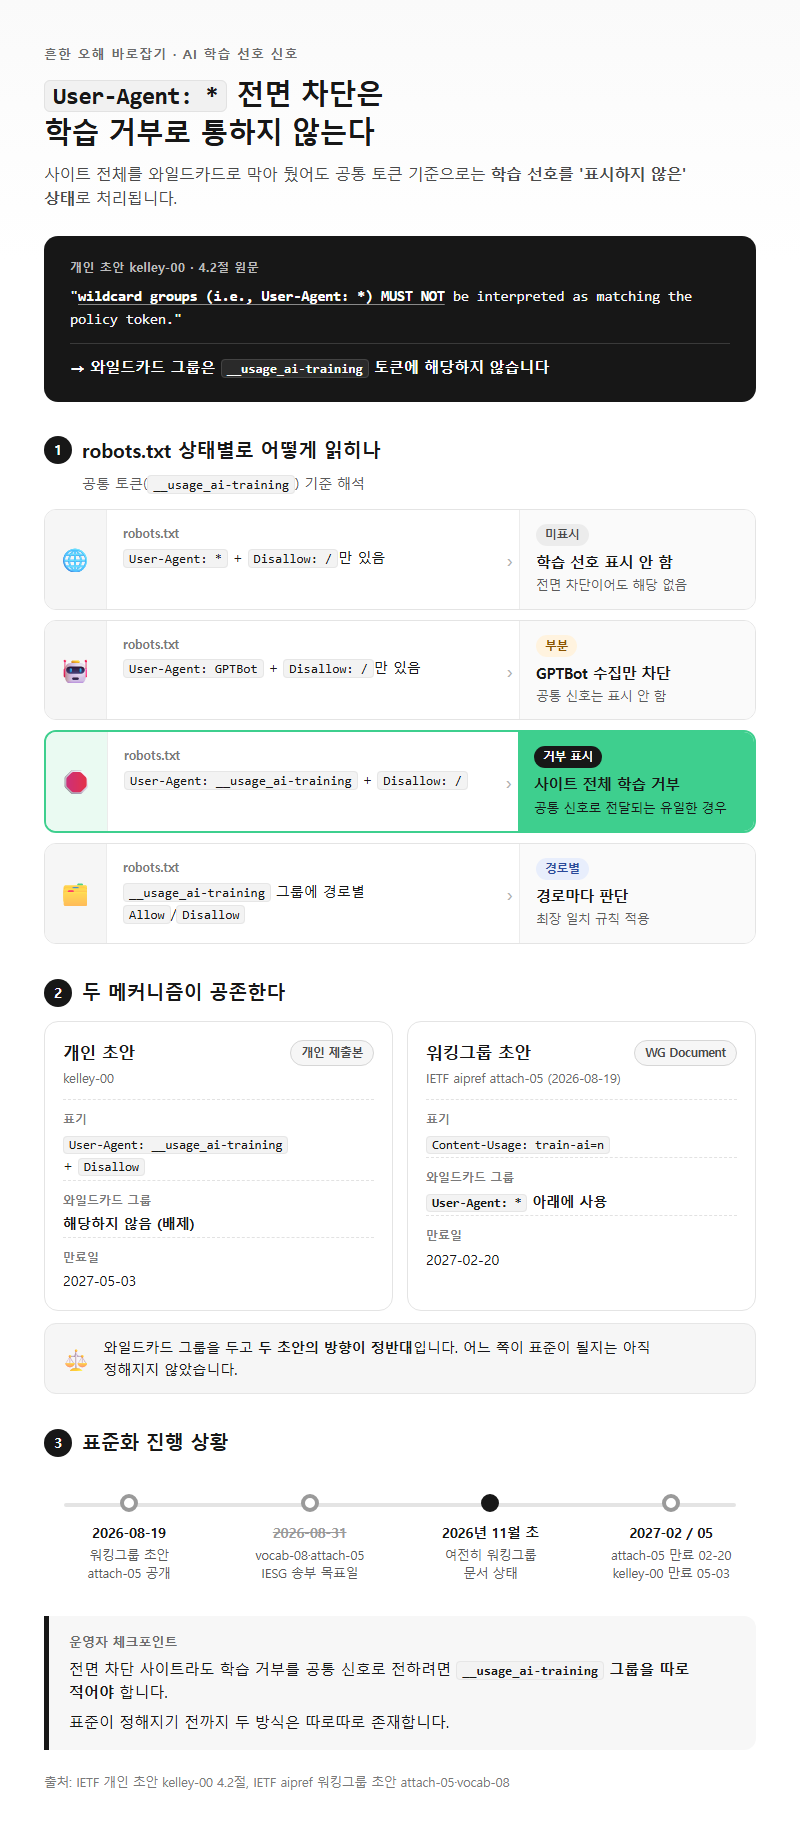
User-Agent: * 아래 Disallow: /로 사이트 전체를 이미 막아 둔 운영자라면 따로 손댈 게 없다고 생각하기 쉽습니다. 초안은 이 해석을 명시적으로 배제합니다. 4.2절 원문은 “wildcard groups (i.e., User-Agent: ) MUST NOT be interpreted as matching the policy token.”입니다. 와일드카드 그룹은 이 토큰에 해당하지 않는다*는 뜻입니다.
robots.txt에 __usage_ai-training 그룹이 없으면 그 사이트는 학습 선호를 ‘표시하지 않은’ 상태로 처리됩니다. 전면 차단 사이트도 학습 거부 의사를 공통 신호로 전하려면 이 그룹을 따로 적어야 합니다.
| robots.txt 상태 | 공통 토큰 기준 해석 |
|---|---|
User-Agent: * + Disallow: /만 있음 |
학습 선호 표시 안 함 |
User-Agent: GPTBot + Disallow: /만 있음 |
GPTBot 수집은 차단, 공통 신호는 표시 안 함 |
User-Agent: __usage_ai-training + Disallow: / |
사이트 전체 학습 거부 표시 |
__usage_ai-training 그룹에 경로별 Allow/Disallow |
경로마다 최장 일치로 판단 |
혼선은 하나 더 있습니다. IETF aipref 워킹그룹의 정식 초안 attach-05(2026년 8월 19일)는 User-Agent: * 아래에 Content-Usage: train-ai=n을 쓰는 방식입니다. 개인 초안은 반대로 와일드카드 그룹을 배제합니다. 두 메커니즘이 공존하고, 어느 쪽이 표준이 될지는 정해지지 않았습니다. 워킹그룹 초안 두 건(vocab-08, attach-05)의 IESG 송부 목표일은 2026년 8월 31일이었지만, 11월 초 현재도 워킹그룹 문서 상태에 머물러 있습니다.
| 구분 | 개인 초안(kelley-00) | 워킹그룹 초안(attach-05) |
|---|---|---|
| 표기 | User-Agent: __usage_ai-training + Disallow |
Content-Usage: train-ai=n |
| 와일드카드 그룹 | 해당하지 않음 | User-Agent: * 아래 사용 |
| 지위 | 개인 제출본 | WG Document |
| 만료일 | 2027-05-03 | 2027-02-20 |
3. OpenAI 크롤러 종류와 새 토큰의 관계
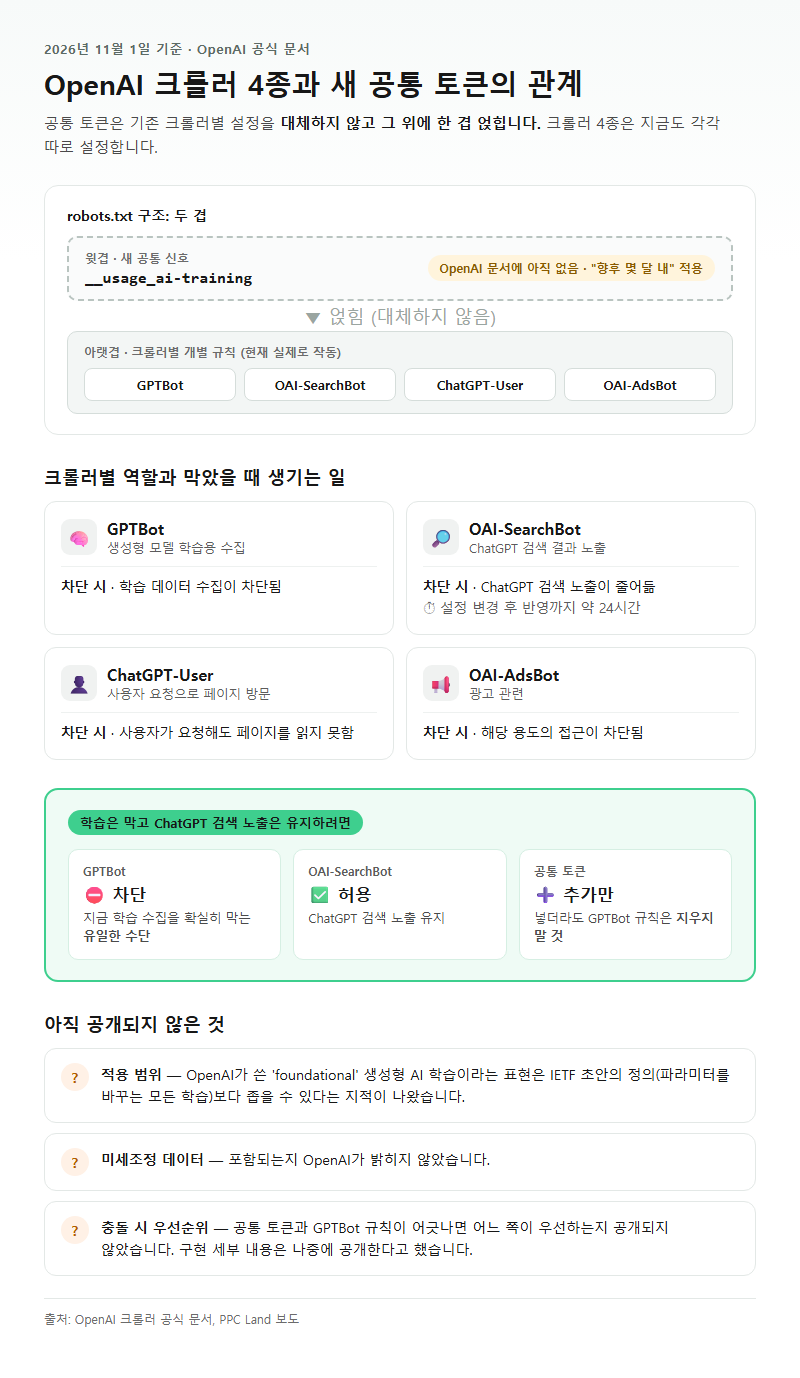
2026년 11월 1일 기준 공식 문서에서 OpenAI 크롤러는 4가지로 나뉘고 각각 따로 설정합니다. 공통 토큰은 이 구조를 대체하지 않고 그 위에 한 겹 얹힙니다. OpenAI도 새 신호가 기존 robots.txt 크롤러 제어를 대체하지 않는다고 밝혔습니다.
| 크롤러 | 역할 | 막으면 생기는 일 |
|---|---|---|
| GPTBot | 생성형 모델 학습용 수집 | 학습 데이터 수집 차단 |
| OAI-SearchBot | ChatGPT 검색 결과 노출 | ChatGPT 검색에서 노출이 줄어듦 |
| ChatGPT-User | 사용자가 요청해 페이지 방문 | 사용자 요청 시 페이지를 읽지 못함 |
| OAI-AdsBot | 광고 관련 | 해당 용도 접근 차단 |
OpenAI 크롤러 문서에는 아직 __usage_ai-training이 없습니다. 적용 시점은 “향후 몇 달 내”이고, 구현 세부는 나중에 공개한다고 했습니다. 지금 OpenAI 학습 수집을 확실하게 막는 수단은 GPTBot 차단뿐입니다. 공통 토큰을 넣었다고 GPTBot 규칙을 지우면 안 됩니다.
OAI-SearchBot 설정을 바꾸면 반영까지 약 24시간이 걸린다고 문서에 적혀 있습니다. 학습은 막고 ChatGPT 검색 노출은 유지하고 싶다면, GPTBot만 막고 OAI-SearchBot은 열어 두면 됩니다.
범위 문제는 남아 있습니다. OpenAI가 쓴 ‘foundational’ 생성형 AI 학습이라는 표현이 IETF 초안의 정의(파라미터를 바꾸는 모든 학습)보다 좁을 수 있다는 지적이 PPC Land 보도에서 나왔습니다. 미세조정 데이터가 포함되는지 OpenAI는 밝히지 않았고, 공통 토큰과 GPTBot 규칙이 어긋날 때 어느 쪽이 우선하는지도 공개하지 않았습니다.
4. Google·Bing·Anthropic 회사별 처리 방식과 일정
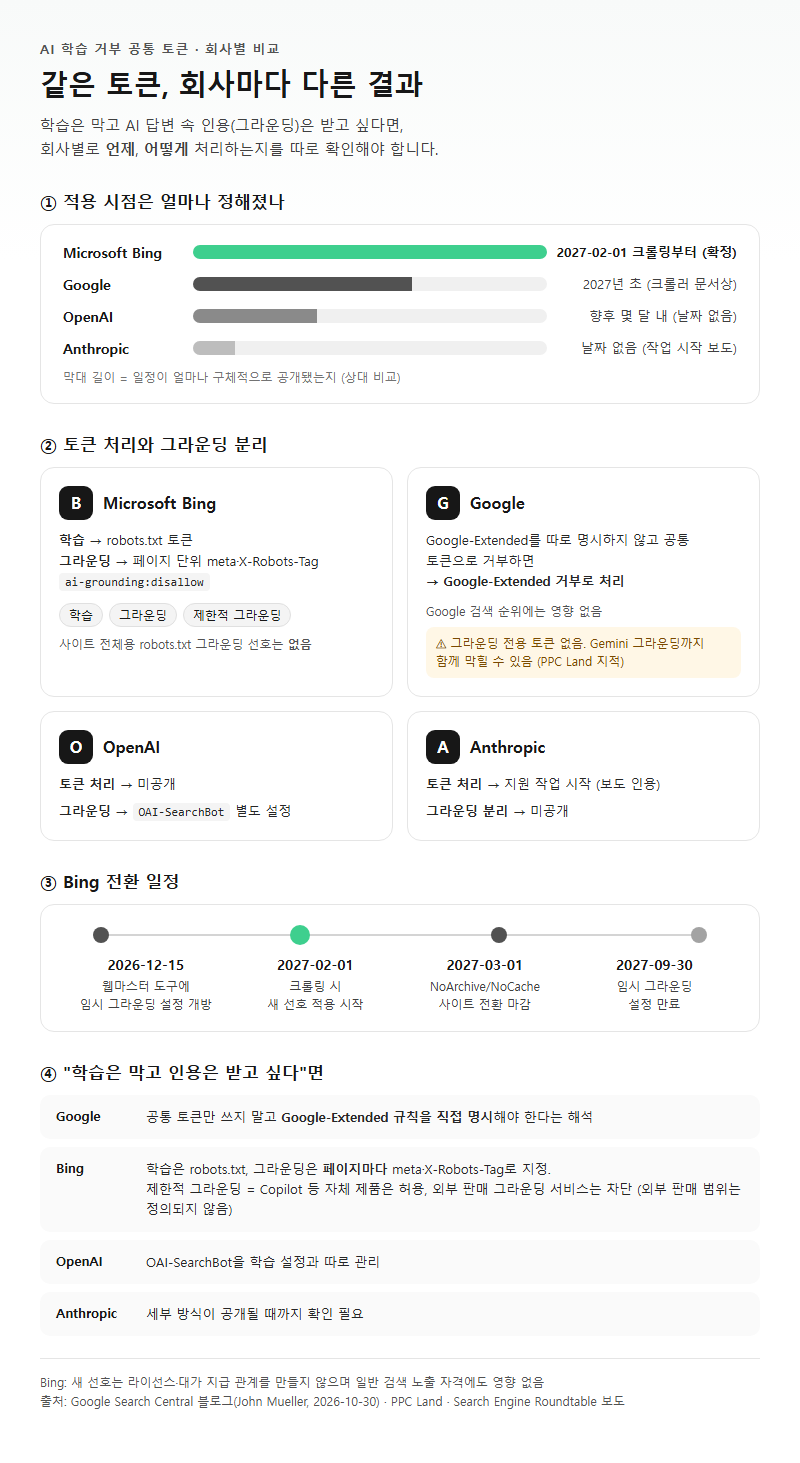
같은 토큰이라도 회사마다 해석과 연결 방식이 다릅니다. 학습만 막고 AI 답변 속 인용(그라운딩)은 받고 싶은 사이트라면 이 차이에서 결과가 갈립니다.
| 회사 | 적용 시점 | 토큰 처리 방식 | 그라운딩 분리 |
|---|---|---|---|
| Microsoft Bing | 2027-02-01 크롤링부터 | 학습 선호를 robots.txt 토큰으로 지정 | 페이지 단위 meta·X-Robots-Tag(ai-grounding:disallow) |
| 2027년(크롤러 문서상 early 2027) | Google-Extended 거부로 처리 | 그라운딩 전용 토큰 없음 | |
| OpenAI | 향후 몇 달 내(날짜 없음) | 미공개 | OAI-SearchBot 별도 설정 |
| Anthropic | 날짜 없음 | 지원 작업 시작(보도 인용) | 미공개 |
Google은 2026년 10월 30일 John Mueller가 쓴 Search Central 블로그 글에서 지원 계획을 밝혔습니다. Google-Extended를 따로 명시하지 않은 사이트가 공통 토큰으로 학습을 거부하면 Google-Extended를 거부한 것으로 처리합니다. Google 검색 순위에는 영향이 없습니다. 문제는 Google에 그라운딩만 따로 막거나 여는 토큰이 없다는 점입니다. PPC Land 보도는 공통 토큰이 Google-Extended로 처리되면 Gemini 그라운딩까지 함께 막힐 수 있다고 지적했습니다. 그라운딩을 살리려면 Google-Extended 규칙을 명시해야 한다는 해석이 여기서 나옵니다.
Microsoft Bing은 학습·그라운딩·제한적 그라운딩 세 가지로 가장 세밀하게 나눴고, 시작일을 확정한 곳도 Bing뿐입니다. 학습은 robots.txt 토큰으로, 그라운딩은 페이지 단위 meta 태그나 X-Robots-Tag로 지정합니다. 사이트 전체에 거는 robots.txt 그라운딩 선호는 없습니다. Search Engine Roundtable 보도에 따르면 제한적 그라운딩은 Copilot 같은 마이크로소프트 자체 제품은 허용하고 외부에 판매하는 그라운딩 서비스는 막는 옵션입니다. 어떤 서비스가 외부 판매에 해당하는지는 정의되지 않았습니다.
| Bing 전환 일정 | 내용 |
|---|---|
| 2026-12-15 | 웹마스터 도구에 임시 그라운딩 설정 개방 |
| 2027-02-01 | 크롤링 시 새 선호 적용 시작 |
| 2027-03-01 | NoArchive/NoCache 기반 제한을 유지하려는 사이트의 전환 마감 |
| 2027-09-30 | 임시 그라운딩 설정 만료 |
NoArchive나 NoCache로 AI 사용을 제한해 온 사이트는 2027년 3월 1일까지 새 방식으로 옮겨야 합니다. Bing은 새 선호가 라이선스나 대가 지급 관계를 만들지 않고, 일반 검색 노출 자격에도 영향을 주지 않는다고 밝혔습니다.
Anthropic은 PPC Land와 The Next Web 보도에 따르면 Kelley가 IETF 메일링 리스트에 올린 글에서 지원 작업을 이미 시작했다고 밝혔지만, 적용일은 내놓지 않았습니다. 메타는 대변인 Andy Stone이 공통 신호에 지지 의사를 밝혔습니다. 다만 The Next Web 보도 기준으로 메타가 이를 따를지는 말하지 않았습니다.
용어 풀이
1. Google-Extended — 2023년 도입된 Google의 robots.txt 제어 토큰으로, Google 검색 색인과 별개로 생성형 AI 쪽 사용 여부를 정합니다.
2. X-Robots-Tag — HTML meta 태그 대신 HTTP 응답 헤더로 크롤러 지시를 전달하는 방식으로, PDF처럼 HTML이 아닌 파일에도 쓸 수 있습니다.
5. 지금 robots.txt에 넣을 설정과 FAQ
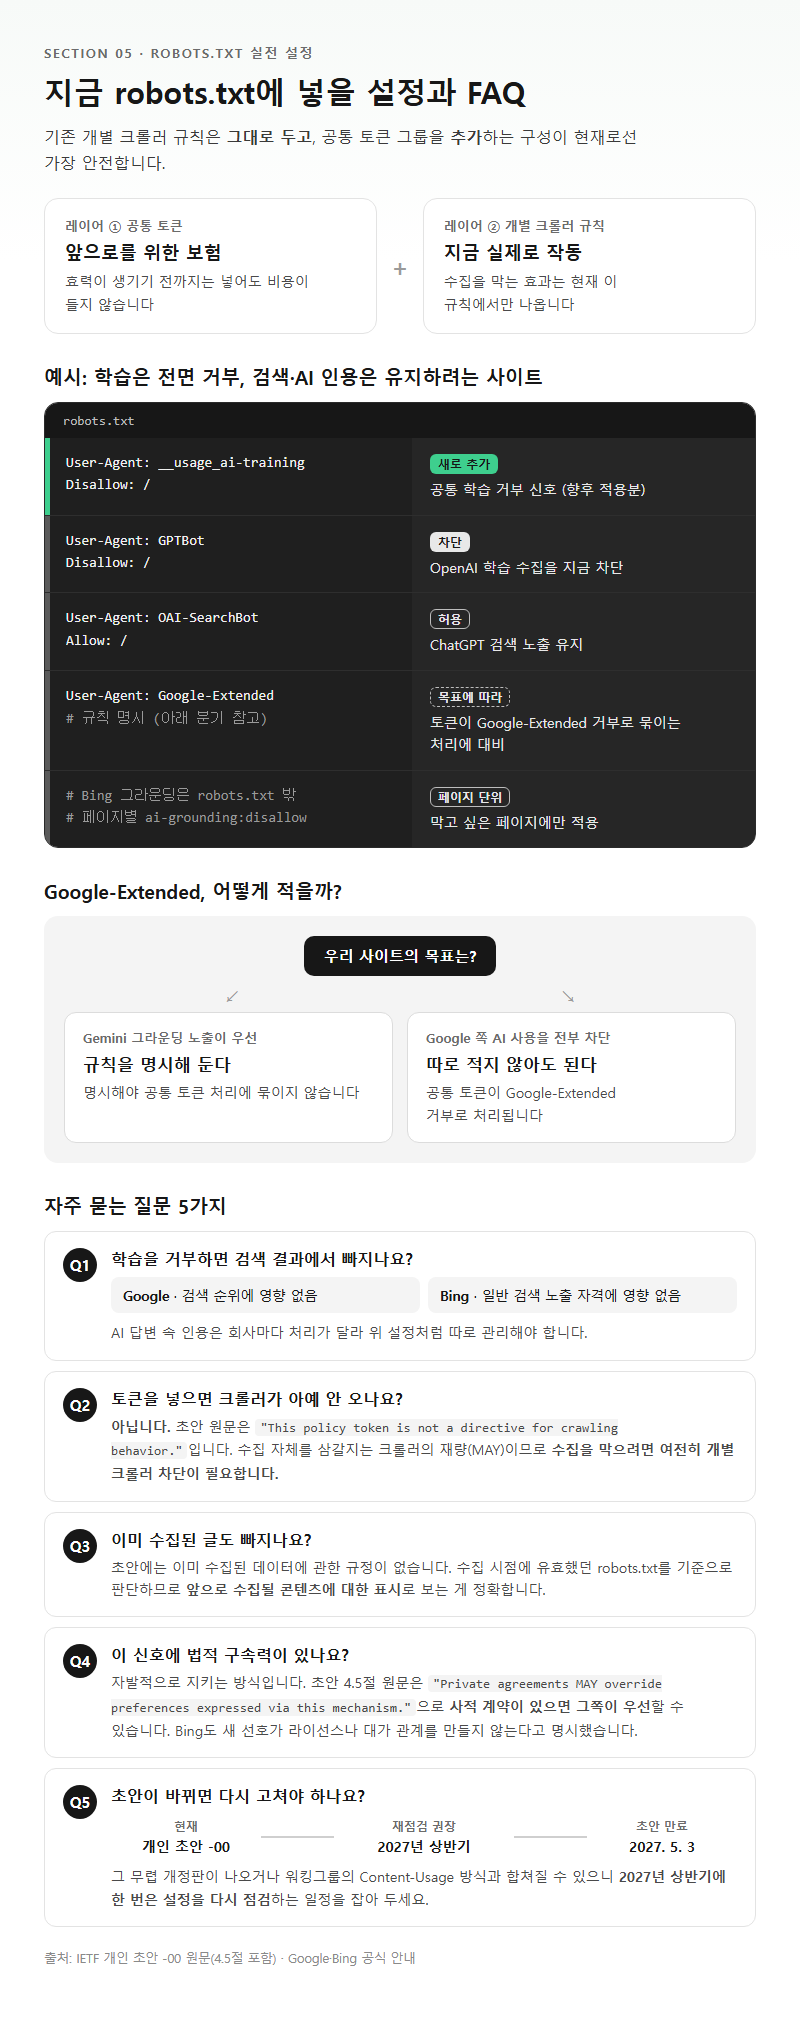
기존 개별 크롤러 규칙은 그대로 두고 공통 토큰 그룹을 추가하는 구성이 현재로선 가장 안전합니다. 공통 토큰은 효력이 생기기 전까지 비용이 들지 않고, 개별 규칙은 지금 실제로 작동하고 있습니다.
학습은 전면 거부, 검색·AI 인용은 유지하려는 사이트의 예시
| 줄 | 목적 |
|---|---|
User-Agent: __usage_ai-training / Disallow: / |
공통 학습 거부 신호(향후 적용분) |
User-Agent: GPTBot / Disallow: / |
OpenAI 학습 수집을 지금 차단 |
User-Agent: OAI-SearchBot / Allow: / |
ChatGPT 검색 노출 유지 |
User-Agent: Google-Extended 규칙 명시 |
토큰이 Google-Extended 거부로 묶이는 처리에 대비 |
Bing 그라운딩은 페이지별 ai-grounding:disallow |
막고 싶은 페이지에만 적용 |
Google-Extended를 어떻게 적을지는 사이트 목표에 따라 다릅니다. Gemini 그라운딩 노출이 우선이라면 규칙을 명시해 둬야 공통 토큰 처리에 묶이지 않습니다. Google 쪽 AI 사용을 전부 막을 생각이라면 따로 적지 않아도 공통 토큰이 Google-Extended 거부로 처리됩니다.
Q. 학습을 거부하면 검색 결과에서 빠지나요?
Google은 검색 순위에 영향이 없다고 했고, Bing은 일반 검색 노출 자격에 영향을 주지 않는다고 밝혔습니다. AI 답변 속 인용은 회사마다 처리가 다르니 위 표처럼 따로 관리해야 합니다.
Q. 토큰을 넣으면 크롤러가 아예 안 오나요?
아닙니다. 초안 원문은 “This policy token is not a directive for crawling behavior.”입니다. 크롤러가 수집 자체를 삼갈지는 재량(MAY)에 맡겨져 있습니다. 수집을 막으려면 여전히 개별 크롤러 차단이 필요합니다.
Q. 이미 수집된 글도 빠지나요?
초안에는 이미 수집된 데이터에 관한 규정이 없습니다. 선호는 수집 시점에 유효했던 robots.txt를 기준으로 판단하므로, 앞으로 수집될 콘텐츠에 대한 표시로 보는 게 정확합니다.
Q. 이 신호에 법적 구속력이 있나요?
자발적으로 지키는 방식입니다. 초안 4.5절 원문은 “Private agreements MAY override preferences expressed via this mechanism.”으로, 사적 계약이 있으면 그쪽이 우선할 수 있습니다. Bing도 새 선호가 라이선스나 대가 관계를 만들지 않는다고 명시했습니다.
Q. 초안이 바뀌면 다시 고쳐야 하나요?
개인 초안 -00의 만료일은 2027년 5월 3일입니다. 그 무렵 개정판이 나오거나 워킹그룹의 Content-Usage 방식과 합쳐질 수 있으니, 2027년 상반기에 한 번은 설정을 다시 점검하는 일정을 잡아 두세요.
정리
__usage_ai-training은 여러 회사에 학습 선호를 한 번에 전하는 첫 공통 신호입니다. 그러나 2026년 11월 초 기준으로 실제로 지키는 회사는 확인되지 않았고, IETF가 보증한 표준도 아닙니다. User-Agent: * 전면 차단은 이 신호로 인정되지 않으니 공통 토큰 그룹을 따로 적어야 합니다. 당장 확실한 수단은 GPTBot 같은 개별 크롤러 차단입니다. 이 규칙은 유지하고 공통 토큰을 그 위에 더하는 방식이 현재 손해가 가장 적습니다. 다음 점검 기준은 Bing의 2027년 2월 1일 적용과 3월 1일 NoArchive/NoCache 전환 마감, 그리고 Google의 Google-Extended 연동 방식입니다.
함께 보면 좋은 제품
- 라이프밀 홀그레인 저당 그래놀라 그릭요거트토핑 귀리 시리얼 140g (11,000원)
- 그릭요거트 토핑을 올린 귀리 그래놀라 시리얼입니다.
위 링크는 제휴 링크이며, 제품 선택은 독자의 판단입니다.
참고 자료
조사 기준일: 2026년 11월 01일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (확인일 2026-11-01)
– OpenAI, Making it easier for websites to express AI training preferences — https://openai.com/index/helping-websites-express-ai-training-preferences/
– OpenAI 크롤러 문서 — https://developers.openai.com/api/docs/bots
– IETF draft-kelley-aipref-training-preference-signal-00 — https://datatracker.ietf.org/doc/draft-kelley-aipref-training-preference-signal/ , https://www.ietf.org/archive/id/draft-kelley-aipref-training-preference-signal-00.html
– IETF draft-ietf-aipref-vocab — https://datatracker.ietf.org/doc/draft-ietf-aipref-vocab/
– IETF draft-ietf-aipref-attach — https://datatracker.ietf.org/doc/draft-ietf-aipref-attach/
– IETF aipref WG 마일스톤 — https://datatracker.ietf.org/wg/aipref/about/
– Google Search Central 블로그, Supporting a shared AI training control for websites — https://developers.google.com/search/blog/2026/10/ai-training-control
– Google 일반 크롤러 문서 — https://developers.google.com/search/docs/crawling-indexing/google-common-crawlers
– Bing 블로그, Your content, your choice — https://blogs.bing.com/search/2026/10/your-content-your-choice-clearer-preferences-for-training-and-grounding/
– The Next Web — https://thenextweb.com/news/ai-training-opt-out-robots-txt-google-openai-microsoft-anthropic
– PPC Land — https://ppc.land/google-microsoft-openai-and-anthropic-back-one-ai-training-opt-out/
– Search Engine Roundtable (Google) — https://www.seroundtable.com/google-ai-training-control-42430.html
– Search Engine Roundtable (Bing) — https://www.seroundtable.com/microsoft-bing-ai-controls-42429.html
답글 남기기