
Claude Fable 5.1로 모델명만 바꾸면 400 오류가 납니다. forced tool_choice 차단, thinking 블록 바인딩 등 파괴적 변경 3가지와 Opus 5·Fable 5·Sonnet 5 비용 비교 기준을 2026년 9월 8일 기준 공식 문서로 정리했습니다.
Claude Fable 5.1 API, 무엇을 기준으로 비교해야 할까
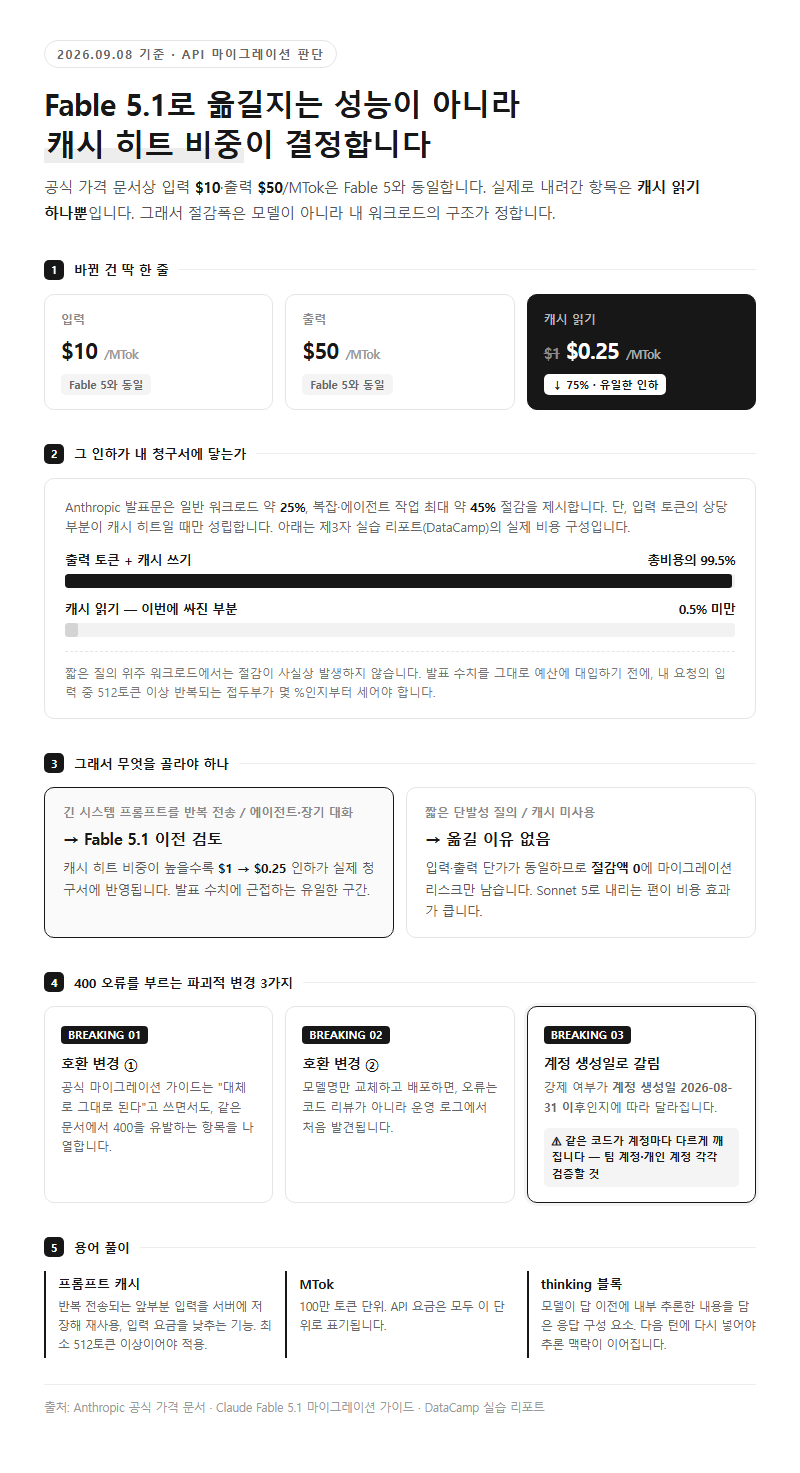
Claude Fable 5.1로 옮길지 판단하는 기준은 성능이 아니라 캐시 히트 비중입니다. 2026년 9월 8일 기준 공식 가격 문서상 입력 $10/MTok·출력 $50/MTok은 Fable 5와 같고, 실제로 내려간 항목은 캐시 읽기 하나뿐입니다($1 → $0.25/MTok). 이 글은 2026년 9월 1일 출시된 Claude Fable 5.1의 API 호환 변경 3가지와, Opus 5·Fable 5·Sonnet 5 중 어느 쪽을 골라야 하는지를 공식 문서와 독립 측정 자료로 비교합니다. 로컬 실행이나 파인튜닝은 다루지 않습니다.
Anthropic 발표문은 일반 워크로드 약 25%, 복잡·에이전트 작업에서 최대 약 45% 비용 절감을 제시합니다. 다만 이 수치가 성립하려면 입력 토큰의 상당 부분이 캐시 히트여야 합니다. 제3자 실습 리포트(DataCamp)의 실측에서는 총비용의 99.5%를 출력 토큰과 캐시 쓰기가 차지했고, 캐시 읽기 절감 효과는 총비용의 0.5% 미만이었습니다. 짧은 질의 위주 워크로드에서는 절감이 사실상 발생하지 않습니다.
두 번째 기준은 마이그레이션 비용입니다. 공식 마이그레이션 가이드는 이전이 대체로 그대로 된다는 취지로 서술하면서도, 같은 문서에서 400 오류를 유발하는 파괴적 변경 3가지를 나열합니다. 특히 세 번째 변경은 계정 생성일이 2026년 8월 31일 이후인지에 따라 강제 여부가 갈리므로, 같은 코드가 계정마다 다르게 깨집니다. 성능 순위만 보고 모델명을 바꾸면 배포 후에 문제를 발견하게 됩니다.
용어 풀이
1. 프롬프트 캐시 — 반복해서 보내는 앞부분 입력을 서버에 저장해 두고 재사용해 입력 요금을 낮추는 기능으로, 최소 512토큰 이상이어야 적용됩니다.
2. MTok — 100만 토큰 단위이며, API 요금은 이 단위로 표기됩니다.
3. thinking 블록 — 모델이 답을 내기 전 내부적으로 추론한 내용을 담은 응답 구성 요소로, 다음 턴에 다시 넣어줘야 추론 맥락이 이어집니다.
비교 기준 정리
판단 항목을 요금·제약·성능 세 축으로 나누면 다음과 같습니다. 모든 가격은 2026년 9월 8일 기준 공식 가격 문서 확인값입니다.
| 기준 항목 | 단위·측정 방식 | 확인해야 할 지점 |
|---|---|---|
| 기본 입출력 단가 | $/MTok | Fable 5.1은 $10/$50으로 Fable 5와 동일. 인하 없음 |
| 캐시 읽기 단가 | $/MTok | $1 → $0.25로 인하. 기본 입력가의 0.025배(타 모델은 0.1배) |
| 캐시 쓰기 단가 | $/MTok | 5분 $12.50, 1시간 $20 — 변동 없음 |
| 캐시 최소 길이 | 토큰 | 512토큰 미만 프롬프트는 캐시 자체가 적용되지 않음 |
| 배치 처리 | $/MTok | 입력 $5·출력 $25로 절반. 지연에 둔감한 작업의 우선 검토 대상 |
| 컨텍스트·출력 | 토큰 | 1,000,000 토큰(기본=최대), 최대 출력 128k |
| 파괴적 변경 | HTTP 코드 | 400 오류 3종 — 아래 절에서 개별 확인 |
| effort 설정 | 5단계 | low/medium/high/xhigh/max, API 기본값 high |
| 데이터 보존 | 정책 | Opus 5에서 이전 시 30일 보존 필수, 별도 승인 없이 ZDR 불가 |
여기서 놓치기 쉬운 값은 캐시 쓰기입니다. 캐시 읽기가 4분의 1로 내려가도 쓰기 단가 $12.50~$20은 그대로라, 같은 프리픽스를 여러 번 읽지 않고 매번 새로 쓰는 구조라면 총비용이 오히려 늘어납니다. 세션이 길고 동일 프리픽스를 반복 조회하는 에이전트여야 인하분이 회수됩니다.
토크나이저는 Fable 5와 같아서 같은 텍스트의 토큰 수는 변하지 않습니다. 다만 4.7 이후 토크나이저가 바뀌면서 동일 텍스트의 토큰이 약 30% 늘어난 상태라, 그 이전 세대에서 곧바로 넘어오는 경우 실질 비용은 단가표만으로 계산되지 않습니다.
옵션·유형별 비교
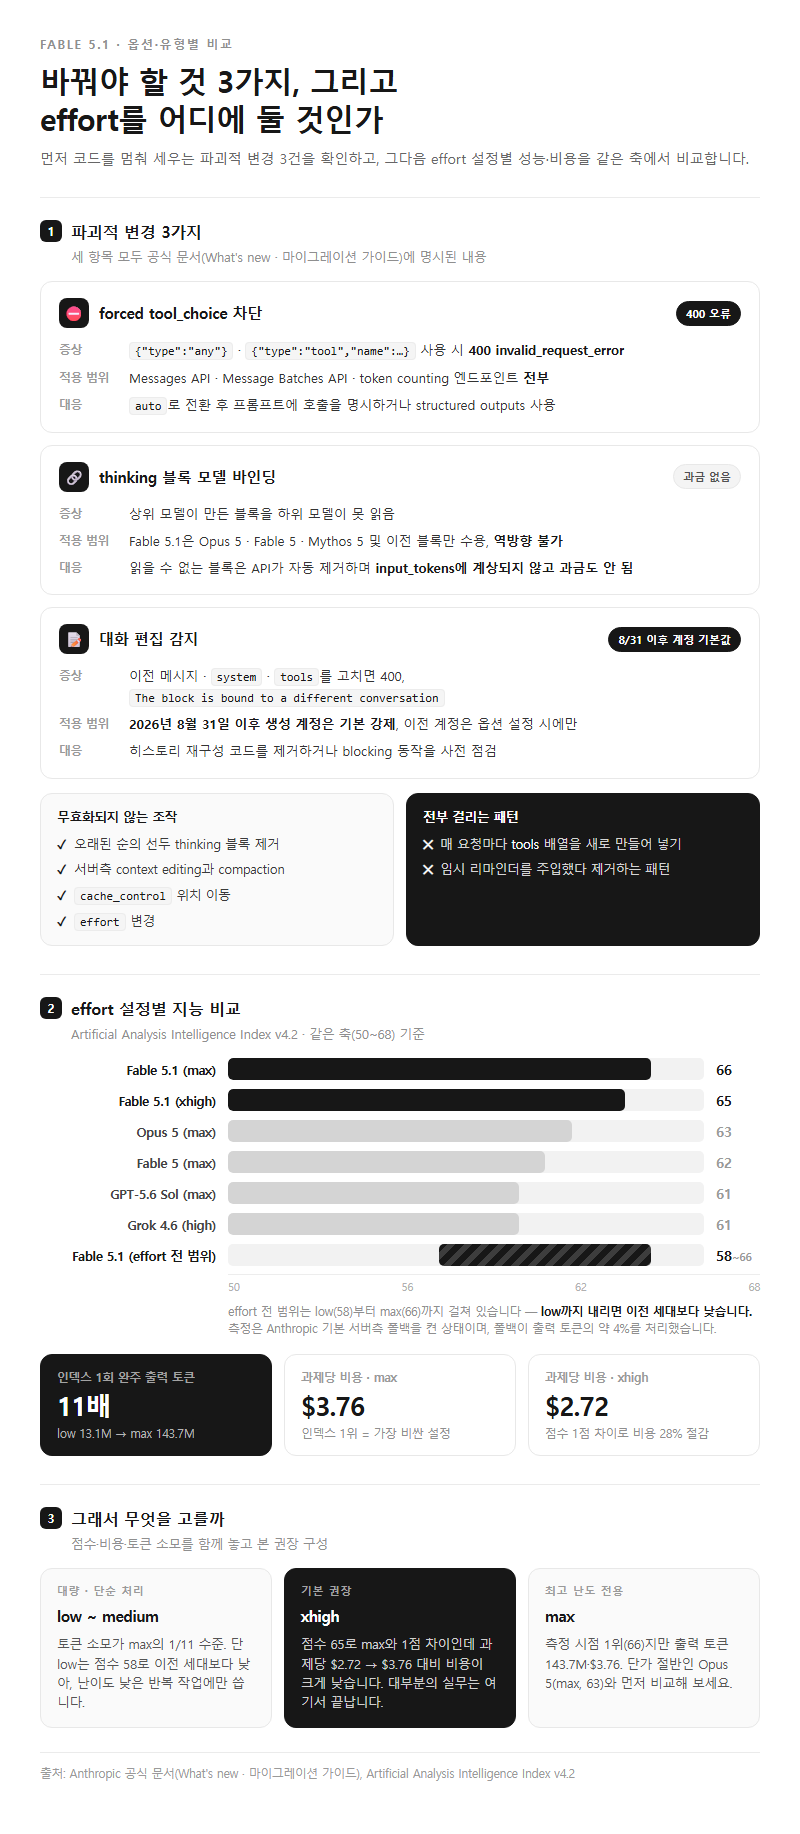
먼저 파괴적 변경 3가지입니다. 세 항목 모두 공식 문서(What’s new·마이그레이션 가이드)에 명시된 내용입니다.
| 변경 항목 | 증상 | 적용 범위 | 대응 |
|---|---|---|---|
| forced tool_choice 차단 | {"type":"any"}·{"type":"tool","name":...} 사용 시 400 invalid_request_error |
Messages API·Message Batches API·token counting 엔드포인트 전부 | 로 전환 후 프롬프트에 호출을 명시하거나 structured outputs 사용 |
| thinking 블록 모델 바인딩 | 상위 모델이 만든 블록을 하위 모델이 못 읽음 | Fable 5.1은 Opus 5·Fable 5·Mythos 5 및 이전 블록만 수용, 역방향 불가 | 읽을 수 없는 블록은 API가 자동 제거하며 input_tokens에 계상되지 않고 과금도 안 됨 |
| 대화 편집 감지 | 이전 메시지··를 고치면 400, The block is bound to a different conversation |
2026년 8월 31일 이후 생성 계정은 기본 강제, 이전 계정은 옵션 설정 시에만 | 히스토리 재구성 코드를 제거하거나 blocking 동작을 사전 점검 |
세 번째 항목에는 무효화되지 않는 조작도 함께 명시돼 있습니다. 오래된 순의 선두 thinking 블록 제거, 서버측 context editing과 compaction, cache_control 위치 이동, 변경은 허용됩니다. 반대로 매 요청마다 배열을 새로 만들어 넣거나 임시 리마인더를 주입했다 제거하는 패턴은 전부 걸립니다.
성능은 effort 설정에 따라 크게 갈립니다. 독립 측정기관 Artificial Analysis의 Intelligence Index v4.2 기준값은 다음과 같습니다.
| 모델·설정 | AA Intelligence Index v4.2 | 참고 |
|---|---|---|
| Fable 5.1 (max) | 66 | 측정 시점 1위 |
| Fable 5.1 (xhigh) | 65 | 과제당 비용 $2.72 |
| Fable 5.1 (effort 전 범위) | 58~66 | low까지 내리면 이전 세대보다 낮음 |
| Opus 5 (max) | 63 | 단가는 절반 |
| Fable 5 (max) | 62 | — |
| GPT-5.6 Sol (max) | 61 | — |
| Grok 4.6 (high) | 61 | — |
이 측정은 Anthropic 기본 서버측 폴백을 켠 상태이며 폴백이 출력 토큰의 약 4%를 처리했습니다. 인덱스를 1회 완주하면 출력 토큰이 low 13.1M에서 max 143.7M으로 11배 차이가 나고, 과제당 비용은 max $3.76·xhigh $2.72입니다. 순위표의 1위는 가장 비싼 설정에서만 성립합니다.
한 가지 참고로, AA 모델 페이지에서는 53과 57이라는 다른 값도 관측됐습니다. 분석글의 66과 같은 변종을 가리키는지는 확인하지 못했습니다(확인 필요).
용어 풀이
1. effort — 모델이 답 하나에 얼마나 많은 추론을 쓸지 정하는 5단계 설정으로, 높일수록 점수와 출력 토큰이 함께 늘어납니다.
2. structured outputs — 응답을 지정한 스키마 형태로 강제해 받는 기능으로, 도구 호출을 강제하던 코드의 대안이 됩니다.
3.
상황별 추천
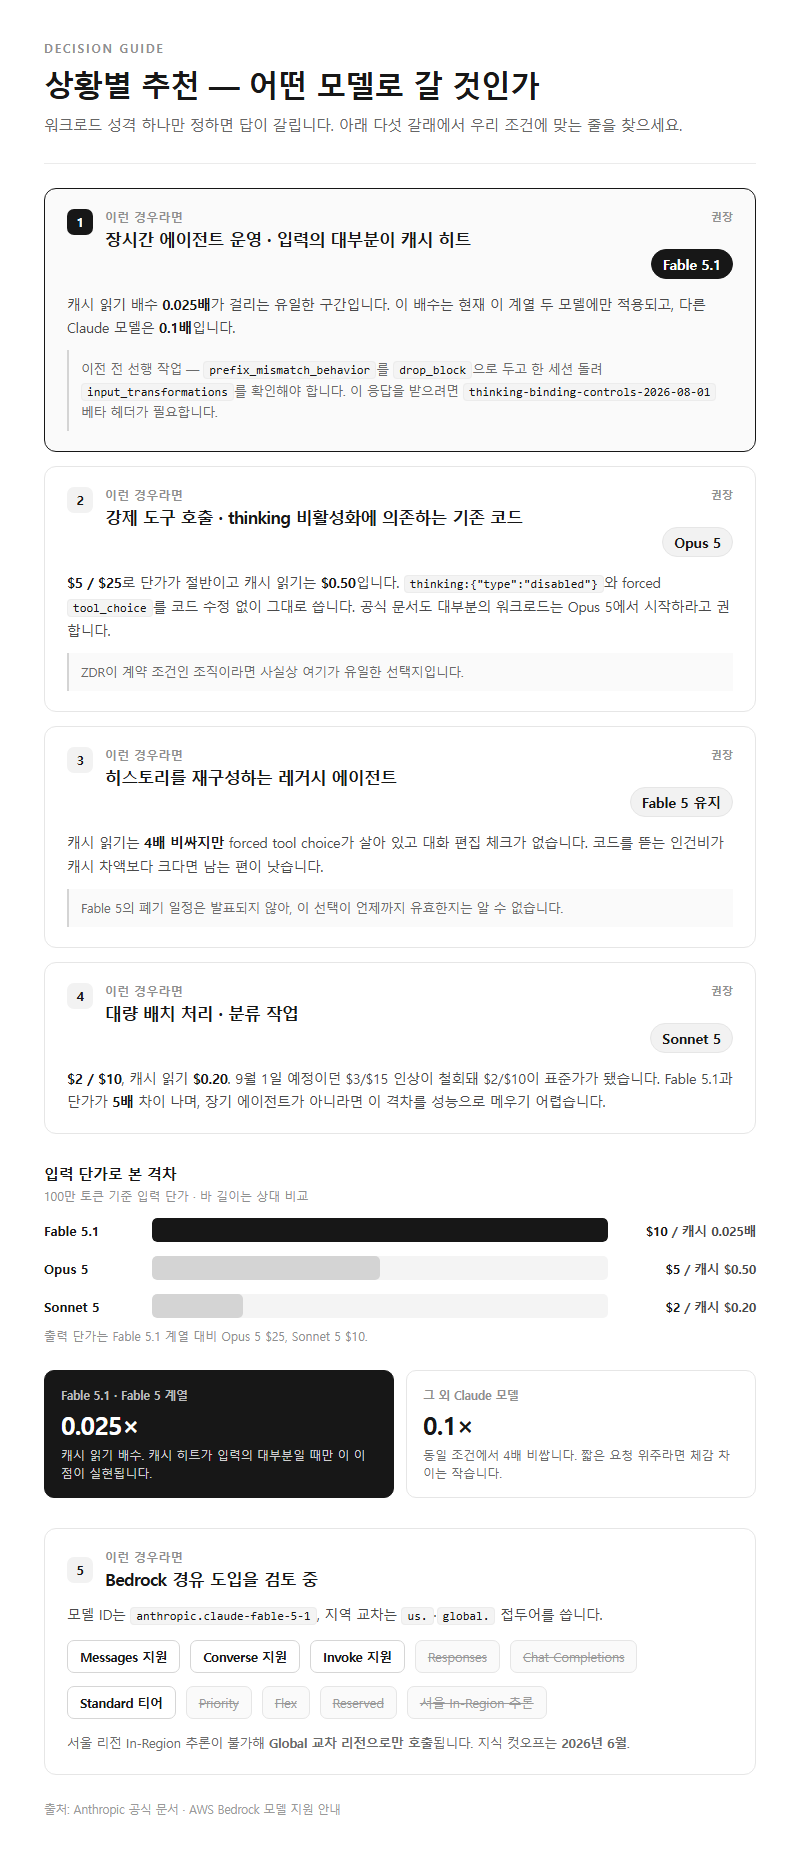
장시간 에이전트를 운영하고 캐시 히트가 입력의 대부분인 경우 — Fable 5.1이 유일하게 유리한 구간입니다. 캐시 읽기 배수 0.025배는 현재 이 계열 두 모델에만 적용되고, 다른 Claude 모델은 0.1배입니다. 다만 이전 전에 prefix_mismatch_behavior를 drop_block으로 두고 한 세션 돌려 input_transformations를 확인하는 작업이 선행돼야 합니다(이 응답을 받으려면 베타 헤더가 필요합니다).
강제 도구 호출이나 thinking 비활성화에 의존하는 기존 코드 — Opus 5가 낫습니다. $5/$25로 단가가 절반이고 캐시 읽기는 $0.50이며, thinking:{"type":"disabled"}와 forced tool_choice를 그대로 씁니다. 공식 문서 자체가 대부분의 워크로드는 Opus 5에서 시작하라고 권합니다. ZDR이 계약 조건인 조직도 여기가 사실상 유일한 선택지입니다.
히스토리를 재구성하는 레거시 에이전트 — Fable 5로 남는 편이 낫습니다. 캐시 읽기는 4배 비싸지만 forced tool choice가 살아 있고 대화 편집 체크가 없어, 코드를 뜯는 인건비보다 캐시 차액이 작습니다. 다만 Fable 5의 폐기 일정은 발표되지 않아 언제까지 이 선택이 유효한지는 알 수 없습니다.
대량 배치 처리·분류 작업 — Sonnet 5($2/$10, 캐시 읽기 $0.20)를 먼저 검토합니다. 9월 1일 예정이던 $3/$15 인상이 철회돼 $2/$10이 표준가가 됐고, Fable 5.1과는 단가가 5배 차이 납니다. 장기 에이전트가 아니라면 이 격차를 성능으로 메우기 어렵습니다.
Bedrock 경유 도입을 검토 중인 경우 — 모델 ID는 anthropic.claude-fable-5-1이며 지역 교차는 us.·global. 접두어를 씁니다. Messages·Converse·Invoke는 지원하지만 Responses·Chat Completions는 지원하지 않습니다. 현재 Standard 티어만 가능하고 Priority·Flex·Reserved는 쓸 수 없으며, 서울 리전 In-Region 추론도 불가해 Global 교차 리전으로만 호출됩니다. 지식 컷오프는 2026년 6월입니다.
자주 하는 실수
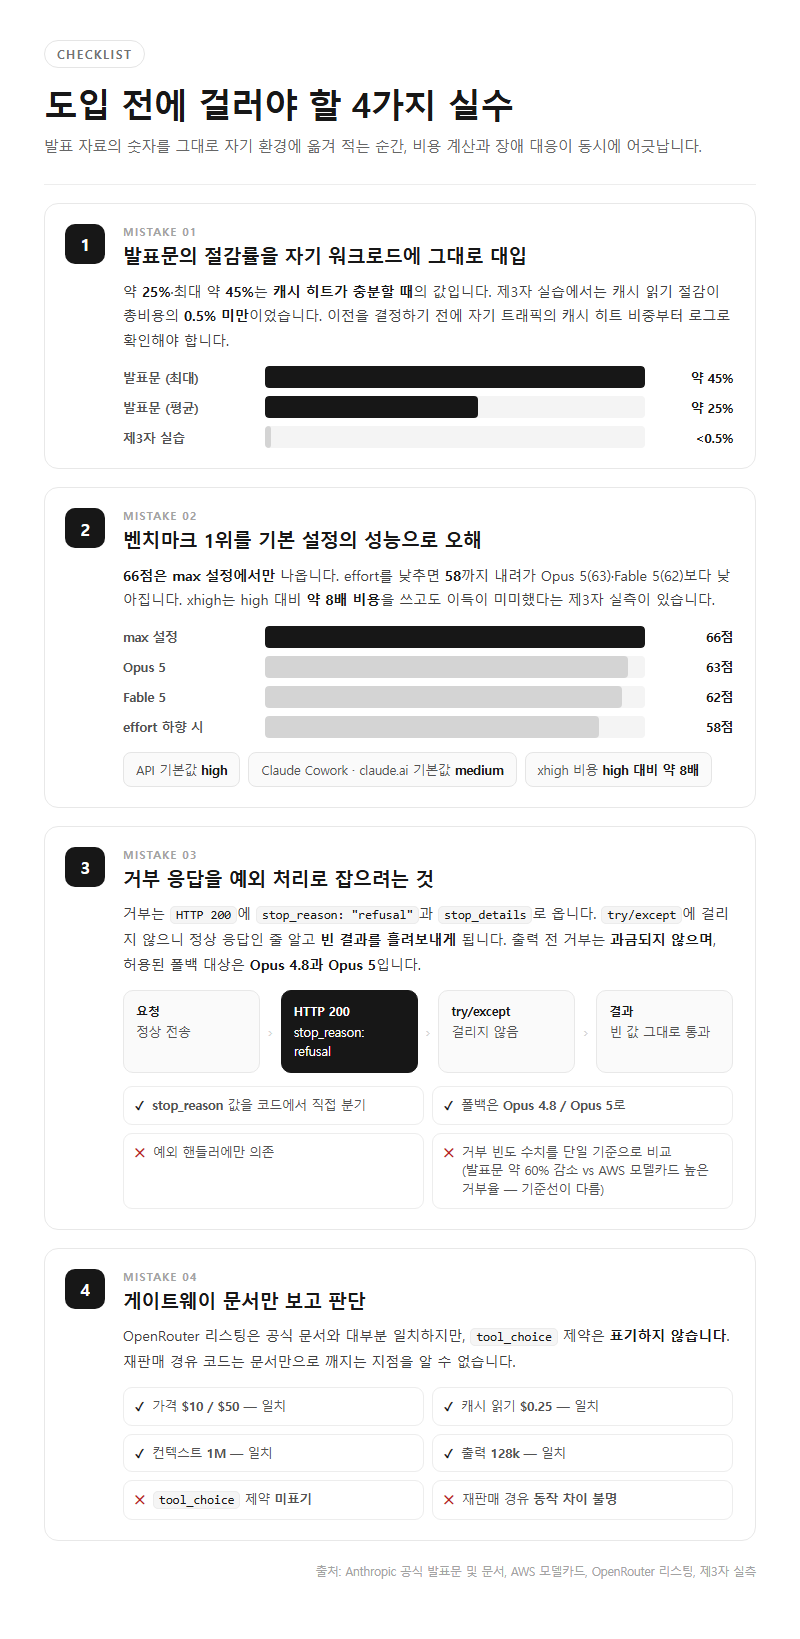
첫째, 발표문의 절감률을 자기 워크로드에 그대로 대입하는 것. 약 25%·최대 약 45%는 캐시 히트가 충분할 때의 값입니다. 앞서 인용한 제3자 실습에서는 캐시 읽기 절감이 총비용의 0.5% 미만이었습니다. 이전을 결정하기 전에 자기 트래픽의 캐시 히트 비중부터 로그로 확인해야 합니다.
둘째, 벤치마크 1위를 기본 설정의 성능으로 오해하는 것. API 기본값은 high이고, Claude Cowork와 claude.ai의 제품 기본값은 medium입니다. 66점은 max 설정에서만 나오며 effort를 낮추면 58까지 내려가 Opus 5(63)·Fable 5(62)보다 낮습니다. 게다가 xhigh는 high 대비 약 8배 비용을 쓰고도 이득이 미미했다는 제3자 실측이 있습니다.
셋째, 거부 응답을 예외 처리로 잡으려는 것. 거부는 HTTP 200에 stop_reason: "refusal"과 stop_details로 옵니다. try/except에 걸리지 않으니 정상 응답인 줄 알고 빈 결과를 흘려보내게 됩니다. 출력 전 거부는 과금되지 않으며 허용된 폴백 대상은 Opus 4.8과 Opus 5입니다. 참고로 거부 빈도는 Anthropic 발표문이 사이버 개입 세션당 약 60% 감소를, AWS 모델카드가 이전 Claude 모델들 대비 실질적으로 높은 거부율을 각각 기술하고 있어 비교 기준선이 서로 다릅니다.
넷째, 게이트웨이 문서만 보고 판단하는 것. OpenRouter 리스팅은 $10/$50·캐시 읽기 $0.25·1M 컨텍스트·128k 출력까지 공식 문서와 일치하지만, tool_choice 제약은 표기하지 않습니다. 재판매 경유 코드는 문서만으로 깨지는 지점을 알 수 없습니다.
정리
Fable 5.1은 단가가 내려간 모델이 아니라 캐시 읽기만 4분의 1로 내려간 모델이며, 그 이점은 동일 프리픽스를 반복 조회하는 장시간 에이전트에서만 회수됩니다. 그 조건에 해당하지 않으면 절반 단가에 제약도 적은 Opus 5, 대량 처리라면 5분의 1 단가인 Sonnet 5가 합리적입니다. 이전을 결정했다면 forced tool_choice 사용처와 히스토리 재구성 코드부터 찾아 정리하고, 2026년 8월 31일 이후 생성 계정에서는 대화 편집 감지가 기본 강제라는 점을 먼저 확인해야 합니다. 기준은 하나입니다 — 캐시 히트 비중이 높으면 5.1, 아니면 Opus 5입니다.
참고 자료
조사 기준일: 2026년 09월 08일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (전량 WebFetch로 원문 대조, 확인일 2026-09-08)
– Anthropic, “Introducing Claude Fable 5.1 and Claude Mythos 5.1” — https://www.anthropic.com/claude-fable-and-mythos-5-1
– Claude Platform Docs, “What’s new in Claude Fable 5.1” — https://platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1
– Claude Platform Docs, “Migrating to Claude Fable 5.1 and Claude Mythos 5.1” — https://platform.claude.com/docs/en/models/fable-5-1/migration-guide
– Claude Platform Docs, “Claude Platform release notes”(2026-09-01·09-03 항목) — https://platform.claude.com/docs/en/release-notes/overview
– Claude Platform Docs, “Pricing” — https://platform.claude.com/docs/en/about-claude/pricing
– AWS, “Claude Fable 5.1” Bedrock 모델카드 — https://docs.aws.amazon.com/bedrock/latest/userguide/model-card-anthropic-claude-fable-5-1.html
Tier 2 (확인일 2026-09-08)
– Artificial Analysis, “Claude Fable 5.1 tops the Artificial Analysis Intelligence Index” — https://artificialanalysis.ai/articles/claude-fable-5-1
– Artificial Analysis 모델 페이지(값 상충, 미채택) — https://artificialanalysis.ai/models/claude-fable-5-1
– DataCamp, “Claude Fable 5.1 API Tutorial: Build a Python AI Agent” — https://www.datacamp.com/tutorial/claude-fable-5-1-api-tutorial
– OpenRouter 모델 리스팅 — https://openrouter.ai/anthropic/claude-fable-5.1
– MacRumors, “Anthropic Launches Claude Fable 5.1 With Lower Costs and Fewer False Positives”(2026-09-01) — https://www.macrumors.com/2026/09/01/anthropic-claude-fable-5-1/
답글 남기기