
2026년 9월 30일 Hugging Face가 공개한 Open TTS Leaderboard의 다국어 TTS·음성 복제 평가 구조를 정리했습니다. WER·CER·SIM·RTFx 지표 계산 방식, 지원 언어 9개, 논문 수치와 직접 비교하면 안 되는 이유, 라이선스 주의점을 다룹니다.
OpenTTS리더보드 개요
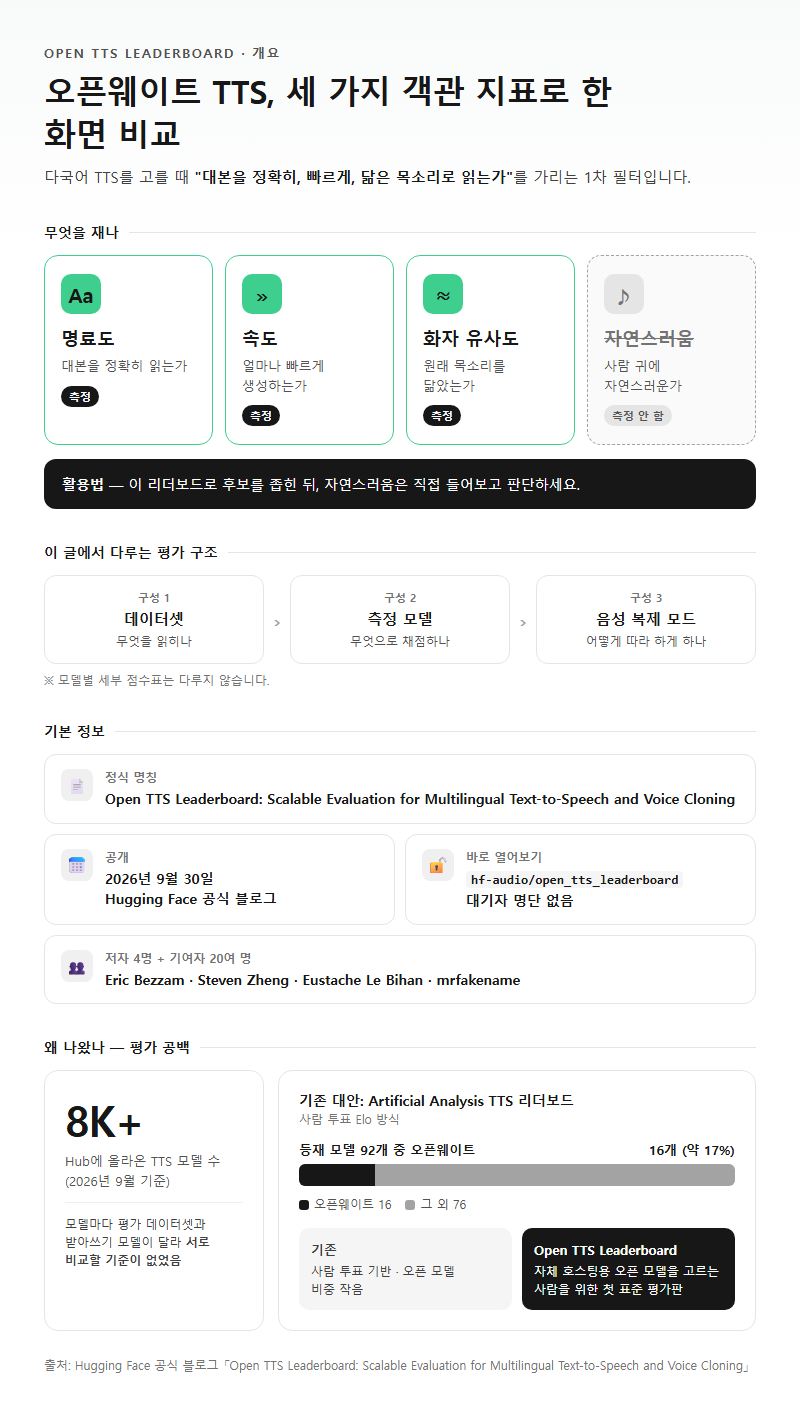
Open TTS Leaderboard는 오픈웨이트 TTS 모델을 명료도·속도·화자 유사도라는 세 가지 객관 지표로 한 화면에서 비교하는 공개 순위표입니다. 사람이 듣기에 얼마나 자연스러운지는 재지 않습니다. 그래서 다국어 TTS를 비교할 때는 “어떤 모델이 대본을 정확히, 빠르게, 닮은 목소리로 읽는가”를 가리는 1차 필터로 쓰면 됩니다. 이 글에서는 데이터셋·측정 모델·음성 복제 모드가 어떻게 짜여 있는지, 즉 리더보드의 평가 구조를 다룹니다. 모델별 세부 점수표는 다루지 않습니다.
정식 명칭은 “Open TTS Leaderboard: Scalable Evaluation for Multilingual Text-to-Speech and Voice Cloning”입니다. Hugging Face 공식 블로그에 2026년 9월 30일 게시됐고, hf-audio/open_tts_leaderboard Space에서 대기자 명단 없이 바로 열어볼 수 있습니다. 저자는 Eric Bezzam, Steven Zheng, Eustache Le Bihan, mrfakename 네 명이고, 20여 명이 기여자로 이름을 올렸습니다.
이 리더보드가 나온 이유는 평가 공백입니다. HF 블로그에 따르면 2026년 9월 기준 Hub에 올라온 TTS 모델은 8K개를 넘습니다. 그런데 모델마다 평가 데이터셋과 받아쓰기 모델이 제각각이라 서로 비교할 기준이 없었습니다. 기존 대안인 Artificial Analysis TTS 리더보드는 사람 투표 Elo 방식이고, 등재된 92개 모델 가운데 오픈웨이트는 16개뿐입니다. 자체 호스팅할 오픈 모델을 고르는 사람에게 맞춘 표준 평가판은 이번이 처음인 셈입니다.
1. 세 가지 평가 축 — WER·CER, RTFx·TTFA, SIM
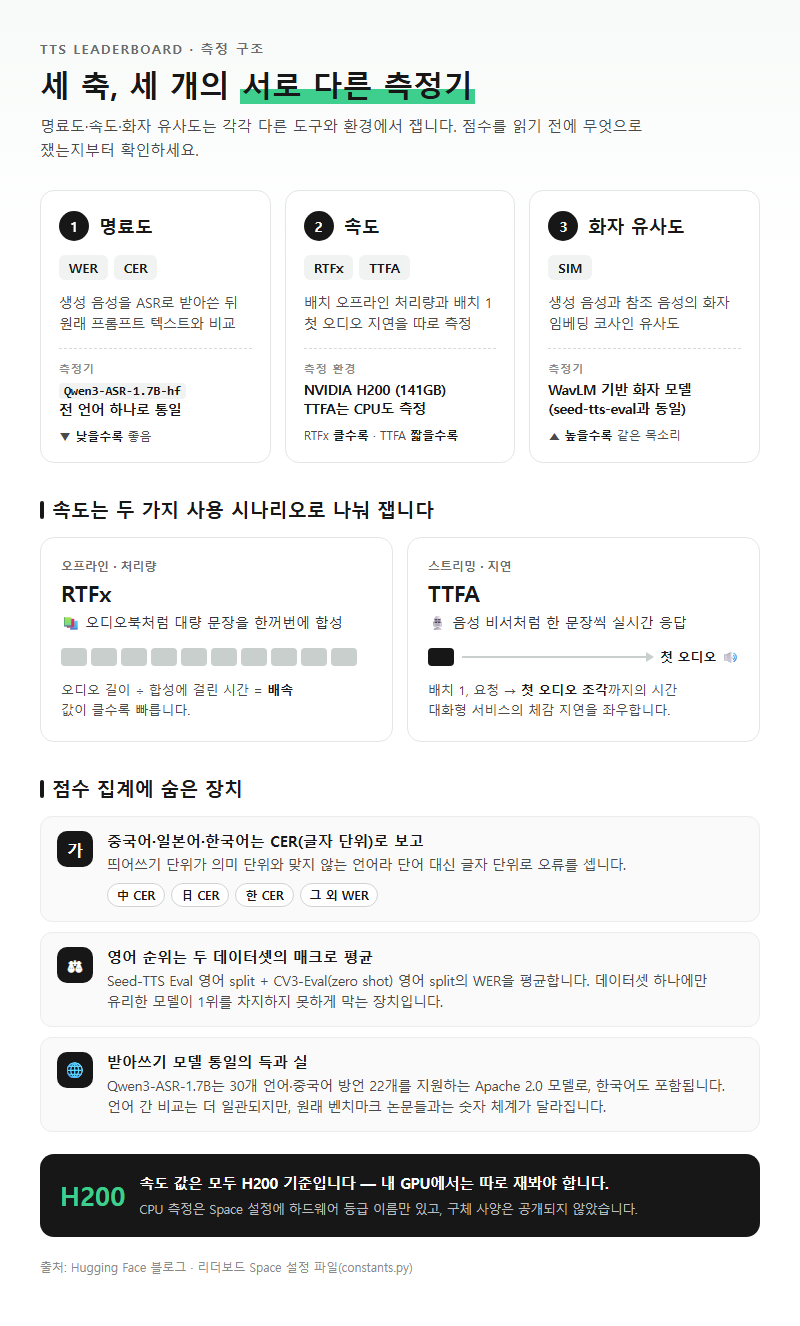
리더보드의 측정 구조는 세 축으로 나뉘고, 축마다 측정기가 따로 있습니다. 아래 표는 HF 블로그와 Space 설정 파일(constants.py)에 적힌 내용을 정리한 것입니다.
| 평가 축 | 지표 | 측정 방법 | 측정기·환경 |
|---|---|---|---|
| 명료도 | WER / CER | 생성 음성을 ASR로 받아쓴 뒤 원래 프롬프트 텍스트와 비교 | Qwen/Qwen3-ASR-1.7B-hf |
| 속도(오프라인) | RTFx | 배치 오프라인 추론 처리 속도 | NVIDIA H200(141GB) |
| 속도(스트리밍) | TTFA | 배치 1에서 첫 오디오가 나오기까지 걸린 시간 | H200 및 CPU |
| 화자 유사도 | SIM | 생성 음성과 참조 음성의 화자 임베딩 코사인 유사도 | WavLM 기반 화자 모델(seed-tts-eval과 동일) |
명료도 축에서 눈여겨볼 부분은 받아쓰기 모델을 Qwen3-ASR-1.7B 하나로 통일했다는 점입니다. Qwen3-ASR-1.7B는 30개 언어와 중국어 방언 22개를 지원하는 Apache 2.0 모델이고, 한국어도 포함됩니다. 언어마다 받아쓰기 모델을 바꾸지 않으니 언어 간 비교는 더 일관됩니다. 대신 원래 벤치마크 논문들과는 숫자 체계가 달라집니다. 이 문제는 3절에서 다룹니다.
중국어·일본어·한국어는 단어 대신 글자 단위로 오류를 세는 CER로 보고합니다. 띄어쓰기 단위가 의미 단위와 맞지 않는 언어라서입니다. 영어 순위는 Seed-TTS Eval 영어 split과 CV3-Eval(zero shot) 영어 split의 WER을 매크로 평균해 매깁니다. 데이터셋 하나에만 유리한 모델이 1위를 차지하지 못하게 막는 장치입니다.
속도 축은 두 가지 사용 시나리오를 따로 잽니다. RTFx는 오디오북처럼 대량 문장을 한꺼번에 합성할 때의 처리량이고, TTFA는 음성 비서처럼 한 문장씩 실시간으로 응답할 때의 지연입니다. 두 값 모두 H200 기준이라 내 GPU에서는 따로 재봐야 합니다. CPU 측정은 Space 설정에 하드웨어 등급 이름만 적혀 있을 뿐, HF가 구체 사양을 공개하지 않았습니다.
용어 풀이
1. WER / CER — 받아쓴 결과가 원문과 단어(또는 글자) 단위로 얼마나 다른지를 나타내는 오류율로, 낮을수록 대본을 정확히 읽었다는 뜻입니다.
2. RTFx — 오디오 길이를 합성에 걸린 시간으로 나눈 배속 지표로, 클수록 빠릅니다.
3. TTFA — 요청을 보낸 뒤 첫 오디오 조각이 나올 때까지의 시간으로, 실시간 대화형 서비스의 체감 지연을 좌우합니다.
4. 화자 임베딩 — 목소리의 특징을 숫자 벡터로 압축한 값으로, 두 벡터가 가까울수록 같은 사람 목소리로 판단합니다.
2. 데이터셋 구성 — 실제로 평가되는 언어는 9개
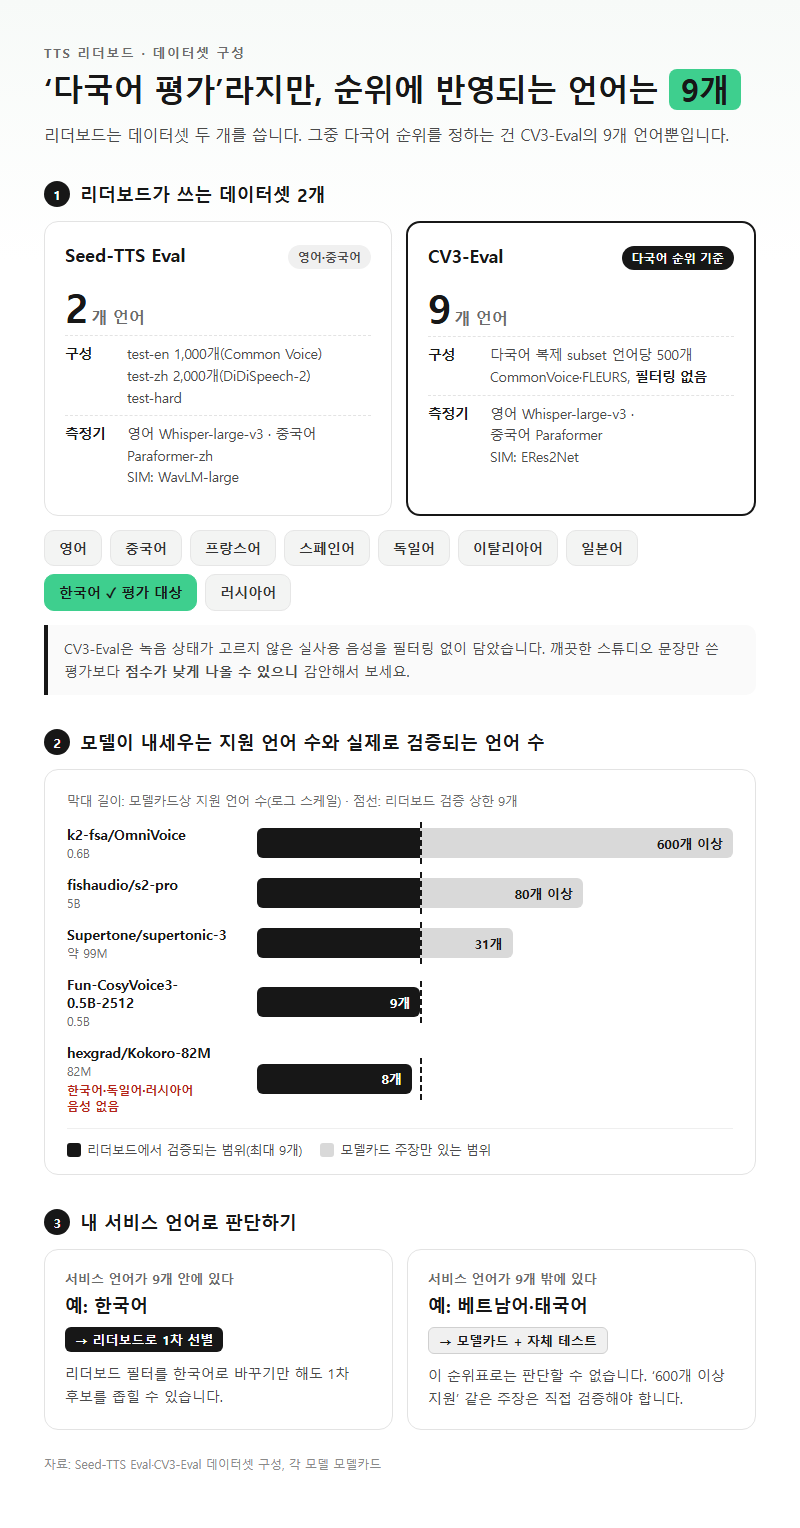
“다국어 평가”라는 이름과 달리 실제 순위에 반영되는 언어는 CV3-Eval의 9개 언어뿐입니다. 리더보드가 쓰는 데이터셋은 두 개입니다.
| 데이터셋 | 언어 | 원 구성 | 원 프로토콜의 측정기 |
|---|---|---|---|
| Seed-TTS Eval | 영어·중국어(2개) | test-en 1,000개(Common Voice), test-zh 2,000개(DiDiSpeech-2), test-hard | 영어 Whisper-large-v3, 중국어 Paraformer-zh, SIM은 WavLM-large |
| CV3-Eval | 영어·중국어·프랑스어·스페인어·독일어·이탈리아어·일본어·한국어·러시아어(9개) | 다국어 복제 subset 언어당 500개(CommonVoice·FLEURS, 필터링 없음) | 영어 Whisper-large-v3, 중국어 Paraformer, SIM은 ERes2Net |
한국어는 CV3-Eval에 포함돼 평가 대상이 됩니다. CV3-Eval의 다국어 subset은 언어당 500개 샘플을 필터링 없이 담고 있어 녹음 상태가 고르지 않은 실사용 음성에 가깝습니다. 깨끗한 스튜디오 문장만 모은 평가보다 점수가 낮게 나올 수 있으니 감안해서 봐야 합니다.
문제는 모델이 내세우는 지원 언어 수와 실제 평가 언어 수의 차이입니다. 모델카드에 적힌 지원 범위를 리더보드 평가 범위와 나란히 놓으면 이렇습니다.
| 모델 | 파라미터 | 모델카드상 지원 언어 | 리더보드에서 검증되는 언어 |
|---|---|---|---|
| k2-fsa/OmniVoice | 0.6B | 600개 이상 | 최대 9개 |
| fishaudio/s2-pro | 5B | 80개 이상 | 최대 9개 |
| Supertone/supertonic-3 | 약 99M | 31개 | 최대 9개 |
| Fun-CosyVoice3-0.5B-2512 | 0.5B | 일반 언어 9개 | 최대 9개 |
| hexgrad/Kokoro-82M | 82M | 8개 | 한국어·독일어·러시아어 음성 없음 |
9개 언어 밖의 성능은 이 순위표로 판단할 수 없습니다. 베트남어나 태국어 서비스를 기획한다면 OmniVoice가 600개 이상을 지원한다는 주장은 리더보드가 아니라 모델카드와 자체 테스트로 확인해야 합니다. 한국어 서비스는 9개 안에 들어가므로 리더보드 필터를 한국어로 바꾸기만 해도 1차 후보를 좁힐 수 있습니다.
3. 논문 수치와 섞으면 안 되는 이유 — 측정기 교체
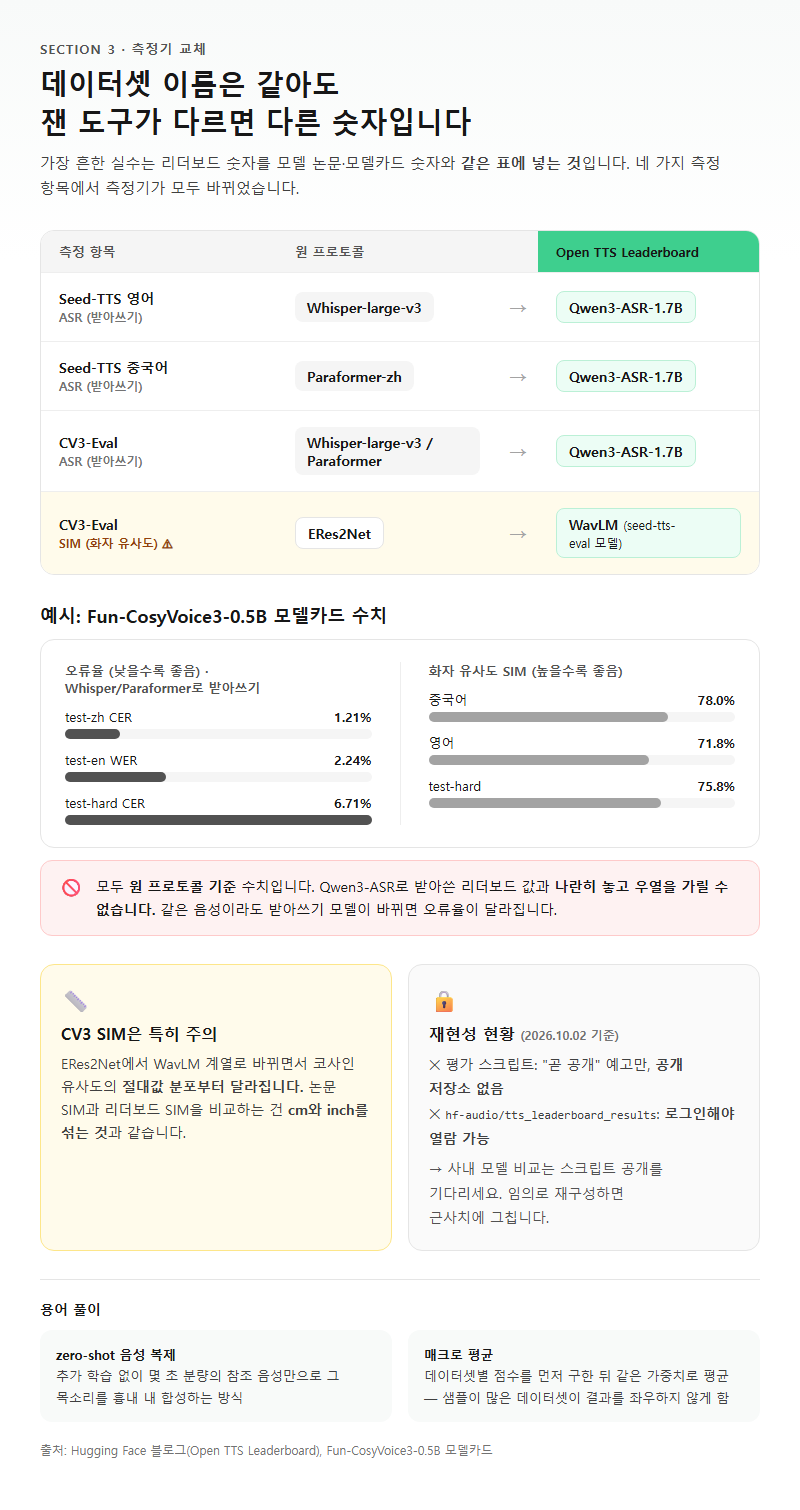
개발자가 가장 흔히 하는 실수는 리더보드 숫자를 모델 논문·모델카드 숫자와 같은 표에 넣는 것입니다. 데이터셋 이름은 같아도 측정기가 바뀌어서 두 숫자는 다른 체계에 속합니다.
| 항목 | 원 프로토콜 | Open TTS Leaderboard |
|---|---|---|
| Seed-TTS 영어 ASR | Whisper-large-v3 | Qwen3-ASR-1.7B |
| Seed-TTS 중국어 ASR | Paraformer-zh | Qwen3-ASR-1.7B |
| CV3-Eval ASR | Whisper-large-v3 / Paraformer | Qwen3-ASR-1.7B |
| CV3-Eval SIM | ERes2Net | WavLM(seed-tts-eval 모델) |
예를 들어 보겠습니다. Fun-CosyVoice3-0.5B 모델카드는 원 프로토콜 기준으로 test-zh CER 1.21%, test-en WER 2.24%, test-hard CER 6.71%를 자사 수치로 보고합니다. SIM은 중국어 78.0%, 영어 71.8%, test-hard 75.8%입니다. 모두 Whisper·Paraformer로 받아쓴 결과라서 Qwen3-ASR로 받아쓴 리더보드 값과 나란히 놓고 우열을 가릴 수 없습니다. 받아쓰기 모델이 바뀌면 같은 음성이라도 오류율이 달라집니다.
CV3-Eval의 SIM은 특히 조심해야 합니다. 원래 CV3-Eval은 ERes2Net으로 화자 유사도를 재는데, 리더보드는 WavLM 계열 모델로 통일했습니다. 화자 임베딩 모델이 다르면 코사인 유사도의 절대값 분포부터 달라집니다. CosyVoice 3 논문의 CV3 SIM 수치를 리더보드 SIM과 비교하는 건 cm와 inch를 섞는 것과 같습니다.
재현성도 아직 제한적입니다. HF 블로그는 평가 스크립트를 “곧” 공개하겠다고만 밝혔고, 2026년 10월 2일 기준 공개 저장소는 없습니다. 결과 데이터셋 hf-audio/tts_leaderboard_results도 같은 날 기준으로 로그인하지 않으면 열리지 않습니다. 사내 모델을 같은 조건에서 돌려 순위표 옆에 놓고 싶다면 스크립트 공개를 기다려야 합니다. 지금 Qwen3-ASR과 WavLM 조합을 임의로 재구성하면 전처리·정규화 차이 때문에 근사치에 그칠 가능성이 높습니다.
용어 풀이
1. zero-shot 음성 복제 — 추가 학습 없이 몇 초 분량의 참조 음성만으로 그 목소리를 흉내 내 합성하는 방식입니다.
2. 매크로 평균 — 데이터셋별 점수를 먼저 구한 뒤 같은 가중치로 평균하는 방식으로, 샘플 수가 많은 데이터셋이 결과를 좌우하지 않게 합니다.
4. 음성 복제 모드 — 같은 모델, 다른 WER
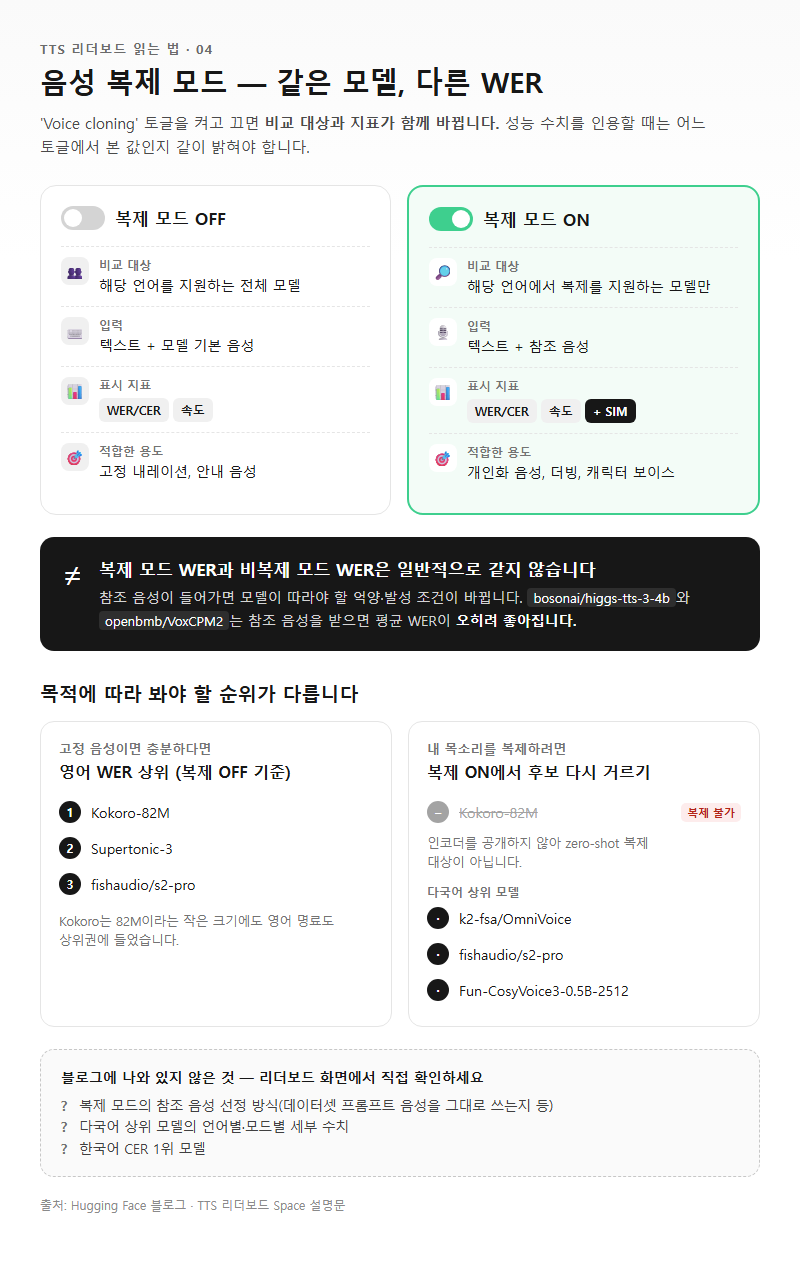
리더보드 화면에는 ‘Voice cloning’ 토글이 있는데, 이 토글을 켜고 끄면 비교 대상부터 달라집니다. 켜면 선택한 언어에서 음성 복제를 지원하는 모델만 남고 SIM 열이 추가됩니다. 끄면 각 모델의 기본 음성으로 평가하고 SIM은 표시되지 않습니다.
| 구분 | 복제 모드 OFF | 복제 모드 ON |
|---|---|---|
| 비교 대상 | 해당 언어를 지원하는 전체 모델 | 해당 언어에서 복제를 지원하는 모델만 |
| 입력 | 텍스트 + 모델 기본 음성 | 텍스트 + 참조 음성 |
| 표시 지표 | WER/CER, 속도 | WER/CER, 속도, SIM |
| 적합한 용도 | 고정 내레이션, 안내 음성 | 개인화 음성, 더빙, 캐릭터 보이스 |
Space 설명문에는 복제 모드 WER이 비복제 모드 WER과 일반적으로 같지 않다고 적혀 있습니다. 참조 음성이 들어가면 모델이 따라야 할 억양·발성 조건이 바뀌기 때문입니다. HF 블로그에 따르면 bosonai/higgs-tts-3-4b와 openbmb/VoxCPM2는 참조 음성을 받으면 평균 WER이 오히려 좋아집니다. 그러니 모델 성능을 인용할 때는 어느 토글에서 본 값인지 함께 밝혀야 비교가 성립합니다.
영어 순위를 보면 이 차이가 드러납니다. HF가 영어 WER 상위로 꼽은 모델은 Kokoro-82M, Supertonic-3, fishaudio/s2-pro입니다. 그런데 Kokoro는 인코더를 공개하지 않아 zero-shot 복제 대상이 아니므로, 이 순위는 복제를 끈 기본 음성 기준입니다. 82M이라는 작은 크기에도 영어 명료도 상위권에 들었지만, 내 목소리 복제가 목적이라면 Kokoro는 후보에서 빠집니다.
복제 모드에서 참조 음성을 어떻게 고르는지, 예컨대 데이터셋에 딸린 프롬프트 음성을 그대로 쓰는지는 HF 블로그에 따로 설명이 없습니다. 다국어 상위 모델로는 k2-fsa/OmniVoice, fishaudio/s2-pro, Fun-CosyVoice3-0.5B-2512를 꼽았는데, 언어별·모드별 세부 수치는 블로그 본문이 아니라 리더보드 화면에서 확인해야 합니다. 한국어 CER 1위가 어느 모델인지도 블로그에는 나와 있지 않습니다.
5. 도입 전 체크리스트와 자주 묻는 질문
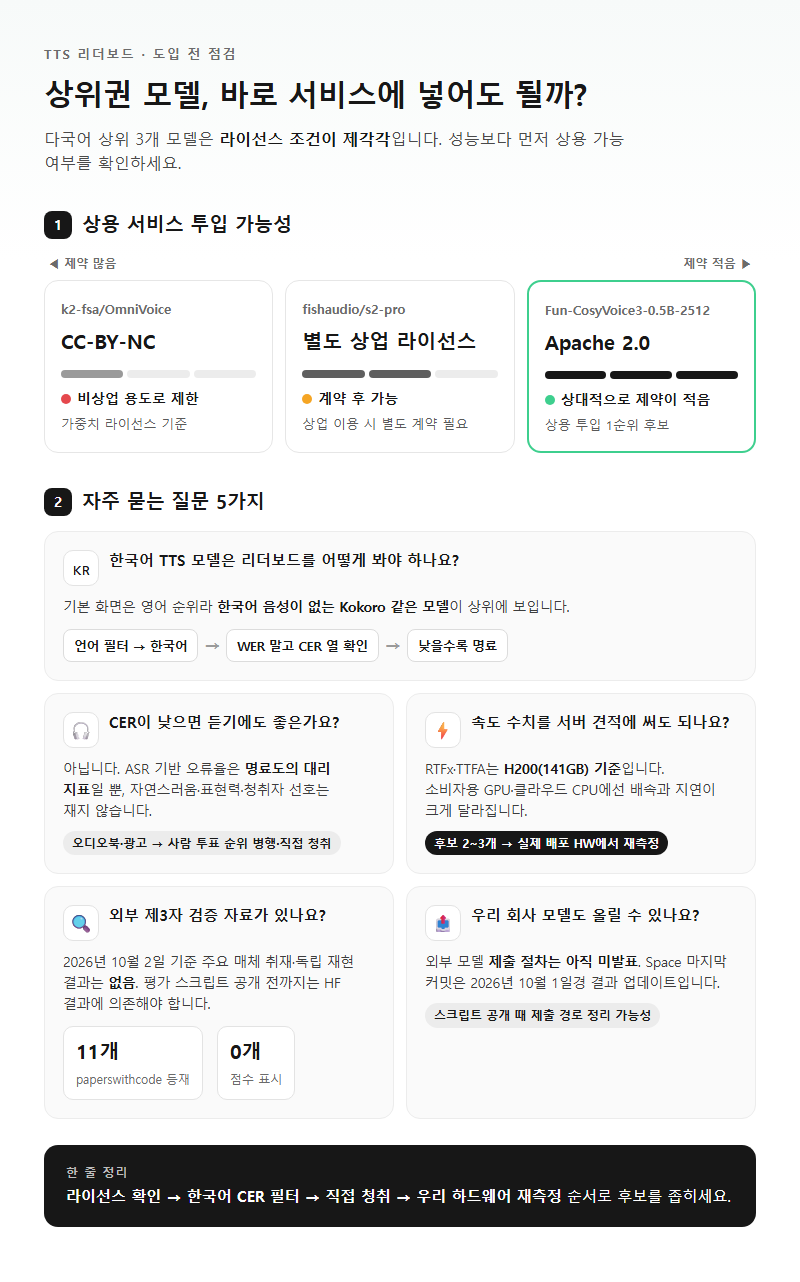
리더보드 상위권이라고 바로 서비스에 넣을 수 있는 건 아닙니다. 다국어 상위 3개 모델의 라이선스 조건이 서로 다릅니다.
| 모델 | 라이선스 조건 | 상용 서비스 투입 |
|---|---|---|
| k2-fsa/OmniVoice | 가중치 CC-BY-NC | 비상업 용도로 제한 |
| fishaudio/s2-pro | 상업 이용 시 별도 라이선스 필요 | 계약 후 가능 |
| Fun-CosyVoice3-0.5B-2512 | Apache 2.0 | 상대적으로 제약이 적음 |
Q. 한국어 TTS 모델을 고를 때 리더보드를 어떻게 봐야 하나요?
먼저 언어 필터를 한국어로 바꿉니다. 기본 화면의 영어 순위를 그대로 보면 한국어 음성이 없는 Kokoro 같은 모델이 상위에 보여 판단이 흐려집니다. 한국어는 CER로 표시되니 WER 열과 헷갈리지 않도록 주의해야 합니다.
Q. CER이 낮으면 듣기에도 좋은 모델인가요?
그렇지 않습니다. 발표자들도 ASR 기반 오류율은 명료도의 대리 지표일 뿐이고 자연스러움·표현력·청취자 선호는 직접 재지 않는다고 밝혔습니다. 사람의 선호가 궁극적 기준이라는 점도 인정했습니다. 감정 표현이나 운율이 중요한 오디오북·광고 내레이션이라면 Artificial Analysis 같은 사람 투표 기반 순위를 함께 보거나 직접 들어보고 평가해야 합니다.
Q. 리더보드 속도 수치를 우리 서버 견적에 써도 되나요?
RTFx와 TTFA는 141GB 메모리의 H200 기준입니다. 소비자용 GPU나 클라우드 CPU 인스턴스에서는 배속과 지연이 크게 달라질 수 있습니다. 후보를 2~3개로 추린 뒤 실제 배포 하드웨어에서 다시 재는 편이 안전합니다.
Q. 외부 제3자가 이 순위를 검증한 자료가 있나요?
2026년 10월 2일 기준으로 주요 기술 매체의 취재 기사나 독립 재현 결과는 없습니다. paperswithcode.co에 벤치마크 페이지가 생겨 11개 모델이 등재됐지만 점수는 표시되지 않습니다. 평가 스크립트가 공개되기 전까지는 HF가 낸 결과를 그대로 받아들일 수밖에 없습니다.
Q. 우리 회사 모델도 리더보드에 올릴 수 있나요?
HF는 외부 모델 제출 절차를 아직 발표하지 않았습니다. Space의 마지막 커밋은 2026년 10월 1일경의 결과 업데이트입니다. 제출 경로는 스크립트를 공개할 때 함께 정리될 가능성이 있습니다.
정리
Open TTS Leaderboard는 Qwen3-ASR 기반 WER·CER, H200 기준 RTFx·TTFA, WavLM 기반 SIM이라는 세 축으로 오픈 TTS 모델을 한 화면에서 비교하는 첫 표준판입니다. 다만 실제 평가 언어는 CV3-Eval의 9개이고, 받아쓰기·화자 모델이 원 프로토콜과 달라 논문 수치와 직접 비교할 수 없습니다. 음성 복제 토글에 따라 같은 모델의 WER도 달라집니다. 한국어 필터와 복제 모드를 목적에 맞게 설정하고, 라이선스와 실제 하드웨어 속도까지 확인하는 순서로 활용하면 됩니다.
참고 자료
조사 기준일: 2026년 10월 02일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (2026-10-02 확인)
– https://huggingface.co/blog/open-tts-leaderboard
– https://huggingface.co/spaces/hf-audio/open_tts_leaderboard (constants.py, 커밋 이력)
– https://github.com/BytedanceSpeech/seed-tts-eval
– https://github.com/FunAudioLLM/CV3-Eval
– https://arxiv.org/html/2505.17589 (CosyVoice 3, CV3-Eval 절)
– https://huggingface.co/Qwen/Qwen3-ASR-1.7B
– https://huggingface.co/hexgrad/Kokoro-82M , https://huggingface.co/hexgrad/Kokoro-82M/blob/main/VOICES.md
– https://huggingface.co/k2-fsa/OmniVoice , https://arxiv.org/abs/2604.00688
– https://huggingface.co/Supertone/supertonic-3
– https://huggingface.co/fishaudio/s2-pro
– https://huggingface.co/FunAudioLLM/Fun-CosyVoice3-0.5B-2512
– https://artificialanalysis.ai/text-to-speech/leaderboard
– https://paperswithcode.co/benchmark/open-tts-leaderboard
– https://hyper.ai/en/stories/30ddd413a7e752bdd6ff7b8bfd808074
– https://www.emergentmind.com/topics/seed-tts-eval (test-hard 문장 수 보조)
답글 남기기