
스위스 공공 완전 공개 LLM Apertus 1.5 8B·70B의 멀티모달 어휘 구조, 262K 컨텍스트, 사고 모드 제약, 허깅페이스 게이트·실행 요건, OLMo 3·Qwen3.5 대비 성능을 2026년 10월 기준으로 정리했습니다.
허깅페이스 Apertus 1.5, 핵심만 먼저 정리하면
Apertus 1.5는 성능 1위를 노린 모델이 아닙니다. 학습 과정까지 공개한 모델이고, 같은 완전 공개 진영에서 고른다면 수학·코드가 핵심일 때는 OLMo 3, 다국어 성능이나 데이터 출처 감사가 조건일 때는 Apertus 1.5가 맞습니다. 2026년 7월 24일 공개된 8B·70B 두 모델은 1.0 체크포인트를 이어 학습한 판입니다. 컨텍스트는 262,144토큰으로 1.0의 4배가 됐습니다. 비전 인코더 없이 어휘를 266,440개로 늘려 이미지·오디오 입력도 받습니다.
개발 주체는 ETH 취리히·EPFL·스위스국립슈퍼컴퓨팅센터(CSCS)로, Swiss AI Initiative 이름을 걸고 Apache 2.0 라이선스로 공개했습니다. 이 글은 2026년 10월 11일 제출된 기술 리포트(arXiv 2610.15542)와 허깅페이스 모델카드·릴리스 노트, 제3자 실측을 서로 대조해 썼습니다. 구조·후학습·공개 범위·실행 요건·비교 성능 순서로 다루고, 수치는 2026년 10월 17일 기준입니다. 벤치마크는 대부분 Apertus 팀이 자체 조건으로 잰 값이므로 경쟁사 자체 발표와 바로 맞대면 안 된다는 점을 먼저 밝혀 둡니다.
| 항목 | Apertus 1.5 8B | Apertus 1.5 70B |
|---|---|---|
| 허깅페이스 저장소 | swiss-ai/Apertus-v1.5-8B | swiss-ai/Apertus-v1.5-70B |
| Hub 표기 파라미터 | 9B | 72B |
| 1.5 추가 학습 토큰 | 4T | 2T |
| 누적 사전학습 토큰 | 19T | 17T |
| 컨텍스트 | 262,144토큰 | 262,144토큰 |
| 입력 / 출력 | 텍스트·이미지·오디오 / 텍스트 | 텍스트·이미지·오디오 / 텍스트 |
| 후학습 마지막 단계 SDPO | 적용 | 미적용 |
| IFEval(사고 모드 끔) | 87.1 | 87.8 |
Q1. Apertus 1.5는 1.0과 구조가 무엇이 다르고, 이미지·음성은 어떻게 읽나요?
아키텍처는 1.0과 같습니다. 바뀐 것은 어휘·컨텍스트·후학습 세 가지입니다. EPFL의 Martin Jaggi는 발표 당시 “Rather than introducing an entirely new model, Apertus 1.5 incorporates feedback from the first release”라고 설명했습니다. 새 모델을 내기보다 첫 릴리스에서 받은 피드백을 반영했다는 뜻입니다. 실제로 팀은 15T 토큰으로 사전학습한 1.0 체크포인트 위에서 Alps 슈퍼컴퓨터로 멀티모달 토큰을 더 학습시켰습니다.
추가 학습량은 8B가 4T, 70B가 2T여서, 크기와 반대로 작은 모델이 더 많이 배웠습니다. 누적 사전학습량은 8B가 19T, 70B가 17T이며 둘 다 1.0의 15T를 포함한 값입니다. 컨텍스트도 65,536토큰에서 262,144토큰으로 함께 늘었습니다.
비전 인코더를 붙이지 않고 어휘를 늘렸다
이미지 이해를 넣을 때는 보통 언어모델 앞에 별도 비전 인코더를 붙입니다. Apertus 1.5는 그 대신 이미지·오디오를 이산 코드로 바꿔 어휘에 넣었습니다. 기존 텍스트 어휘 옆에 이미지 코드, 오디오 코드, 예약 슬롯을 더해 전체 어휘가 266,440개가 됐습니다.
| 어휘 구간 | 개수 | 만드는 도구·용도 |
|---|---|---|
| 텍스트 | 131,072 | 기존 텍스트 토큰 |
| 이미지 코드 | 131,072 | Emu3.5 토크나이저 |
| 오디오 코드 | 4,096 | WavTokenizer |
| 예약 슬롯 | 200 | 멀티모달 확장용 |
| 합계 | 266,440 | — |
이미지는 Emu3.5 토크나이저로 바꾸는데, 512×512 한 장이 1,024토큰입니다. 오디오는 WavTokenizer를 거치면 초당 40토큰입니다. 텍스트와 이미지·오디오가 한 토큰 열에 섞여 들어가므로, 입력을 짤 때는 이미지가 많을수록 컨텍스트가 빨리 줄어든다는 점을 감안해야 합니다.
출력은 사정이 다릅니다. 출력 헤드가 텍스트 전용이라 이미지와 음성을 이해한 뒤 글로 답할 뿐, 이미지나 음성을 만들어 내지는 못합니다. 모델카드 기준 입력은 텍스트·이미지·오디오이고, 이 가운데 오디오는 아직 실험 단계이며 비디오는 직접 넣을 수 없습니다. 팀도 지각(perception) 과제나 영어 같은 고자원 언어 받아쓰기에서는 전문 모델이 앞선다고 인정했습니다.
모델 이름과 실제 크기도 조금 다릅니다. 허깅페이스 Hub 메타데이터에는 8B가 9B, 70B가 72B로 표기돼 있습니다. 팀은 이 차이를 공식적으로 설명하지 않았고, 어휘 확장분이 반영된 결과로 짐작할 뿐입니다. 메모리를 산정할 때는 모델 이름 대신 실제 가중치 파일 크기를 기준으로 삼는 편이 안전합니다.
용어 풀이
1. 비전 인코더 — 이미지를 언어모델이 읽을 수 있는 벡터로 바꿔 주는 별도 신경망으로, Apertus 1.5는 이 부품을 쓰지 않습니다.
2. 이미지 토크나이저 — 이미지를 정해진 코드북의 정수 코드 열로 바꿔 텍스트 토큰처럼 다루게 해 주는 변환기입니다.
3. 출력 헤드 — 다음 토큰의 확률을 계산하는 마지막 층으로, 여기에 연결된 어휘만 생성할 수 있습니다.
Q2. 사고 모드와 후학습은 어떻게 짜여 있고, 켜면 무엇을 잃나요?
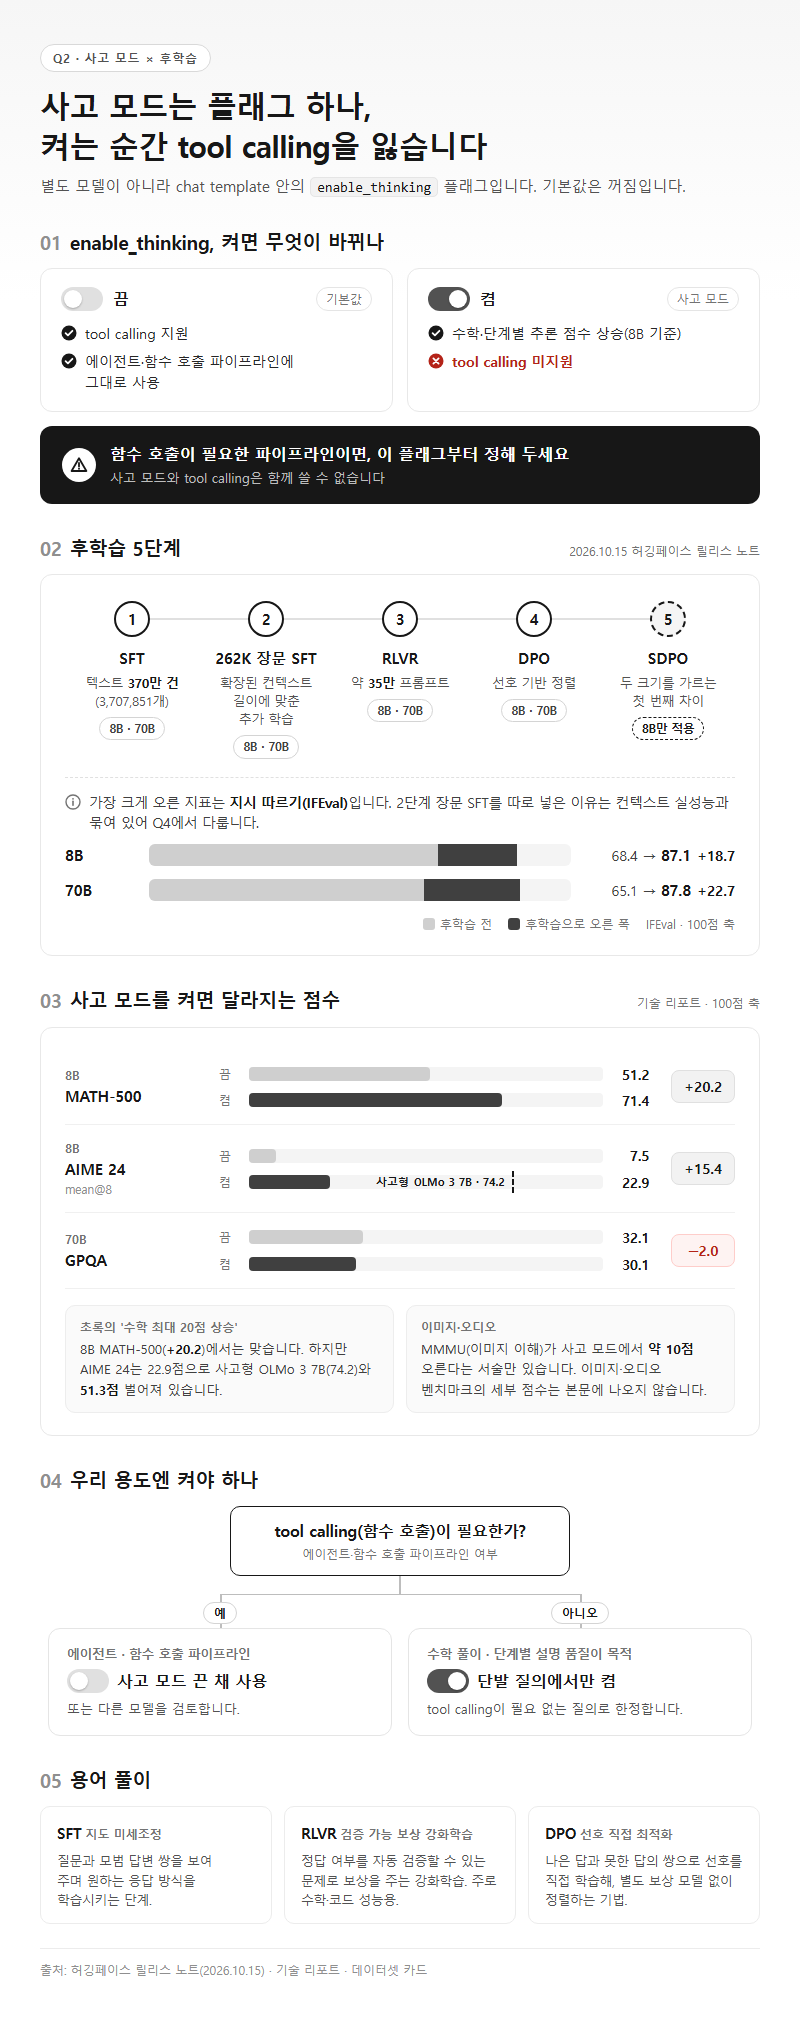
사고 모드는 별도 모델이 아니라 enable_thinking 플래그입니다. chat template에 들어 있는 이 플래그는 기본값이 꺼짐인데, 켜는 순간 큰 제약이 하나 생깁니다. 사고 모드에서는 tool calling을 지원하지 않습니다. 함수 호출이 필요한 파이프라인이라면 이 플래그부터 정해 두어야 합니다.
후학습 5단계
2026년 10월 15일 허깅페이스 릴리스 노트에 공개된 후학습 순서는 아래와 같습니다. 두 크기를 가르는 첫 번째 차이는 SDPO가 8B에만 적용됐다는 점입니다.
| 순서 | 단계 | 규모·특징 |
|---|---|---|
| 1 | SFT | 텍스트 370만 건(데이터셋 카드 기준 3,707,851개) |
| 2 | 262K 장문 SFT | 확장된 컨텍스트 길이에 맞춘 추가 학습 |
| 3 | RLVR | 약 35만 프롬프트 |
| 4 | DPO | 선호 기반 정렬 |
| 5 | SDPO | 8B에만 적용 |
이 과정의 효과가 가장 크게 드러난 지표는 지시 따르기입니다. 기술 리포트 기준 IFEval은 8B가 68.4에서 87.1로, 70B가 65.1에서 87.8로 올랐습니다. 2단계 장문 SFT를 따로 넣은 이유는 컨텍스트 실성능과 묶여 있어 Q4에서 다룹니다.
사고 모드를 켜면 달라지는 점수
| 모델·지표 | 사고 모드 끔 | 사고 모드 켬 | 변화 |
|---|---|---|---|
| 8B MATH-500 | 51.2 | 71.4 | +20.2 |
| 8B AIME 24(mean@8) | 7.5 | 22.9 | 상승 |
| 70B GPQA | 32.1 | 30.1 | 하락 |
기술 리포트 초록에 적힌 ‘수학 최대 20점 상승’은 8B MATH-500에서는 맞는 수치입니다. 다만 AIME 24는 22.9로, 사고형 OLMo 3 7B의 74.2와 격차가 큽니다. 70B GPQA는 사고 모드를 켜자 오히려 떨어졌습니다. 리포트에는 이미지 이해 벤치마크 MMMU가 사고 모드에서 약 10점 오른다는 서술이 있지만, 이미지·오디오 벤치마크의 세부 점수는 본문 서술에 나오지 않습니다.
실무 판단은 단순합니다. 에이전트나 함수 호출 파이프라인이라면 사고 모드를 끈 채 쓰거나 다른 모델을 검토해야 합니다. 수학 풀이나 단계별 설명 품질이 목적이라면, tool calling이 필요 없는 단발 질의에서만 켜는 구성이 맞습니다.
용어 풀이
1. SFT(지도 미세조정) — 질문과 모범 답변 쌍을 보여 주며 원하는 응답 방식을 학습시키는 단계입니다.
2. RLVR — 정답 여부를 자동으로 검증할 수 있는 문제로 보상을 주는 강화학습으로, 주로 수학·코드 성능을 끌어올릴 때 씁니다.
3. DPO — 나은 답과 못한 답의 쌍으로 선호를 직접 학습시켜, 별도 보상 모델 없이 정렬하는 기법입니다.
Q3. 허깅페이스에서 받는 Apertus 1.5, 가격과 ‘완전 공개’ 범위는 어디까지인가요?
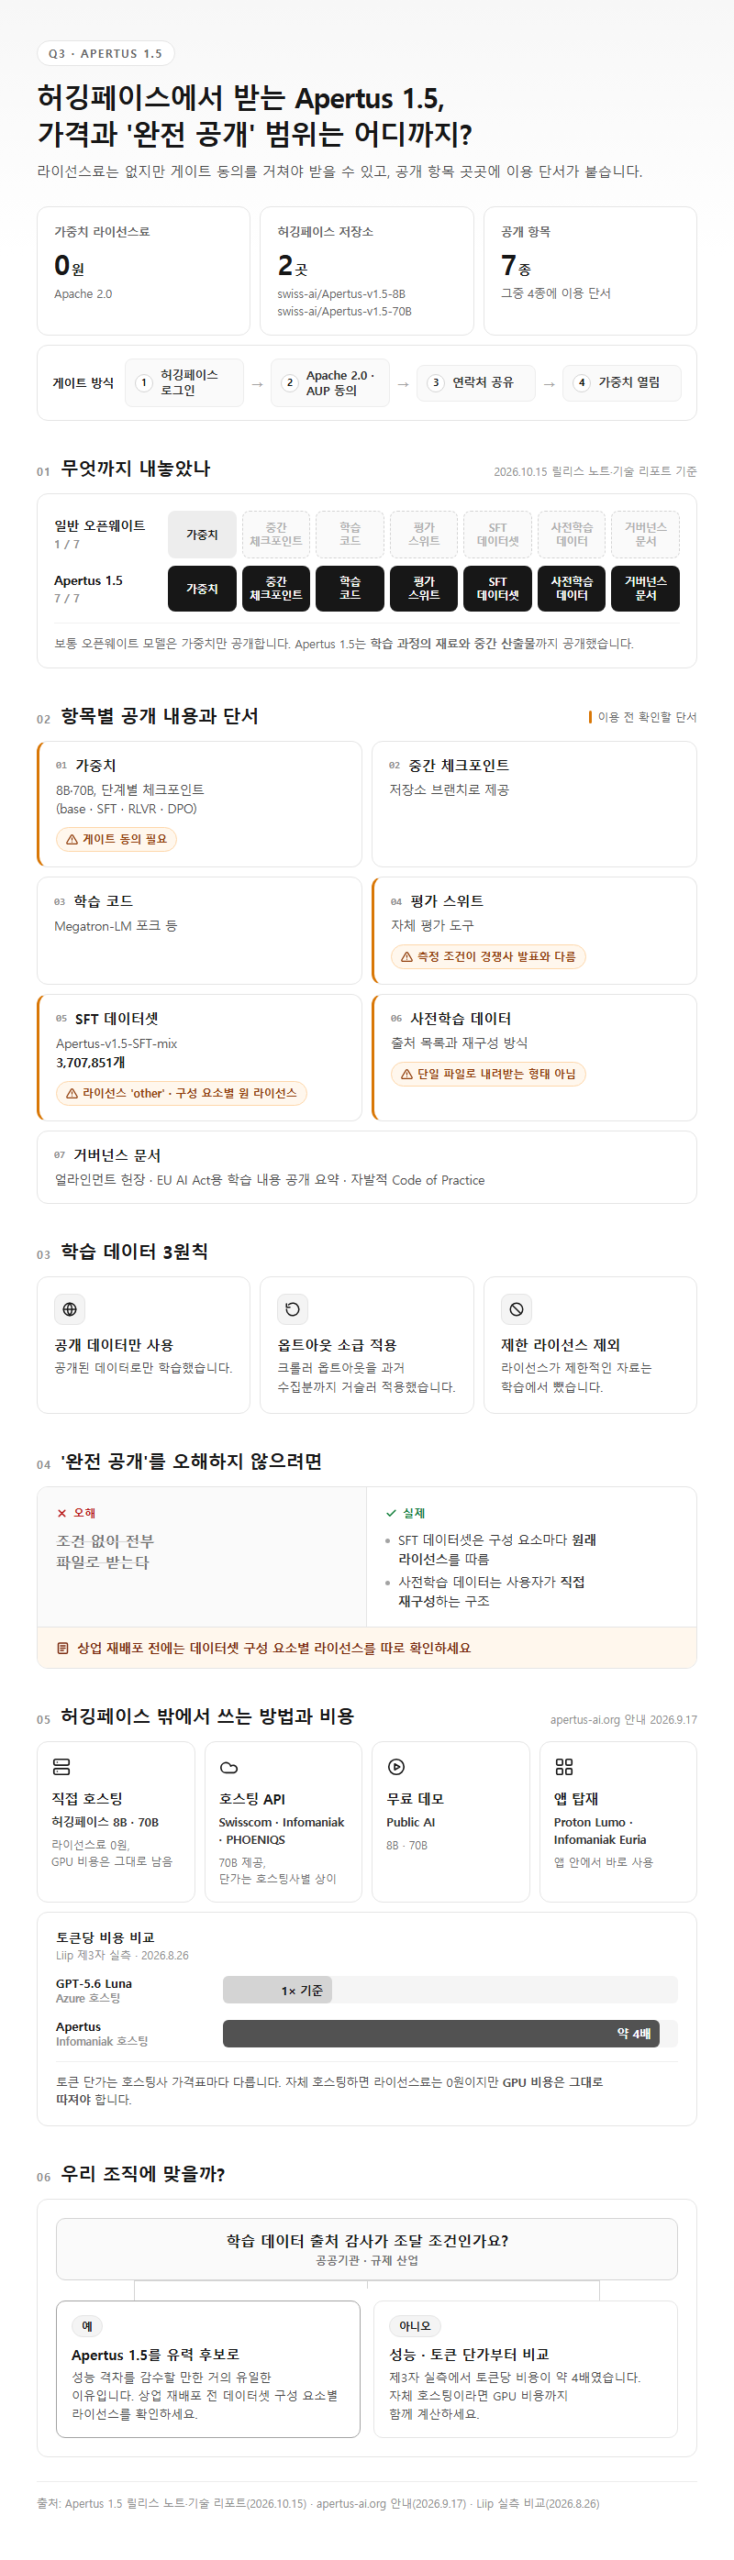
허깅페이스에서 받는 가중치에는 라이선스료가 없습니다(Apache 2.0). 그렇다고 바로 내려받을 수는 없습니다. 로그인한 뒤 Apache 2.0과 이용 정책(AUP)에 동의하고 연락처를 공유해야 열리는 게이트 방식입니다. 저장소는 swiss-ai/Apertus-v1.5-8B와 swiss-ai/Apertus-v1.5-70B 두 곳입니다.
‘완전 공개’에 실제로 들어 있는 것
오픈웨이트 모델은 보통 가중치만 내놓습니다. Apertus 1.5는 그와 달리 학습 과정의 재료와 중간 산출물까지 공개했습니다. 2026년 10월 15일 릴리스 노트와 기술 리포트를 기준으로 공개 범위와 단서를 표로 정리했습니다.
| 공개 항목 | 내용 | 단서 |
|---|---|---|
| 가중치 | 8B·70B, 단계별 체크포인트(base·SFT·RLVR·DPO) | 게이트 동의 필요 |
| 중간 체크포인트 | 저장소 브랜치로 제공 | — |
| 학습 코드 | Megatron-LM 포크 등 | — |
| 평가 스위트 | 자체 평가 도구 | 측정 조건이 경쟁사 발표와 다름 |
| SFT 데이터셋 | Apertus-v1.5-SFT-mix, 3,707,851개 | 라이선스 ‘other’, 구성 요소별 원 라이선스 적용 |
| 사전학습 데이터 | 출처 목록과 재구성 방식 | 단일 파일로 내려받는 형태가 아님 |
| 거버넌스 문서 | 얼라인먼트 헌장, EU AI Act용 학습 내용 공개 요약, 자발적 Code of Practice | — |
데이터 원칙은 세 가지입니다. 공개 데이터만 썼고, 크롤러 옵트아웃은 과거 수집분까지 소급 적용했으며, 라이선스가 제한적인 자료는 뺐습니다. 공공기관이나 규제 산업에서 학습 데이터 출처 감사가 조달 조건으로 걸려 있다면, 이 원칙이 성능 격차를 감수할 만한 거의 유일한 이유가 됩니다.
‘완전 공개’를 ‘조건 없이 전부 파일로 받는다’로 이해하면 오해입니다. SFT 데이터셋은 구성 요소마다 원래 라이선스를 따르고, 사전학습 데이터는 사용자가 직접 재구성하는 구조입니다. 그래서 상업 재배포 전에는 데이터셋 구성 요소별 라이선스를 따로 확인해야 합니다.
허깅페이스 밖에서 쓰는 비용
직접 호스팅하지 않는 길도 있습니다. 2026년 9월 17일 apertus-ai.org 안내에 따르면 Swisscom·Infomaniak·PHOENIQS가 70B API를 제공합니다. Public AI는 8B·70B 무료 데모를 운영하고, Proton Lumo와 Infomaniak Euria 앱에도 탑재됐습니다.
토큰 단가는 호스팅사 가격표에 따라 달라집니다. 공개된 제3자 비교로는 Liip의 2026년 8월 26일 실측이 있습니다. 여기서 Infomaniak에 호스팅한 Apertus의 토큰당 비용은 Azure에 호스팅한 GPT-5.6 Luna의 약 4배였습니다. 자체 호스팅하면 라이선스료는 붙지 않지만 GPU 비용은 그대로 남는다는 점도 함께 따져야 합니다.
생태계 규모를 보여 주는 수치도 있습니다. 2026년 10월 15일 릴리스 노트는 팀의 허깅페이스 분석을 근거로 Apertus 누적 다운로드를 500만으로 밝혔습니다. swissinfo는 2026년 9월 2일 보도에서 커뮤니티 리드 집계를 인용해 허깅페이스 다운로드 400만 이상, 외부 배포 70곳 이상, 파생 모델 100개 이상을 전했습니다. 두 수치 모두 1.5 단독이 아니라 Apertus 전체 기준입니다.
문서 갱신은 늦은 편입니다. 기술 리포트는 가중치 공개 79일 뒤인 2026년 10월 11일에 나왔고 저자는 138명입니다. 그런데 2026년 10월 17일에도 모델카드에는 기술 리포트가 몇 주 안에 공개된다는 안내가 그대로 남아 있습니다. 세부 사양은 모델카드보다 리포트와 릴리스 노트를 기준으로 보는 편이 정확합니다.
Q4. 8B·70B를 직접 돌리려면 무엇이 필요하고, 262K 컨텍스트는 믿어도 되나요?
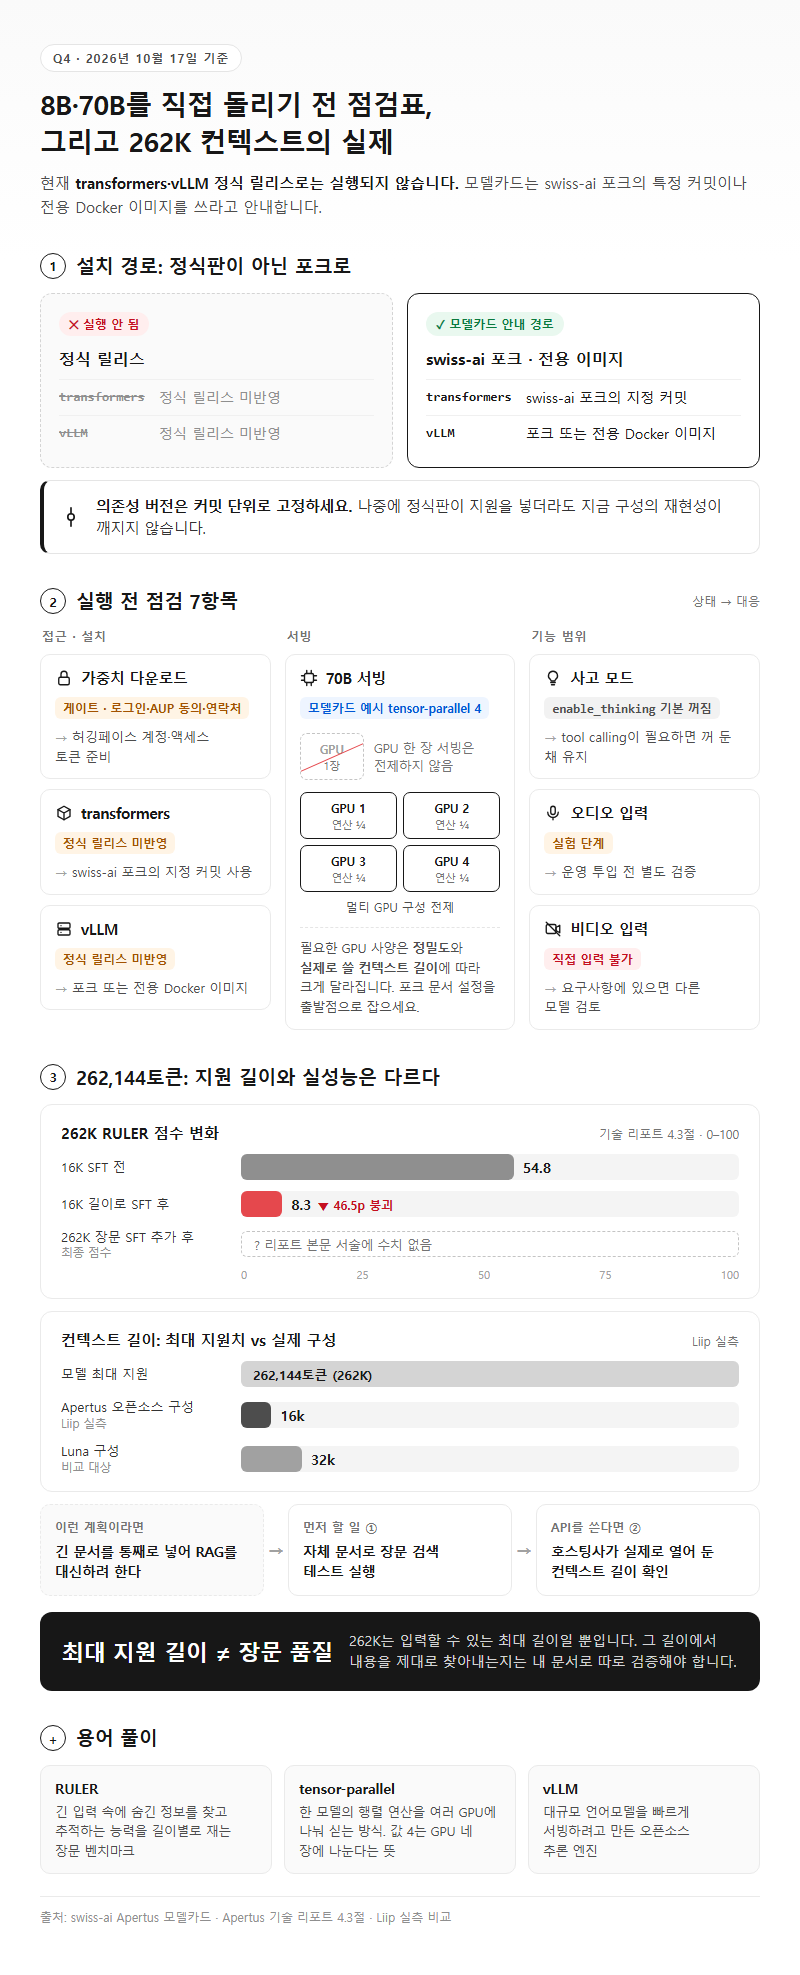
2026년 10월 17일 기준으로 transformers·vLLM 정식 릴리스로는 실행되지 않습니다. 모델카드는 swiss-ai 포크의 특정 커밋이나 전용 Docker 이미지를 쓰라고 안내합니다. 포크 버전에 기대는 구성이니 의존성 버전을 커밋 단위로 고정해 두세요. 그래야 나중에 정식판이 지원을 넣을 때 재현성이 깨지지 않습니다.
| 확인 항목 | 2026년 10월 17일 기준 상태 | 대응 |
|---|---|---|
| 가중치 다운로드 | 게이트(로그인·AUP 동의·연락처) | 허깅페이스 계정·액세스 토큰 준비 |
| transformers | 정식 릴리스 미반영 | swiss-ai 포크의 지정 커밋 사용 |
| vLLM | 정식 릴리스 미반영 | 포크 또는 전용 Docker 이미지 |
| 70B 서빙 | 모델카드 예시 tensor-parallel 4 | 멀티 GPU 구성 전제 |
| 사고 모드 | enable_thinking 기본 꺼짐 |
tool calling이 필요하면 꺼 둔 채 유지 |
| 오디오 입력 | 실험 단계 | 운영 투입 전 별도 검증 |
| 비디오 입력 | 직접 입력 불가 | 요구사항에 있으면 다른 모델 검토 |
70B는 모델카드의 vLLM 예시 설정부터 tensor-parallel 4여서 GPU 한 장으로 서빙하는 구성을 전제하지 않습니다. 필요한 GPU 사양은 정밀도와 실제로 쓸 컨텍스트 길이에 따라 크게 달라집니다. 포크 문서의 설정을 출발점으로 잡는 것이 현실적입니다.
262,144토큰, 지원 길이와 실성능은 다르다
기술 리포트 4.3절에는 컨텍스트 확장 과정의 시행착오가 적혀 있습니다. 16K 길이로 SFT를 하자 262K RULER 점수가 54.8에서 8.3으로 무너졌고, 그래서 262K 장문 SFT 단계를 따로 넣었습니다. 그 뒤의 최종 RULER 점수는 리포트 본문 서술에 수치로 나오지 않습니다. 결국 최대 지원 길이와 장문 처리 품질은 별개로 봐야 합니다.
현장 구성을 봐도 마찬가지입니다. Liip 실측에서 Apertus를 붙인 오픈소스 구성의 컨텍스트는 16k였고, 비교 대상인 Luna 구성은 32k였습니다. 긴 문서를 통째로 넣어 RAG를 대신할 생각이라면 자체 문서로 장문 검색 테스트를 먼저 돌리는 것이 순서입니다. API를 쓴다면 호스팅사가 실제로 열어 둔 컨텍스트 길이도 따로 확인해야 합니다.
용어 풀이
1. RULER — 긴 입력 속에 숨긴 정보를 찾고 추적하는 능력을 길이별로 재는 장문 벤치마크입니다.
2. tensor-parallel — 한 모델의 행렬 연산을 여러 GPU에 나눠 싣는 방식으로, 값 4는 GPU 네 장에 나눈다는 뜻입니다.
3. vLLM — 대규모 언어모델을 빠르게 서빙하려고 만든 오픈소스 추론 엔진입니다.
Q5. OLMo 3·Qwen3.5 대신 Apertus 1.5를 골라야 하는 경우는 언제인가요?
범용 성능만 보면 Apertus 1.5를 고를 이유는 약합니다. 같은 조건에서 재면 학습 데이터를 공개하지 않는 오픈웨이트 진영의 Qwen3.5가 거의 모든 지표에서 앞서고, 수학·코드는 같은 완전 공개 진영의 OLMo 3이 앞섭니다. Apertus 1.5가 맞는 자리는 데이터 출처 감사가 필요한 공공·규제 환경, 유럽 다국어와 스위스 문맥, 그리고 완전 공개 모델 가운데 이미지·오디오 입력이 필요한 경우입니다.
아래 수치는 모두 기술 리포트 Table 23·24에서 가져왔습니다. 자체 LM Evaluation Harness 포크와 chat template을 쓰고 전 모델의 사고 모드를 끈 상태에서, 모든 모델을 같은 조건에서 잰 값입니다. 빈칸(-)은 해당 표에서 이 글이 다루지 않은 값입니다.
8B급 비교
| 지표 | Apertus 1.5 8B | OLMo 3 7B | Qwen3.5 9B | EuroLLM 9B |
|---|---|---|---|---|
| MMLU | 70.5 | 67.1 | 83.7 | 62.0 |
| MMLU-Pro | 48.8 | 52.7 | – | – |
| TruthfulQA | 56.2 | 57.5 | – | – |
| Global-MMLU | 59.4 | 46.4 | 74.6 | – |
| SwitzerlandQA | 64.6 | 53.4 | 67.9 | – |
| IFEval | 87.1 | 82.8 | 84.3 | 66.0 |
| AlpacaEval(LC) | 47.2 | 57.3 | 71.8 | 64.9 |
| MATH-500 | 51.2 | 77.2 | 87.2 | – |
| HumanEval | 68.8 | 81.6 | – | – |
지시 따르기(IFEval)는 네 모델 중 Apertus 1.5 8B가 가장 높습니다. 다국어 지표인 Global-MMLU와 SwitzerlandQA는 OLMo 3 7B보다 크게 앞서지만 Qwen3.5 9B에는 못 미칩니다. 반면 대화 품질 지표인 AlpacaEval(LC)은 네 모델 중 가장 낮고, MATH-500과 HumanEval에서는 OLMo 3 7B와 격차가 뚜렷합니다. EuroLLM 9B와 견주면 MMLU와 IFEval은 앞서고 AlpacaEval은 뒤처집니다.
70B급 비교
| 지표 | Apertus 1.5 70B | OLMo 3.1 32B | Gemma 4 31B | Llama 3.3 70B |
|---|---|---|---|---|
| MMLU | 76.5 | – | 90.5 | – |
| GPQA | 32.1 | – | 72.1 | – |
| IFEval | 87.8 | – | 90.9 | 90.2 |
| MATH-500 | 64.0 | 79.6 | – | – |
| HumanEval | 70.3 | 86.9 | – | – |
70B급에서는 더 불리합니다. 파라미터가 약 46%인 OLMo 3.1 32B가 MATH-500과 HumanEval에서 모두 앞서고, Gemma 4 31B는 MMLU와 GPQA에서 큰 차이로 위에 있습니다. 70B의 IFEval 87.8도 Llama 3.3 70B와 Gemma 4 31B보다 낮습니다. 8B처럼 지시 따르기 1위에 오르지도 못합니다.
70B는 계획한 토큰의 절반만 학습했습니다. 기술 리포트 3.2절은 학습 노드가 다음 Apertus 학습으로 재배정됐기 때문이라고 설명하며, SDPO 단계도 빠졌다고 밝혔습니다. 2026년 7월 24일 보도자료에는 없던 내용입니다. 리포트에는 70B SDPO에서 성능이 후퇴한 원인이 토크나이저 설정 불일치였다는 서술이 있지만, 2026년 10월 17일 기준 SDPO를 적용한 70B를 다시 배포한다는 공지는 없습니다. 크기를 고를 때는 70B가 8B보다 덜 다듬어진 상태라는 점을 고려해야 합니다.
같은 모델도 측정 조건이 바뀌면 점수가 달라진다
| OLMo 3 7B Instruct | Apertus 팀 측정 | AI2 자체 발표 |
|---|---|---|
| MMLU | 67.1 | 69.1 |
| IFEval | 82.8 | 85.6 |
| GPQA | 31.5 | 40.4 |
| BBH | 58.9 | 71.2 |
| AlpacaEval(LC) | 57.3 | 40.9 |
같은 OLMo 3 7B Instruct인데도 점수가 이만큼 갈립니다. AI2 모델카드의 평가 설정은 temperature 0.6, top_p 0.95, max_tokens 32768로, Apertus 리포트의 하니스·샘플링 조건과 다릅니다. GPQA·BBH는 AI2 발표가 훨씬 높고 AlpacaEval은 반대입니다. 리포트 표의 경쟁사 점수를 그 회사 공식 발표와 섞어 쓰면 결론이 뒤집힐 수 있습니다.
발표문과 실제가 갈리는 지점
| 발표 내용 | 실제 조건 |
|---|---|
| 8B가 비슷한 크기 오픈웨이트보다 지시 따르기·다국어에서 앞섬(릴리스 노트) | 지시 따르기는 맞음(IFEval 87.1 대 Qwen3.5 9B 84.3). 다국어는 같은 리포트 Table 23에서 Qwen3.5 9B가 앞섬 |
| 8B가 완전 공개 동급 중 지식 분야 선두(초록) | MMLU는 OLMo 3 7B보다 높지만 MMLU-Pro·TruthfulQA는 뒤짐 |
| 8B 지시 따르기가 모든 비교 모델보다 높음(초록) | 사고 모드를 끈 prompt-level strict 기준에서만 성립. 70B는 Llama 3.3 70B·Gemma 4 31B보다 낮음 |
| 사고 모드로 수학 최대 20점 상승(초록) | MATH-500은 맞음. AIME 24는 사고형 OLMo 3 7B와 격차가 크고 70B GPQA는 하락 |
| 지원 언어 수 | 1.0 모델카드 1,811개, apertus-ai.org 1,500개 이상, 기술 리포트 1,000개 이상으로 서로 다르고 1.5 모델카드에는 숫자가 없음 |
발표문의 주장은 대부분 특정 지표·특정 조건에서만 맞는 문장입니다. 지원 언어 수처럼 공식 문서끼리 어긋나는 항목도 있으니, 도입 검토 문서에는 출처와 조건을 함께 적어 두는 것이 좋습니다.
취리히시 RAG 챗봇 실측
Liip은 2026년 8월 26일 블로그에서 70B를 취리히시 공식 문서 기반 RAG 챗봇에 붙여 GPT-5.6 Luna와 비교했습니다. 실사용 평균 점수는 1.0의 3.73에서 1.5의 3.99로 올랐고, Luna는 4.81이었습니다. 출처에 충실한 정도를 보는 faithfulness는 0.56 대 0.84로 차이가 컸습니다.
1인이 평가한 20문항 통제 테스트에서는 평균 4.70 대 5.15였습니다. 수용 가능한 답변 비율은 1.5가 85%로 1.0의 100%보다 낮았고, Luna는 95%였습니다. 1.0보다 나빠진 지표도 있었다는 뜻입니다. 같은 질문이 독일어로는 6/6, 영어로는 2/6을 받기도 했습니다. 작성자는 격차의 상당 부분이 임베딩·리랭커 같은 오픈소스 RAG 부품 탓이라고 봤습니다. 이 결과는 모델만 따로 잰 성적이 아닙니다.
독립 리더보드의 사정도 비슷합니다. Artificial Analysis에는 2026년 10월 17일 기준 1.5 항목이 없고 1.0(2509) Instruct만 올라 있습니다. 그 1.0도 70B가 39개 중 38위, 8B가 74개 중 70위로 하위권이며, 점수는 독립 평가 전 추정치로 표기돼 있습니다. swissinfo 2026년 9월 2일 보도에서 스위스 AI 기업 Artificialy는 번역·다국어는 좋지만 에이전트 능력은 다른 오픈웨이트 모델에 못 미친다고 평가했습니다.
상황별 선택 기준
| 상황 | 권장 | 판단 근거 |
|---|---|---|
| 수학·코드 생성이 핵심 | OLMo 3 7B / OLMo 3.1 32B | MATH-500·HumanEval 모두 OLMo 우위 |
| 데이터 공개 여부와 무관하게 성능 우선 | Qwen3.5 9B | 8B급 MMLU 83.7, MATH-500 87.2 |
| 학습 데이터 출처 감사·옵트아웃 준수가 조달 조건 | Apertus 1.5 | 공개 데이터만 사용, 옵트아웃 소급 적용 |
| 완전 공개 모델 중 다국어·스위스 문맥 | Apertus 1.5 8B | Global-MMLU 59.4 대 OLMo 3 7B 46.4 |
| 완전 공개 모델에 이미지·오디오 입력 필요 | Apertus 1.5 | 어휘 확장 방식의 멀티모달 입력 |
| 에이전트·tool calling 중심 | 다른 오픈웨이트 모델 검토 | 사고 모드에서 tool calling 불가, Artificialy 평가 |
| 70B급 범용 성능 | Gemma 4 31B 등 | MMLU 90.5, GPQA 72.1 |
정리
Apertus 1.5 구조의 핵심은 세 가지입니다. 비전 인코더 없이 어휘를 266,440개로 늘린 멀티모달 입력, 262,144토큰 컨텍스트, 그리고 단계별 체크포인트와 데이터 출처 목록까지 내놓은 공개 범위입니다. 대신 2026년 10월 17일 기준으로 transformers·vLLM 정식판이 지원하지 않고, 사고 모드에서는 tool calling을 쓸 수 없으며, 70B는 계획 토큰의 절반만 학습했습니다. 그래서 범용 성능 경쟁에서는 OLMo 3·Qwen3.5에 밀립니다.
ETH의 Imanol Schlag는 “Apertus is not about competing with frontier models from private companies”라고 밝혔습니다. 그 말대로 이 모델은 출처를 감사할 수 있는 공공 인프라라는 기준으로 평가해야 맞습니다. 다음 판인 2.0은 릴리스 노트 기준 약 600B 규모의 sparse/MoE 구조로, 2027년에 나올 예정입니다. Blick은 2026년 10월 2일 보도에서 Alps의 GPU 수천 장으로 이미 학습 중이며 2027년 1분기에 공개된다고 전했습니다.
참고 자료
조사 기준일: 2026년 10월 17일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (확인일 2026-10-17)
- CSCS 보도자료 (2026-07-24): https://www.cscs.ch/science/computer-science-hpc/2026/apertus-15-building-the-next-generation-of-open-ai-infrastructure
- EPFL 뉴스 (2026-07-24): https://actu.epfl.ch/news/apertus-15-building-the-next-generation-of-open–2/
- HF 모델카드 Apertus-v1.5-70B: https://huggingface.co/swiss-ai/Apertus-v1.5-70B
- HF 모델카드 Apertus-v1.5-8B: https://huggingface.co/swiss-ai/Apertus-v1.5-8B
- HF 블로그 Apertus 1.5 Release Notes (2026-10-15): https://huggingface.co/blog/swiss-ai/apertus-v15-release-notes
- 기술 리포트 arXiv 2610.15542 초록: https://arxiv.org/abs/2610.15542
- 기술 리포트 HTML(Table 9·23·24·25, 3.2·3.4·4.3절): https://arxiv.org/html/2610.15542v1
- HF 데이터셋 Apertus-v1.5-SFT-mix: https://huggingface.co/datasets/swiss-ai/Apertus-v1.5-SFT-mix
- apertus-ai.org GA 안내 (2026-09-17): https://www.apertus-ai.org/articles/2026-09-apertus-1-5-ga/
- apertus-ai.org 개요·로드맵: https://www.apertus-ai.org/docs/overview/
- Public AI 공지 (2026-07-24, 자사 서비스 제공 사실만): https://publicai.co/stories/apertus-1-5
- HF 모델카드 Apertus-70B-2509(1.0): https://huggingface.co/swiss-ai/Apertus-70B-2509
- AI2 HF 모델카드 Olmo-3-7B-Instruct: https://huggingface.co/allenai/Olmo-3-7B-Instruct
- arXiv 2605.29128 (Apertus v1.1 증류·양자화): https://arxiv.org/abs/2605.29128
- Artificial Analysis Apertus 70B Instruct: https://artificialanalysis.ai/models/apertus-70b-instruct
- Artificial Analysis Apertus 8B Instruct: https://artificialanalysis.ai/models/apertus-8b-instruct
- Liip, Apertus 1.5 first impressions (2026-08-26): https://www.liip.ch/en/blog/apertus-1-5-first-impressions-from-using-switzerland-s-updated-ai-model
- swissinfo, One year on (2026-09-02): https://www.swissinfo.ch/eng/swiss-ai/one-year-on-has-swiss-ai-model-apertus-lived-up-to-the-hype/91984276
- Blick, Apertus 2.0 (2026-10-02): https://www.blick.ch/digital/eth-und-epfl-tuefteln-an-apertus-20-ki-modell-kommt-2027/tg7krpw
답글 남기기