
Nemotron 3.5 Super VL을 DGX Spark 128GB에서 상시가동 에이전트로 돌릴 때 실제로 쓰는 설정값, NVFP4 양자화로 떨어지는 지표, 2026년 10월 기준 API 가격, Bolt 24GB와 고르는 기준을 정리했습니다.
AI 에이전트 개요
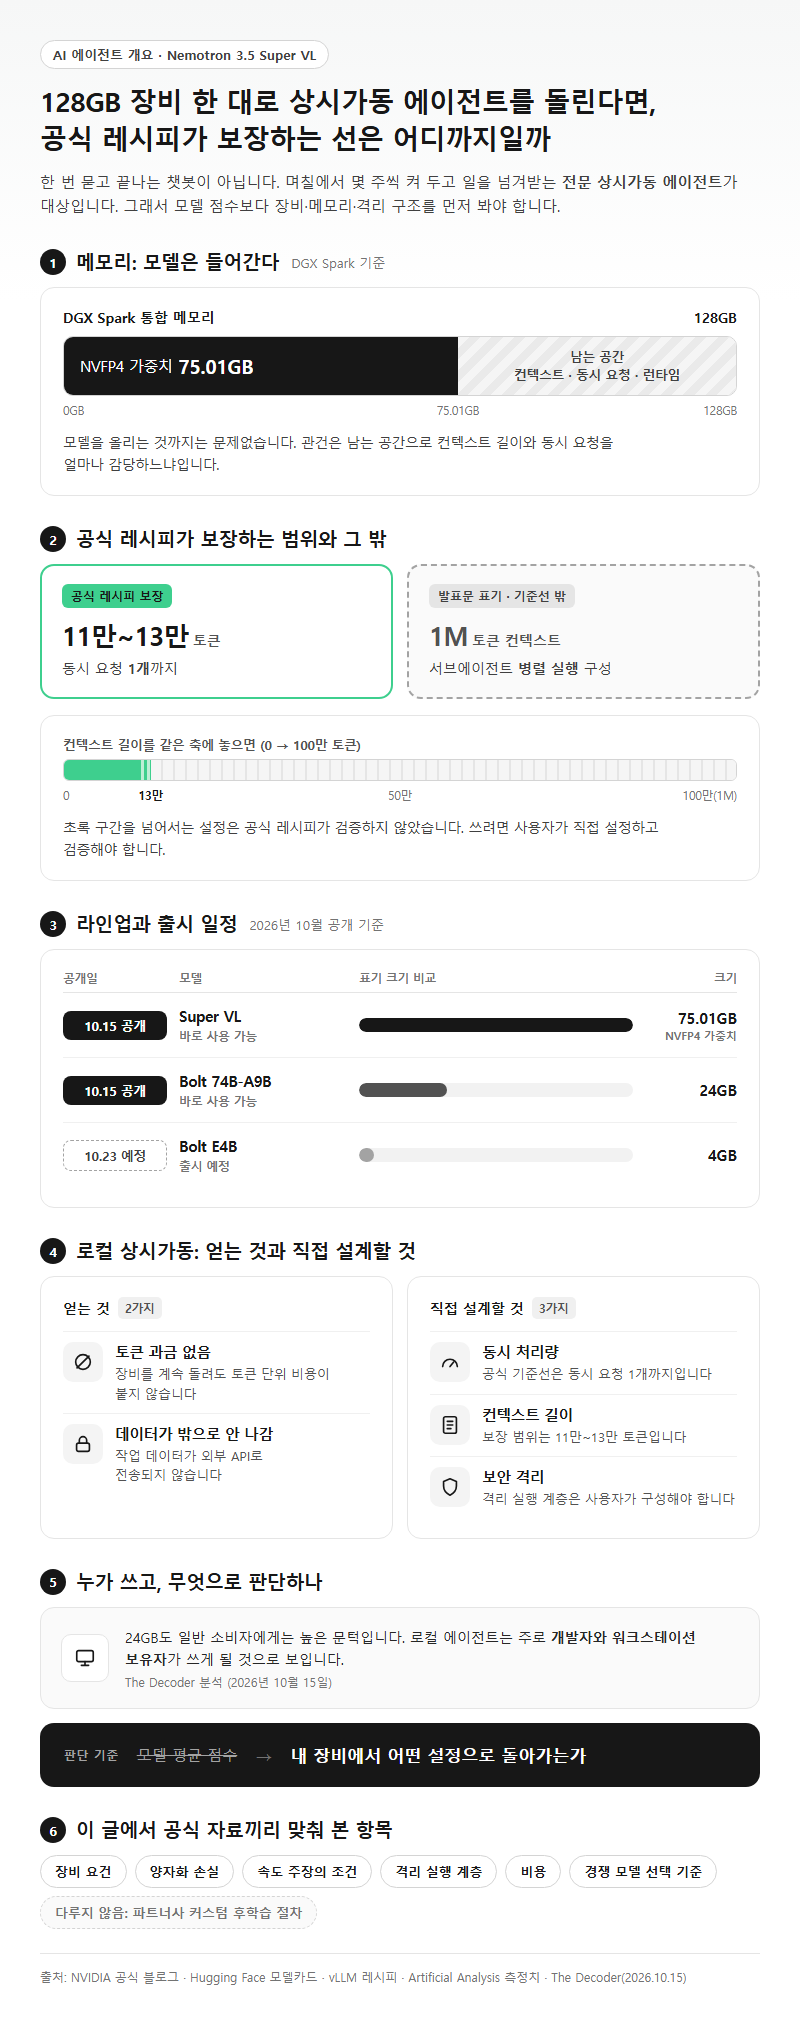
Nemotron 3.5 Super VL은 128GB 통합 메모리 장비 한 대로 상시가동 에이전트를 로컬에서 돌릴 수 있는 모델입니다. 하지만 공식 레시피가 보장하는 범위는 동시 1요청·컨텍스트 11만에서 13만 토큰까지입니다. NVFP4 가중치가 75.01GB라 DGX Spark(128GB)에 올라가는 것은 맞지만, 발표문에 적힌 1M 컨텍스트와 병렬 서브에이전트 구성은 이 기준선 밖에 있습니다. 이 글은 NVIDIA 공식 블로그, Hugging Face 모델카드, vLLM 레시피, Artificial Analysis 측정치를 서로 맞춰 보며 장비 요건·양자화 손실·속도 주장의 조건·격리 실행 계층·비용·경쟁 모델 선택 기준을 정리했습니다. 파트너사의 커스텀 후학습 절차는 다루지 않습니다.
NVIDIA는 2026년 10월 15일 Super VL과 Bolt 74B-A9B 24GB를 공개하면서 둘 다 바로 쓸 수 있다고 밝혔습니다. 4GB 크기의 Bolt E4B는 2026년 10월 23일에 나올 예정입니다. Super VL이 겨냥하는 쪽은 며칠에서 몇 주씩 이어지는 워크플로를 맡는 전문 상시가동 에이전트(specialized always-on agents)입니다. 한 번 묻고 끝나는 챗봇이 아니라 계속 켜 두고 일을 넘겨받는 에이전트가 대상이니, 모델 점수보다 장비·메모리·격리 구조부터 따져야 합니다.
로컬 상시가동의 이점은 분명합니다. 토큰 단위 과금 없이 장비를 계속 돌릴 수 있고, 작업 데이터가 외부 API로 나가지 않습니다. 대신 동시 처리량·컨텍스트 길이·보안 격리는 사용자가 직접 설계해야 합니다. The Decoder는 2026년 10월 15일 분석에서 24GB도 일반 소비자에게는 높은 문턱이라, 로컬 에이전트는 주로 개발자와 워크스테이션 보유자가 쓰게 될 것이라고 봤습니다. 판단 기준은 모델의 평균 점수가 아니라 내 장비에서 어떤 설정으로 돌아가느냐입니다.
1. Nemotron 3.5 패밀리에서 Super VL의 자리와 하이브리드 MoE 구조
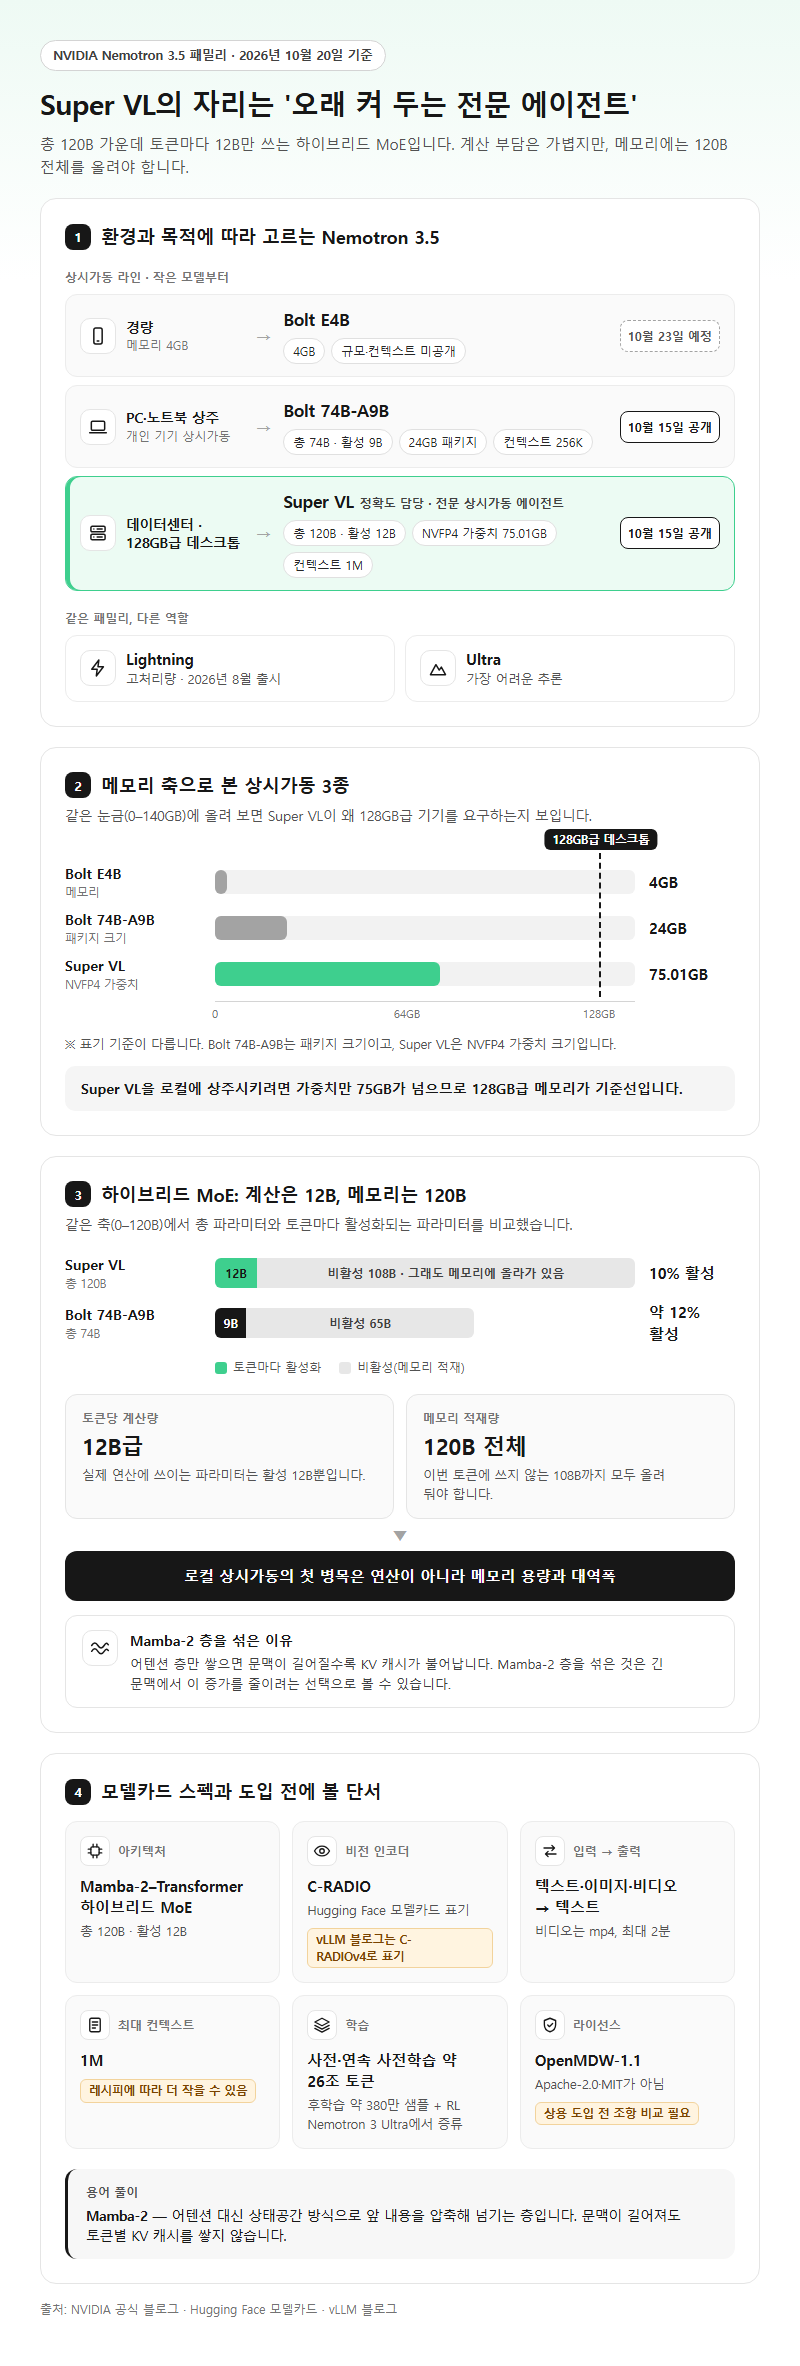
상시가동 AI 에이전트 종류를 NVIDIA 라인업 기준으로 나누면 역할이 갈립니다. Super VL은 데이터센터와 128GB급 데스크톱에서 정확도를 맡고, Bolt는 PC·노트북에 상주합니다. NVIDIA 공식 블로그에 따르면 같은 패밀리 안에서 Lightning(2026년 8월 출시)은 고처리량을, Ultra는 가장 어려운 추론을 담당합니다. Super VL의 자리는 그 사이, 오래 켜 두는 전문 에이전트입니다.
| 모델 | 역할 | 규모(총/활성) | 메모리 | 최대 컨텍스트 | 상태(2026년 10월 20일 기준) |
|---|---|---|---|---|---|
| Lightning | 고처리량 | — | — | — | 2026년 8월 출시 |
| Super VL | 전문 상시가동 에이전트 | 120B / 12B | NVFP4 가중치 75.01GB | 1M | 2026년 10월 15일 공개 |
| Ultra | 최고난도 추론 | — | — | — | — |
| Bolt 74B-A9B | PC·노트북 상시가동 | 74B / 9B | 24GB 패키지 | 256K | 2026년 10월 15일 공개 |
| Bolt E4B | 경량 | 미공개 | 4GB | 미공개 | 2026년 10월 23일 예정 |
Super VL은 총 120B 가운데 토큰마다 12B만 활성화하는 하이브리드 MoE입니다. 계산량은 12B급에 가깝지만 메모리에는 120B 전체를 올려야 합니다. 그래서 로컬 상시가동에서는 연산보다 메모리 용량과 대역폭이 먼저 병목이 됩니다. Mamba-2 층을 섞은 것은 어텐션 층만 쌓을 때보다 긴 문맥에서 KV 캐시가 덜 불어나게 하려는 선택으로 볼 수 있습니다.
| 항목 | 내용 |
|---|---|
| 아키텍처 | Mamba-2–Transformer 하이브리드 MoE(총 120B·활성 12B) |
| 비전 인코더 | C-RADIO(Hugging Face 모델카드 표기) |
| 입력 / 출력 | 텍스트·이미지·비디오(mp4 최대 2분) / 텍스트 |
| 최대 컨텍스트 | 1M(레시피에 따라 더 작을 수 있음) |
| 학습 | 사전·연속 사전학습 약 26조 토큰, 후학습 약 380만 샘플과 RL |
| 원본 모델 | Nemotron 3 Ultra에서 증류 |
| 라이선스 | OpenMDW-1.1 |
모델카드는 최대 컨텍스트를 1M으로 적으면서도 레시피에 따라 더 작을 수 있다는 단서를 달았습니다. 2절에서 볼 실제 로컬 설정이 바로 이 단서와 맞닿아 있습니다. 비전 인코더 이름도 문서마다 다릅니다. 모델카드는 C-RADIO, vLLM 블로그는 C-RADIOv4로 적었는데, 이 글은 모델카드 표기를 따랐습니다. 라이선스도 Apache-2.0이나 MIT가 아니라 OpenMDW-1.1이므로, 상용 도입 전에 조항을 따로 비교해 봐야 합니다.
용어 풀이
1. Mamba-2 — 어텐션 대신 상태공간 방식으로 앞 내용을 압축해 넘기는 층으로, 문맥이 길어져도 토큰별 KV 캐시를 쌓지 않습니다.
2. 증류 — 큰 모델의 출력을 작은 모델이 따라 배우도록 학습시켜 성능을 옮겨 담는 방법입니다.
2. DGX Spark 128GB 로컬 기준선은 동시 1요청·컨텍스트 11만에서 13만
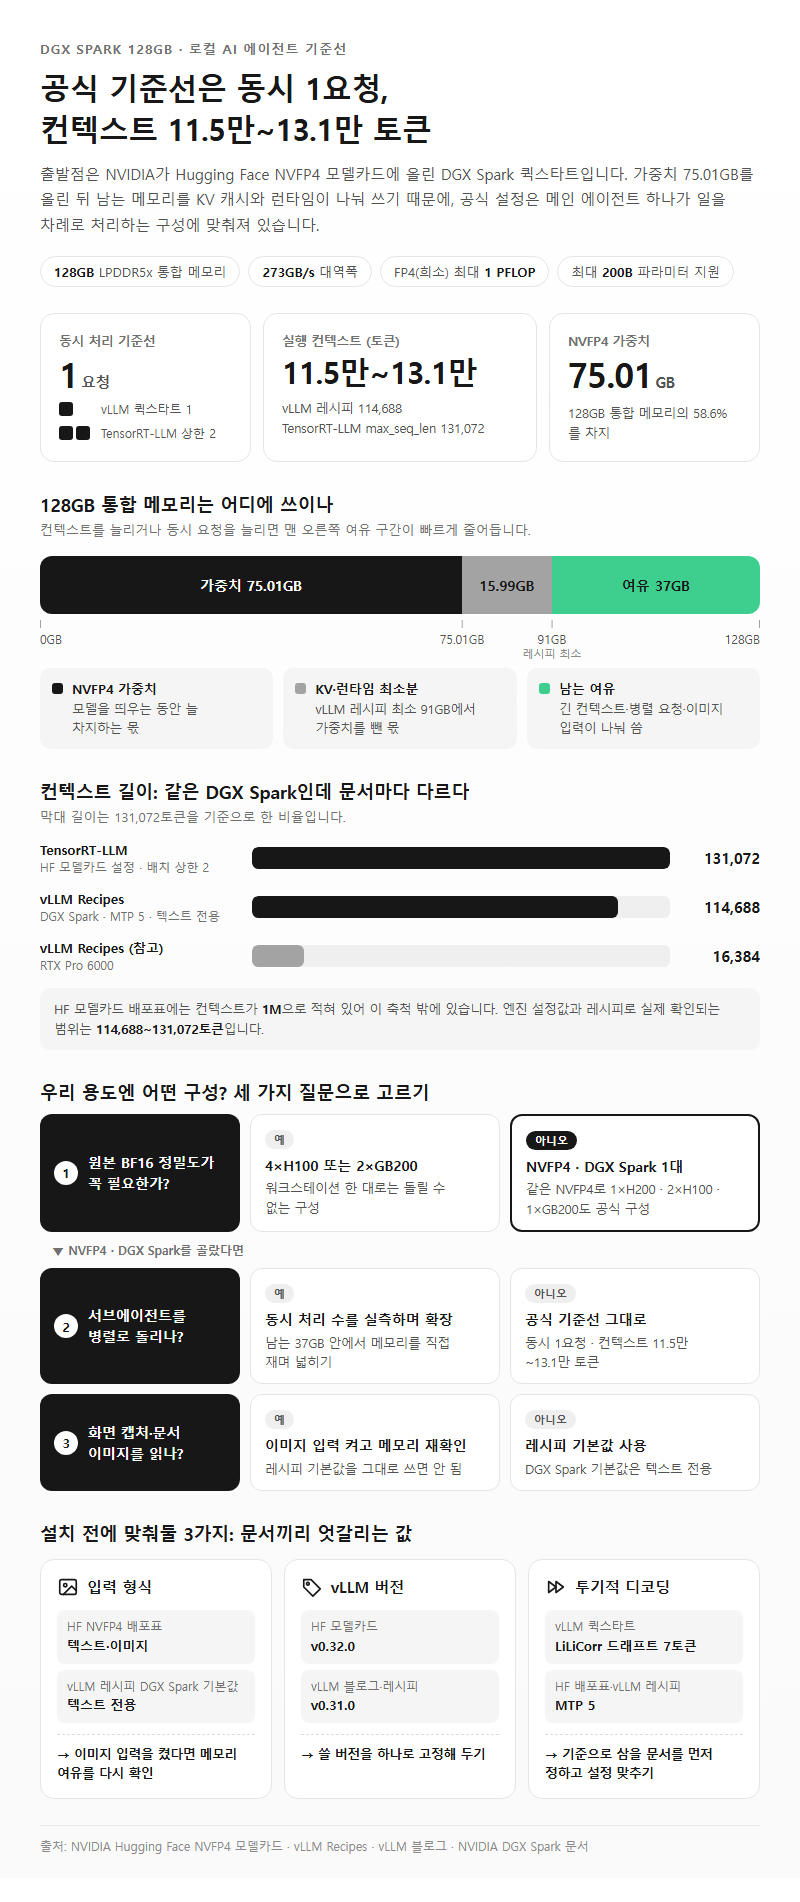
로컬에서 AI 에이전트 만들기를 시작한다면 NVIDIA가 Hugging Face NVFP4 모델카드에 올린 DGX Spark 퀵스타트가 출발점입니다. 공식 배치 구성은 정밀도에 따라 갈립니다. BF16은 H100 4장 또는 GB200 2장이 필요해 워크스테이션 한 대로는 돌릴 수 없습니다.
| 정밀도 | 공식 배치 구성 | 메모리 참고값 |
|---|---|---|
| NVFP4 | 1×DGX Spark · 1×H200 · 2×H100 · 1×GB200 | 가중치 75.01GB, vLLM 레시피 최소 91GB |
| BF16 | 4×H100 또는 2×GB200 | 단일 워크스테이션 불가 |
DGX Spark는 128GB LPDDR5x 통합 메모리에 대역폭 273GB/s를 갖췄고, FP4(희소) 기준 최대 1 PFLOP을 냅니다. NVIDIA 문서상 200B 파라미터 모델까지 지원합니다. NVFP4 가중치 75.01GB를 올리고 남는 공간을 KV 캐시와 런타임이 나눠 쓰는 구조라, 컨텍스트를 늘릴수록 여유가 빠르게 줄어듭니다.
| 문서 | 엔진 | 컨텍스트 | 동시 처리 | 투기적 디코딩 | 입력 |
|---|---|---|---|---|---|
| HF 모델카드 퀵스타트 | vLLM | — | –max-num-seqs 1, GPU 메모리 0.75 | LiLiCorr 드래프트 7토큰 | — |
| HF 모델카드 설정 | TensorRT-LLM | max_seq_len 131,072 | max_batch_size 2 | — | — |
| HF 모델카드 배포표 | — | 1M | — | MTP 5 | 텍스트·이미지 |
| vLLM Recipes(DGX Spark) | vLLM | 114,688 | — | MTP 5 | 텍스트 전용(기본값) |
| vLLM Recipes(RTX Pro 6000) | vLLM | 16,384 | — | — | — |
표에서 보듯 같은 DGX Spark인데 문서마다 설정이 다릅니다. vLLM 퀵스타트의 –max-num-seqs 1은 한 번에 시퀀스 하나만 처리한다는 뜻이고, TensorRT-LLM도 배치 2가 상한입니다. 공식 기준선은 메인 에이전트 하나가 일을 차례로 처리하는 구성인 셈입니다. 서브에이전트 여러 개를 병렬로 돌리려면 메모리를 직접 재며 넓혀야 합니다.
입력 형식도 문서끼리 엇갈립니다. Hugging Face NVFP4 배포표에는 DGX Spark에서 텍스트·이미지를 받는다고 적혀 있지만, vLLM 레시피의 DGX Spark 기본값은 텍스트 전용입니다. 화면 캡처나 문서 이미지를 읽는 에이전트라면 레시피 기본값을 그대로 쓰지 말고, 이미지 입력을 켠 상태에서 메모리 여유를 다시 확인해야 합니다. vLLM 버전도 모델카드는 v0.32.0, vLLM 블로그·레시피는 v0.31.0을 기준으로 적고 있어 버전을 고정해 두는 게 안전합니다.
NVFP4는 Blackwell 세대에서 가중치와 활성화를 모두 4비트로 계산하고, 그 밖의 GPU에서는 가중치 4비트·활성화 16비트로 돌아갑니다. KV 캐시도 NVFP4로 저장할 수 있어 긴 문맥에서 메모리 부담을 덜 여지가 있습니다. NVIDIA 설명으로는 DGX Spark 권장 드래프터인 LiLiCorr를 쓰면 투기적 디코딩 없이 돌릴 때보다 생성 속도가 최대 2.3배 빨라집니다.
| 형식(Unsloth 추정) | 파일 크기 | 권장 메모리 |
|---|---|---|
| UD-Q4_K_XL | 86.9GB | 128GB |
| NVFP4 GGUF | 79GB | 96GB |
| 1비트 | 46.1GB | 64GB |
| LM Studio 최소 요건 | — | 시스템 메모리 70GB |
Unsloth는 이 값들이 실측이 아닌 계획용 추정치라고 밝히면서, 로컬에서는 컨텍스트 16K부터 시작하라고 권합니다. vLLM 레시피의 최소 메모리 91GB도 가중치만 계산한 값이라 컨텍스트와 배치까지 보장하지는 않습니다. 128GB 장비라도 1M 컨텍스트를 기대하기보다는 16K에서 출발해 114,688 근처까지 단계적으로 늘리며 메모리 사용량을 확인하는 쪽이 현실적입니다.
용어 풀이
1. 투기적 디코딩 — 작은 드래프트 모델이나 MTP 헤드가 다음 토큰 여러 개를 미리 제안하고, 본 모델이 한 번에 검증해 생성 속도를 높이는 기법입니다.
2. KV 캐시 — 어텐션 층이 이전 토큰의 키·값을 저장해 두는 메모리로, 컨텍스트가 길어질수록 커집니다.
3. GGUF — llama.cpp 계열 런타임이 읽는 양자화 모델 파일 형식입니다.
3. 속도 5배·벤치마크 주장, 어떤 조건에서 성립하나
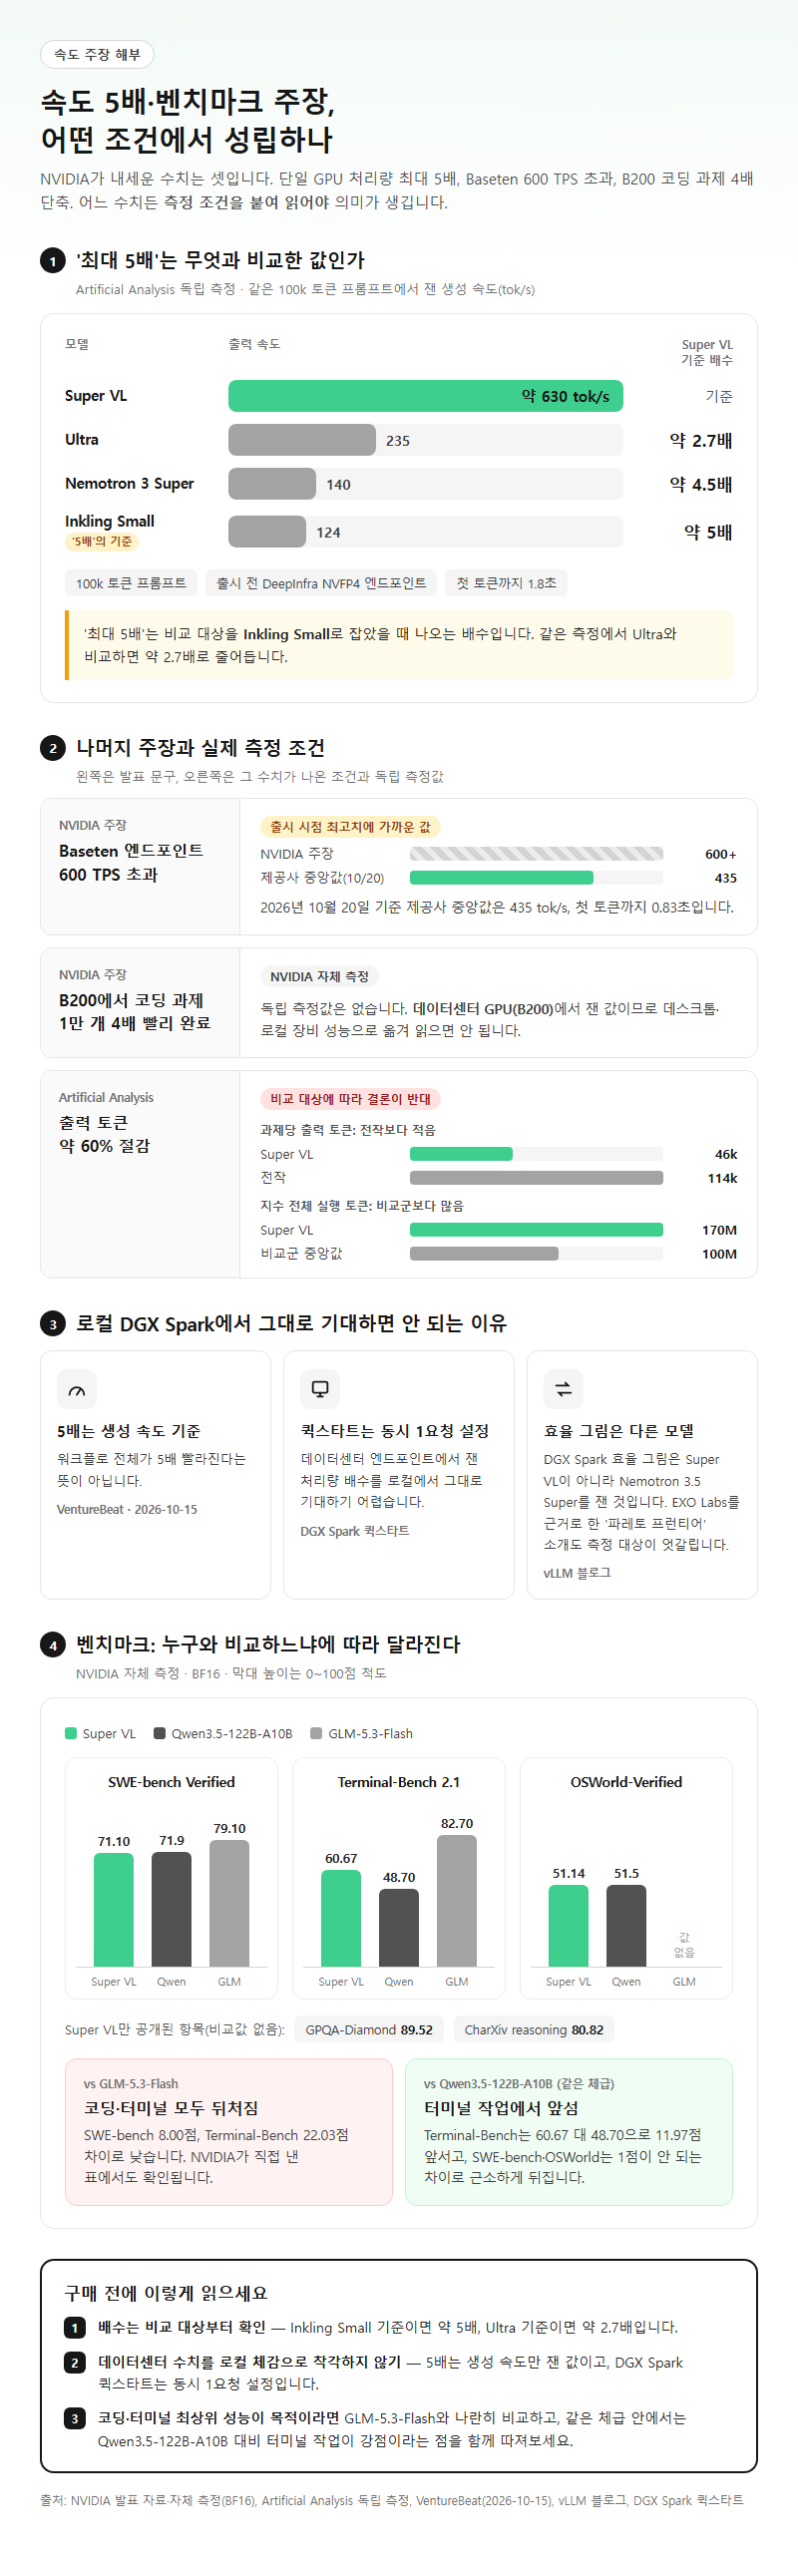
NVIDIA가 내세운 속도 주장은 세 가지입니다. 단일 GPU에서 동급 오픈 모델보다 에이전트 처리량이 최대 5배이고, Baseten 엔드포인트에서 600 TPS를 넘기며, B200에서 코딩 과제 1만 개를 4배 빨리 끝낸다는 내용입니다. 어느 수치든 측정 조건을 붙여 읽어야 의미가 있습니다.
| 주장 | 측정 조건·독립 측정 | 해석 |
|---|---|---|
| 단일 GPU 처리량 최대 5배(NVIDIA) | Artificial Analysis: 100k 토큰 프롬프트, 출시 전 DeepInfra NVFP4 엔드포인트에서 약 630 tok/s. Inkling Small 124(약 5배), Ultra 235(약 2.7배), Nemotron 3 Super 140(약 4.5배), 첫 토큰 1.8초 | 비교 대상을 Inkling Small로 잡았을 때의 배수 |
| Baseten 600 TPS 초과(NVIDIA) | 2026년 10월 20일 제공사 중앙값 435 tok/s, 첫 토큰 0.83초 | 출시 시점 최고치에 가까운 값 |
| B200 코딩 과제 1만 개 4배 빨리 완료(NVIDIA) | NVIDIA 자체 측정 | 데이터센터 GPU 조건 |
| 출력 토큰 약 60% 절감(Artificial Analysis) | 과제당 46k로 전작 114k보다 적지만, 지수 전체 실행은 170M으로 비교군 중앙값 100M보다 많음 | 비교 대상에 따라 결론이 반대 |
VentureBeat는 2026년 10월 15일 보도에서 5배가 생성 속도 기준이며 워크플로 전체가 5배 빨라진다는 뜻은 아니라고 짚었습니다. DGX Spark 퀵스타트는 동시 1요청 설정이기도 해서, 데이터센터 엔드포인트에서 잰 처리량 배수를 로컬에서 그대로 기대하기는 어렵습니다. vLLM 블로그는 DGX Spark 효율 그림이 Super VL이 아니라 관련 모델인 Nemotron 3.5 Super를 측정한 것이라고 밝혔습니다. NVIDIA가 EXO Labs 평가를 근거로 DGX Spark가 파레토 프런티어에 있다고 소개한 대목도 측정 대상이 엇갈린다는 점을 감안하고 읽어야 합니다.
| 벤치마크(NVIDIA 측정, BF16) | Super VL | Qwen3.5-122B-A10B | GLM-5.3-Flash |
|---|---|---|---|
| SWE-bench Verified | 71.10 | 71.9 | 79.10 |
| Terminal-Bench 2.1 | 60.67 | 48.70 | 82.70 |
| OSWorld-Verified | 51.14 | 51.5 | — |
| GPQA-Diamond | 89.52 | — | — |
| CharXiv reasoning | 80.82 | — | — |
NVIDIA 자체 표에서도 Super VL은 코딩·터미널 항목에서 GLM-5.3-Flash에 뒤처집니다. 체급이 같은 Qwen3.5-122B-A10B와 비교하면 사정이 다릅니다. Terminal-Bench 2.1에서 60.67 대 48.70으로 앞서 터미널형 작업에 강점을 보입니다. 다만 모델카드 표에는 추론 모드·도구 사용·반복 횟수가 적혀 있지 않아, 같은 조건에서 비교했는지는 표만으로 판단하기 어렵습니다.
독립 지표인 Artificial Analysis Intelligence Index v4.3.2에서 Super VL은 26점으로 미국 오픈웨이트 모델 중 1위입니다. 전작 Nemotron 3 Super(12.8)와 Ultra(23)보다도 높습니다. 국적 조건을 빼고 보면 MiMo-V2.6-Pro(46)와 K2 Horizon(31)이 앞서고, GLM-5.3-Flash는 42점입니다. NVIDIA는 기술 블로그에서 Super VL이 하네스 평가 Hermes Bench 63.44%, LangChain 87.05%로 Ultra(56.33%·84.3%)를 넘었다고 밝혔습니다.
로컬 사용자에게는 양자화 손실이 더 중요합니다. Artificial Analysis 측정으로는 NVFP4판과 BF16판의 지수 차이가 0.1점 이내이고, 개별 항목 차이는 최대 2.6점입니다. 그런데 NVIDIA 모델카드 표를 보면 WebVoyager[offline]가 77.72에서 66.31로 11.41포인트 떨어졌고, DeepSWE[offline]도 24.65에서 18.2로 내려갔습니다. 평균에 가려진 이 브라우징형·장기 코딩형 항목이 상시가동 에이전트가 맡을 일과 정확히 겹칩니다. 자기 과제로 BF16판과 직접 비교해 보는 절차를 건너뛰면 안 되는 이유입니다.
Opus 5·GPT-6.1 Sol을 넘었다는 보도도 조건을 따져 봐야 합니다. VentureBeat 2026년 10월 15일 보도에 따르면 근거는 파트너가 후학습한 커스텀판 2건입니다. 보험 청구 과제는 약 28%에서 72%로 올라 Opus 5(약 38%)를 넘었고, 보안 대응 과제는 약 35%에서 76%로 올라 GPT-6.1 Sol(약 66%)을 넘었습니다. 과제 정의와 표본 수는 공개되지 않았고, 무엇보다 기본 모델을 비교한 결과가 아닙니다.
4. AI 에이전트 생태계 속 하네스·OpenShell 격리와 운영 비용
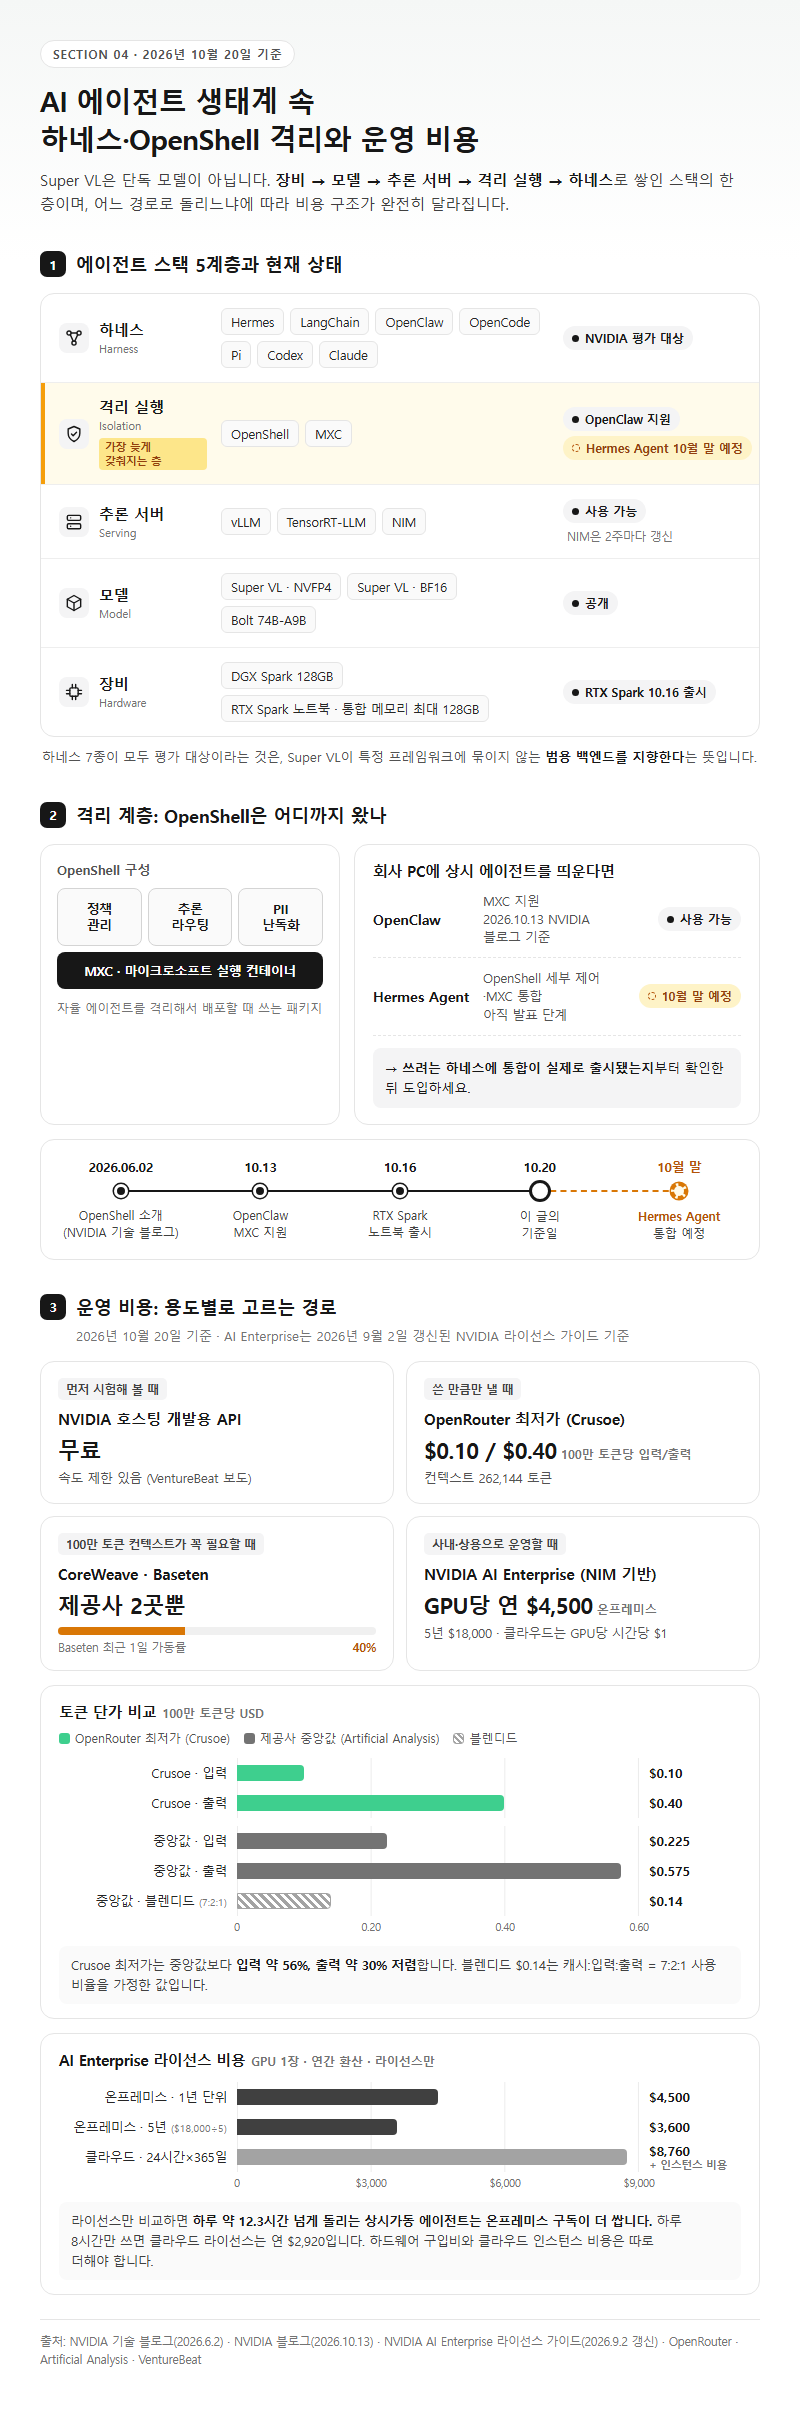
AI 에이전트 생태계 안에서 Super VL은 단독 모델이 아니라 하네스·추론 서버·격리 실행 계층으로 이뤄진 스택의 한 층입니다. NVIDIA 기술 블로그는 평가 대상 하네스로 Hermes·LangChain·OpenClaw·OpenCode·Pi·Codex·Claude를 꼽았습니다. 특정 프레임워크에 묶이지 않는 범용 백엔드를 지향한다는 뜻입니다.
| 계층 | 구성 요소 | 상태(2026년 10월 20일 기준) |
|---|---|---|
| 모델 | Super VL(NVFP4·BF16), Bolt 74B-A9B | 공개 |
| 추론 서버 | vLLM, TensorRT-LLM, NIM | 사용 가능, NIM은 2주마다 갱신 |
| 격리 실행 | OpenShell + MXC | OpenClaw 지원, Hermes Agent는 2026년 10월 말 통합 예정 |
| 하네스 | Hermes·LangChain·OpenClaw·OpenCode·Pi·Codex·Claude | NVIDIA 평가 대상 |
| 장비 | DGX Spark 128GB, RTX Spark 노트북(통합 메모리 최대 128GB) | RTX Spark 2026년 10월 16일 출시 |
상시가동 에이전트에서 가장 늦게 갖춰지는 것은 격리 계층입니다. NVIDIA가 2026년 6월 2일 기술 블로그에서 소개한 OpenShell은 마이크로소프트 실행 컨테이너(MXC) 위에서 정책 관리·추론 라우팅·PII 난독화를 묶은 패키지로, 자율 에이전트를 격리해 배포할 때 씁니다. 2026년 10월 13일 NVIDIA 블로그 기준으로 OpenClaw는 이미 MXC를 지원합니다. Hermes Agent의 세부 OpenShell 제어와 MXC 통합은 2026년 10월 말 예정으로, 아직 발표 단계에 머물러 있습니다. 회사 PC에 상시 에이전트를 띄울 계획이라면 쓰려는 하네스에 이 통합이 실제로 출시됐는지부터 확인하는 게 순서입니다.
운영 비용은 경로마다 구조가 완전히 다릅니다. 아래 가격은 2026년 10월 20일 기준이며, AI Enterprise 항목은 2026년 9월 2일 갱신된 NVIDIA 라이선스 가이드를 따랐습니다.
| 경로 | 비용 | 조건 |
|---|---|---|
| NVIDIA 호스팅 개발용 API | 무료 | 속도 제한 있음(VentureBeat 보도) |
| OpenRouter 최저가(Crusoe) | 100만 토큰당 입력 $0.10 / 출력 $0.40 | 컨텍스트 262,144 |
| 제공사 중앙값(Artificial Analysis) | 입력 $0.225 / 출력 $0.575, 블렌디드 $0.14 | 캐시:입력:출력 7:2:1 가정 |
| 1M 컨텍스트 제공사 | CoreWeave·Baseten 2곳 | Baseten 최근 1일 가동률 40% |
| AI Enterprise(온프레미스) | GPU당 연 $4,500, 5년 $18,000 | NIM 기반 상용 운영 |
| AI Enterprise(클라우드) | GPU당 시간당 $1 | 인스턴스 비용 별도 |
API로 갈 때는 1M 컨텍스트를 조심해야 합니다. OpenRouter에 등록된 제공사 6곳 중 4곳은 262,144 토큰까지만 받고, 1,048,576 토큰을 주는 곳은 CoreWeave와 Baseten 두 곳뿐입니다. 그중 Baseten은 조회 시점 최근 1일 가동률이 40%였습니다. 상시가동 워크로드를 한 제공사에만 걸어 두면 위험합니다.
The Decoder는 오픈 공개가 결국 NVIDIA 하드웨어 수요로 이어지는 구조라고 지적했습니다. 모델은 무료로 풀렸지만 공식 레시피는 DGX Spark·H100·GB200 같은 NVIDIA 장비와 NVFP4 형식을 중심으로 짜여 있으니, 도입을 판단할 때 이 점도 따져 봐야 합니다. vLLM으로 가중치를 직접 띄울지, 2주 주기 패치가 붙는 NIM·AI Enterprise 경로로 갈지는 사내 보안 패치 요건에 맞춰 정하면 됩니다.
용어 풀이
1. 하네스 — 모델에 도구 호출·파일 접근·작업 반복 루프를 붙여 에이전트로 움직이게 하는 실행 프레임워크입니다.
2. PII 난독화 — 이름·연락처 같은 개인식별정보를 모델이나 외부 서비스에 넘기기 전에 가리거나 바꾸는 처리입니다.
5. Super VL·Qwen3.5-122B·GLM-5.3-Flash·Bolt 선택 기준과 FAQ
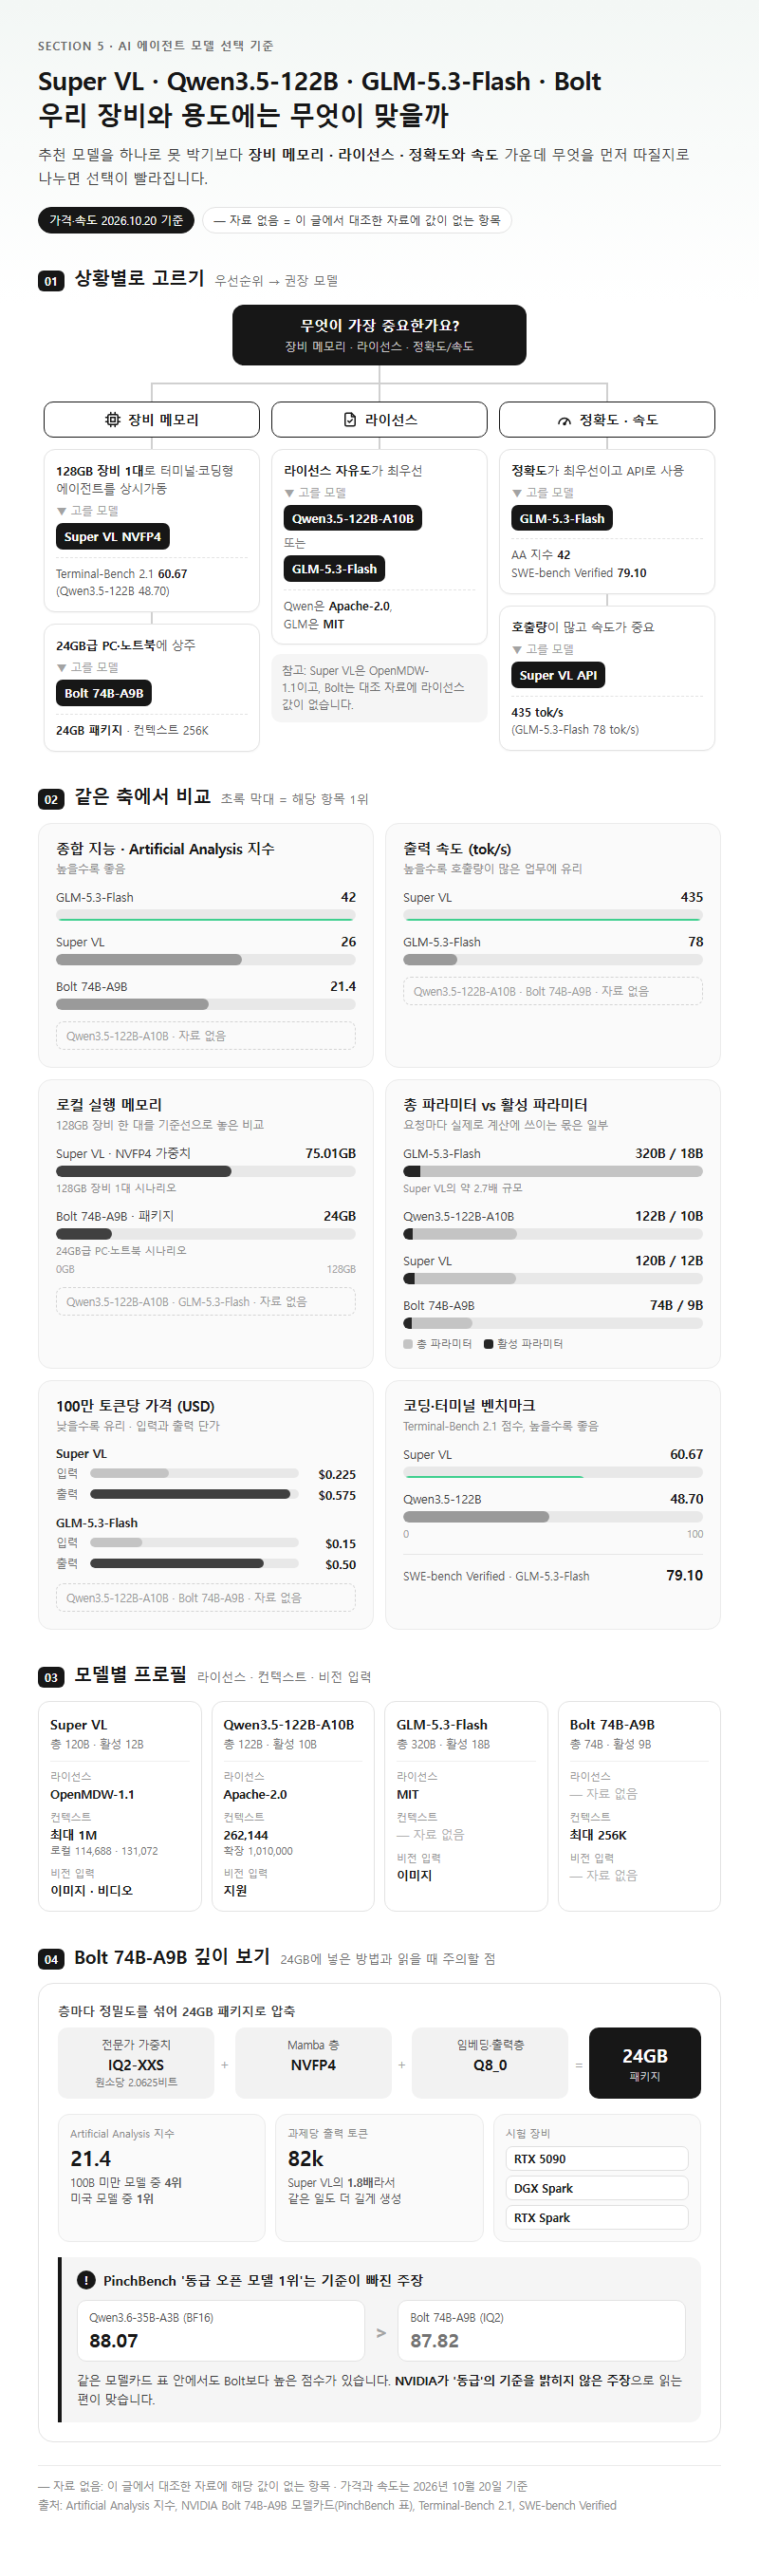
AI 에이전트 추천 모델을 하나로 못 박기보다 장비 메모리·라이선스·정확도와 속도의 우선순위로 나눠 보면 선택이 빨라집니다. 아래 표의 가격과 속도는 2026년 10월 20일 기준이고, 빈칸은 이 글에서 대조한 자료에 해당 값이 없는 항목입니다.
| 항목 | Super VL | Qwen3.5-122B-A10B | GLM-5.3-Flash | Bolt 74B-A9B |
|---|---|---|---|---|
| 총/활성 파라미터 | 120B / 12B | 122B / 10B | 320B / 18B(Super VL의 약 2.7배) | 74B / 9B |
| 라이선스 | OpenMDW-1.1 | Apache-2.0 | MIT | — |
| 컨텍스트 | 최대 1M(로컬 114,688·131,072) | 262,144(확장 1,010,000) | — | 최대 256K |
| 비전 입력 | 이미지·비디오 | 지원 | 이미지 | — |
| AA 지수 | 26 | — | 42 | 21.4 |
| 출력 속도 | 435 tok/s | — | 78 tok/s | — |
| 100만 토큰당 가격 | 입력 $0.225 / 출력 $0.575 | — | 입력 $0.15 / 출력 $0.50 | — |
| 로컬 메모리 | NVFP4 가중치 75.01GB | — | — | 24GB |
Bolt 74B-A9B는 정밀도를 섞어 24GB 패키지로 줄였습니다. 전문가 가중치는 IQ2-XXS(원소당 2.0625비트), Mamba 층은 NVFP4, 임베딩·출력층은 Q8_0입니다. 시험 장비에는 RTX 5090·DGX Spark·RTX Spark가 들어 있습니다. Artificial Analysis 지수는 21.4로 100B 미만 모델 중 4위, 미국 모델 중 1위입니다. 다만 과제당 출력 토큰이 82k로 Super VL의 1.8배여서, 같은 일을 시켜도 더 길게 생성합니다. NVIDIA는 Bolt가 PinchBench에서 동급 오픈 모델 1위라고 소개했지만, 같은 모델카드 표에서 Qwen3.6-35B-A3B(BF16)가 88.07로 Bolt(IQ2)의 87.82보다 높습니다. 동급의 기준을 NVIDIA가 밝히지 않은 주장으로 읽는 편이 맞습니다.
| 상황 | 고를 모델 | 근거 |
|---|---|---|
| 128GB 장비 1대, 터미널·코딩형 상시가동 | Super VL NVFP4 | Terminal-Bench 2.1 60.67(Qwen3.5-122B 48.70) |
| 라이선스 자유도 최우선 | Qwen3.5-122B-A10B 또는 GLM-5.3-Flash | Apache-2.0 / MIT |
| 정확도 최우선, API 사용 | GLM-5.3-Flash | AA 42, SWE-bench Verified 79.10 |
| 호출량이 많고 속도가 중요 | Super VL API | 435 tok/s(GLM-5.3-Flash 78 tok/s) |
| 24GB급 PC·노트북 상주 | Bolt 74B-A9B | 24GB 패키지, 컨텍스트 256K |
| 4GB급 경량 장비 | Bolt E4B 출시 대기 | 2026년 10월 23일 예정, 사양 미공개 |
1M 컨텍스트를 로컬에서 쓸 수 있나요?
공식 로컬 레시피로는 어렵습니다. DGX Spark에서 vLLM 레시피는 114,688 토큰, TensorRT-LLM 설정은 131,072 토큰이고, RTX Pro 6000 레시피는 16,384 토큰입니다. 1M은 모델의 상한일 뿐, 로컬에서 실제로 쓰는 창은 그보다 훨씬 작습니다.
NVFP4로 줄여도 에이전트 정확도가 유지되나요?
평균 지수로는 BF16과 0.1점 이내입니다. 하지만 브라우징형 항목인 WebVoyager[offline]는 11.41포인트 떨어졌습니다. 상시가동 용도가 웹 탐색이나 장기 코딩이라면 자기 과제로 BF16판과 비교 측정한 뒤 결정해야 합니다.
노트북에서도 Super VL을 돌릴 수 있나요?
NVIDIA가 Hugging Face에 올린 NVFP4 배치 구성은 DGX Spark·H200·H100·GB200뿐이고, 노트북은 없습니다. 2026년 10월 16일 출시된 RTX Spark 노트북은 통합 메모리가 최대 128GB지만, NVIDIA가 RTX Spark를 시험 장비로 명시한 모델은 Bolt입니다. 노트북 상주용이라면 Bolt 74B-A9B 24GB가 공식 경로입니다.
상시가동 에이전트를 API로만 운영해도 되나요?
가능하지만 제공사를 잘 골라야 합니다. 2026년 10월 20일 OpenRouter 기준 최저가는 Crusoe의 입력 $0.10·출력 $0.40(100만 토큰당)이고, 컨텍스트는 262,144입니다. VentureBeat 보도에 따르면 개발 단계에서는 NVIDIA 호스팅 API를 무료로 쓸 수 있지만 속도 제한이 걸려 있습니다. NVIDIA는 구체적인 제한 수치를 공개하지 않았습니다.
Bolt E4B 4GB를 기다릴 만한가요?
Bolt E4B는 2026년 10월 23일 출시 예정이지만 파라미터·컨텍스트·벤치마크 점수는 아직 나오지 않았습니다. 4GB급 장비만 있다면 출시 후 공개 점수를 확인하고 결정하는 편이 낫습니다.
정리
Nemotron 3.5 Super VL을 로컬에서 상시가동할 때의 기준선은 DGX Spark 128GB, NVFP4, 동시 1요청, 컨텍스트 11만에서 13만 토큰, 기본 텍스트 전용입니다. 1M 컨텍스트와 병렬 서브에이전트는 이 범위 밖입니다. 5배·600 TPS 같은 속도 수치는 특정 엔드포인트와 비교 대상을 전제로 한 값이고, NVFP4는 평균 점수와 달리 브라우징형 에이전트 항목에서 손실이 큽니다. 128GB 장비로 터미널·코딩형 작업을 돌린다면 Super VL, 24GB급 PC·노트북이라면 Bolt 74B-A9B, 정확도가 최우선이고 API로 쓴다면 GLM-5.3-Flash가 맞습니다. 회사 PC에 배포할 때는 쓰려는 하네스에 OpenShell·MXC 격리 통합이 실제로 붙었는지부터 확인하는 편이 안전합니다.
참고 자료
조사 기준일: 2026년 10월 20일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (확인일 2026-10-20)
- NVIDIA 공식 블로그, Open From Data Center to Desktop (2026-10-15): https://blogs.nvidia.com/blog/nemotron-3-5-super-vl/
- NVIDIA 기술 블로그, Nemotron 3.5 Super VL Powers Specialized Agents (2026-10-15): https://developer.nvidia.com/blog/nvidia-nemotron-3-5-super-vl-powers-specialized-agents-with-multimodal-reasoning/
- HF 모델카드 BF16: https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-BF16
- HF 모델카드 NVFP4: https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4
- HF 모델카드 Bolt 74B-A9B 24GB: https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-74B-A9B-24GB
- NVIDIA HF 저장소 목록(API): https://huggingface.co/api/models?author=nvidia&search=Nemotron-3.5
- NVIDIA 공식 블로그, RTX Spark 앱 생태계 (2026-10-13): https://blogs.nvidia.com/blog/local-ai-rtx-spark-laptops-software-updates/
- NVIDIA 기술 블로그, Build Personal AI Agents on Windows PCs (2026-06-02): https://developer.nvidia.com/blog/build-personal-ai-agents-on-windows-pcs-with-new-tools-from-microsoft-and-nvidia
- NVIDIA DGX Spark 하드웨어 문서: https://docs.nvidia.com/dgx/dgx-spark/hardware.html
- NVIDIA AI Enterprise 가격표 (2026-09-02 갱신): https://docs.nvidia.com/ai-enterprise/planning-resource/licensing-guide/latest/pricing.html
- Qwen3.5-122B-A10B 모델카드: https://huggingface.co/Qwen/Qwen3.5-122B-A10B
- GLM-5.3-Flash 모델카드: https://huggingface.co/zai-org/GLM-5.3-Flash
- Artificial Analysis 기사 (2026-10-15): https://artificialanalysis.ai/articles/nemotron-3-5-super-and-bolt
- Artificial Analysis 모델 페이지: https://artificialanalysis.ai/models/nemotron-3-5-super-vl
- Artificial Analysis 비교(GLM-5.3-Flash): https://artificialanalysis.ai/models/comparisons/nemotron-3-5-super-vl-vs-glm-5-3-flash
- VentureBeat (2026-10-15): https://venturebeat.com/technology/nvidias-new-open-nemotron-3-5-super-vl-with-post-training-beats-claude-opus-5-gpt-6-1-sol-on-specialized-task-benchmarks
- The Decoder (2026-10-15): https://the-decoder.com/nvidias-nemotron-3-5-super-vl-is-an-open-model-built-to-run-enterprise-ai-agents-nonstop/
- SiliconANGLE (2026-10-15): https://siliconangle.com/2026/10/15/nvidia-expands-nemotron-llm-family-with-hyper-efficient-models-for-agentic-systems/
- vLLM 블로그 (2026-10-15): https://vllm.ai/blog/2026-10-15-nemotron-3-5-super-vl-vllm
답글 남기기