
Ai2가 2026년 11월 공개한 ToyBlocks는 로봇 정책이 실패하는 원인을 변수별로 가려내는 통제형 평가 환경입니다. 평가 구조와 일반화 실험 결과, 재현성의 한계, GPU 요건과 라이선스를 짚습니다.
이 글에는 네이버 브랜드커넥트 제휴 링크가 포함되어 있습니다. 링크를 통해 구매가 이루어지면 작성자가 일정액의 수수료를 지급받습니다. 제품 선택과 구매는 독자의 판단이며, 이 글은 특정 제품의 효과를 보증하지 않습니다.
피지컬 AI 핵심만 먼저 정리하면
ToyBlocks는 새 로봇 제품이 아닙니다. 피지컬 AI 로봇 정책이 왜 실패하는지 변수별로 떼어 보는 통제형 평가 환경입니다. Ai2(앨런 AI 연구소)가 2026년 11월 6일에 공개했고, 장기 시연 85,336건(로봇 실행 약 1,600시간, 프레임 약 1억 4,400만 장)도 함께 풀었습니다. 이 가운데 사람이 원격 조종한 시연은 0건입니다.
가장 눈여겨볼 결과는 일반화 실험입니다. 학습한 영역에서 80%를 내던 π0.5가 블록 위치를 왼쪽에서 오른쪽으로 옮기자 10%로 떨어졌습니다. 피지컬 AI 시연 영상을 볼 때 “학습한 조건 그대로인가”부터 따져야 하는 이유를 이 숫자 하나가 보여 줍니다.
이 글은 ToyBlocks의 평가 구조, 공간 일반화 실험, 시뮬레이션과 실물 결과의 간극, 직접 돌릴 때 필요한 GPU와 라이선스를 다룹니다. 관련주나 ETF 같은 투자 판단은 다루지 않습니다. 수치는 2026년 11월 12일 기준 Ai2 공식 자료에서 가져왔습니다.
Q1. 피지컬 AI 로봇 평가에 왜 별도의 통제 환경이 필요한가요?
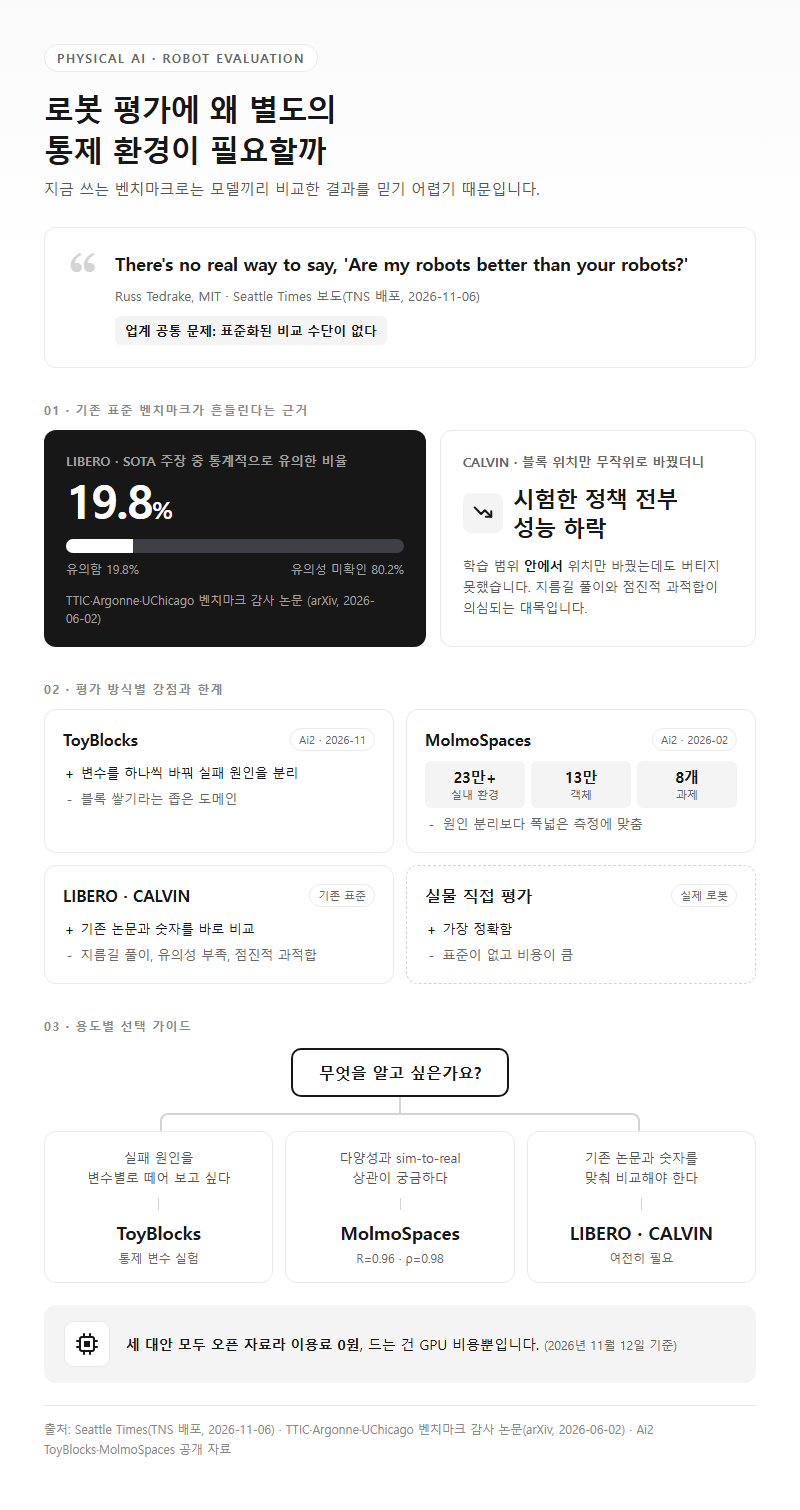
지금의 로봇 벤치마크로는 모델끼리 비교한 결과를 믿기 어렵기 때문입니다. Seattle Times가 2026년 11월 6일에 낸 보도(TNS 배포)에서 MIT의 Russ Tedrake는 “There’s no real way to say, ‘Are my robots better than your robots?’”라고 말했습니다. 표준화된 비교 수단이 없다는, 업계가 함께 겪는 문제를 짚은 말입니다.
기존 표준 벤치마크가 흔들린다는 근거도 있습니다. TTIC·Argonne·UChicago 연구진이 2026년 6월 2일 arXiv에 공개한 벤치마크 감사 논문을 보면, LIBERO의 SOTA 주장 중 통계적으로 유의한 것은 19.8%뿐이었습니다. CALVIN에서는 블록 위치를 학습 범위 안에서 무작위로 바꾸기만 했는데도 시험한 정책 전부의 성능이 떨어졌습니다.
| 평가 방식 | 강점 | 한계 |
|---|---|---|
| ToyBlocks (Ai2, 2026-11) | 변수를 하나씩 바꿔 실패 원인을 분리 | 블록 쌓기라는 좁은 도메인 |
| MolmoSpaces (Ai2, 2026-02) | 실내 환경 23만 개 이상, 객체 13만 개, 과제 8개 | 원인을 분리하기보다 폭넓게 측정하는 데 맞춤 |
| LIBERO·CALVIN | 기존 논문과 숫자를 바로 비교 가능 | 지름길 풀이, 유의성 부족, 점진적 과적합 지적 |
| 실물 직접 평가 | 가장 정확함 | 표준이 없고 비용이 큼 |
용도에 따라 나눠 쓰면 됩니다. 다양성과 sim-to-real 상관(MolmoSpaces R=0.96, ρ=0.98)이 궁금하면 MolmoSpaces를, 실패 원인을 변수별로 떼어 보려면 ToyBlocks를 씁니다. 기존 논문과 숫자를 맞춰 비교해야 한다면 LIBERO·CALVIN도 여전히 필요합니다. 세 대안 모두 오픈 자료라 이용료는 없고 GPU 비용만 듭니다(2026년 11월 12일 기준).
Q2. ToyBlocks 평가 구조는 무엇을 통제하고 점수는 어떻게 매기나요?
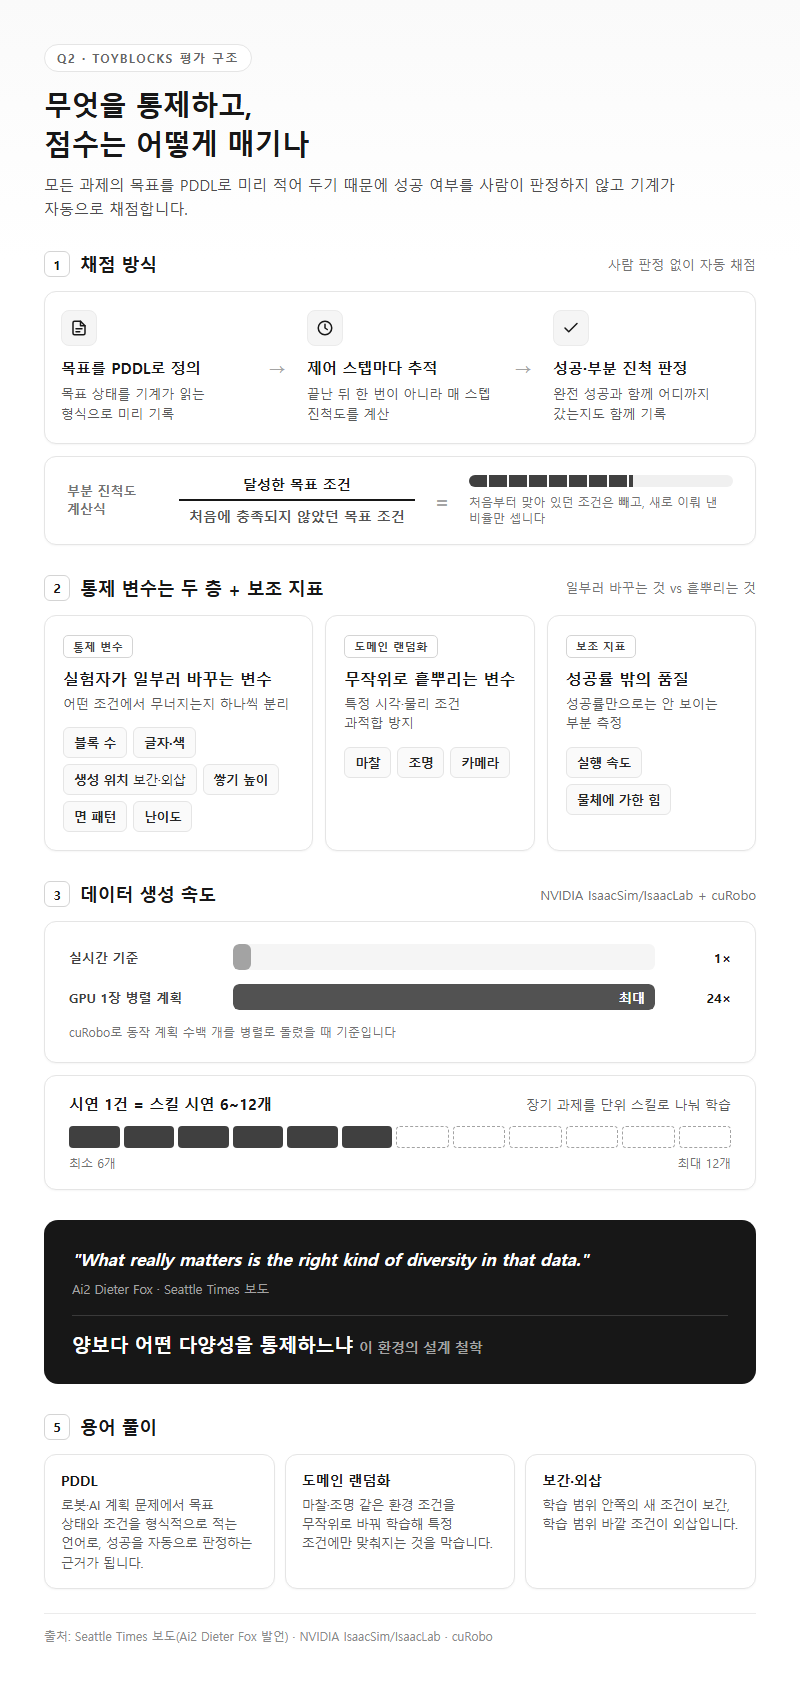
가장 큰 특징은 모든 과제의 목표를 PDDL로 미리 적어 둔다는 점입니다. 목표 상태를 기계가 읽는 형식으로 정의해 두었으니 성공 여부를 사람이 눈으로 판정할 필요가 없습니다. 부분 진척도는 처음에 충족되지 않았던 목표 조건 가운데 달성한 비율로 계산하고, 제어 스텝마다 추적합니다.
통제 대상 변수는 두 층입니다. 실험자가 일부러 바꾸는 변수와, 도메인 랜덤화로 흩뿌리는 변수입니다.
| 구분 | 변수 | 목적 |
|---|---|---|
| 통제 변수 | 블록 수, 블록의 글자·색, 생성 위치(보간·외삽), 쌓기 높이, 면 패턴, 난이도 | 어떤 조건에서 무너지는지 하나씩 분리 |
| 도메인 랜덤화 | 마찰, 조명, 카메라 등 | 특정 시각·물리 조건에 과적합되는 것 방지 |
| 보조 지표 | 실행 속도, 물체에 가한 힘 | 성공률만으로 안 보이는 품질 측정 |
기반은 NVIDIA IsaacSim/IsaacLab이고, 동작 계획은 cuRobo가 맡습니다. 계획 수백 개를 병렬로 돌리면 데이터 생성 속도가 GPU 1장으로 실시간의 최대 24배까지 나옵니다. 시연 1건에 스킬 시연이 6~12개 들어 있어, 장기 과제를 단위 스킬로 쪼개 학습시키기에도 좋습니다.
데이터를 두고 Ai2의 Dieter Fox는 같은 Seattle Times 보도에서 “What really matters is the right kind of diversity in that data.”라고 말했습니다. 양보다 어떤 다양성을 통제하느냐, 이것이 이 환경의 설계 철학입니다.
용어 풀이
1. PDDL — 로봇·AI 계획 문제에서 목표 상태와 조건을 형식적으로 적는 언어로, 성공을 자동 판정하는 근거가 됩니다.
2. 도메인 랜덤화 — 마찰·조명 같은 환경 조건을 무작위로 바꿔 학습해 특정 조건에만 맞춰지는 것을 막는 기법입니다.
3. 보간·외삽 — 학습 범위 안쪽의 새 조건이 보간이고, 학습 범위 바깥 조건이 외삽입니다.
Q3. 피지컬 AI 로봇은 학습한 자리를 벗어나면 성공률이 얼마나 떨어지나요?
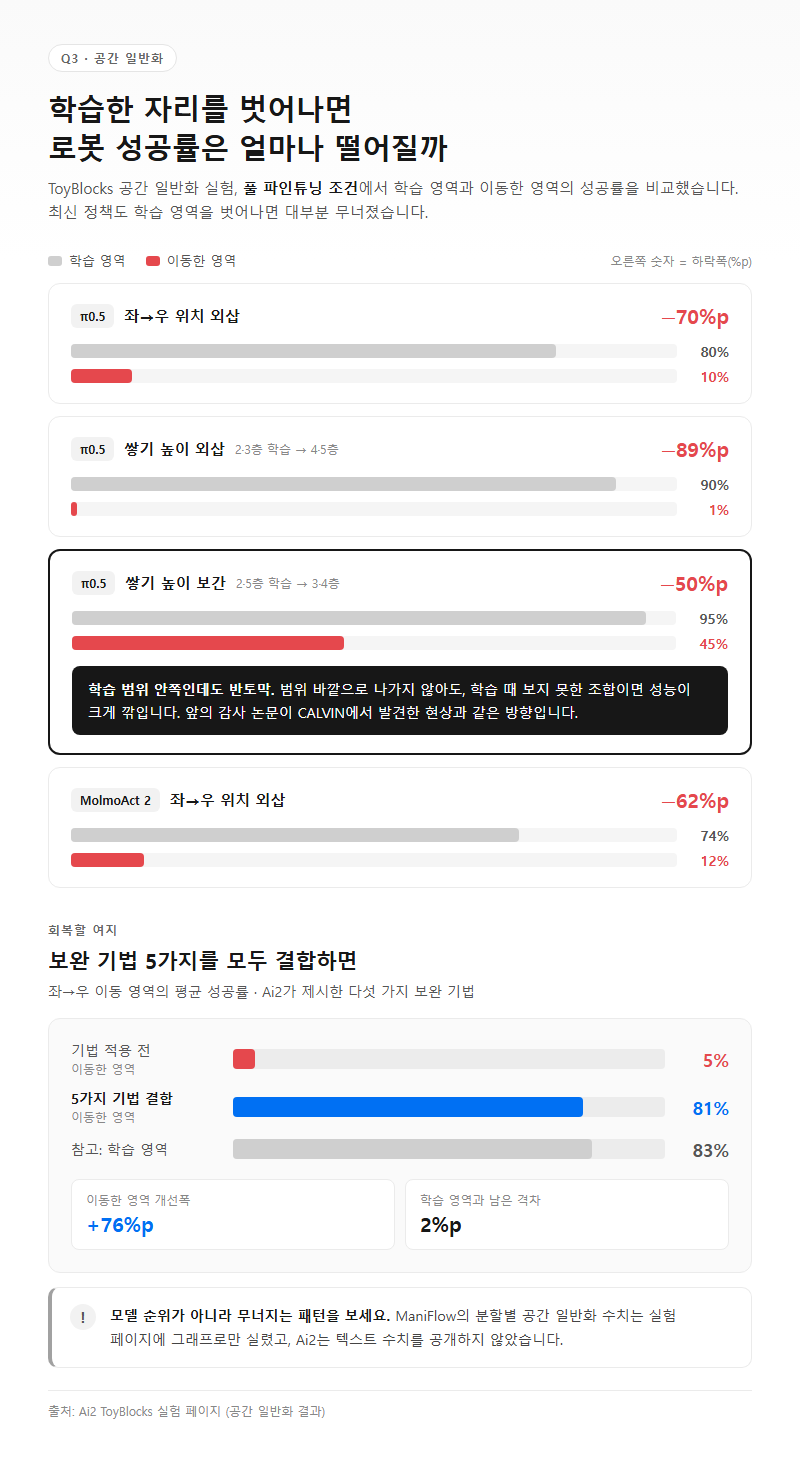
ToyBlocks 실험 페이지의 공간 일반화 결과에서 최신 정책도 학습 영역을 벗어나면 대부분 무너졌습니다. 아래 수치는 모두 풀 파인튜닝 조건에서 학습 영역과 이동한 영역의 성공률을 비교한 값입니다.
| 모델 | 실험 조건 | 학습 영역 | 이동한 영역 |
|---|---|---|---|
| π0.5 | 좌→우 위치 외삽 | 80% | 10% |
| π0.5 | 쌓기 높이 외삽 (2,3층 학습 → 4,5층) | 90% | 1% |
| π0.5 | 쌓기 높이 보간 (2,5층 학습 → 3,4층) | 95% | 45% |
| MolmoAct 2 | 좌→우 위치 외삽 | 74% | 12% |
특히 볼 행은 보간입니다. 학습 범위 안쪽인 3·4층에서도 95%가 45%로 떨어졌습니다. 범위 바깥으로 나가지 않아도, 학습 때 보지 못한 조합이면 성능이 크게 깎인다는 뜻입니다. 앞의 감사 논문이 CALVIN에서 발견한 현상과 같은 방향입니다.
회복할 여지도 확인됐습니다. Ai2가 제시한 다섯 가지 보완 기법을 모두 결합하자 좌→우 이동 영역의 평균 성공률이 기법 적용 전 5%에서 81%로 올라왔습니다. 학습 영역 성공률이 83%였으니, 이동한 영역이 학습 영역 수준에 거의 다다른 셈입니다.
ManiFlow의 분할별 공간 일반화 수치는 실험 페이지에 그래프로만 실렸고, Ai2는 텍스트 수치를 공개하지 않았습니다. 그러니 이 결과는 모델 간 순위를 매기기보다 무너지는 패턴을 보는 데 쓰는 편이 맞습니다.
Q4. 시뮬레이션 성공률을 실물 로봇 성능으로 봐도 되나요?
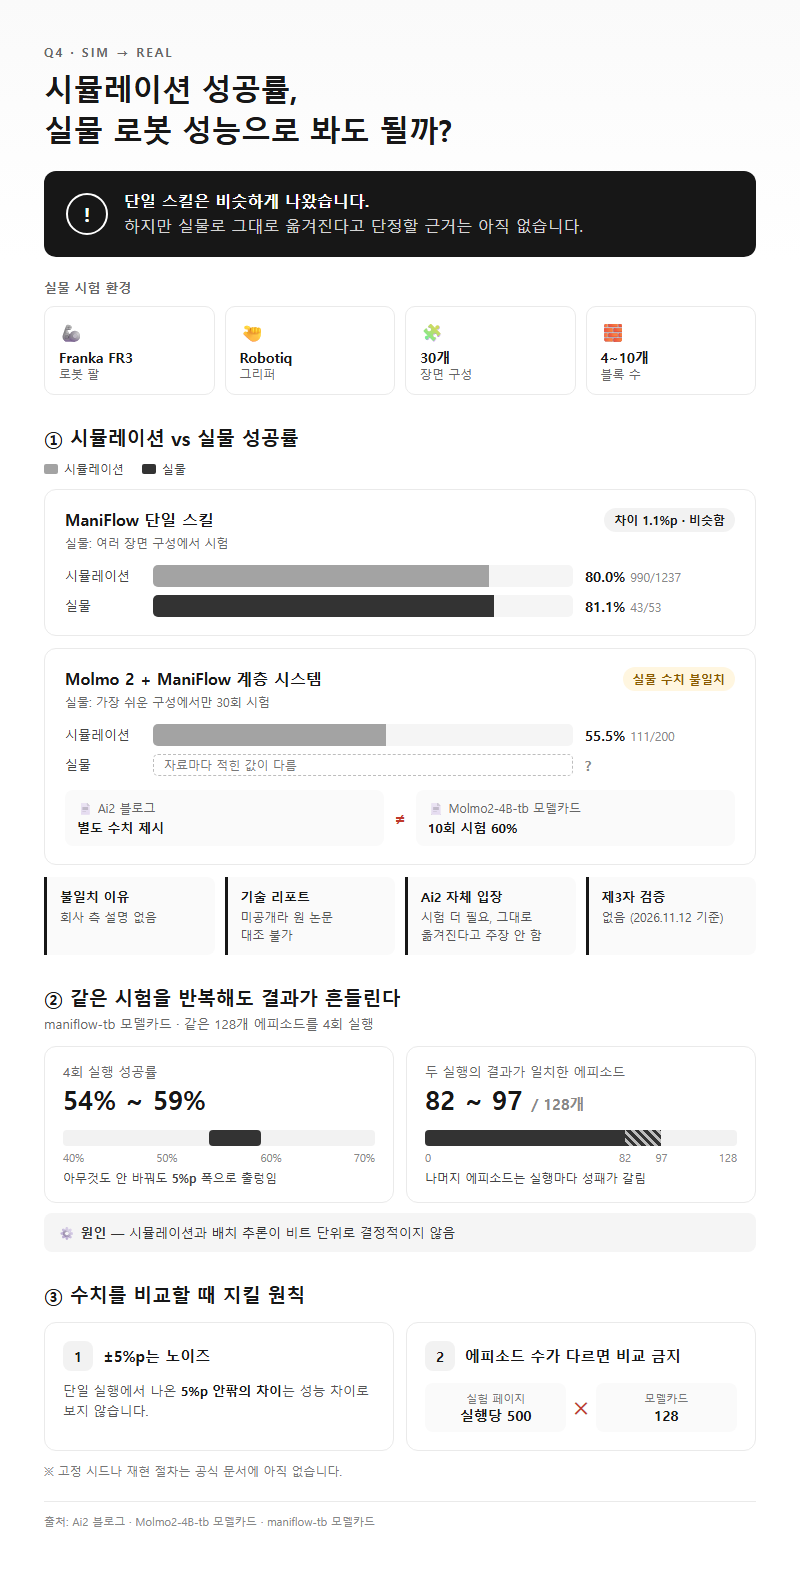
단일 스킬 수준에서는 비슷하게 나왔지만, 그대로 옮겨진다고 단정할 근거는 아직 없습니다. 실물 시험에는 Franka FR3 팔과 Robotiq 그리퍼, 장면 구성 30개, 블록 4~10개를 썼습니다.
| 시스템 | 시뮬레이션 | 실물 | 실물 시험 조건 |
|---|---|---|---|
| ManiFlow 단일 스킬 | 80.0% (990/1237) | 81.1% (43/53) | 여러 장면 구성 |
| Molmo 2 + ManiFlow 계층 시스템 | 55.5% (111/200) | 자료마다 다름 | 가장 쉬운 구성에서만 30회 |
계층 시스템의 실물 결과는 자료마다 적힌 값이 다릅니다. Ai2 블로그의 수치와 Molmo2-4B-tb 모델카드의 수치(10회 시험 60%)가 맞지 않는데, 회사는 그 이유를 설명하지 않았습니다. 기술 리포트가 아직 나오지 않아 정확한 수치를 원 논문으로 확인하지도 못했습니다. Ai2 스스로도 통계적 신뢰를 얻으려면 시험을 더 해야 한다고 밝혔고, 시뮬레이션 결과가 실물로 그대로 옮겨진다고 주장하지 않습니다. 2026년 11월 12일 기준으로 이를 검증한 제3자 실험도 없습니다.
재현성은 따로 따져 봐야 합니다. maniflow-tb 모델카드에 따르면 같은 128개 에피소드를 4회 돌린 성공률이 54%~59%로 흔들렸고, 두 실행의 결과가 일치한 에피소드는 128개 중 82~97개였습니다. 시뮬레이션과 배치 추론이 비트 단위로 결정적이지 않아서입니다.
그래서 비교할 때 지킬 원칙이 두 가지입니다. 첫째, 단일 실행에서 나온 5%p 안팎의 차이는 노이즈로 봅니다. 둘째, 실험 페이지(실행당 500 에피소드)와 모델카드(128 에피소드)처럼 에피소드 수가 다른 수치끼리는 비교하지 않습니다. 고정 시드나 재현 절차는 공식 문서에 아직 없습니다.
Q5. 피지컬 AI 교육·연구용으로 직접 돌려 보려면 GPU와 라이선스 조건은?

평가만 돌린다면 진입 장벽이 낮지만, 파인튜닝부터는 비용이 크게 뜁니다. Ai2 문서 기준으로 정리했습니다.
| 항목 | 조건 |
|---|---|
| ManiFlow 단독 평가 | VRAM 16GB 카드 1장 |
| Molmo 2 평가 | 약 24GB 또는 GPU 2장 |
| Molmo2-4B 파인튜닝 | H100 8장으로 약 8시간 |
| 공개 체크포인트 | Molmo2-4B-tb(약 4.5B, 약 6Hz), maniflow-tb(322.5M) |
| 시뮬레이터 | IsaacSim/IsaacLab, 사실상 NVIDIA GPU 전제 |
| 코드·데이터 라이선스 | 코드 Apache-2.0, 데이터셋 ODC-BY |
| 데이터 형식 | LeRobot |
데이터가 LeRobot 형식이라 기존 학습 파이프라인으로 옮기기 쉽습니다. 대학 수업이나 사내 스터디처럼 피지컬 AI 교육용으로 쓴다면 ManiFlow 평가부터 시작하는 것이 현실적인 첫 단계입니다. 16GB 카드 한 장이면 시뮬레이션 평가 전 과정을 따라가 볼 수 있습니다.
상업적으로 쓰려면 라이선스를 한 번 더 확인하세요. 공개 가중치는 Apache 2.0이지만, 모델카드에 따르면 베이스 모델 Molmo2-4B는 학술·비상업 연구용 제3자 데이터로 학습됐습니다. 제품에 넣을 계획이라면 법무 검토부터 받는 편이 안전합니다.
공개 범위에도 한계가 있습니다. RL 학습 통합 기능은 현재 패키지에 없습니다. Ai2는 데이터 확대·스킬 추가·벤치마크 확장을 담은 2차 공개를 “몇 주 안”에 하겠다고만 밝혔고, 기술 리포트도 GitHub README에 “coming soon”으로만 적혀 있습니다. 공개 후 6일밖에 지나지 않아 제3자 측정 결과와 리더보드 등록도 아직 없습니다.
정리
ToyBlocks는 로봇이 “잘한다”를 보여 주는 도구가 아닙니다. 어떤 조건에서 왜 무너지는지를 변수별로 보여 주는 도구입니다. π0.5가 위치 외삽에서 80%에서 10%로, 높이 외삽에서 90%에서 1%로 떨어진 결과를 보면, 피지컬 AI 로봇 시연은 학습 조건부터 확인해야 합니다.
다만 이 수치들을 실물 성능 순위로 읽어서는 안 됩니다. 실물 시험은 쉬운 조건에 한정됐고, 같은 설정에서도 실행마다 5%p 안팎씩 흔들립니다. 기술 리포트와 2차 공개가 나온 뒤에 다시 판단하는 것이 맞습니다. 직접 돌려 보려면 16GB GPU에서 ManiFlow 평가로 시작하고, 상업적으로 쓸 계획이면 Molmo2 베이스의 비상업 데이터 제약부터 확인하세요.
함께 보면 좋은 제품
- 라이프밀 홀그레인 저당 그래놀라 귀리 시리얼 20g 7봉
- 그릭요거트 토핑을 올린 귀리 그래놀라 시리얼입니다.
위 링크는 제휴 링크이며, 제품 선택은 독자의 판단입니다.
참고 자료
조사 기준일: 2026년 11월 12일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (모두 2026-11-12 확인)
– https://allenai.org/blog/toyblocks
– https://huggingface.co/blog/allenai/toyblocks
– https://github.com/allenai/ToyBlocks
– https://allenai.github.io/ToyBlocks
– https://allenai.github.io/ToyBlocks/evals.html
– https://allenai.github.io/ToyBlocks/experiments.html
– https://allenai.github.io/ToyBlocks/docs/user_guide/index.html
– https://huggingface.co/datasets/allenai/toyblocks-data
– https://huggingface.co/allenai/maniflow-tb
– https://huggingface.co/allenai/Molmo2-4B-tb
– https://arxiv.org/abs/2602.11337 (MolmoSpaces)
– https://www.chronline.com/stories/why-a-seattle-ai-lab-is-making-robots-play-with-toy-blocks,411448 (Seattle Times 기사, TNS 배포)
– https://arxiv.org/html/2606.04233 (벤치마크 감사 논문)
– https://www.unite.ai/ai2-releases-toyblocks-to-test-how-robots-learn-and-fail/ (Ai2 수치를 옮긴 기사이고 독자 취재가 없어 보조 자료로만 씀)
– https://letsdatascience.com/news/ai2-releases-toyblocks-an-open-tabletop-simulator-for-robot-a2e13867 (보조 자료)
답글 남기기