

Dharma Field Extractor는 2026년 11월 9일 기준 가중치가 공개되지 않았고 라이선스도 비상업용입니다. 0.834라는 점수가 무엇을 재는지, 도입 전에 직접 검증할 6단계를 정리했습니다.
이 글에는 네이버 브랜드커넥트 제휴 링크가 포함되어 있습니다. 링크를 통해 구매가 이루어지면 작성자가 일정액의 수수료를 지급받습니다. 제품 선택과 구매는 독자의 판단이며, 이 글은 특정 제품의 효과를 보증하지 않습니다.
허깅페이스 시작 전 확인할 것
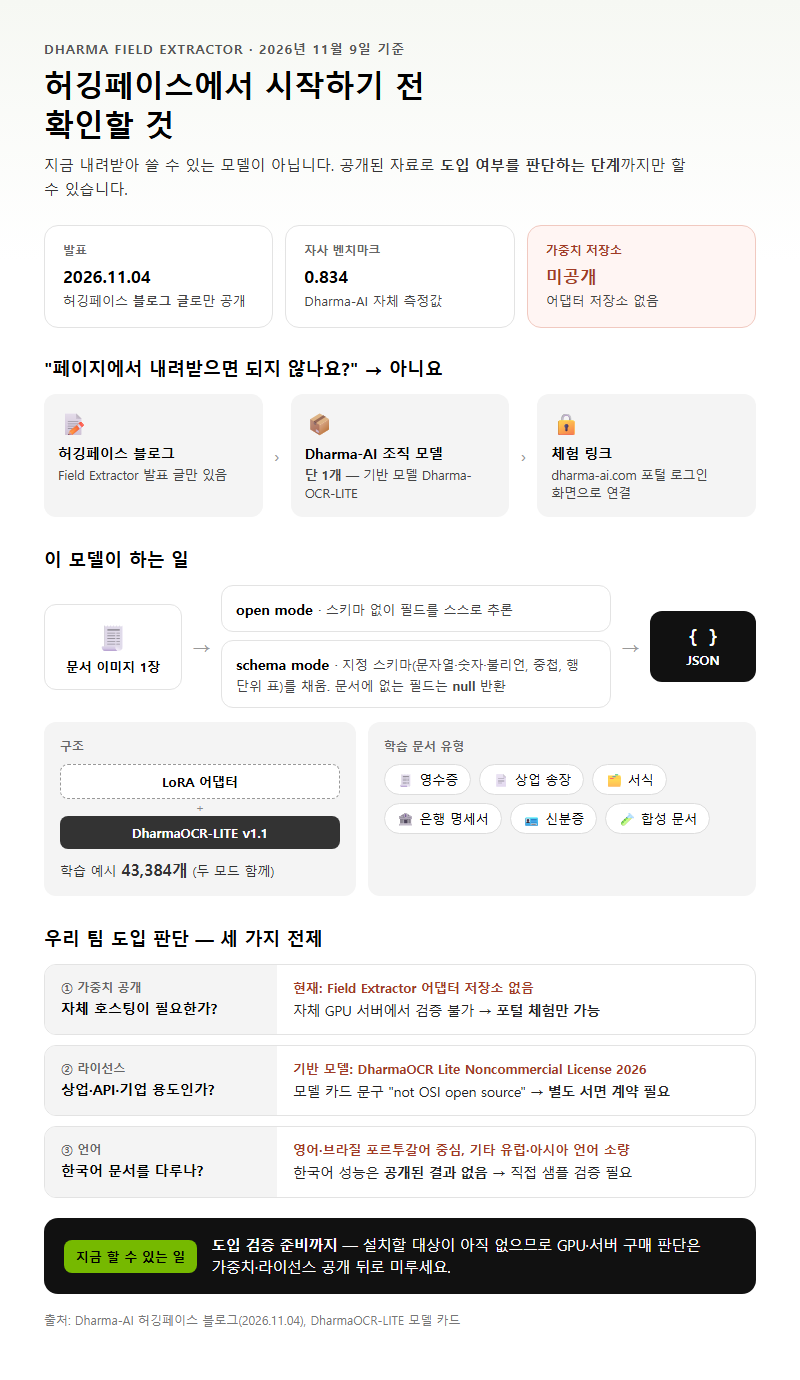
Dharma Field Extractor는 지금 바로 받아서 쓸 수 있는 모델이 아닙니다. 그래서 할 수 있는 일은 도입 검증 준비까지입니다. 브라질 기업 Dharma-AI는 2026년 11월 4일 허깅페이스 블로그에 이 문서 JSON 추출 모델을 발표하며 자사 벤치마크 점수 0.834를 내세웠습니다. 그런데 2026년 11월 9일 기준 Field Extractor 가중치 저장소는 공개되지 않았습니다. 이 글은 공개된 자료로 도입 여부를 판단하는 절차를 다룹니다. 설치할 대상이 아직 없으니 설치 방법은 다루지 않습니다.
“허깅페이스 ai 모델이니 페이지에서 내려받으면 되지 않느냐”고 묻는다면 답은 ‘아니요’입니다. 여기서 허깅페이스는 모델 저장소와 기술 블로그를 함께 운영하는 플랫폼을 가리킵니다. Field Extractor는 그 플랫폼에 블로그 글로만 발표됐습니다. 2026년 11월 9일 기준 Dharma-AI 조직에 공개된 모델은 기반 모델인 Dharma-OCR-LITE 단 1개이고, 블로그의 체험 링크를 누르면 dharma-ai.com 포털 로그인 화면이 나옵니다.
이 모델이 하는 일
문서 이미지 한 장을 넣으면 JSON을 돌려줍니다. 모드는 두 가지입니다. 스키마 없이 필드를 스스로 추론하는 open mode, 그리고 사용자가 지정한 스키마(문자열·숫자·불리언, 중첩 구조, 행 단위 표)를 채우는 schema mode입니다. 회사 설명에 따르면 schema mode에서는 문서에 없는 필드를 지어내지 않고 null로 돌려줍니다. 블로그 원문 표현은 “it returns null instead of inventing a value”입니다.
구조는 DharmaOCR-LITE v1.1 위에 LoRA 어댑터를 얹은 형태입니다. 블로그에는 “we trained a LoRA adapter on 43,384 training examples covering both request modes”라고 적혀 있습니다. 학습 예시 43,384개가 두 모드를 함께 다룬다는 뜻입니다. 학습 문서는 영수증, 상업 송장, 서식, 은행 명세서, 신분증, 합성 문서입니다.
시작 전 세 가지 전제
| 전제 | 2026년 11월 9일 기준 상태 | 판단에 미치는 영향 |
|---|---|---|
| 가중치 공개 | Field Extractor 어댑터 저장소 없음 | 자체 호스팅 검증 불가, 포털 체험만 가능 |
| 라이선스 | 기반 모델은 DharmaOCR Lite Noncommercial License 2026 | 상업·API·기업 용도는 별도 서면 계약 필요 |
| 언어 | 영어·브라질 포르투갈어 중심, 기타 유럽·아시아 언어 소량 | 한국어 문서 성능은 공개된 결과 없음 |
기반 모델 카드에는 “not OSI open source”라는 문구가 있습니다. 블로그에 오픈소스 모델이라는 표현이 나오더라도 상업 배포에 그대로 쓸 수 있는 라이선스는 아닙니다.
용어 풀이
1. LoRA 어댑터 — 원래 모델은 그대로 두고 작은 추가 가중치만 학습해 특정 작업에 맞추는 파인튜닝 방식입니다.
2. JSON 스키마 — 출력 JSON에 들어갈 필드 이름과 자료형을 미리 정해 두는 틀입니다.
3. OSI 오픈소스 — 오픈소스 이니셔티브(OSI)의 정의를 충족해 상업적 이용과 재배포가 자유로운 라이선스를 말합니다.
준비물·필요 서류

도입을 검토하는 팀에 먼저 필요한 건 GPU가 아니라 정답이 붙은 자체 문서 묶음입니다. 회사가 발표한 점수는 회사가 만든 시험지에서 나왔습니다. 판단 근거는 우리 문서로 다시 만들어야 합니다. 아래 표에 검증 단계에서 필요한 항목과 각 항목의 공개 상태를 정리했습니다.
| 준비물 | 용도 | 상태·출처 (2026년 11월 9일 기준) |
|---|---|---|
| 자체 문서 샘플 100–200건 | 필드별 정확 일치율 측정 | 직접 준비, 문서마다 정답 JSON을 붙여야 함 |
| 추출 스키마 정의서 | schema mode 입력, 정답 기준 | 직접 작성, 필드 자료형·중첩·표 구조 명시 |
| 기반 모델 Dharma-OCR-LITE | OCR 단계 사전 시험 | 허깅페이스 공개, Qwen2.5-VL 아키텍처, vLLM·transformers 예제 있음 |
| dharma-ai.com 포털 계정 | Field Extractor 체험 | 로그인 필요, 가입 조건은 회사가 공개하지 않음 |
| 라이선스 문서 | 사용 범위 확인 | 기반 모델은 비상업용, 어댑터 라이선스는 회사가 밝히지 않음 |
| 비교군 API | 프런티어 모델과 같은 조건 비교 | Claude Opus 5, GPT-5.6 계열 등, 요금은 각 사 공식 요금표로 확인 |
| GPU 비용 기준 | 자체 호스팅 비용 추정 | 회사는 단일 L40S를 시간당 $2.24로 가정 |
공개된 것과 공개되지 않은 것
| 구분 | 내용 |
|---|---|
| 공개됨 | 발표 블로그, 기반 모델 Dharma-OCR-LITE, DharmaOCR 원논문(arXiv 2604.14314) |
| 공개되지 않음 | Field Extractor 가중치, 어댑터 라이선스, 문서당 달러 비용, 처리량, 지연 시간 |
| 블로그에 없음 | PDF·여러 페이지 입력 지원 여부, 입력 해상도 상한 |
기반 모델을 받아 둔다고 필드 추출 성능이 재현되지는 않습니다. Dharma-OCR-LITE는 OCR 모델이고, JSON 필드 추출 능력은 공개되지 않은 어댑터에 들어 있습니다. 기반 모델은 “글자를 제대로 읽는가”를 먼저 확인하는 데만 쓰면 됩니다.
참고로 DharmaOCR 연구팀이 2026년 4월 15일 arXiv에 공개한 논문에서 Lite의 OCR 점수는 0.911, Full(7B)은 0.925였습니다. 반복 출력이 무너지는 degeneration 비율은 각각 0.20%와 0.40%였고, AWQ 양자화로 페이지당 비용을 최대 22% 줄였다고 합니다. 모두 OCR 과제 결과라 필드 추출 점수와 직접 비교할 수는 없습니다.
단계별 진행 순서

아래 6단계는 가중치 공개 전에 할 수 있는 검증과, 공개 뒤 곧바로 이어 갈 측정을 한 흐름으로 묶은 것입니다. 소요시간은 작업 성격에 따른 예상치이며 회사가 공개한 수치가 아닙니다.
1단계: 라이선스와 공개 범위 확인
- 할 일: 기반 모델 카드의 라이선스 조항을 읽고, 쓰려는 용도가 비상업 범위인지 판정합니다. 사내 업무 자동화, 고객 대상 서비스, API 제공 가운데 어디에 해당하는지부터 정합니다.
- 소요시간: 짧음. 문서 검토 위주입니다.
- 주의점: 모델 카드는 상업·API·기업 용도에 별도 서면 라이선스가 필요하다고 명시합니다. 사내에서만 써도 기업 용도이니 법무 검토를 거쳐야 합니다.
2단계: 자체 평가셋 구성
- 할 일: 실제 업무 문서 100–200건을 모으고 문서마다 정답 JSON을 붙입니다. 회사 벤치마크는 문서 546건에 요청 시나리오 3개를 곱해 1,638케이스를 만들었는데, 이 방식을 그대로 가져오면 좋습니다.
- 시나리오 세 가지: ① 스키마 없음, ② 실제 있는 필드만 담은 부분 스키마, ③ 문서에 없는 필드가 섞인 스키마.
- 소요시간: 가장 깁니다. 정답 라벨링에 며칠이 걸릴 수 있습니다.
- 주의점: 개인정보가 담긴 신분증·은행 명세서는 외부 포털에 올리기 전에 비식별 처리를 해야 합니다.
3단계: 추출 스키마 설계
- 할 일: 필드마다 string·number·boolean 자료형을 정하고, 품목 목록처럼 반복되는 값은 행 단위 표로 정의합니다.
- 소요시간: 반나절 안팎(예상).
- 주의점: 금액을 number로 둘지, 통화 기호가 붙은 string으로 둘지 정답과 맞춰야 합니다. 여기서 어긋나면 제대로 추출한 값도 오답으로 집계됩니다.
4단계: 포털 체험과 기반 모델 사전 시험
- 할 일: dharma-ai.com 포털에서 비식별 샘플 몇 건으로 open mode와 schema mode를 돌려 봅니다. 동시에 Dharma-OCR-LITE를 vLLM이나 transformers로 띄워 원문 텍스트 인식 품질을 확인합니다.
- 소요시간: 환경 구성에 따라 반나절부터 하루(예상).
- 주의점: 포털 결과는 재현 조건(버전·설정)을 알 수 없습니다. 점수 비교가 아니라 동작 확인용으로만 씁니다.
5단계: 필드별 정확 일치 측정
- 할 일: 금액·계좌번호·사업자번호·날짜처럼 한 글자만 틀려도 사고가 나는 필드는 정확 일치율을 따로 계산합니다. 같은 평가셋을 비교군 API에도 똑같이 넣습니다.
- 소요시간: 평가 스크립트 작성 포함 하루 안팎(예상).
- 주의점: 회사의 0.834는 정확 일치율이 아닙니다. F1 × Levenshtein 유사도 × 유효 JSON 비율을 곱한 복합 점수라서, 우리 지표와 나란히 놓고 비교하면 안 됩니다.
6단계: 총소유비용(TCO) 재계산
- 할 일: 월 처리량, GPU 유휴 시간, 운영 인력, 라이선스 계약 비용을 넣어 자체 호스팅 비용을 다시 계산하고 API 비용과 비교합니다.
- 소요시간: 짧음. 처리량 자료만 있으면 바로 계산할 수 있습니다.
- 주의점: 회사는 GPT-5.6 Luna보다 약 6배, GPT-5.6 Sol보다 약 147배 저렴하다고 밝혔지만, 이 비교는 L40S GPU 시간만 계산한 값입니다. 블로그에도 “This is not a sales price”라고 적혀 있습니다.
용어 풀이
1. Levenshtein 유사도 — 두 문자열이 몇 글자를 고치면 같아지는지로 비슷한 정도를 재는 지표라서, 한 글자가 틀려도 점수가 크게 깎이지 않습니다.
2. TCO(총소유비용) — 장비 사용료뿐 아니라 유휴 시간, 운영 인력, 계약 비용까지 합친 실제 운영 비용입니다.
자주 놓치는 부분

0.834를 “83% 정확하다”로 읽는 실수
가장 흔한 오독입니다. 이 점수에는 경로 기준 필드 F1, 값의 문자열 유사도, 유효 JSON 비율이 함께 들어 있습니다. 토큰포스트는 2026년 11월 5일 보도에서 이 점수를 송장 금액·계좌번호의 정확 일치율로 읽을 수 없다고 지적했습니다. 금액이 한 자리 틀려도 유사도 점수는 높게 나올 수 있습니다.
Claude Opus 5와의 1.8포인트 차이
회사 발표에서 Field Extractor는 0.834, Claude Opus 5는 0.816, GPT-5.6 Luna는 0.741입니다. 차이는 각각 1.8포인트와 9.3포인트입니다. 하지만 explainx는 발표 당일 분석에서 “Dharma-AI wrote the benchmark and ran the rivals”라고 짚었습니다. 시험지 작성도, 경쟁 모델 실행도 개발사가 했다는 뜻입니다. 같은 분석은 1.8포인트가 작은 차이이고 신뢰구간도 제시되지 않았다고 평가했습니다.
비교 조건도 따져 봐야 합니다. 프런티어 모델은 reasoning low로 돌렸고 Opus 5에는 adaptive effort를 적용했습니다. 온도와 프롬프트 조건은 회사가 공개하지 않았습니다. explainx는 JSON 바깥에 설명 문장을 붙이는 프런티어 모델이 값을 맞혀도 유효 JSON 항목에서 감점된다는 점도 지적했습니다. 2026년 11월 9일 기준 제3자가 직접 측정한 결과는 아직 없습니다.
기반 모델 크기가 문서마다 다르다
| 자료 | 표기된 크기 |
|---|---|
| 발표 블로그(DharmaOCR-LITE v1.1) | 2B |
| 공개 모델카드 본문·원논문 | 3B |
| 허깅페이스 허브 메타데이터 | 4B |
공개된 모델카드에는 v1.1 표기가 없고 4월 업데이트본으로 올라 있습니다. 그래서 블로그의 v1.1이 공개 저장소의 어느 버전인지 지금은 알 수 없습니다. VRAM 계획은 가장 큰 표기를 기준으로 잡아야 안전합니다.
한국어 문서와 다중 페이지
학습 데이터는 영어와 브라질 포르투갈어 중심이고, 회사는 한국어 문서 결과를 공개하지 않았습니다. 기반 모델 카드도 브라질 포르투갈어 문서에 주로 최적화됐다고 밝힙니다. 세금계산서나 국내 은행 거래내역처럼 한글 서식이 많은 업무라면 2단계 평가셋 없이는 판단하기 어렵습니다. PDF나 여러 페이지 입력을 지원하는지도 블로그에 나와 있지 않습니다.
오픈 모델 대안과 비교할 때
Dharma 모델카드는 OCR 과제에서 Qwen2.5-VL-7B 0.839, olmOCR-2-7B 0.823, Nanonets-OCR2-3B 0.791이라는 점수를 제시합니다. 이 점수는 Dharma가 직접 측정한 OCR 점수이지 필드 추출 점수가 아닙니다. “Field Extractor가 오픈 모델보다 필드 추출을 잘한다”는 근거로는 쓸 수 없습니다.
용어 풀이
1. reasoning low — 추론형 모델이 답하기 전에 생각하는 양을 낮게 설정한 상태로, 비용과 속도는 유리하지만 정확도는 낮아질 수 있습니다.
2. 신뢰구간 — 측정값이 우연에 따라 흔들릴 수 있는 범위로, 이 값이 없으면 작은 점수 차이가 의미 있는 차이인지 판단할 수 없습니다.
체크리스트 정리
검토를 시작하기 전에 아래 항목을 차례로 확인합니다. 하나라도 “아니오”라면 지금은 프런티어 API나 라이선스가 확인된 오픈 모델로 업무를 돌리고, Field Extractor는 가중치가 공개될 때까지 지켜보는 쪽이 현실적입니다.
- 용도 판정: 쓰려는 용도가 비상업 범위인가, 아니면 별도 서면 라이선스를 계약할 의사가 있는가.
- 공개 상태 재확인: Dharma-AI 허깅페이스 조직에 Field Extractor 어댑터 저장소와 라이선스가 새로 올라왔는가(2026년 11월 9일 기준 없음).
- 평가셋 준비: 정답 JSON이 붙은 자체 문서 100–200건과, 없는 필드가 섞인 스키마 시나리오를 갖췄는가.
- 지표 분리: 금액·계좌번호 같은 핵심 필드의 정확 일치율을 복합 점수와 따로 계산하도록 설계했는가.
- 같은 조건 비교: 비교군 API를 같은 평가셋, 같은 프롬프트, 공개한 reasoning 설정으로 돌렸는가.
- 언어 적합성: 한국어 서식 문서에서 직접 측정한 결과를 확보했는가.
- 비용 재계산: L40S 시간당 $2.24라는 GPU 단가만이 아니라 유휴 시간·운영 인력·계약 비용을 넣은 TCO로 비교했는가.
근거 자료는 Dharma-AI 허깅페이스 발표 블로그, Dharma-OCR-LITE 모델카드, DharmaOCR 원논문(arXiv 2604.14314), explainx 발표 당일 분석, 토큰포스트 2026년 11월 5일 보도입니다.
함께 보면 좋은 제품
- 라이프밀 홀그레인 저당 그래놀라 귀리 시리얼 20g 7봉
- 그릭요거트 토핑을 올린 귀리 그래놀라 시리얼입니다.
위 링크는 제휴 링크이며, 제품 선택은 독자의 판단입니다.
참고 자료
조사 기준일: 2026년 11월 09일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (확인일 2026-11-09)
– https://huggingface.co/blog/Dharma-AI/dharma-field-extractor
– https://huggingface.co/Dharma-AI/Dharma-OCR-LITE
– https://huggingface.co/Dharma-AI
– https://huggingface.co/api/models?author=Dharma-AI
– https://arxiv.org/abs/2604.14314
– https://explainx.ai/blog/dharma-field-extractor-2b-document-to-json-0-834-vs-claude-opus-5-0-816-l40s-claimed-vs-verified-2026
– https://www.tokenpost.kr/news/ai/433262
– https://runtimewire.com/article/dharma-ai-field-extractor-2b-json
– (열람 실패, 404) https://dev.to/mikefluff/dharma-ai-releases-2b-field-extractor-for-document-to-json
답글 남기기