
AI 코딩 에이전트 스킬(Agent Skills) 설계 기준을 SkillsBench 실측치와 벤더 문서로 비교했습니다. SKILL.md 필드 상한, 컨텍스트 예산 1% vs 2%, 발동률 49%, 보안 취약률 26.1%까지 근거 중심으로 정리합니다.
AI코딩에이전트, 무엇을 기준으로 비교해야 할까
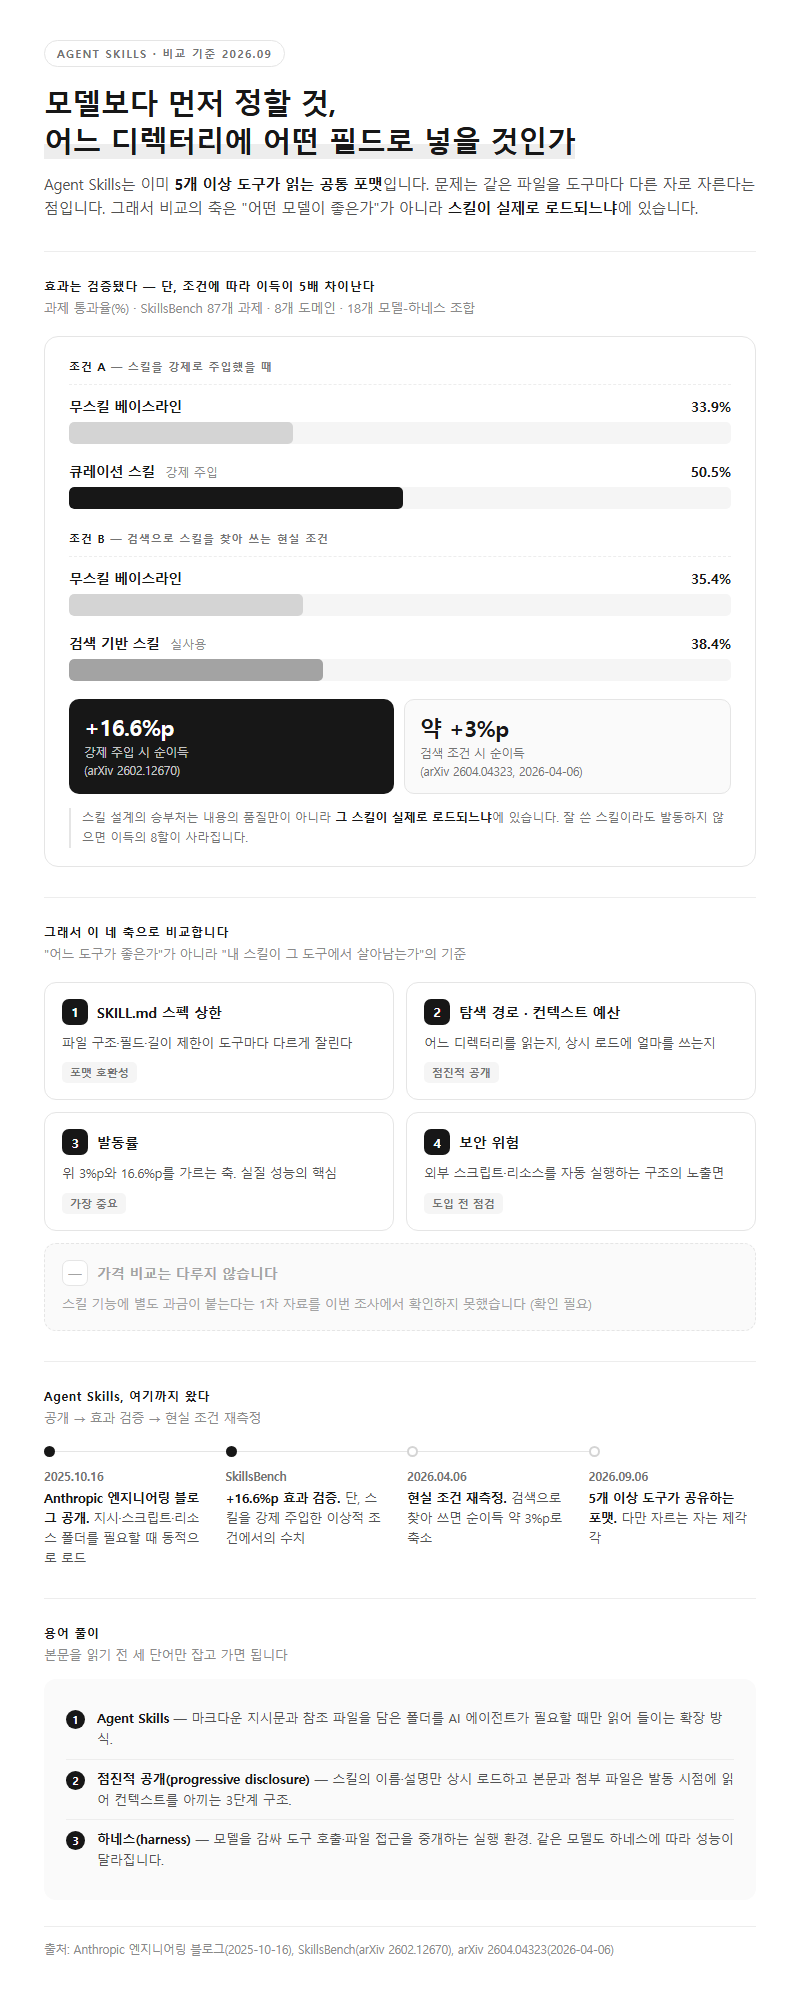
스킬을 설계할 때 가장 먼저 정할 것은 “어떤 모델이 좋은가”가 아닙니다. 어느 디렉터리에 어떤 필드로 넣을 것인가입니다. 2026년 9월 6일 기준으로 Agent Skills는 이미 5개 이상 도구가 읽는 공통 포맷이 됐지만, 같은 파일을 도구마다 다른 자로 자르기 때문입니다.
Agent Skills는 2025년 10월 16일 Anthropic 엔지니어링 블로그로 처음 공개됐습니다. 지시·스크립트·리소스를 담은 폴더를 에이전트가 필요할 때 동적으로 불러오는 구조입니다. 효과 자체는 검증됐습니다. SkillsBench(arXiv 2602.12670)는 87개 과제·8개 도메인에서 18개 모델-하네스 조합을 측정해 무스킬 33.9%에서 큐레이션 스킬 50.5%로 평균 통과율이 16.6%p 올랐다고 보고했습니다.
다만 이 수치는 스킬을 강제로 주입한 조건의 결과입니다. 후속 연구인 arXiv 2604.04323(2026-04-06)은 검색으로 스킬을 찾아 쓰는 현실적 조건에서 통과율 38.4%, 무스킬 베이스라인 35.4%로 순이득이 약 3%p까지 줄었다고 측정했습니다. 스킬 설계의 승부처는 내용의 품질만이 아니라 그 스킬이 실제로 로드되느냐에 있습니다.
이 글은 SKILL.md의 스펙 상한, 도구별 탐색 경로와 컨텍스트 예산, 발동률, 보안 위험 네 축으로 비교합니다. 가격 비교는 다루지 않습니다 — 스킬 기능에 별도 과금이 붙는다는 1차 자료를 이번 조사에서 확인하지 못했기 때문입니다(확인 필요).
용어 풀이
1. Agent Skills — 마크다운 지시문과 참조 파일을 담은 폴더를 AI 에이전트가 필요할 때만 읽어 들이는 확장 방식.
2. 점진적 공개(progressive disclosure) — 스킬의 이름·설명만 상시 로드하고 본문과 첨부 파일은 발동 시점에 읽어 컨텍스트를 아끼는 3단계 구조.
3. 하네스(harness) — 모델을 감싸 도구 호출·파일 접근을 중개하는 실행 환경. 같은 모델도 하네스에 따라 성능이 달라집니다.
비교 기준 정리
스킬 설계 문서를 읽을 때 실제로 판단을 바꾸는 값은 여섯 가지입니다. 특히 컨텍스트 예산과 설명 상한은 초과해도 오류를 내지 않고 조용히 잘리므로, 설계 단계에서 미리 계산해두지 않으면 문제를 인지할 방법이 없습니다.
| 기준 항목 | 값·단위 | 근거 | 주의점 |
|---|---|---|---|
| 필수 필드 수 | , 2개 | agentskills.io 명세 | 선택 필드는 ··· 4개뿐 |
| 상한 | 최대 64자 | agentskills.io 명세 | 소문자·숫자·하이픈만, 연속 하이픈 불가, 상위 디렉터리명과 일치 필수 |
| 상한 | 표준 1,024자 | agentskills.io 명세 | Claude Code는 +when_to_use 합산 1,536자로 다르게 잽니다 |
| 메타데이터 비용 | 스킬 1개당 약 100토큰(상시) | Claude 플랫폼 문서 | 발동 전에도 늘 컨텍스트를 차지합니다 |
| 본문 권장 상한 | 5,000토큰 미만 / 500줄 이하 | Claude 플랫폼 문서·Anthropic 작성 지침 | 참조 파일은 SKILL.md에서 1단계 깊이까지만 |
| 목록 예산 | Claude Code 컨텍스트의 1%, Codex 2% | 각 벤더 문서 | 초과 시 사용 빈도 낮은 스킬의 설명부터 버립니다 |
여기에 설계 절차 기준이 하나 더 붙습니다. Anthropic 공식 작성 지침은 문서를 먼저 쓰지 말고 평가를 먼저 만들라고 명시합니다. 갭 식별 → 평가 시나리오 최소 3개 작성 → 베이스라인 측정 → 최소 지시 작성 → 반복이라는 순서입니다. 참조 파일이 100줄을 넘으면 목차를 붙이라는 기준도 같은 문서에 있습니다.
분량 기준에는 성능 근거도 있습니다. SkillsBench는 모듈 3개 이하의 좁은 스킬이 크거나 망라적인 번들보다 성능이 높았다고 보고했고, 스킬을 붙인 작은 모델이 스킬 없는 큰 모델과 대등한 결과를 냈습니다. “일단 크게 만들어두고 나중에 줄인다”는 접근은 이 결과와 반대 방향입니다.
옵션·유형별 비교
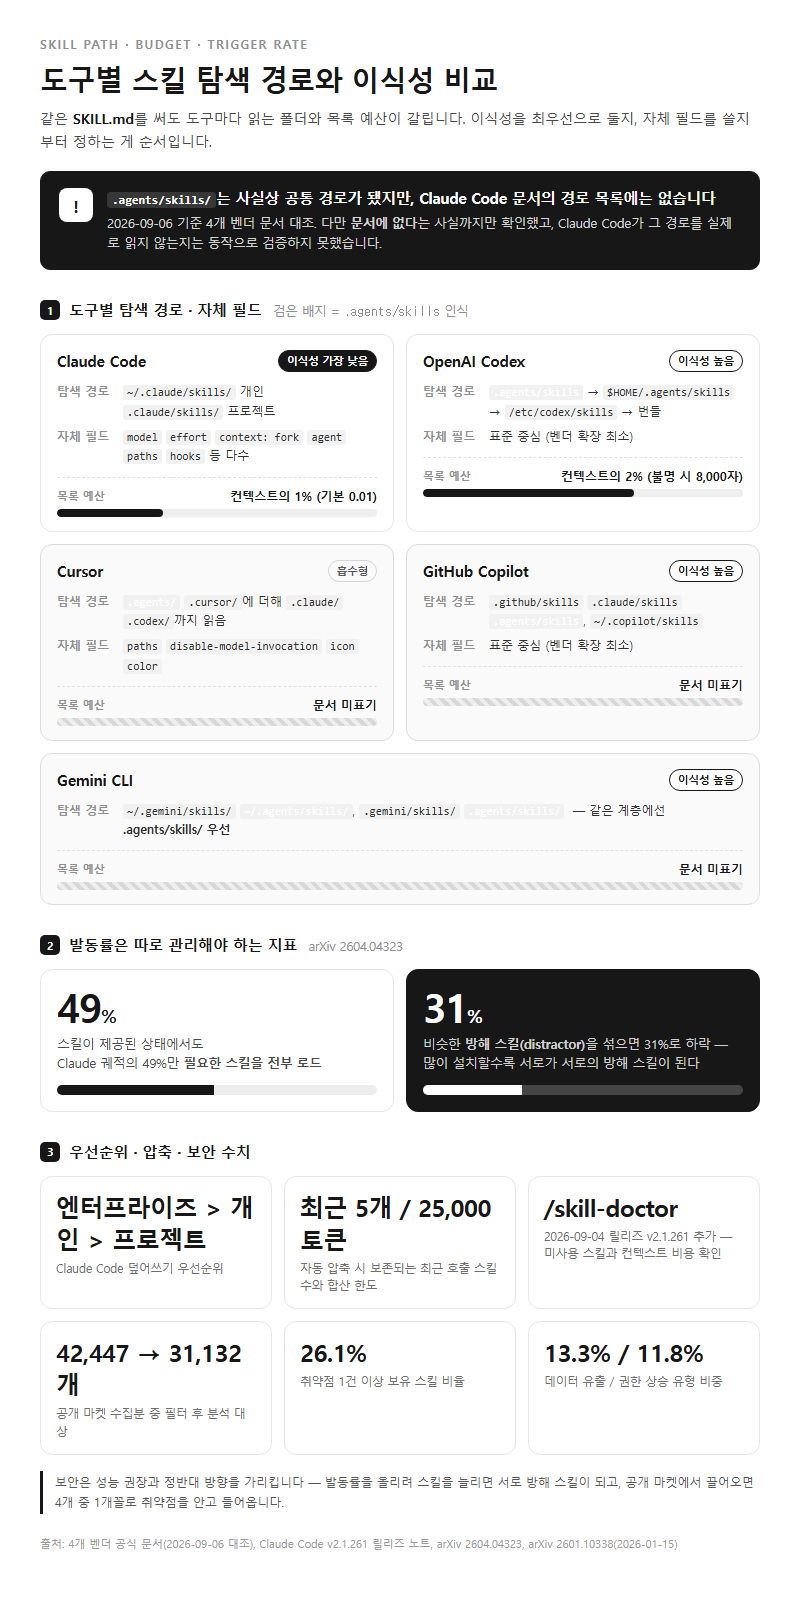
도구별로 탐색 경로와 자체 필드가 갈립니다. 가장 중요한 차이는 .agents/skills/가 사실상 공통 경로가 됐는데 Claude Code 문서의 경로 목록에는 그 경로가 없다는 점입니다(2026-09-06 기준 4개 벤더 문서 대조). 다만 Claude Code가 그 경로를 실제로 전혀 읽지 않는지는 문서에 없다는 사실까지만 확인했고, 동작 자체는 검증하지 못했습니다.
| 도구 | 주요 탐색 경로 | 목록 예산 | 자체 필드 | 이식성 |
|---|---|---|---|---|
| Claude Code | ~/.claude/skills/(개인), .claude/skills/(프로젝트) |
컨텍스트의 1%(기본 0.01) | ··context: fork··· 등 다수 |
가장 낮음 |
| OpenAI Codex | .agents/skills → $HOME/.agents/skills → /etc/codex/skills → 번들 |
컨텍스트의 2%(불명 시 8,000자) | 표준 중심 | 높음 |
| Cursor | .agents/·.cursor/에 더해 .claude/·.codex/까지 읽음 |
문서 미표기 | ··· | 흡수형 |
| GitHub Copilot | .github/skills·.claude/skills·.agents/skills, ~/.copilot/skills |
문서 미표기 | 표준 중심 | 높음 |
| Gemini CLI | ~/.gemini/skills/·~/.agents/skills/, .gemini/skills/·.agents/skills/ |
문서 미표기 | 같은 계층에선 .agents/skills/ 우선 |
높음 |
우선순위 규칙도 다릅니다. Claude Code는 엔터프라이즈 > 개인 > 프로젝트 순으로 덮어쓰고, 자동 압축 시 최근 호출된 스킬 5개까지(합산 25,000토큰 한도) 보존합니다. 2026년 9월 4일 릴리즈된 v2.1.261에는 /skill-doctor가 추가돼 세션에서 한 번도 쓰이지 않은 스킬과 각각의 컨텍스트 비용을 확인할 수 있습니다.
발동률은 따로 관리해야 하는 지표입니다. arXiv 2604.04323은 스킬이 제공된 상태에서도 Claude 궤적의 49%만 필요한 스킬을 전부 로드했고, 비슷한 방해 스킬(distractor)을 섞으면 31%로 떨어졌다고 측정했습니다. 스킬을 많이 설치할수록 서로가 서로의 방해 스킬이 된다는 뜻입니다.
보안은 성능 권장과 정반대 방향을 가리킵니다. arXiv 2601.10338(2026-01-15)은 공개 마켓에서 수집한 42,447개 중 필터 후 31,132개를 분석해 26.1%가 취약점을 1건 이상(데이터 유출 13.3%, 권한 상승 11.8%, 고위험 악성 패턴 5.2%) 가졌다고 보고했습니다. 결정적으로 실행 스크립트를 번들한 스킬은 지시문만 있는 스킬보다 취약 확률이 2.12배(OR=2.12, p<0.001) 높았습니다. Snyk의 ToxicSkills 조사(2026-02-05)도 3,984개 스캔에서 13.4%(534개)가 critical 이슈를 가졌고, 사람 검토로 확정한 악성 페이로드 76건 중 8개가 게시 시점까지 공개 상태였다고 밝혔습니다.
한편 패키징 상위 규격인 Agent Plugins 1.0.0은 2026년 8월 6일 공개됐습니다. 제안 주체는 AWS·Anysphere·GitHub·Microsoft·OpenAI·Vercel이고 Anthropic은 창립 목록에 없습니다. 표준의 무게중심이 어디로 이동하는지 판단할 때 참고할 값입니다.
용어 풀이
1. 컨텍스트 윈도우 — 모델이 한 번에 읽을 수 있는 텍스트 총량. 스킬 목록 예산은 이 값의 비율로 계산합니다.
2. 방해 스킬(distractor) — 이름·설명이 비슷해 올바른 스킬 선택을 방해하는 다른 스킬.
3. 자동 압축(auto-compaction) — 대화가 길어지면 이전 내용을 요약해 컨텍스트를 확보하는 동작.
상황별 추천
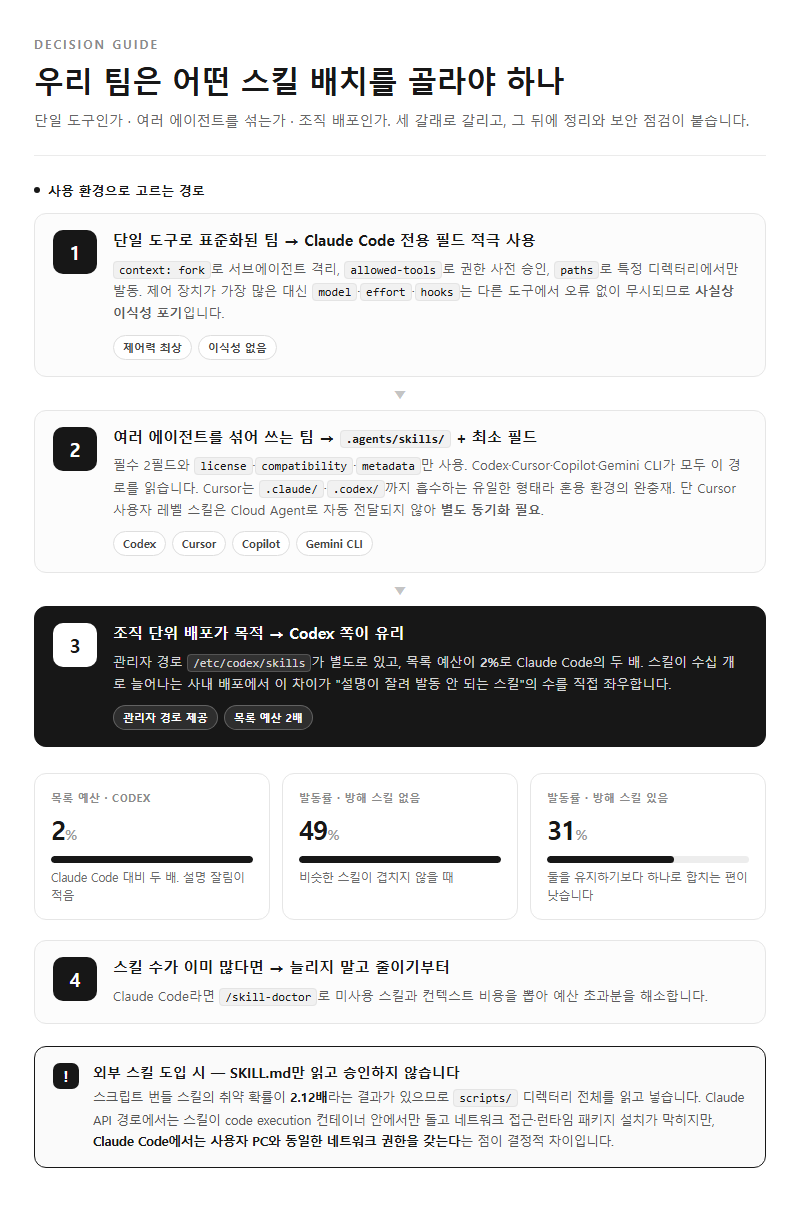
단일 도구로 표준화된 팀이라면 Claude Code 전용 필드를 적극적으로 씁니다. context: fork로 서브에이전트를 격리하고, 로 권한을 사전 승인하며, 로 특정 디렉터리에서만 발동하게 조건을 겁니다. 제어 장치가 가장 많은 대신 ·· 같은 필드는 다른 도구에서 오류 없이 무시되므로, 이 선택은 사실상 이식성을 포기하는 결정입니다.
여러 에이전트를 섞어 쓰는 팀이라면 .agents/skills/에 두고 필수 2필드와 ··만 씁니다. Codex·Cursor·Copilot·Gemini CLI가 모두 이 경로를 읽습니다. Cursor는 .claude/·.codex/까지 흡수하는 유일한 형태라 혼용 환경의 완충재 역할을 합니다. 다만 Cursor의 사용자 레벨 스킬은 Cloud Agent로 자동 전달되지 않아 별도 동기화가 필요합니다.
조직 단위 배포가 목적이라면 Codex 쪽이 유리합니다. 관리자 경로 /etc/codex/skills가 별도로 있고 목록 예산도 2%로 Claude Code의 두 배입니다. 스킬 수가 수십 개로 늘어나는 사내 배포에서는 이 예산 차이가 “설명이 잘려 발동 안 되는 스킬”의 수를 직접 좌우합니다.
스킬 수가 이미 많다면 늘리는 대신 줄이는 작업부터 합니다. Claude Code라면 /skill-doctor로 미사용 스킬과 컨텍스트 비용을 뽑아 예산 초과분을 해소합니다. 발동률이 방해 스킬 유무에 따라 49%에서 31%로 갈렸다는 측정치를 고려하면, 비슷한 스킬 두 개를 유지하기보다 하나로 합치는 편이 낫습니다.
외부 스킬을 도입할 때는 SKILL.md만 읽고 승인하지 않습니다. 스크립트 번들 스킬의 취약 확률이 2.12배라는 결과가 있으므로 scripts/ 디렉터리 전체를 읽고 넣습니다. Claude API 경로에서는 스킬이 code execution 컨테이너 안에서만 돌고 네트워크 접근·런타임 패키지 설치가 막히지만, Claude Code에서는 사용자 PC와 동일한 네트워크 권한을 갖는다는 점이 결정적 차이입니다.
자주 하는 실수
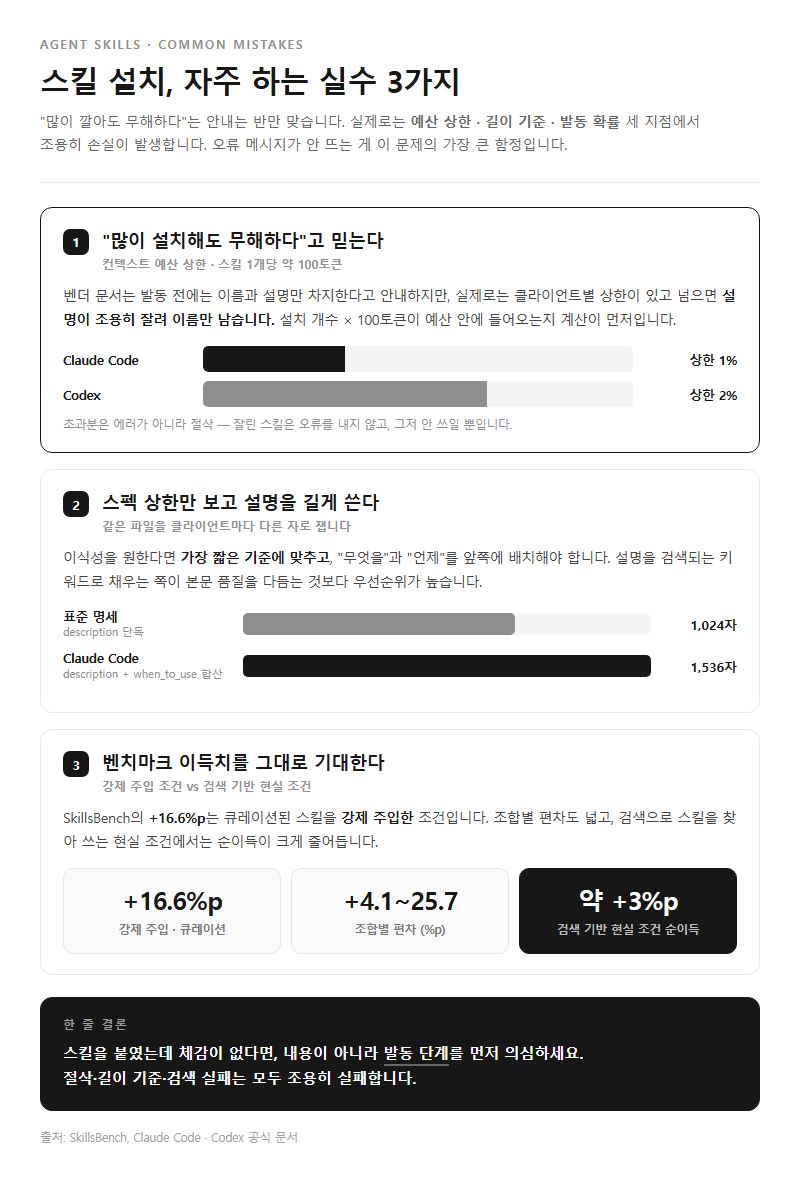
첫째, “많이 설치해도 무해하다”고 믿는 것입니다. 벤더 문서는 발동 전에는 이름과 설명만 차지하므로 컨텍스트 패널티 없이 많이 설치할 수 있다고 안내하지만, 실제로는 Claude Code 1%·Codex 2%라는 상한이 있고 넘으면 설명이 조용히 잘려 이름만 남습니다. 스킬 1개당 약 100토큰이라는 값에 설치 개수를 곱해 예산 안에 들어오는지 계산하는 게 먼저입니다. 잘린 스킬은 오류를 내지 않고, 그저 안 쓰일 뿐입니다.
둘째, 스펙 상한만 보고 설명을 길게 쓰는 것입니다. 표준 명세의 상한은 1,024자지만 Claude Code는 +when_to_use 합산 1,536자를 기준으로 잽니다. 같은 파일을 클라이언트마다 다른 자로 자른다는 뜻이므로, 이식성을 원한다면 가장 짧은 기준에 맞추고 “무엇을”과 “언제”를 앞쪽에 배치해야 합니다. 설명을 검색되는 키워드로 채우는 쪽이 본문 품질을 다듬는 것보다 우선순위가 높습니다.
셋째, 벤치마크 이득치를 그대로 기대하는 것입니다. SkillsBench의 +16.6%p는 큐레이션된 스킬을 강제 주입한 조건이고, 조합별 편차도 +4.1~+25.7%p로 넓습니다. 현실적인 검색 기반 조건에서는 순이득이 약 3%p로 줄었습니다. 스킬을 붙였는데 체감이 없다면 내용이 아니라 발동 단계를 먼저 의심해야 합니다.
정리
스킬 설계의 판단 기준은 네 가지로 압축됩니다. 분량은 모듈 3개 이하·본문 500줄 이하로 좁게 잡고, 목록 예산(Claude Code 1%·Codex 2%)을 스킬 1개당 약 100토큰으로 곱해 미리 계산합니다. 이식성이 필요하면 .agents/skills/에 표준 필드만, 제어가 필요하면 Claude Code 전용 필드까지 쓰되 둘을 동시에 얻을 수는 없습니다.
효과는 검증됐지만 조건부입니다. 강제 주입 시 +16.6%p였던 이득이 현실 조건에서 약 3%p로 줄었고, 필요한 스킬이 전부 로드된 궤적은 49%(방해 스킬 존재 시 31%)에 그쳤습니다. 외부 스킬은 26.1%가 취약점을 가졌고 스크립트 번들은 위험이 2.12배입니다.
한 줄로 정리하면, 좁게 쓰고, 예산 안에 넣고, 을 성능처럼 튜닝하고, 남의 스크립트는 읽고 넣으면 됩니다.
참고 자료
조사 기준일: 2026년 09월 06일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (WebFetch로 원문 확인, 확인일 2026-09-06)
– Anthropic Engineering, Equipping agents for the real world with Agent Skills — https://www.anthropic.com/engineering/equipping-agents-for-the-real-world-with-agent-skills
– Claude Platform Docs, Agent Skills 개요 — https://platform.claude.com/docs/en/agents-and-tools/agent-skills/overview
– Claude Platform Docs, Skill authoring best practices — https://platform.claude.com/docs/en/agents-and-tools/agent-skills/best-practices
– Agent Skills 표준 홈 — https://agentskills.io/
– Agent Skills 명세 — https://agentskills.io/specification
– Claude Code Docs, Extend Claude with skills — https://code.claude.com/docs/en/skills
– anthropics/claude-code CHANGELOG — https://raw.githubusercontent.com/anthropics/claude-code/main/CHANGELOG.md
– OpenAI, Build skills (Codex) — https://learn.chatgpt.com/docs/build-skills (원 URL https://developers.openai.com/codex/skills 에서 308 리다이렉트)
– Cursor Docs, Skills — https://cursor.com/docs/context/skills
– GitHub Docs, About agent skills (Copilot) — https://docs.github.com/en/copilot/concepts/agents/about-agent-skills
– Gemini CLI Docs, Skills — https://geminicli.com/docs/cli/skills/
– Agent Plugins Specification 1.0.0 — https://agent-plugins.org/specification
– Vercel, Introducing Agent Plugins (2026-08-06) — https://vercel.com/blog/introducing-agent-plugins
– arXiv 2602.12670, SkillsBench (v1 2026-02-13 / v4 2026-06-14) — https://arxiv.org/abs/2602.12670
– arXiv 2604.04323, How Well Do Agentic Skills Work in the Wild (2026-04-06) — https://arxiv.org/html/2604.04323v1
– arXiv 2601.10338, Agent Skills in the Wild (2026-01-15) — https://arxiv.org/html/2601.10338v1
Tier 2 (확인일 2026-09-06)
– Snyk, ToxicSkills: 36% of AI agent skills contain security flaws (2026-02-05) — https://snyk.io/blog/toxicskills-malicious-ai-agent-skills-clawhub/
– llm-stats.com, Terminal-Bench 2.0 리더보드 (페이지 표기 최종 갱신 2026-09-06) — https://llm-stats.com/benchmarks/terminal-bench-2
– The New Stack, Anthropic defined the standards inside Agent Plugins… — https://thenewstack.io/agent-plugins-portability-gaps/
– The New Stack, Agent Skills: Anthropic’s Next Bid to Define AI Standards — https://thenewstack.io/agent-skills-anthropics-next-bid-to-define-ai-standards/
답글 남기기