
AI 에이전트 신뢰성은 평균 성공률보다 pass^k로 판단하는 편이 정확합니다. 평균 77.4%인 에이전트도 5회 모두 성공한 과제는 53.0%였습니다. Princeton·IBM 측정을 바탕으로 반복 실행 평가를 설계하는 방법을 정리합니다.
AI에이전트신뢰성 개요
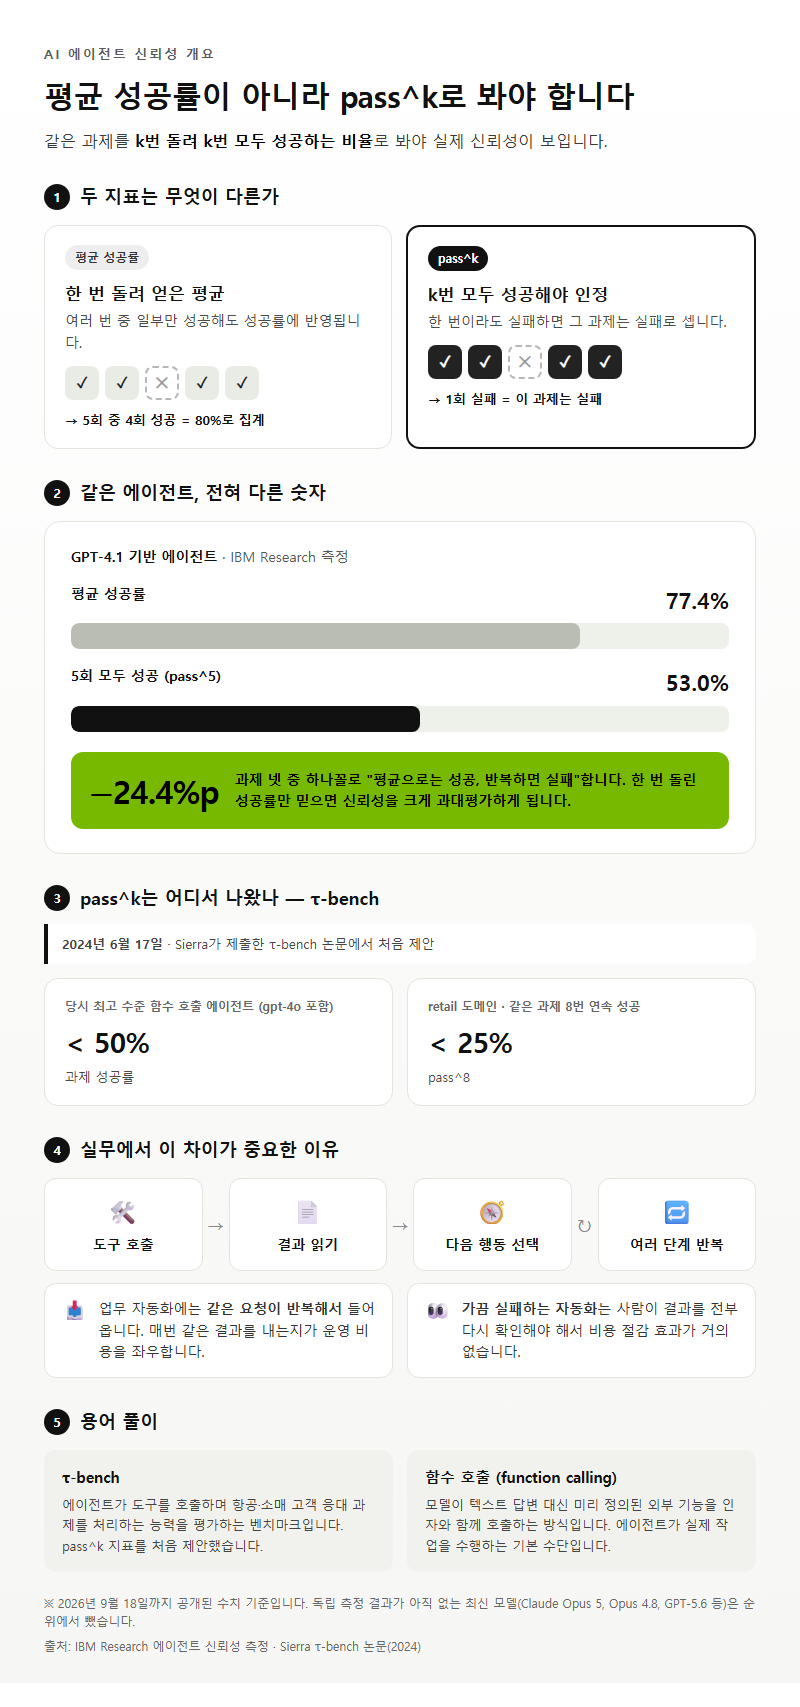
AI 에이전트 신뢰성은 한 번 돌려 얻은 평균 성공률로 판단하면 안 됩니다. 같은 과제를 k번 돌려 k번 모두 성공하는 비율(pass^k)로 봐야 합니다. 에이전트 신뢰성 평가에서 두 값의 차이는 작지 않습니다. IBM Research 측정에서 GPT-4.1 기반 에이전트는 평균 성공률이 77.4%였는데, 5회 모두 성공한 과제는 53.0%에 그쳤습니다. 이 글은 2026년 9월 18일까지 공개된 논문과 독립 대시보드 수치를 근거로, 반복 실행 성공률을 읽는 법과 평가 설계 방법을 정리했습니다. 독립 측정이 아직 없는 최신 모델(Claude Opus 5, Opus 4.8, GPT-5.6 등)은 순위를 매기지 않았습니다.
pass^k 지표는 2024년 6월 17일 Sierra가 제출한 τ-bench 논문에서 처음 나왔습니다. 원논문 초록을 보면 gpt-4o를 포함한 당시 최고 수준의 함수 호출 에이전트도 과제 성공률이 50% 미만이었습니다. retail 도메인에서 같은 과제를 8번 연속 성공하는 비율(pass^8)은 25% 미만까지 내려갔습니다. 한 번 성공한 에이전트가 다음 실행에서도 성공한다는 보장이 없다는 사실이 이때 처음 수치로 드러났습니다.
이 차이가 실무에서 중요한 까닭은 에이전트의 작동 방식에 있습니다. 에이전트는 챗봇처럼 한 번 답하고 끝나지 않습니다. 도구를 호출하고, 결과를 읽고, 다음 행동을 고르는 과정을 여러 단계 거칩니다. 업무 자동화에 투입하면 같은 요청이 반복해서 들어오므로 매번 같은 결과를 내는지가 운영 비용을 좌우합니다. 가끔 실패하는 자동화는 사람이 결과를 전부 다시 확인해야 해서, 자동화하지 않은 것과 비용 차이가 크지 않습니다.
용어 풀이
1. τ-bench — 에이전트가 도구를 호출하며 항공·소매 고객 응대 과제를 처리하는 능력을 평가하는 벤치마크로, pass^k 지표를 처음 제안했습니다.
2. 함수 호출(function calling) — 모델이 텍스트 답변 대신 미리 정의된 외부 기능을 인자와 함께 호출하는 방식으로, 에이전트가 실제 작업을 수행하는 기본 수단입니다.
1. 평균 성공률과 pass^k가 다르게 나오는 이유
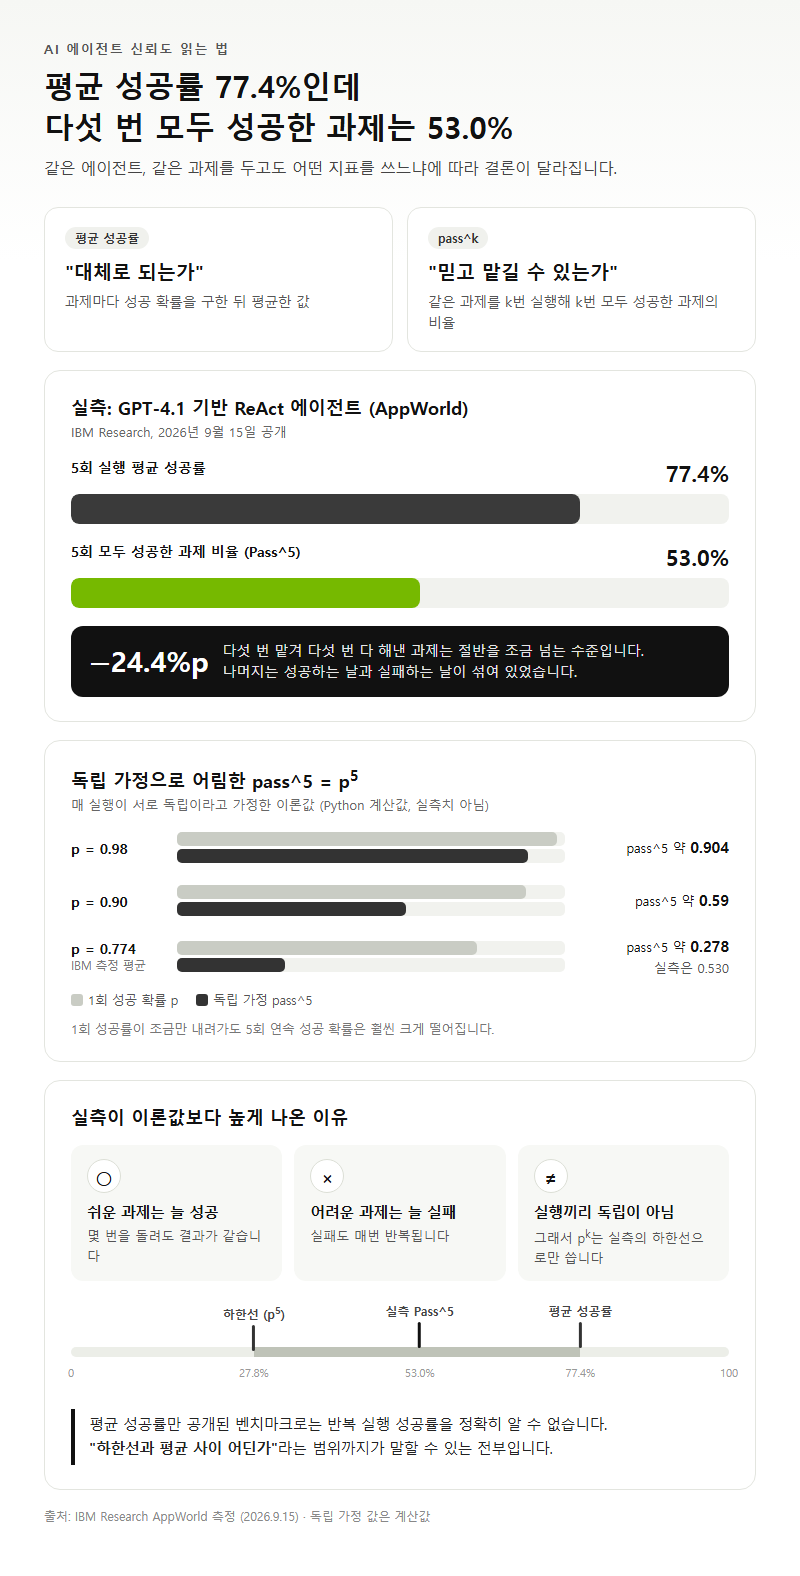
평균 성공률은 과제마다 성공 확률을 구해 평균한 값입니다. pass^k는 같은 과제를 k번 실행해 k번 모두 성공한 과제의 비율입니다. 평균이 “대체로 되는가”를 보여 준다면, pass^k는 “믿고 맡길 수 있는가”를 보여 줍니다. 2026년 9월 15일 IBM Research가 공개한 AppWorld 측정에서 두 값의 차이가 분명히 드러납니다.
| 지표 (GPT-4.1 기반 ReAct 에이전트, AppWorld) | 값 |
|---|---|
| 5회 실행 평균 성공률 | 77.4% |
| 5회 모두 성공한 과제 비율(Pass^5) | 53.0% |
| 두 값의 차이 | 24.4%p |
평균 77.4%만 보면 대부분 처리하는 에이전트로 보입니다. 그런데 다섯 번 맡겨서 다섯 번 다 해낸 과제는 절반을 조금 넘는 수준입니다. 나머지 과제는 성공하는 날과 실패하는 날이 섞여 있었다는 뜻입니다.
pass^k를 이론값으로 어림할 수도 있습니다. 매 실행이 서로 독립이라고 가정하면 pass^k는 성공 확률 p를 k번 곱한 값(p^k)입니다. 아래 표의 독립 가정 값은 Python으로 계산한 것이며 실측치가 아닙니다.
| 1회 성공 확률 p | 독립 가정 pass^5 | 비고 |
|---|---|---|
| 0.98 | 약 0.904 | 계산값 |
| 0.90 | 약 0.59 | 계산값 |
| 0.774 | 약 0.278 | IBM 실측 Pass^5는 0.530 |
실측값이 곱셈 값보다 높게 나온 데는 이유가 있습니다. 실제 과제는 쉬운 것은 늘 성공하고 어려운 것은 늘 실패하는 경향이 있어서, 실행 결과가 서로 독립적이지 않습니다. 그래서 p^k는 실측 pass^k의 하한선으로만 써야 합니다. 뒤집어 말하면, 평균 성공률만 공개된 벤치마크 점수로는 반복 실행 성공률을 정확히 알 수 없습니다. 하한선과 평균 사이 어딘가라는 범위까지가 말할 수 있는 전부입니다.
2. Princeton 연구로 본 모델별 반복 실행 일관성
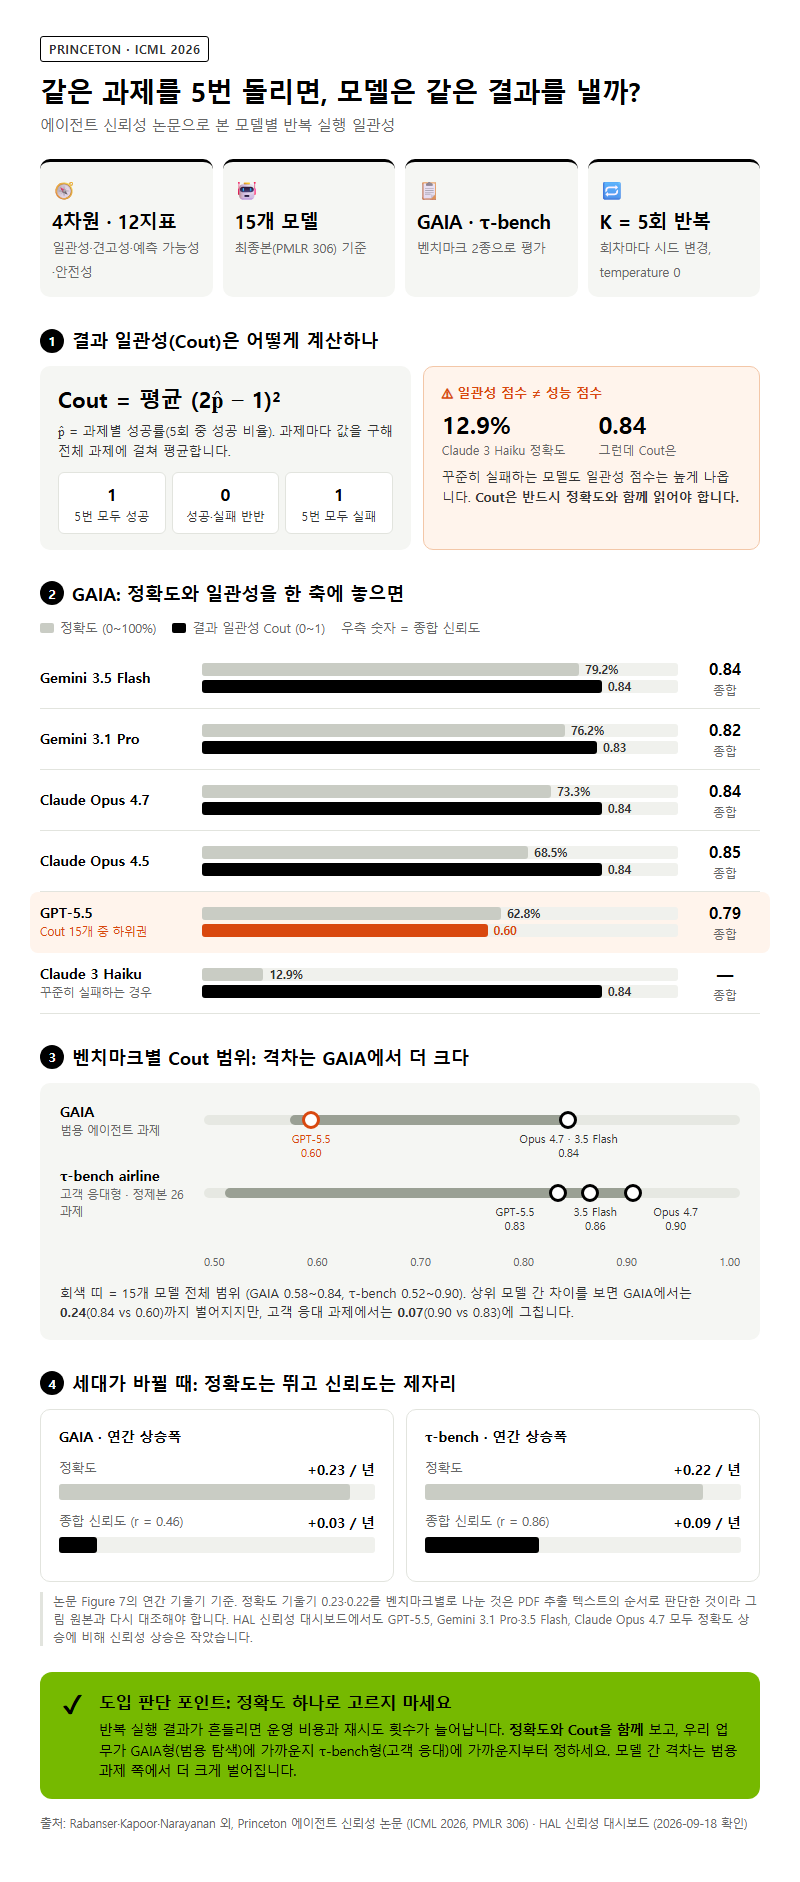
반복 실행 신뢰성을 가장 체계적으로 측정한 자료는 Princeton의 Rabanser·Kapoor·Narayanan 등 6인이 쓴 논문입니다. 연구진은 신뢰성을 일관성·견고성·예측 가능성·안전성의 4개 차원, 12개 지표로 나눴습니다. ICML 2026(PMLR 306)에 실린 최종본은 15개 모델을 GAIA와 τ-bench 두 벤치마크로 평가했습니다. 과제마다 K=5회 반복 실행했고, 회차마다 랜덤 시드를 바꾸고 temperature는 0으로 고정했습니다.
핵심 지표인 결과 일관성(Cout)은 과제별 성공률 p̂에 대해 (2p̂−1)²를 구한 뒤 모든 과제에 걸쳐 평균한 값입니다. 매번 성공하거나 매번 실패하면 1이고, 성공과 실패가 반반이면 0입니다. 주의할 점은 일관성이 성능 점수가 아니라는 것입니다. Claude 3 Haiku는 GAIA 정확도가 12.9%인데도 Cout은 0.84로 나옵니다. 꾸준히 실패하는 모델도 일관성 점수는 높게 받습니다. 그러니 Cout은 정확도와 함께 읽어야 합니다.
| 모델 (GAIA, HAL 2026-09-18 확인) | 정확도 | 종합 신뢰도 | 결과 일관성(Cout) |
|---|---|---|---|
| Gemini 3.5 Flash | 79.2% | 0.84 | 0.84 |
| Gemini 3.1 Pro | 76.2% | 0.82 | 0.83 |
| Claude Opus 4.7 | 73.3% | 0.84 | 0.84 |
| Claude Opus 4.5 | 68.5% | 0.85 | 0.84 |
| GPT-5.5 | 62.8% | 0.79 | 0.60 |
| Claude 3 Haiku | 12.9% | — | 0.84 |
GAIA에서 GPT-5.5의 Cout 0.60은 15개 모델 가운데 하위권입니다. 최종본 기준 GAIA의 Cout 범위는 0.58~0.84입니다. 고객 응대형인 τ-bench airline 정제본(26과제)에서는 Opus 4.7이 0.90, Gemini 3.5 Flash가 0.86, GPT-5.5가 0.83이었고, 범위는 0.52~0.90입니다. 모델 간 격차는 GAIA에서 더 크고, 고객 응대 과제에서는 상대적으로 작습니다.
더 눈여겨봐야 할 것은 모델 세대가 바뀔 때의 추세입니다. 논문 Figure 7의 연간 기울기를 보면 정확도는 연 0.23(GAIA)·0.22(τ-bench) 올랐습니다. 반면 종합 신뢰도는 연 0.03(GAIA, r=0.46)·0.09(τ-bench, r=0.86) 오르는 데 그쳤습니다. 이 가운데 정확도 기울기 0.23과 0.22가 각각 어느 벤치마크 패널에 해당하는지는 PDF 추출 텍스트의 배열 순서로 판단한 것이라, 그림 원본과 다시 대조할 필요가 있습니다. HAL 신뢰성 대시보드도 같은 흐름입니다. GPT-5.5, Gemini 3.1 Pro·3.5 Flash, Claude Opus 4.7 모두 정확도는 뚜렷이 올랐지만 신뢰성은 그만큼 오르지 않았고, GAIA에서 GPT-5.5와 Opus 4.7은 이전 모델보다 신뢰성이 나아지지 않았다고 정리돼 있습니다.
용어 풀이
1. GAIA — 웹 탐색·파일 처리·다단계 추론이 섞인 범용 과제로 에이전트를 평가하는 벤치마크입니다.
2. temperature — 모델이 다음 토큰을 고를 때 무작위성을 조절하는 설정값으로, 0에 가까울수록 확률이 가장 높은 선택을 따르게 합니다.
3. 발표된 벤치마크 점수를 반복 실행 기준으로 다시 읽는 법
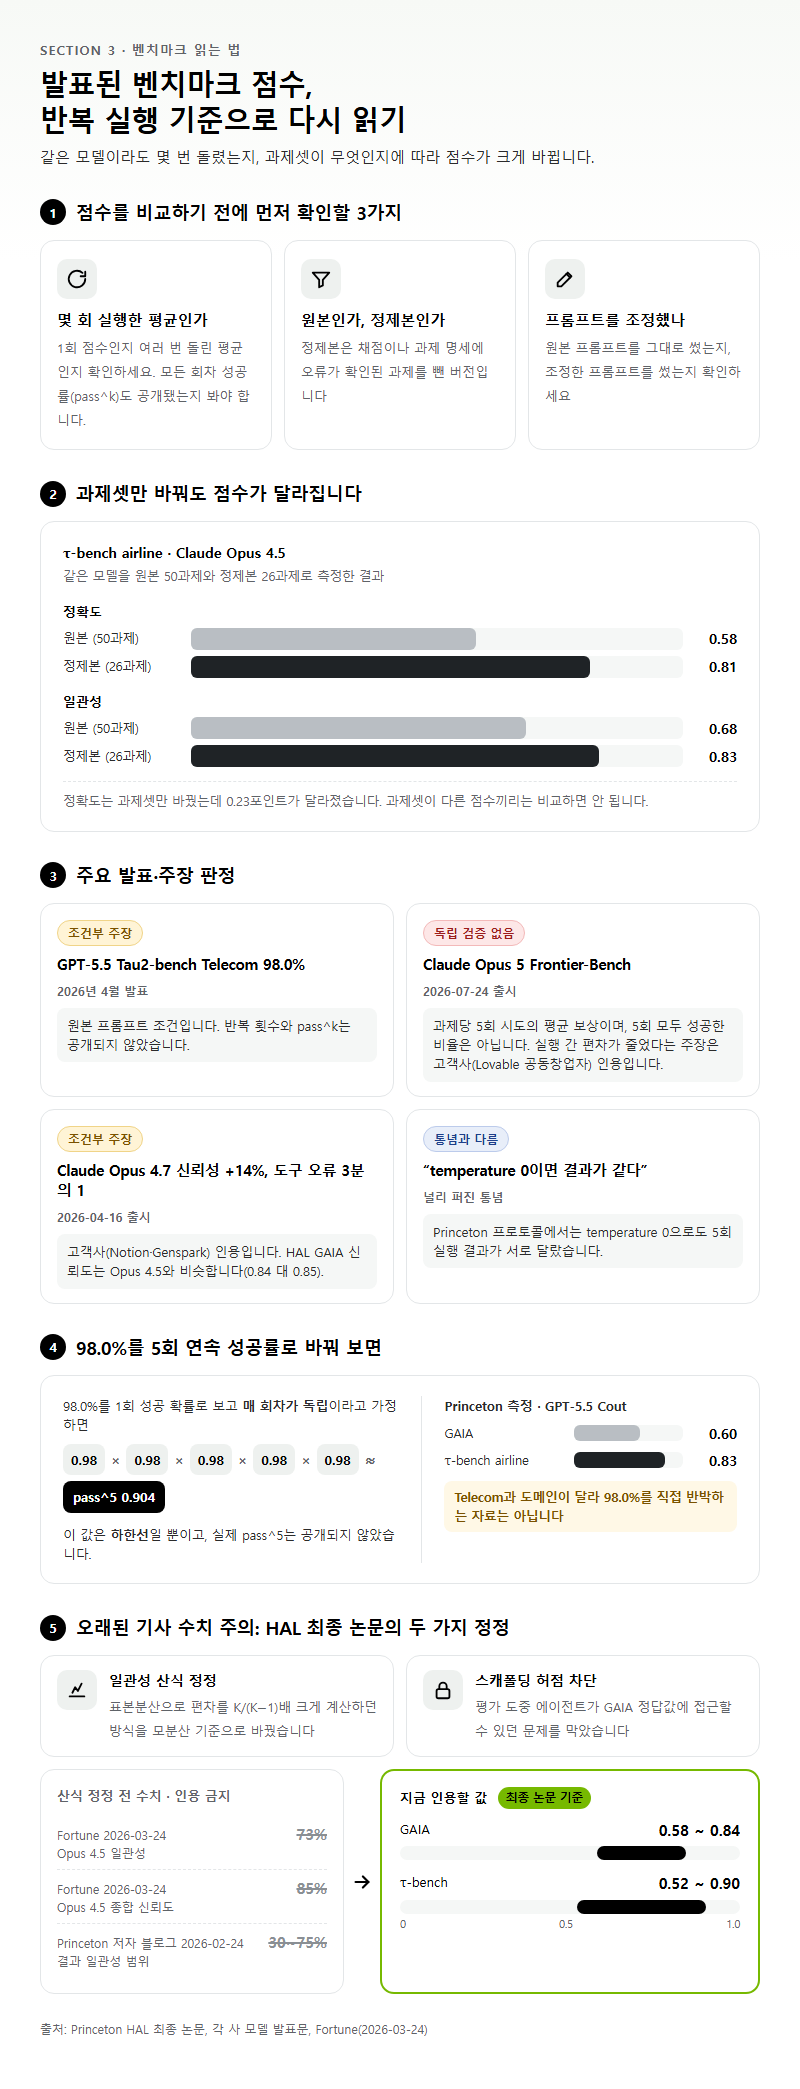
모델 발표문의 점수를 비교하기 전에 세 가지를 먼저 확인해야 합니다. 몇 회 실행한 평균인지, 원본 과제셋인지 정제 과제셋인지, 프롬프트를 조정했는지입니다. 과제셋만 바꿔도 점수가 크게 달라집니다. τ-bench airline에서 Opus 4.5의 정확도는 원본 50과제 기준 0.58, 정제본 26과제 기준 0.81이었습니다. 일관성도 0.68과 0.83으로 갈렸습니다. 정제본은 채점이나 과제 명세에 오류가 확인된 과제를 뺀 버전입니다.
| 발표·주장 | 확인된 측정 조건 | 판정 |
|---|---|---|
| GPT-5.5 Tau2-bench Telecom 98.0%(2026년 4월 발표) | 원본 프롬프트 조건. 반복 횟수와 pass^k는 비공개 | 조건부 주장 |
| Claude Opus 5 Frontier-Bench(2026-07-24 출시) | 과제당 5회 시도의 평균 보상이며 5회 모두 성공한 비율이 아님. 실행 간 편차 감소는 고객사(Lovable 공동창업자) 인용 | 독립 검증 없음 |
| Claude Opus 4.7 신뢰성 개선 +14%, 도구 오류 3분의 1(2026-04-16 출시) | 고객사(Notion·Genspark) 인용. HAL GAIA 신뢰도는 Opus 4.5와 비슷(0.84 대 0.85) | 조건부 주장 |
| temperature 0이면 결과가 같다는 통념 | Princeton 프로토콜에서 temperature 0으로도 5회 결과가 갈림 | 통념과 다름 |
GPT-5.5의 98.0%를 예로 들어 보겠습니다. 이 값을 1회 성공 확률로 보더라도 독립 가정 pass^5는 약 0.904입니다. 이것은 하한선일 뿐이고, 실제 pass^5는 공개되지 않았습니다. Princeton 측정에서 GPT-5.5의 Cout은 GAIA 0.60, τ-bench airline 0.83이었습니다. 다만 Telecom과는 도메인이 달라 직접 반박하는 자료는 아닙니다.
오래된 기사 수치도 조심해야 합니다. HAL은 최종 논문에서 두 가지를 고쳤습니다. 첫째, 결과 일관성 산식이 표본분산을 써서 편차를 K/(K−1)배 크게 계산하던 문제를 모분산 기준으로 바꿨습니다. 둘째, 평가 도중 에이전트가 GAIA 정답값에 접근할 수 있었던 스캐폴딩 허점을 막았습니다. 2026년 3월 24일 Fortune이 보도한 Opus 4.5 일관성 73%와 종합 신뢰도 85%, 2026년 2월 24일 Princeton 저자 블로그의 결과 일관성 30~75% 범위는 모두 산식 정정 전 수치입니다. 지금 인용할 값은 최종본 기준인 GAIA 0.58~0.84, τ-bench 0.52~0.90입니다.
4. 반복 실행 결과가 흔들리는 원인과 줄이는 방법
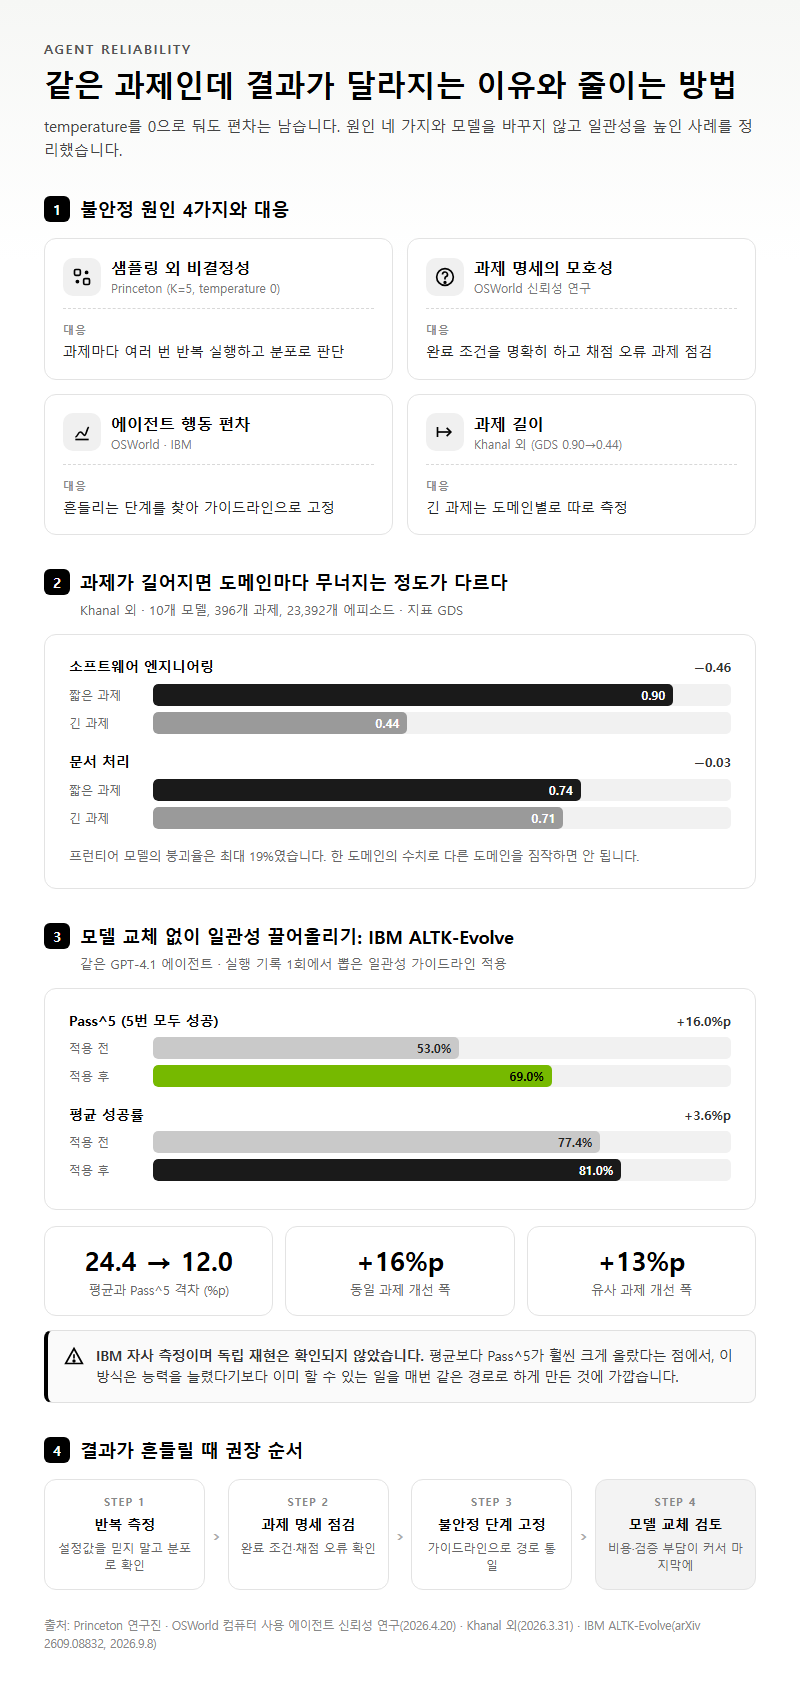
첫 번째 원인은 설정으로 없앨 수 없는 비결정성입니다. Princeton 연구진은 temperature를 0으로 둬도 부동소수점 연산 순서, 서버 부하에 따른 배치 크기 변화 같은 샘플링 외 요인 때문에 편차가 생긴다고 명시했습니다. API로 모델을 호출하는 한 사용자가 통제할 수 없는 부분입니다. 재현성은 설정값으로 보장되지 않으니 반복 측정으로 확인해야 합니다.
2026년 4월 20일 공개된 컴퓨터 사용 에이전트(OSWorld) 연구는 반복 실행이 불안정해지는 원인을 세 가지로 꼽았습니다. 실행 중의 확률성, 과제 명세의 모호성, 에이전트 행동의 편차입니다. 과제 길이도 변수입니다. Khanal 외 연구(2026년 3월 31일)는 10개 모델로 396개 과제, 23,392개 에피소드를 평가했습니다. 연구진의 지표 GDS는 소프트웨어 엔지니어링 도메인에서 과제가 길어질수록 0.90에서 0.44로 떨어졌습니다. 문서 처리 도메인은 0.74에서 0.71로 거의 변하지 않았고, 프런티어 모델의 붕괴율은 최대 19%였습니다.
| 불안정 원인 | 근거 자료 | 평가·설계 단계의 대응 |
|---|---|---|
| 샘플링 외 비결정성 | Princeton(K=5, temperature 0) | 과제당 여러 번 반복 실행하고 분포로 판단 |
| 과제 명세의 모호성 | OSWorld 신뢰성 연구 | 완료 조건을 명확히 하고 채점 오류 과제를 점검 |
| 에이전트 행동 편차 | OSWorld, IBM | 흔들리는 단계를 찾아 가이드라인으로 고정 |
| 과제 길이 | Khanal 외(GDS 0.90→0.44) | 긴 과제는 도메인별로 따로 측정 |
모델을 바꾸지 않고 일관성을 높인 사례도 있습니다. IBM의 ALTK-Evolve 방식은 한 번의 실행 기록에서 일관성 가이드라인을 뽑아 에이전트에 적용합니다. 같은 GPT-4.1 에이전트에서 Pass^5는 53.0%에서 69.0%로, 평균 성공률은 77.4%에서 81.0%로 올랐습니다. 평균과 Pass^5의 차이는 24.4%p에서 12.0%p로 줄었습니다. 2026년 9월 8일 제출된 논문(arXiv 2609.08832)에 따르면 개선 폭은 동일 과제에서 +16%p, 유사 과제에서 +13%p입니다.
다만 이 결과는 IBM의 자사 측정이며 독립 재현은 확인되지 않았습니다. 그래도 평균보다 Pass^5가 훨씬 크게 올랐다는 점에서, 이 방식은 모델의 능력을 늘렸다기보다 이미 할 수 있는 일을 매번 같은 경로로 하게 만든 것으로 읽힙니다. 모델 교체는 비용과 검증 부담이 크니, 그 전에 불안정한 단계를 고정하는 방식부터 시험해 보는 편이 낫습니다.
5. 에이전트 도입 전 반복 실행 평가 체크리스트와 FAQ
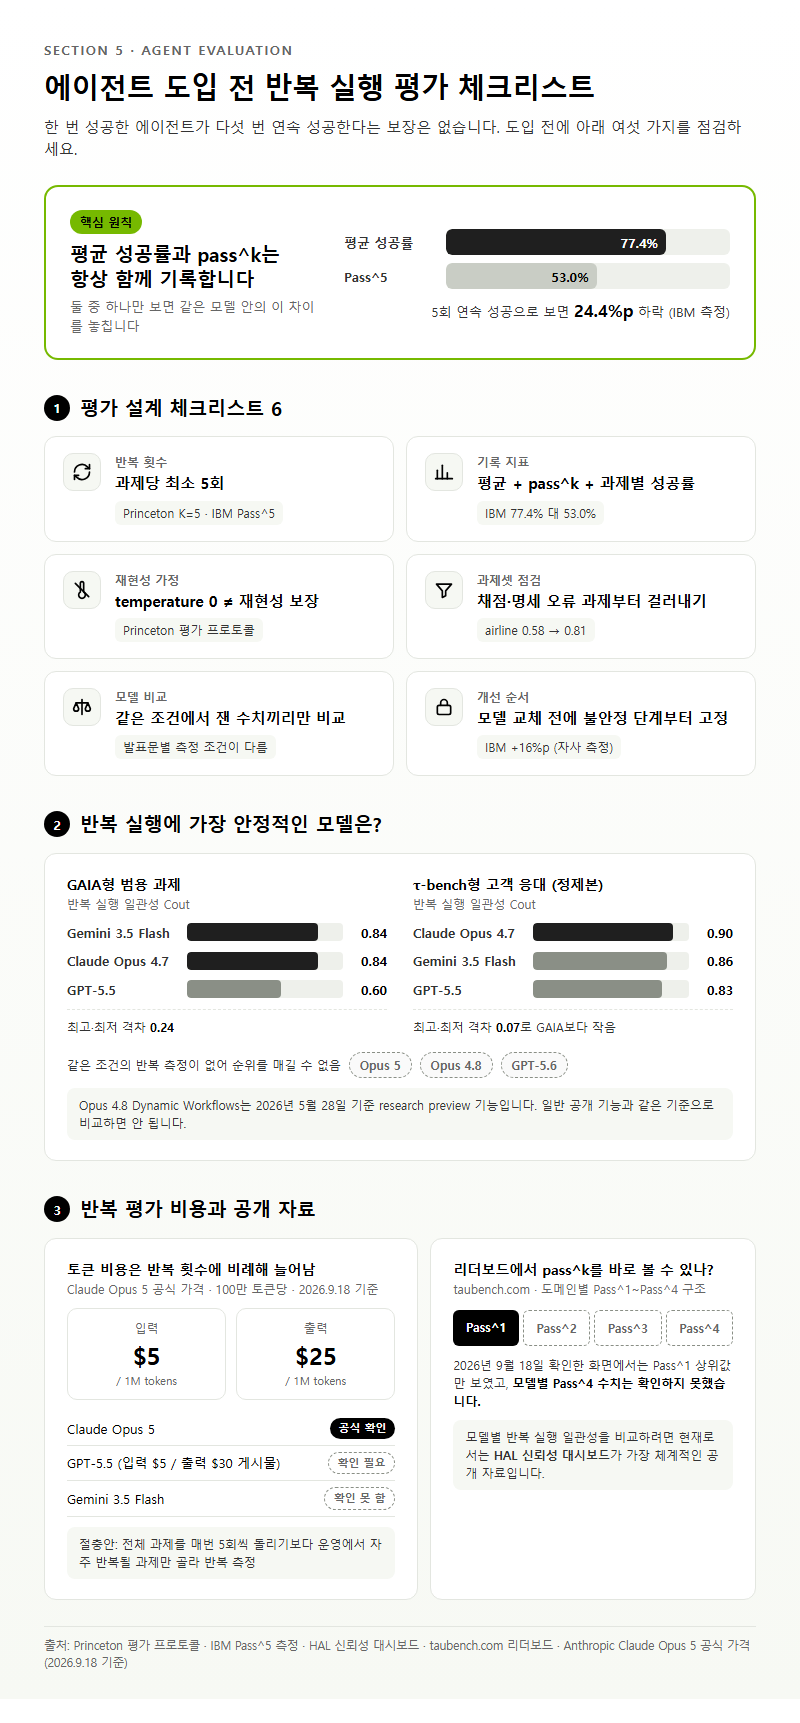
앞의 측정 자료를 평가 설계 항목으로 옮기면 다음과 같습니다. 핵심은 평균과 pass^k를 항상 함께 기록하는 것입니다. 둘 중 하나만 있으면 앞에서 본 24.4%p 같은 차이를 놓칩니다.
| 항목 | 권장 설계 | 근거 |
|---|---|---|
| 반복 횟수 | 과제당 최소 5회 | Princeton K=5, IBM Pass^5 |
| 기록 지표 | 평균 성공률 + pass^k + 과제별 성공률 | IBM 77.4% 대 53.0% |
| 재현성 가정 | temperature 0을 재현성 보장으로 보지 않음 | Princeton 평가 프로토콜 |
| 과제셋 점검 | 채점·명세 오류 과제를 먼저 걸러냄 | airline 0.58 대 0.81 |
| 모델 비교 | 같은 조건에서 측정한 수치끼리만 비교 | 발표문별 측정 조건이 다름 |
| 개선 순서 | 모델 교체 전 불안정 단계 고정을 먼저 시험 | IBM +16%p(자사 측정) |
반복 실행이 가장 안정적인 모델은 무엇인가요?
과제 유형에 따라 다릅니다. GAIA형 범용 과제에서는 Gemini 3.5 Flash와 Claude Opus 4.7이 Cout 0.84로 같고, GPT-5.5는 0.60입니다. τ-bench형 고객 응대(정제본)에서는 Opus 4.7이 0.90, Gemini 3.5 Flash가 0.86, GPT-5.5가 0.83으로 격차가 GAIA보다 작습니다. Opus 5, Opus 4.8, GPT-5.6은 같은 조건의 반복 실행 측정이 없어 순위를 매길 수 없습니다. Opus 4.8의 Dynamic Workflows는 2026년 5월 28일 기준 research preview 기능이라 일반 공개 기능과 같은 기준으로 보면 안 됩니다.
반복 평가를 하면 비용은 얼마나 드나요?
토큰 비용은 반복 횟수만큼 늘어납니다. 2026년 9월 18일 기준 Claude Opus 5의 공식 가격은 입력 100만 토큰당 $5, 출력 $25입니다. GPT-5.5는 입력 $5, 출력 $30이라는 게시물이 있지만 OpenAI 공식 자료로 확인하지 못했습니다(확인 필요). Gemini 3.5 Flash 가격도 공식 자료로 확인하지 못했습니다. 전체 과제를 매번 5회씩 돌리기 부담스럽다면 운영에서 자주 반복될 과제만 골라 반복 측정하는 것이 현실적인 절충입니다.
공개 리더보드에서 pass^k를 바로 확인할 수 있나요?
taubench.com 리더보드는 도메인별로 Pass^1부터 Pass^4까지 보여 주는 구조라고 안내합니다. 하지만 2026년 9월 18일 확인한 화면에서는 Pass^1 상위값만 보였고, 모델별 Pass^4 수치는 확인하지 못했습니다. 반복 실행 일관성을 모델별로 비교하려면 현재로서는 HAL 신뢰성 대시보드가 가장 체계적인 공개 자료입니다.
정리
AI 에이전트의 반복 실행 성공률은 대개 평균 성공률보다 낮게 나옵니다. 평균 77.4%인 에이전트도 5회 모두 성공한 과제는 53.0%였습니다. Princeton 최종본 기준으로 모델의 정확도는 연 0.22~0.23씩 올랐지만 신뢰도는 연 0.03~0.09 상승에 그쳤습니다. 새 모델의 점수만 보고 자동화를 맡기기보다, 과제당 최소 5회 실행으로 pass^k를 직접 측정하고 흔들리는 단계를 고정하는 편이 안전합니다.
참고 자료
조사 기준일: 2026년 09월 18일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
Tier 1 (확인일 2026-09-18)
– τ-bench 논문: https://arxiv.org/abs/2406.12045
– Towards a Science of AI Agent Reliability: https://arxiv.org/abs/2602.16666 (최종본 PDF https://arxiv.org/pdf/2602.16666 , v2 HTML https://arxiv.org/html/2602.16666v2)
– Princeton 저자 블로그: https://www.normaltech.ai/p/new-paper-towards-a-science-of-ai
– IBM Research 블로그: https://huggingface.co/blog/ibm-research/altk-evolve-consistency
– IBM 논문: https://arxiv.org/abs/2609.08832
– Beyond pass@1: https://arxiv.org/abs/2603.29231
– On the Reliability of Computer Use Agents: https://arxiv.org/abs/2604.17849
– Claude Opus 4.7: https://www.anthropic.com/news/claude-opus-4-7
– Claude Opus 4.8: https://www.anthropic.com/news/claude-opus-4-8
– Claude Opus 5: https://www.anthropic.com/news/claude-opus-5
– Introducing GPT-5.5: https://openai.com/index/introducing-gpt-5-5/ (직접 접속 403, 프록시로 원문 대조)
Tier 2 (확인일 2026-09-18)
– HAL 신뢰성 대시보드: https://hal.cs.princeton.edu/reliability/
– HAL GAIA: https://hal.cs.princeton.edu/reliability/benchmark/gaia/ , 일관성: https://hal.cs.princeton.edu/reliability/benchmark/gaia/dimension/consistency/
– HAL τ-bench 비교: https://hal.cs.princeton.edu/reliability/compare/taubench/
– Fortune(Yahoo Tech 재게재): https://tech.yahoo.com/ai/articles/ai-agents-getting-more-capable-201847286.html
– τ-bench 리더보드: https://taubench.com , README: https://github.com/sierra-research/tau2-bench/blob/main/README.md
– TechCrunch(Opus 4.8): https://techcrunch.com/2026/05/28/anthropic-releases-opus-4-8-with-new-dynamic-workflow-tool/
답글 남기기