
Tether가 2026년 11월 공개한 0.8B 온디바이스 에이전트 모델 BotPsy를 Qwen3.5-2B·LFM2.5·FunctionGemma와 비교했습니다. 측정 조건 차이, Q4_K_M 점수 하락, 기기 실측 공백까지 도입 전 기준을 짚습니다.
이 글에는 네이버 브랜드커넥트 제휴 링크가 포함되어 있습니다. 링크를 통해 구매가 이루어지면 작성자가 일정액의 수수료를 지급받습니다. 제품 선택과 구매는 독자의 판단이며, 이 글은 특정 제품의 효과를 보증하지 않습니다.
AI 에이전트, 무엇을 기준으로 비교해야 할까
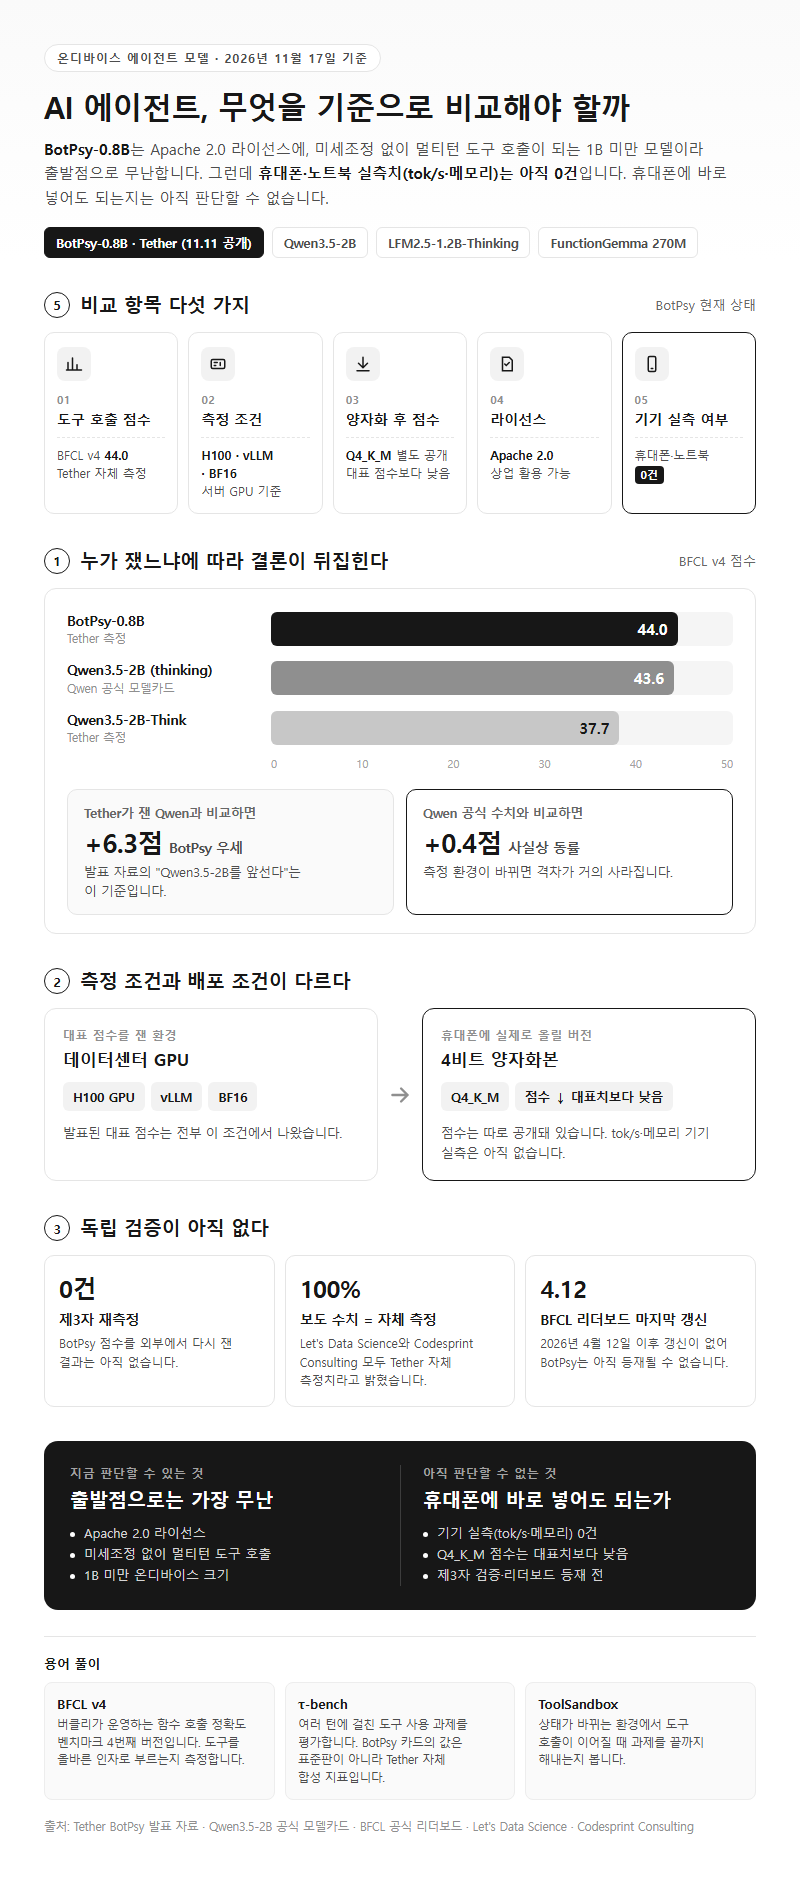
BotPsy-0.8B는 Apache 2.0 라이선스에, 미세조정 없이 멀티턴 도구 호출이 되는 1B 미만 온디바이스 에이전트 모델입니다. 출발점으로는 가장 무난합니다. 그렇다고 이 온디바이스 에이전트 모델을 휴대폰에 바로 넣어도 되는지는 아직 판단할 수 없습니다. 2026년 11월 17일 기준으로 휴대폰·노트북 실측치(tok/s·메모리)가 0건이라서입니다. 이 글에서는 Tether가 2026년 11월 11일 공개한 BotPsy를 Qwen3.5-2B, LFM2.5-1.2B-Thinking, FunctionGemma 270M과 나란히 놓고 다섯 항목으로 비교합니다. 도구 호출 점수, 측정 조건, 양자화 후 점수, 라이선스, 기기 실측 여부입니다. 일반 사용자용 앱 사용법은 다루지 않습니다.
비교 기준을 따로 세워야 하는 이유는 단순합니다. 발표 자료의 대표 문구는 BotPsy가 BFCL v4에서 Qwen3.5-2B를 앞선다는 것입니다. 그런데 이 결론은 누구의 측정 환경으로 쟀느냐에 따라 뒤집힙니다. Tether가 직접 잰 Qwen3.5-2B-Think는 37.7점, BotPsy는 44.0점입니다. 반면 Qwen 공식 모델카드에는 Qwen3.5-2B의 BFCL-V4(thinking)가 43.6점으로 적혀 있습니다. 이 숫자와 비교하면 차이는 0.4점, 사실상 동률입니다.
두 번째는 배포 형태입니다. 대표 점수는 전부 H100 GPU에서 vLLM으로 돌린 BF16 기준입니다. 휴대폰에 실제로 올릴 버전은 4비트 양자화본(Q4_K_M)인데, 이 버전의 점수는 따로 공개돼 있고 대표 점수보다 낮습니다. 온디바이스 에이전트 모델을 고를 때 점수 하나만 보지 말고 측정 조건과 배포 조건을 같이 놓고 봐야 하는 까닭입니다.
세 번째는 독립 검증입니다. 2026년 11월 17일 기준으로 BotPsy 점수를 제3자가 다시 잰 결과는 없습니다. Let’s Data Science와 Codesprint Consulting 모두 보도한 수치가 전부 Tether 자체 측정이라고 밝혔습니다. BFCL 공식 리더보드는 2026년 4월 12일 이후 갱신되지 않아 BotPsy가 아직 등재될 수 없는 상태입니다.
용어 풀이
1. BFCL v4 — 버클리가 운영하는 함수 호출 정확도 벤치마크의 4번째 버전으로, 모델이 도구를 올바른 인자로 부르는지 측정합니다.
2. τ-bench — 고객 응대처럼 여러 턴에 걸쳐 도구를 쓰는 과제를 평가하는 벤치마크이며, BotPsy 카드의 값은 표준판이 아닌 Tether의 자체 합성 지표입니다.
3. ToolSandbox — 상태가 바뀌는 환경에서 도구 호출이 이어질 때 과제를 끝까지 해내는지 보는 평가입니다.
비교 기준 정리
소형 에이전트 모델을 비교할 때 쓸 기준을 표로 정리했습니다. 같은 이름의 벤치마크라도 측정 주체·온도·모드가 다르면 숫자를 나란히 놓을 수 없습니다.
| 기준 | 확인할 값 | 단위 | 주의점 |
|---|---|---|---|
| 도구 호출 정확도 | BFCL v4, ACEBench, ToolSandbox | 점수(0-100) | 같은 하네스로 잰 값끼리만 비교합니다. BFCL v3와 v4는 서로 다른 지표입니다 |
| 멀티턴 에이전트 | τ-bench / TAU2-Bench | 점수 | BotPsy의 τ-bench는 τ²(retail·telecom)와 τ³(banking)의 평균이고 airline은 뺐습니다 |
| 측정 조건 | temperature, thinking 모드, 최대 토큰 | – | Tether는 temperature 0.3·최대 32,768토큰, Qwen 공식은 temperature 1.0입니다 |
| 배포 버전 점수 | Q4_K_M·Q8_0 별도 점수 | 점수 | 대표 점수가 BF16이면 양자화본 점수를 따로 찾아야 합니다 |
| 파일 크기 | GGUF·safetensors 용량 | GB/MB | 파일 크기는 실행 메모리와 같지 않습니다 |
| 기기 실측 | 디코드 속도, 피크 메모리 | tok/s, MB | 어떤 기기·런타임·양자화로 쟀는지 함께 봅니다 |
| 라이선스 | Apache 2.0 / 자체 라이선스 / 접근 승인 | – | 상업 배포 가능 범위와 학습 데이터 라이선스까지 확인합니다 |
| 컨텍스트 길이 | 공식 지원 길이 | 토큰 | 설정 파일 값과 공식 지원 길이는 다를 수 있습니다 |
이 표에서 가장 자주 놓치는 행이 측정 조건입니다. BotPsy 모델카드의 평가는 2026년 11월 3일 vLLM BF16, temperature 0.3, thinking 모드로 5개 모델을 같은 하네스에 넣어 돌린 결과입니다. 같은 하네스 안에서라면 비교는 공정합니다. 그 결과를 다른 회사 모델카드의 숫자와 섞는 순간 결론이 바뀝니다.
베이스 모델 점수를 봐도 차이가 드러납니다. 같은 Qwen3.5-0.8B를 두고 Tether는 GPQA Diamond를 33.2점으로 쟀고, Qwen 공식 카드에는 11.9점으로 나옵니다. IFEval(thinking)도 Tether 59.7점, Qwen 공식 44.0점입니다. 베이스 대비 몇 점 올랐다는 향상 폭조차 하네스마다 달라지는 셈입니다.
컨텍스트 길이도 조심해야 합니다. BotPsy 모델카드에는 지원 컨텍스트 길이가 명시돼 있지 않고, config.json의 max_position_embeddings 값이 262144일 뿐입니다. 베이스인 Qwen3.5의 네이티브 컨텍스트가 262,144토큰이라 같은 값이 남아 있는 것으로 보입니다. 하지만 Tether가 이 길이를 공식 지원한다고 밝힌 적은 없습니다.
옵션·유형별 비교
온디바이스 AI 에이전트 모델 종류, 증류형 범용 vs 미세조정 전제형
1B 안팎 에이전트 모델은 크게 두 종류입니다. 하나는 BotPsy와 LFM2.5처럼 받자마자 범용 도구 호출을 하도록 학습된 모델이고, 다른 하나는 FunctionGemma처럼 내 도메인에 맞게 미세조정하는 것을 전제로 만든 기반 모델입니다. Qwen3.5-2B는 에이전트 전용은 아니지만 지식 성능이 높은 범용 모델이라 비교 기준선으로 씁니다.
BotPsy는 Qwen3.5-0.8B(Thinking)를 베이스로 4단계를 거쳐 학습했습니다. SFT 다음에 Qwen3.5-4B 교사 3개로 다중 교사 온폴리시 증류(MOPD)를 하고, 마지막으로 DAPO 강화학습을 2라운드 돌렸습니다. 학습 코드와 학습 데이터는 공개하지 않았습니다.
| 항목 | BotPsy-0.8B | Qwen3.5-2B | LFM2.5-1.2B-Thinking | FunctionGemma 270M |
|---|---|---|---|---|
| 파라미터 | 0.8B(HF 메타데이터 0.9B) | 2B | 1.17B | 270M |
| 라이선스 | Apache 2.0 | Apache 2.0 | lfm1.0 | Gemma 라이선스, 접근 승인 필요 |
| 도구 호출 점수 | BFCL v4 44.0(Tether 측정) | BFCL-V4 43.6(Qwen 측정) / 37.7(Tether 측정) | BFCLv3 56.97(자체 핸들러) | Mobile Actions 기본 58%, 미세조정 후 85% |
| 컨텍스트 | 공식 표기 없음 | 262,144 | 32,768 | – |
| 기기 실측 | 없음 | – | S25 Ultra CPU, llama.cpp Q4_0: 70 tok/s, 719MB | S25 Ultra CPU, LiteRT dynamic_int8: 125.9 tok/s, 피크 551MB |
| 성격 | 미세조정 없이 멀티턴 도구 호출 | 지식·범용 | 기기 실측 공개, 후속 LFM3-1.7B 존재 | 도메인 미세조정 전제 |
LFM2.5의 BFCLv3 56.97점은 v3 기준인 데다 Liquid가 자체 핸들러로 잰 값입니다. BotPsy의 BFCL v4 44.0점과 크기를 비교하면 안 됩니다. FunctionGemma의 Mobile Actions도 별도 과제라 다른 모델 점수와 직접 맞댈 수 없습니다. 이 표에서 공정하게 비교할 수 있는 축은 라이선스, 크기, 그리고 기기 실측이 있느냐 없느냐 정도입니다.
BotPsy 내부 수치는 하네스 안에서만 비교
Tether 하네스 안에서 잰 값끼리 놓고 보면 BotPsy의 개선 폭은 분명합니다. 같은 하네스에서 지식 벤치마크가 2B 모델보다 크게 낮다는 점도 함께 드러납니다.
| 지표 (Tether 측정) | BotPsy-0.8B | 베이스 Qwen3.5-0.8B | Qwen3.5-2B-Think |
|---|---|---|---|
| BFCL v4 | 44.0 | 23.4 | 37.7 |
| ACEBench | 58.7 | 30.1 | 55.4 |
| τ-bench(자체 합성) | 51.5 | 23.2 | 46.5 |
| GPQA Diamond | 38.1 | 33.2 | 59.9 |
| MMLU-Pro | 48.9 | – | 65.5 |
ToolSandbox는 BotPsy 64.6점만 공개돼 있습니다. 표가 말해주는 건 도구를 다루는 능력은 2B급, 지식은 2B보다 한참 아래라는 사실입니다. 효율 지표도 같이 봐야 합니다. GPQA Diamond 정답 1개당 추론 토큰은 BotPsy 3,690개, 베이스 11,563개입니다. IFBench에서 같은 말을 반복하는 루핑 비율은 22.9%에서 1.4%로 줄었습니다. 배터리와 지연이 중요한 기기라면 점수 못지않게 의미 있는 개선입니다.
배포 파일과 양자화 후 점수
| 형식 | 크기 | BFCL v4 | τ-bench |
|---|---|---|---|
| safetensors BF16 | 1.71 GB | 44.0 | 51.5 |
| GGUF BF16 | 1.52 GB | – | – |
| GGUF Q8_0 | 812 MB | – | – |
| GGUF Q4_K_M(imatrix) | 529 MB | 43.5 | 46.7 |
휴대폰에 올릴 Q4_K_M에서는 τ-bench가 51.5점에서 46.7점으로 떨어집니다. Tether가 잰 Qwen3.5-2B-Think의 46.5점과 겨우 0.2점 차이입니다. GGUF 평가는 2026년 11월 6-7일 llama.cpp와 @qvac/sdk 0.23.0으로 진행했는데, 이것도 H100에서 돌렸지 모바일 기기에서 잰 게 아닙니다. 529MB는 파일 크기일 뿐이고, 실행 시 메모리 사용량은 Tether가 공개하지 않았습니다.
상황별 추천
조건별 온디바이스 AI 에이전트 모델 추천
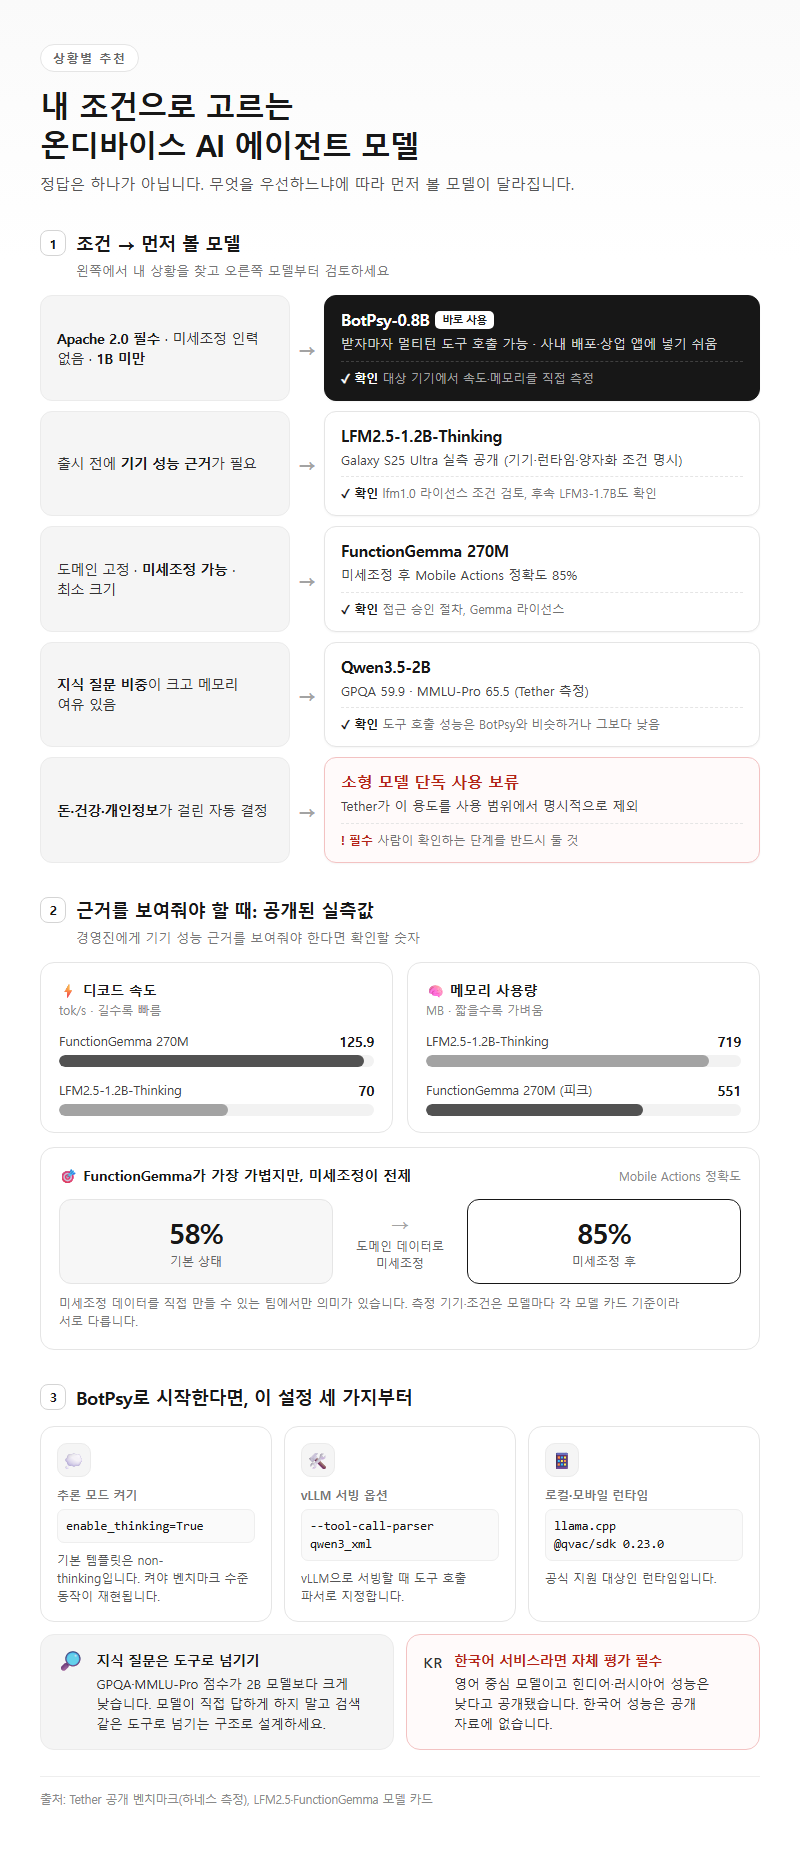
정답은 하나가 아닙니다. 무엇을 우선하느냐로 갈립니다. 아래 표는 위 비교 결과를 독자 조건에 맞춰 옮긴 것입니다.
| 내 조건 | 먼저 볼 모델 | 이유 | 조건 |
|---|---|---|---|
| Apache 2.0 필수, 미세조정 인력 없음, 1B 미만 | BotPsy-0.8B | 받자마자 멀티턴 도구 호출 | 대상 기기에서 직접 속도·메모리 측정 |
| 출시 전에 기기 성능 근거가 필요 | LFM2.5-1.2B-Thinking | S25 Ultra 실측 공개 | lfm1.0 라이선스 조건 검토, 후속 LFM3-1.7B도 확인 |
| 도메인 고정, 미세조정 가능, 최소 크기 | FunctionGemma 270M | 미세조정 후 Mobile Actions 85% | 접근 승인, Gemma 라이선스 |
| 지식 질문 비중이 크고 메모리 여유가 있음 | Qwen3.5-2B | GPQA 59.9·MMLU-Pro 65.5(Tether 측정) | 도구 호출은 BotPsy와 동률부터 열세까지 |
| 돈·건강·개인정보가 걸린 자동 결정 | 소형 모델 단독 사용 보류 | Tether가 이 용도를 명시적으로 제외 | 사람 확인 단계 필수 |
BotPsy가 맞는 쪽은 라이선스 제약이 엄격하고 학습 파이프라인을 따로 꾸릴 여력이 없는 팀입니다. Apache 2.0이라 사내 배포나 상업 앱에 넣기 쉽고, 일정·메일 정리처럼 난이도 낮음·중간인 작업은 Tether가 권장한 범위와도 겹칩니다. 사용자 다수가 영어가 아닌 언어를 쓰는 서비스라면 얘기가 다릅니다. Tether는 영어 중심 모델이며 힌디어·러시아어 성능이 낮다고 밝혔습니다. 한국어 성능은 공개 자료에 없으니 한국어 서비스라면 자체 평가가 필수입니다.
출시 일정이 빠듯하고 경영진에게 기기 성능 근거를 보여줘야 한다면 LFM2.5 쪽 자료가 더 탄탄합니다. 디코드 70 tok/s, 메모리 719MB에 실측 조건(기기·런타임·양자화)까지 모두 카드에 적혀 있습니다. 가장 가벼운 건 FunctionGemma로, 125.9 tok/s에 피크 551MB입니다. 다만 기본 상태 정확도가 58%라서 미세조정 데이터를 만들 수 있는 팀에게만 의미가 있습니다.
온디바이스 AI 에이전트 만들기, BotPsy로 시작한다면
BotPsy로 AI 에이전트 만들기를 시작한다면 설정 세 가지부터 챙깁니다. 기본 채팅 템플릿은 non-thinking이라, 벤치마크 수준의 동작을 재현하려면 enable_thinking=True를 켜야 합니다. vLLM으로 서빙할 때는 --tool-call-parser qwen3_xml 옵션을 씁니다. 로컬·모바일 런타임은 llama.cpp 또는 @qvac/sdk 0.23.0이 공식 대상입니다.
설계 단계에서는 지식 질문을 모델이 직접 답하게 두지 말고 검색 같은 도구로 넘기는 구조가 맞습니다. GPQA·MMLU-Pro 점수가 2B 모델보다 크게 낮기 때문입니다. 도입 여부는 Tether 하네스 점수가 아니라 내 도구 스키마로 BotPsy와 Qwen3.5-2B를 A/B 테스트한 결과를 보고 정합니다. 2026년 11월 17일 기준 지난달 다운로드가 887회에 그쳐, 커뮤니티 운영 사례도 아직 거의 없습니다.
자주 하는 실수
1. 서로 다른 하네스의 점수를 한 표에 섞기
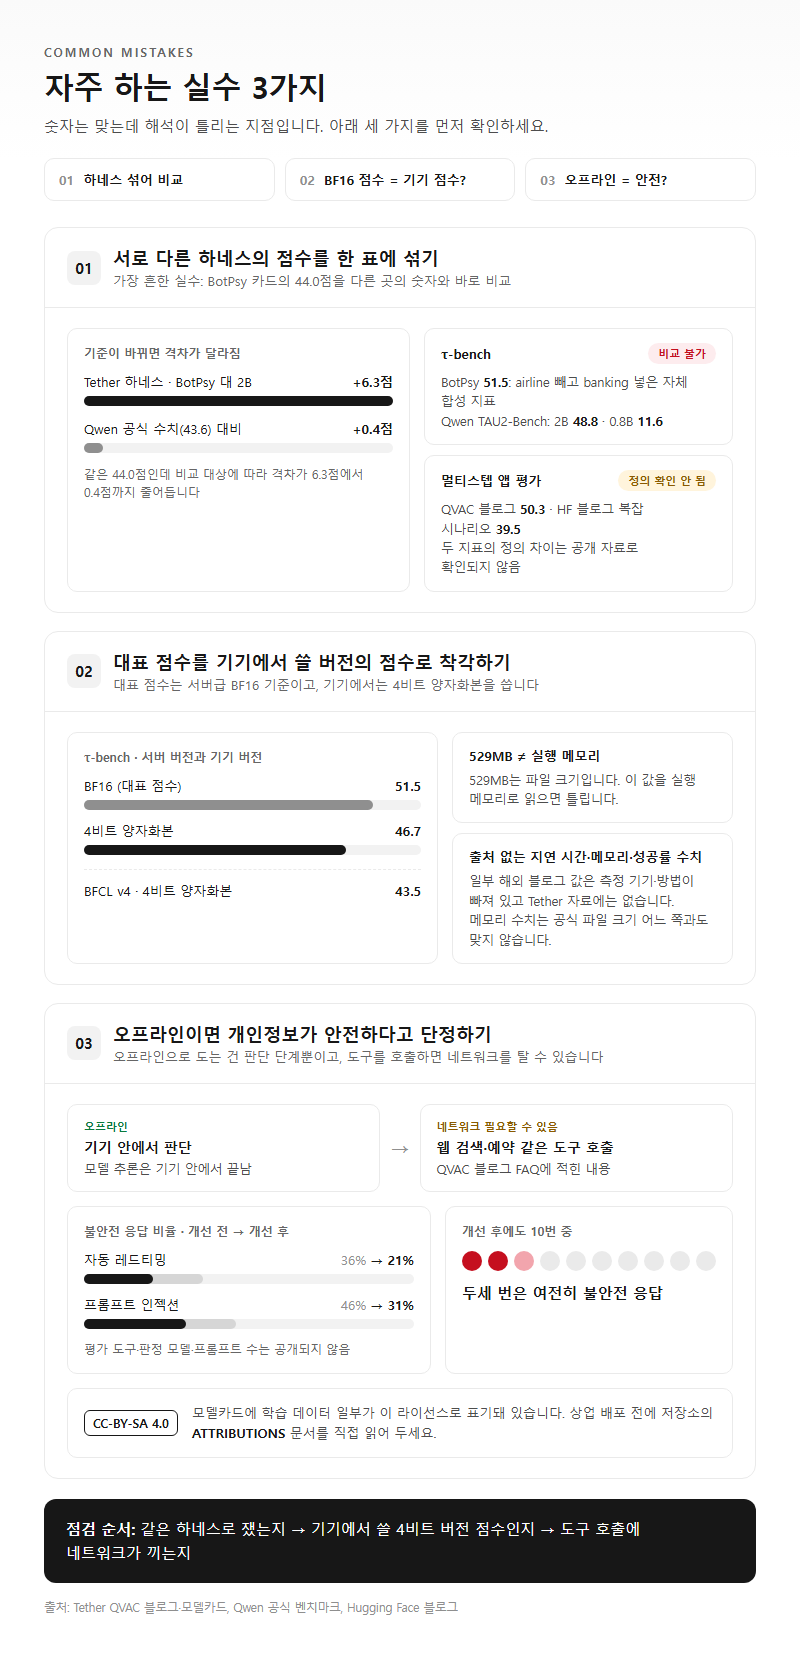
가장 흔한 실수는 BotPsy 카드의 44.0점을 다른 곳에서 본 숫자와 바로 비교하는 것입니다. Tether 하네스에서는 BotPsy가 2B보다 6.3점 앞서지만, Qwen 공식 수치(43.6)와 비교하면 0.4점 차이입니다. τ-bench도 마찬가지입니다. BotPsy의 51.5점은 airline을 빼고 banking을 넣은 자체 합성 지표라, Qwen 공식 TAU2-Bench(2B 48.8, 0.8B 11.6)와는 정의가 달라 비교 자체가 성립하지 않습니다. 멀티스텝 앱 평가도 같은 문제를 안고 있습니다. QVAC 블로그는 BotPsy 50.3점, HF 블로그 복잡 시나리오는 39.5점으로 적었는데, 두 지표의 정의 차이는 공개 자료로 확인되지 않습니다.
2. 대표 점수를 기기에서 쓸 버전의 점수로 착각하기
대표 점수는 서버급 BF16 기준입니다. 4비트 양자화본은 τ-bench 46.7점, BFCL v4 43.5점입니다. 파일 크기 529MB를 실행 메모리로 읽는 것도 오류입니다. 일부 해외 블로그에 지연 시간·메모리·성공률 수치가 돌고 있지만, 측정 기기와 방법이 빠져 있고 Tether 자료 어디에도 없는 값입니다. 그중 메모리 수치는 공식 파일 크기 어느 쪽과도 맞지 않습니다.
3. 오프라인이면 개인정보가 안전하다고 단정하기
모델이 기기 안에서 판단하는 단계는 오프라인으로 돌아갑니다. 하지만 QVAC 블로그 FAQ에는 웹 검색·예약 같은 도구에는 네트워크가 필요할 수 있다고 적혀 있습니다. 안전성 수치에도 한계가 남아 있습니다. 자동 레드티밍에서 불안전 응답 비율은 36%에서 21%로, 프롬프트 인젝션 불안전률은 46%에서 31%로 낮아졌습니다. 그래도 열 번 중 두세 번은 여전히 불안전 응답이고, 평가 도구·판정 모델·프롬프트 수는 공개되지 않았습니다. 모델카드에는 학습 데이터 일부가 CC-BY-SA 4.0으로 표기돼 있으니, 상업 배포 전에 저장소의 ATTRIBUTIONS 문서를 직접 읽어 두는 편이 안전합니다.
정리
BotPsy-0.8B는 Apache 2.0, 1B 미만, 미세조정 없는 멀티턴 도구 호출이라는 세 조건을 모두 갖춘 드문 온디바이스 에이전트 모델입니다. 다만 2B를 앞선다는 결론은 Tether 측정 환경에서만 성립하고, Qwen 공식 수치로 보면 BFCL-V4 44.0 대 43.6으로 동률입니다. 휴대폰용 Q4_K_M 점수는 이보다 낮고, 기기 실측은 아직 없습니다.
한 줄로 줄이면 이렇습니다. 라이선스와 미세조정 부담이 우선이면 BotPsy를 후보로 두되, 대상 기기에서 내 도구 스키마로 직접 측정한 결과로 최종 결정하십시오. 기기 성능 근거가 먼저 필요하면 LFM2.5, 도메인이 고정돼 있고 미세조정할 수 있으면 FunctionGemma, 지식 질문이 많으면 Qwen3.5-2B가 더 맞습니다.
함께 보면 좋은 제품
- 라이프밀 홀그레인 저당 그래놀라 귀리 시리얼 20g 7봉
- 그릭요거트 토핑을 올린 귀리 그래놀라 시리얼입니다.
위 링크는 제휴 링크이며, 제품 선택은 독자의 판단입니다.
참고 자료
조사 기준일: 2026년 11월 17일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (모두 2026-11-17 확인)
– https://huggingface.co/blog/qvac/botpsy
– https://huggingface.co/qvac/BotPsy-0.8B
– https://huggingface.co/qvac/BotPsy-0.8B/tree/main
– https://huggingface.co/qvac/BotPsy-0.8B/resolve/main/config.json
– https://huggingface.co/qvac/BotPsy-0.8B-GGUFs
– https://qvac.tether.io/blog/on-device-ai-agent-botpsy
– https://huggingface.co/Qwen/Qwen3.5-2B
– https://huggingface.co/Qwen/Qwen3.5-0.8B
– https://huggingface.co/LiquidAI/LFM2.5-1.2B-Thinking
– https://huggingface.co/google/functiongemma-270m-it
– https://letsdatascience.com/news/tether-ai-research-introduces-botpsy-a-08b-on-device-agent-m-2cbe1684
– https://www.codesprintconsulting.com/blog/botpsy
– https://explore.n1n.ai/blog/botpsy-on-device-personal-assistant-sub-billion-parameter-agentic-model-2026-11-12 (근거 없는 수치를 반박하는 데에만 사용)
– https://huggingface.co/emergic/BotPsy-0.8B-GGUFs
– https://gorilla.cs.berkeley.edu/leaderboard.html
– https://deepinfra.com/Qwen/Qwen3.5-2B (Qwen 수치 교차 확인용)
답글 남기기