
Ai2가 2026년 10월 1일 공개한 Olmo-core 3의 MoE 학습 구조를 정리했습니다. DDP 전환과 MXFP8 적용 효과를 살펴보고, 2.7배·1조 파라미터 수치가 어떤 조건에서 나왔는지, 3.0.0으로 올릴 때 무엇을 주의해야 하는지 수치로 설명합니다.
OlmoCore3 핵심만 먼저 정리하면
Olmo-core 3는 새 AI 모델이 아닙니다. Ai2가 2026년 10월 1일 공개한 대형 MoE 모델 학습용 소프트웨어 스택입니다. MoE 학습 구조에서 가장 크게 달라진 점은 기존 FSDP 방식을 DDP 기반으로 바꿨다는 것입니다. 전문가(expert)를 GPU에 상주시키고 데이터를 그 GPU로 보내도록 설계를 뒤집었습니다. Ai2에 따르면 그 결과 B300 GPU 8장에서 47B MoE를 학습할 때 처리량이 GPU당 초당 19,400토큰에서 52,000토큰으로 약 2.7배 늘었습니다.
다만 이 2.7배의 기준선은 Ai2 자사의 예전 FSDP 구현입니다. NVIDIA Megatron-Core와 비교한 수치가 아닙니다. 1.2T 파라미터 실험도 무작위 라우팅으로 시스템 성능만 잰 테스트였고, 학습을 마친 1조 파라미터 모델이 나온 것도 아닙니다. 이 글은 2026년 10월 3일 기준 공개 자료로 구조 변화와 처리량 수치, 경쟁 스택과의 위치, 3.0.0 업그레이드 시 주의점을 정리했습니다. 독립 벤치마크와 제3자 재현 결과는 다루지 않습니다. 이 시점까지 공개된 것이 없어서입니다.
Q1. Olmo-core 3는 정확히 무엇이고, MoE 학습 구조에서 무엇이 바뀌었나요?
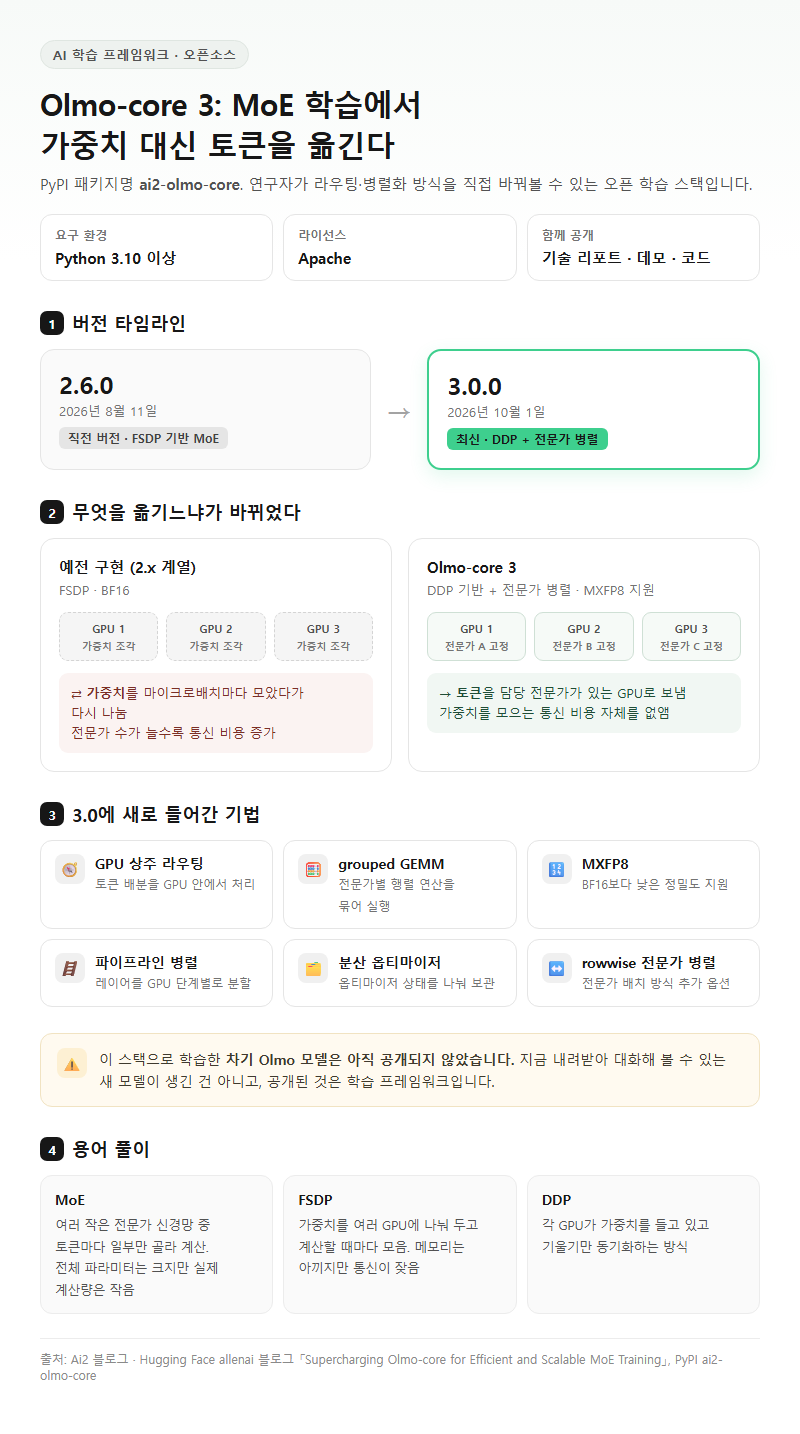
Olmo-core 3는 PyPI에 ai2-olmo-core라는 이름으로 배포되는 학습 프레임워크입니다. 최신 버전 3.0.0의 배포일은 2026년 10월 1일이고, 직전 버전은 2026년 8월 11일에 나온 2.6.0입니다. Python 3.10 이상이 필요하며 라이선스는 Apache입니다. 이 스택으로 학습한 차기 Olmo 모델은 아직 공개되지 않았습니다. 지금 내려받아 대화해 볼 수 있는 모델이 생긴 건 아니라는 얘기입니다.
핵심 변화는 MoE 학습에서 가중치와 데이터 중 무엇을 옮기느냐에 있습니다. 예전 구현은 FSDP를 써서 마이크로배치마다 가중치를 모았다가 다시 나눴습니다. 3에서는 DDP 기반으로 바꿔 전문가를 GPU에 고정해 두고 토큰을 해당 GPU로 보냅니다. 전문가 수가 늘수록 가중치를 모으는 통신 비용도 커지는데, 구조를 바꿔 이 비용 자체를 없앴습니다.
| 구분 | 예전 구현 (2.x 계열 MoE) | Olmo-core 3 |
|---|---|---|
| 기본 병렬 방식 | FSDP | DDP 기반 + 전문가 병렬 |
| 무엇을 이동시키나 | 가중치 (마이크로배치마다 수집·재분할) | 데이터(토큰) |
| 라우팅 | — | GPU 상주 라우팅 |
| 행렬 연산 | — | grouped GEMM |
| 추가 병렬화 | — | 파이프라인 병렬, 분산 옵티마이저, rowwise 전문가 병렬 |
| 저정밀도 | BF16 | MXFP8 지원 |
이 기법 목록은 Ai2 블로그와 Hugging Face의 allenai 블로그에 똑같이 실려 있습니다. 기술 리포트(“Supercharging Olmo-core for Efficient and Scalable MoE Training”), 인터랙티브 데모, 코드도 함께 나왔습니다. 이번 공개에서 실제로 의미 있는 부분은 연구자가 라우팅·병렬화 방식을 직접 바꿔볼 수 있는 오픈 스택이라는 점입니다.
용어 풀이
1. MoE(Mixture of Experts) — 여러 개의 작은 전문가 신경망 가운데 토큰마다 일부만 골라 계산하는 구조로, 전체 파라미터는 크지만 실제로 계산하는 양은 작습니다.
2. FSDP — 모델 가중치를 여러 GPU에 나눠 두었다가 계산할 때마다 모으는 분산 학습 방식으로, 메모리는 아끼지만 통신이 잦습니다.
3. DDP — 각 GPU가 가중치를 들고 있고 기울기만 동기화하는 분산 학습 방식입니다.
Q2. “2.7배 빨라졌다”는 수치는 무엇과 비교한 결과인가요?
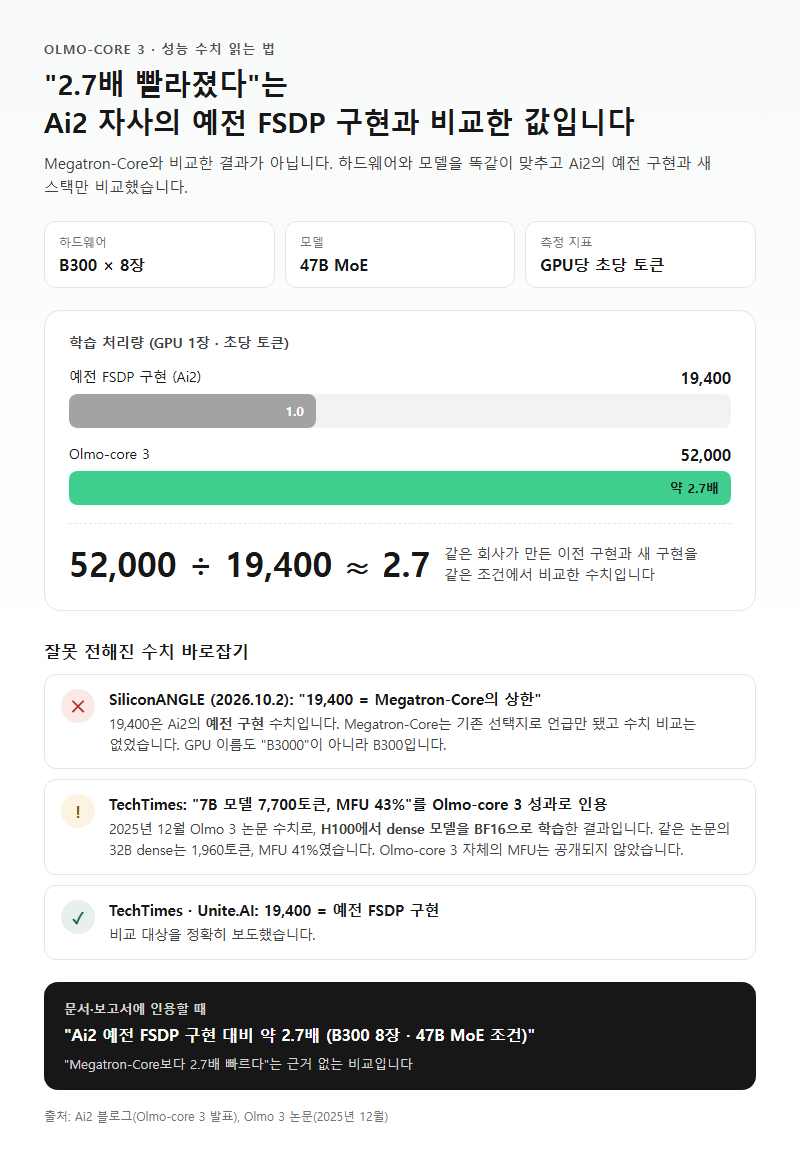
결론부터 말하면 Ai2 자사의 예전 FSDP 구현과 비교한 값입니다. 조건은 B300 GPU 8장에서 47B MoE를 학습하는 경우로 같습니다. 이 조건에서 새 스택은 GPU당 초당 52,000토큰, 예전 구현은 19,400토큰을 처리했습니다. 둘의 비율이 약 2.7배입니다.
| 항목 | 예전 FSDP 구현 | Olmo-core 3 |
|---|---|---|
| 하드웨어 | B300 8장 | B300 8장 |
| 모델 | 47B MoE | 47B MoE |
| GPU당 초당 토큰 | 19,400 | 52,000 |
| 비율 | 1.0 | 약 2.7배 |
이 수치를 잘못 옮긴 보도도 있습니다. SiliconANGLE은 2026년 10월 2일 기사에서 19,400토큰을 NVIDIA Megatron-Core의 상한처럼 서술했고, GPU 이름도 B300이 아닌 “B3000″으로 적었습니다. Ai2 원문에서 19,400은 자사의 예전 구현 수치입니다. Megatron-Core는 대형 MoE 학습의 기존 선택지로 언급됐을 뿐, 수치 비교는 없었습니다. TechTimes와 Unite.AI는 19,400을 예전 FSDP 구현의 수치로 정확히 보도했습니다.
TechTimes가 Olmo-core 3의 성과처럼 인용한 “7B 모델 GPU당 7,700토큰, MFU 43%”도 출처가 다릅니다. 이 값은 2025년 12월 Olmo 3 논문에 나온 수치로, H100에서 dense 모델을 BF16으로 학습한 결과입니다. 같은 논문의 32B dense 모델 수치는 GPU당 1,960토큰, MFU 41%입니다. Olmo-core 3 자체의 MFU는 Ai2 블로그에 나와 있지 않습니다.
“Olmo-core 3가 Megatron-Core보다 2.7배 빠르다”는 문장은 그러니 근거 없는 비교입니다. 개발 문서나 사내 보고서에 인용할 때는 “Ai2 예전 FSDP 구현 대비, B300 8장·47B MoE 조건”을 꼭 함께 적어야 합니다.
Q3. 전문가를 128개로 늘려도 속도가 거의 안 떨어진다는데, MXFP8은 얼마나 효과가 있나요?
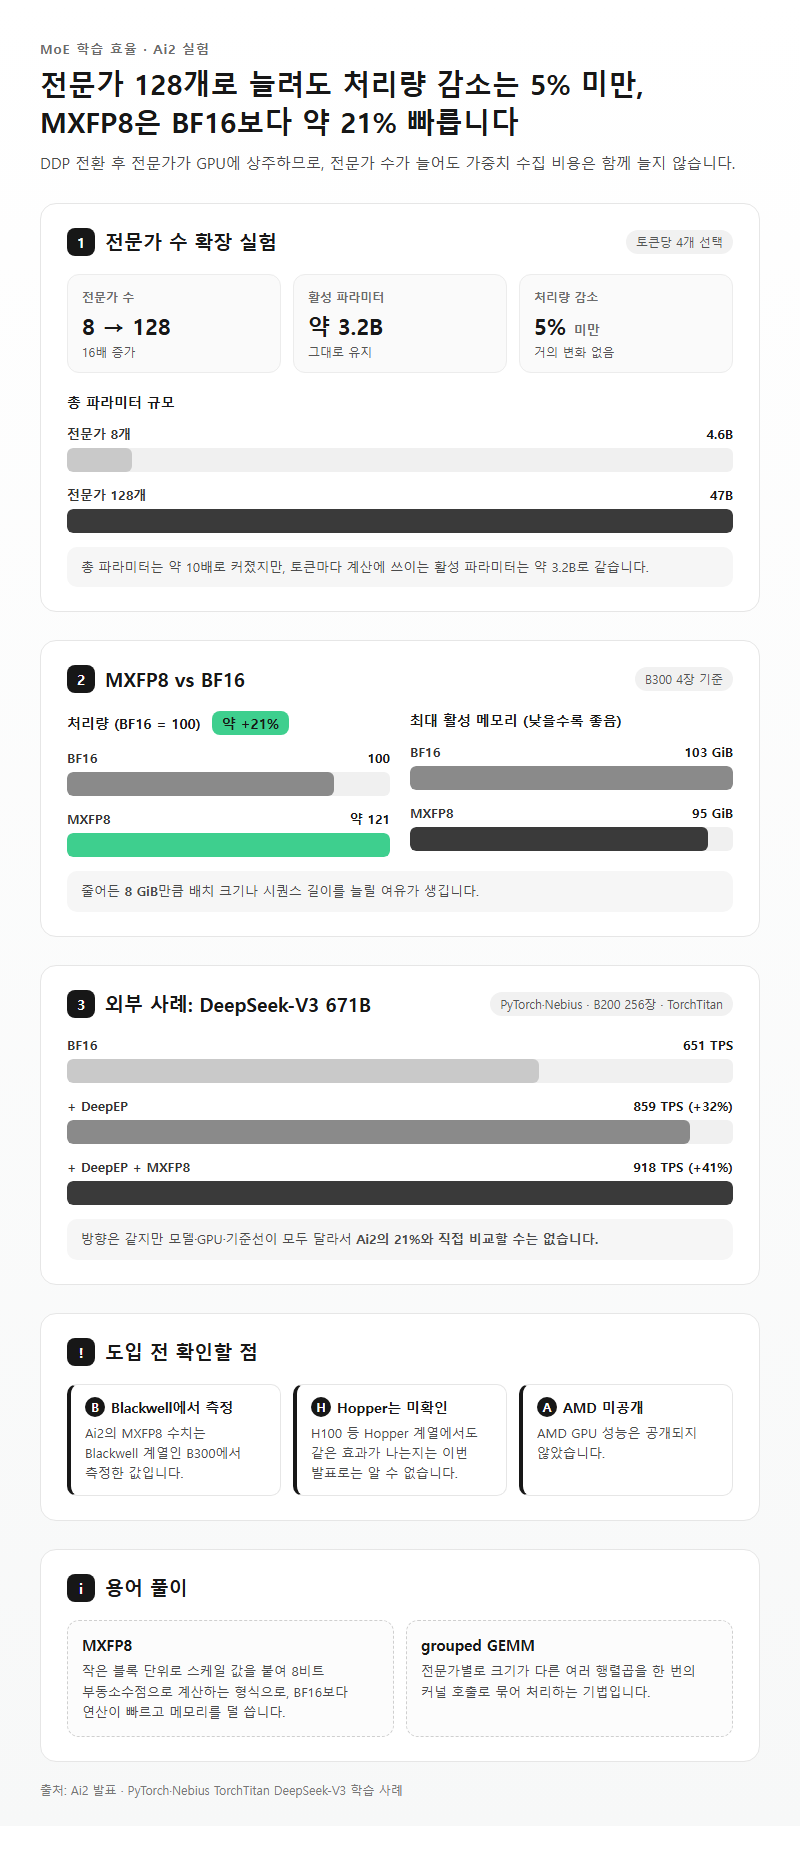
DDP 전환의 효과는 전문가 수를 늘린 실험에서 가장 잘 보입니다. Ai2는 전문가 수를 8개에서 128개로 늘리고 토큰당 4개를 고르게 했습니다. 활성 파라미터는 약 3.2B로 유지됐고, 총 파라미터는 4.6B에서 47B로 커졌습니다. 그런데도 Ai2가 밝힌 처리량 감소는 5% 미만이었습니다. 전문가가 GPU에 상주하니 전문가 수가 늘어도 가중치 수집 비용은 따라 늘지 않습니다.
| 항목 | 값 |
|---|---|
| 전문가 수 | 8 → 128 |
| 토큰당 선택 전문가 | 4 |
| 활성 파라미터 | 약 3.2B (유지) |
| 총 파라미터 | 4.6B → 47B |
| 처리량 감소 | 5% 미만 |
MXFP8 저정밀도 학습은 B300 4장 기준으로 BF16보다 처리량이 약 21% 높았습니다. 최대 활성 메모리도 103 GiB에서 95 GiB로 줄었습니다. 줄어든 8 GiB만큼 배치 크기나 시퀀스 길이를 늘릴 여유가 생깁니다.
외부 사례도 방향은 같습니다. PyTorch와 Nebius는 B200 256장에서 TorchTitan으로 DeepSeek-V3 671B를 학습했는데, 처리량이 BF16 651 TPS에서 DeepEP를 더하자 859 TPS(+32%), MXFP8까지 함께 쓰자 918 TPS(+41%)로 올랐습니다. 다만 모델·GPU·기준선이 모두 달라서 Ai2의 21%와 직접 비교할 수는 없습니다.
하나 짚어둘 점이 있습니다. Ai2의 MXFP8 수치는 Blackwell 계열인 B300에서 측정한 값입니다. Hopper 계열(H100 등)에서도 같은 효과가 나는지는 이번 발표로는 알 수 없습니다. AMD GPU 성능도 공개되지 않았습니다.
용어 풀이
1. MXFP8 — 작은 블록 단위로 스케일 값을 붙여 8비트 부동소수점으로 계산하는 형식으로, BF16보다 연산이 빠르고 메모리를 덜 씁니다.
2. grouped GEMM — 전문가별로 크기가 다른 여러 행렬곱을 한 번의 커널 호출로 묶어 처리하는 기법입니다.
Q4. Olmo-core 3로 1조 파라미터 모델을 학습했다는 말은 사실인가요?
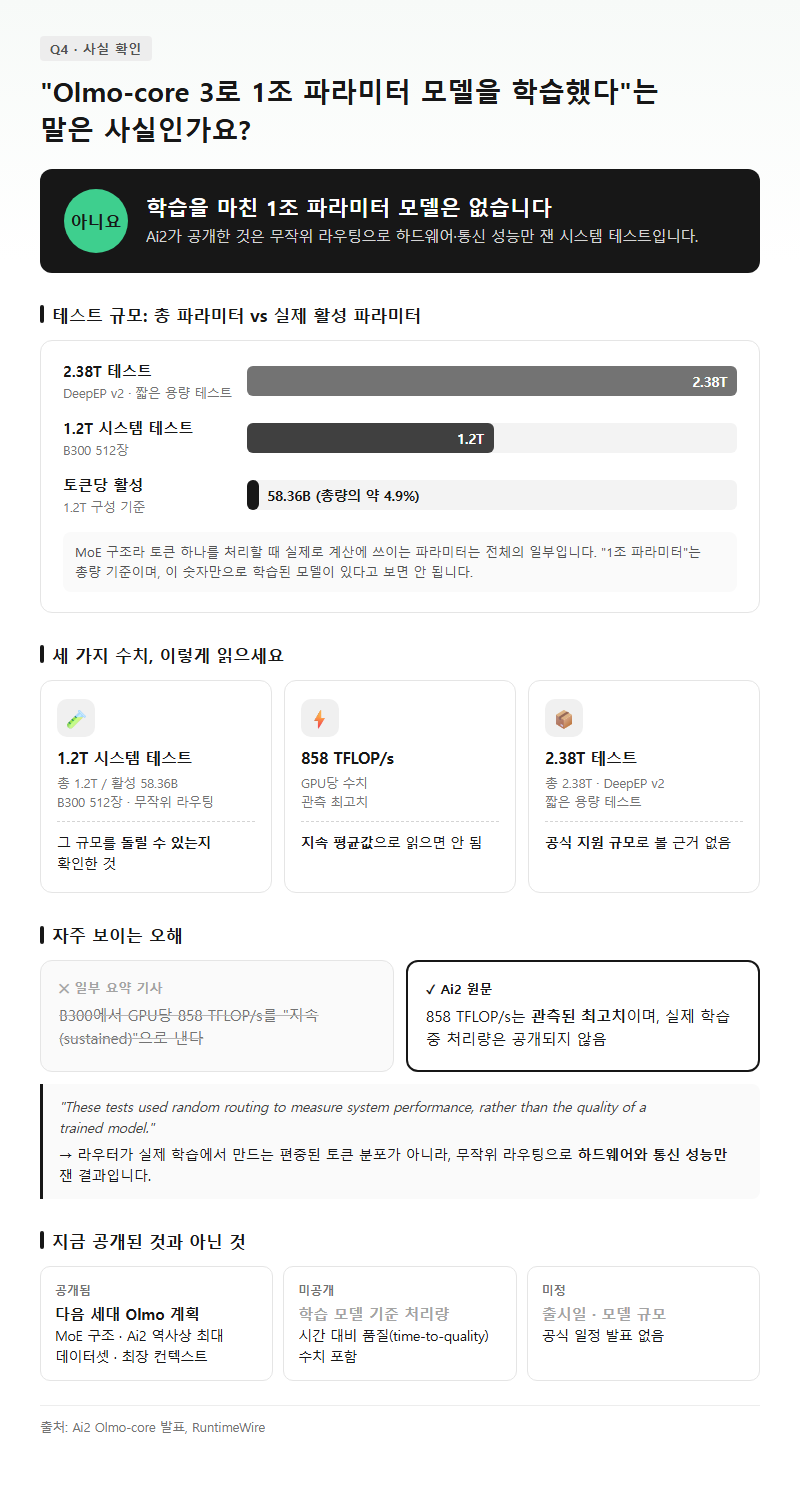
학습을 마친 1조 파라미터 모델은 없습니다. Ai2가 돌린 것은 총 1.2T 파라미터(토큰당 활성 58.36B) 구성의 시스템 테스트입니다. B300 512장을 썼고, GPU당 관측 최고치는 858 TFLOP/s였습니다. DeepEP v2 실험에서는 총 2.38T 파라미터 구성까지 올렸지만, 이것도 짧은 용량 테스트였습니다.
Ai2는 대규모 실험의 전제를 원문에 이렇게 적었습니다. “These tests used random routing to measure system performance, rather than the quality of a trained model.” 실제 학습에서 라우터가 만드는 편중된 토큰 분포가 아니라 무작위 라우팅으로 하드웨어와 통신 성능만 잰 결과라는 말입니다.
| 실험 | 규모 | 조건 | 해석 |
|---|---|---|---|
| 1.2T 시스템 테스트 | 총 1.2T / 활성 58.36B, B300 512장 | 무작위 라우팅 | 그 규모를 돌릴 수 있는지 확인한 것 |
| 858 TFLOP/s | GPU당 | 관측 최고치 | 지속 평균값으로 읽으면 안 됨 |
| 2.38T 테스트 | 총 2.38T, DeepEP v2 | 짧은 용량 테스트 | 공식 지원 규모로 볼 근거 없음 |
RuntimeWire도 1.2T 결과를 시스템 테스트로 다루면서, 쓸 만한 품질의 1T 모델을 학습했다는 증거는 아니라고 명시했습니다. 858 TFLOP/s를 “지속(sustained)” 성능처럼 쓴 요약 기사도 있었지만, Ai2가 밝힌 것은 관측된 최고치입니다.
실제 학습된 모델로 잰 처리량과 시간 대비 품질(time-to-quality) 수치는 Ai2가 공개하지 않았습니다. 다음 세대 Olmo를 MoE 구조로, Ai2 역사상 가장 큰 데이터셋과 가장 긴 컨텍스트로 학습하겠다는 계획만 밝혔습니다. 출시일과 규모는 미정입니다.
Q5. Megatron-Core·TorchTitan 대신 Olmo-core 3를 골라도 될까요? 3.0.0으로 올릴 때 주의할 점은?
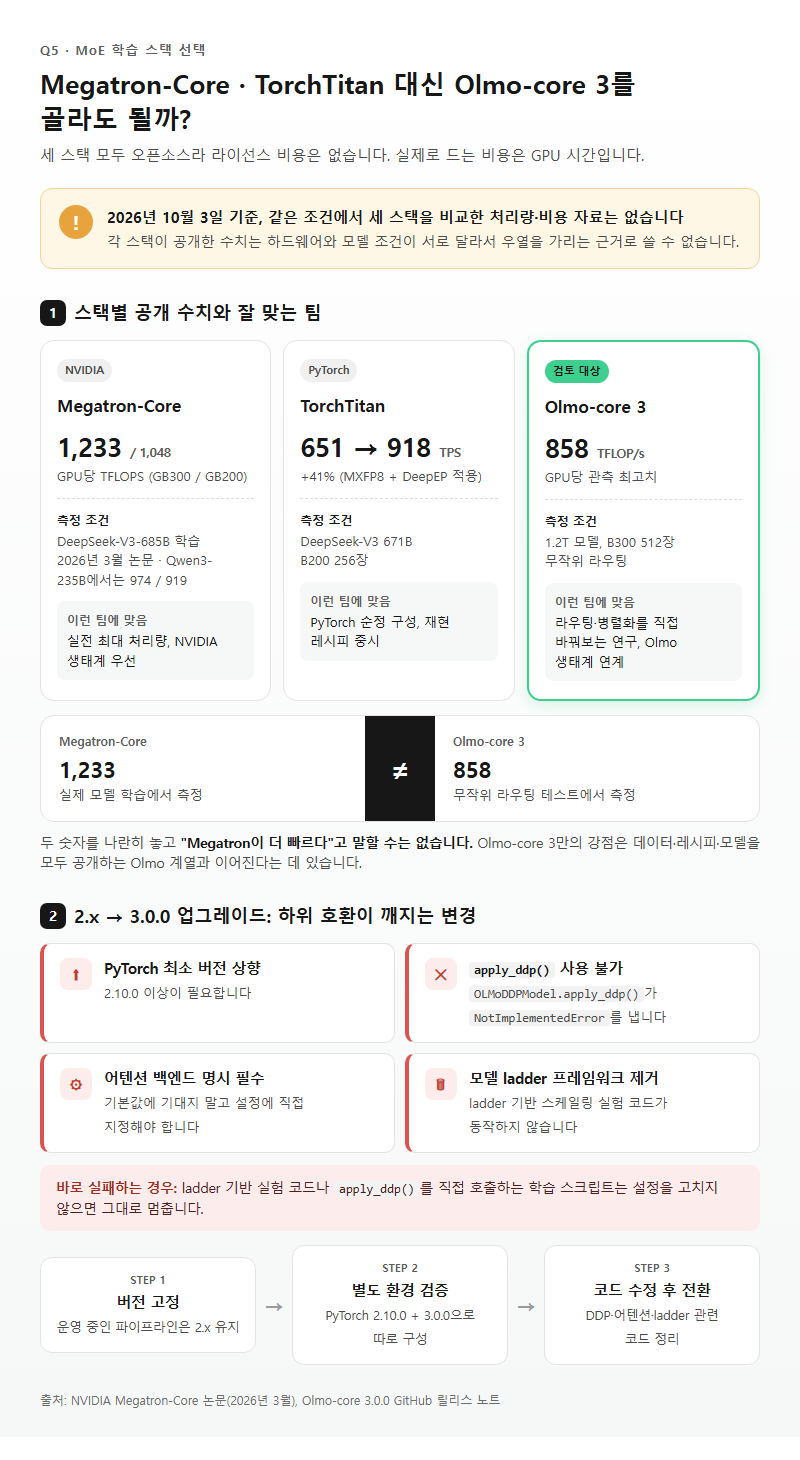
세 스택 모두 오픈소스라 라이선스 비용은 없고, 실제로 드는 비용은 GPU 시간입니다. 2026년 10월 3일 기준으로 세 스택을 같은 조건에서 비교한 처리량·비용 자료는 없습니다. 각자 공개한 수치는 하드웨어와 모델 조건이 달라서 우열을 가리는 데 쓸 수 없습니다.
| 스택 | 공개된 대표 수치 | 측정 조건 | 맞는 팀 |
|---|---|---|---|
| NVIDIA Megatron-Core | GPU당 1,233 / 1,048 TFLOPS | DeepSeek-V3-685B, GB300 / GB200 (2026년 3월 논문) | 실전 최대 처리량, NVIDIA 생태계 우선 |
| PyTorch TorchTitan | 651 → 918 TPS (+41%) | DeepSeek-V3 671B, B200 256장, MXFP8+DeepEP | PyTorch 순정 구성, 재현 레시피 중시 |
| Olmo-core 3 | GPU당 858 TFLOP/s (관측 최고치) | 1.2T, B300 512장, 무작위 라우팅 | 라우팅·병렬화를 직접 바꿔보는 연구, Olmo 생태계 연계 |
Megatron-Core 논문은 Qwen3-235B 학습에서도 GB300 974, GB200 919 TFLOPS를 보고했습니다. 그렇다고 858과 1,233을 나란히 놓고 “Megatron이 더 빠르다”고 말할 수는 없습니다. 한쪽은 실제 모델 학습, 다른 쪽은 무작위 라우팅 테스트이기 때문입니다. Olmo-core 3만의 강점은 데이터·레시피·모델을 모두 공개하는 Olmo 계열과 이어진다는 데 있습니다.
2.x에서 3.0.0으로 올린다면 하위 호환이 깨지는 변경부터 확인해야 합니다. GitHub 릴리스 노트에 적힌 주요 변경은 다음과 같습니다.
- PyTorch 최소 요구 버전 2.10.0으로 상향
OLMoDDPModel.apply_ddp()가NotImplementedError를 내도록 변경- 어텐션 백엔드를 명시적으로 지정해야 함
- 모델 ladder 프레임워크 제거
ladder 기반 스케일링 실험 코드나 apply_ddp()를 직접 호출하는 학습 스크립트가 있다면 설정을 고치지 않는 한 바로 실패합니다. 운영 중인 학습 파이프라인은 버전을 고정해 두고 별도 환경에서 먼저 검증하는 편이 안전합니다.
정리
Olmo-core 3는 FSDP 대신 DDP 기반 전문가 병렬로 MoE 학습 구조를 바꾼 오픈 학습 스택입니다. B300 8장·47B MoE 조건에서 자사 예전 구현 대비 약 2.7배의 처리량을 보고했습니다. 전문가를 128개로 늘려도 처리량 감소는 5% 미만이었고, MXFP8은 B300에서 약 21%를 더했습니다. 반면 1.2T·2.38T 결과는 무작위 라우팅을 쓴 시스템 테스트입니다. Megatron-Core와 같은 조건에서 비교한 자료나 독립 재현 결과도 2026년 10월 3일 기준 아직 없습니다. 도입을 검토한다면 공개된 수치를 측정 조건과 함께 읽고, PyTorch 2.10.0 요구와 API 변경부터 점검하세요.
참고 자료
– Ai2 블로그: https://allenai.org/blog/olmocore3
– Hugging Face allenai 블로그: https://huggingface.co/blog/allenai/olmocore3
– PyPI ai2-olmo-core: https://pypi.org/project/ai2-olmo-core/
– GitHub 릴리스: https://github.com/allenai/OLMo-core/releases
– Olmo 3 논문: https://arxiv.org/html/2512.13961
– Megatron-Core MoE 논문: https://arxiv.org/abs/2603.07685
– PyTorch·Nebius 블로그: https://pytorch.org/blog/enabling-up-to-41-faster-pre-training-mxfp8-and-deepep-for-deepseek-v3-on-b200-with-torchtitan/
– SiliconANGLE 2026년 10월 2일 (보도 인용)
– TechTimes 2026년 10월 2일 (보도 인용)
– RuntimeWire (보도 인용)
참고 자료
조사 기준일: 2026년 10월 03일
본문의 수치는 아래 자료에서 확인한 것입니다. 제조사 공식 자료(T1)와 전문 매체 실측(T2)을 구분해 표기했습니다. 가격·공급 상황은 변동이 크므로 기준일 이후의 값은 다시 확인해야 합니다.
공식 자료 (2026-10-03 확인)
– Ai2 블로그: https://allenai.org/blog/olmocore3
– HF allenai 블로그: https://huggingface.co/blog/allenai/olmocore3
– PyPI: https://pypi.org/project/ai2-olmo-core/
– GitHub: https://github.com/allenai/olmo-core · 릴리스: https://github.com/allenai/OLMo-core/releases
– 기술 리포트(본문 미열람): https://allenai.org/papers/olmocore3
– Olmo 3 논문: https://arxiv.org/html/2512.13961
– Megatron-Core MoE 논문: https://arxiv.org/abs/2603.07685
– PyTorch·Nebius 블로그: https://pytorch.org/blog/enabling-up-to-41-faster-pre-training-mxfp8-and-deepep-for-deepseek-v3-on-b200-with-torchtitan/
– SiliconANGLE: https://siliconangle.com/2026/10/02/ai2-releases-olmo-core-3-to-make-developing-large-mixture-of-experts-llms-more-efficient/
– TechTimes: https://www.techtimes.com/articles/328470/20261002/ai2-releases-olmocore-3-open-moe-training-stack-delivers-27x-throughput-gain.htm
– Unite.AI: https://www.unite.ai/ai2-releases-olmo-core-3-open-training-stack-for-trillion-parameter-moes/
– RuntimeWire: https://runtimewire.com/article/ai2-olmo-core-3-moe-training-infrastructure
답글 남기기